Si votre équipe teste les prompts sur un seul modèle à la fois, vous mesurez probablement la mauvaise chose. Un prompt qui semble solide sur une route peut échouer un contrat JSON sur une autre, devenir trop lent avec un contexte plus long, ou sembler peu coûteux jusqu’à ce que les nouvelles tentatives et les sorties rejetées soient incluses.
Ce guide fournit aux équipes produit IA un flux de travail de test de prompts multi-modèles pratique pour comparer des versions de prompt sur plusieurs routes de modèle avant le lancement. L’objectif n’est pas de couronner un gagnant universel. L’objectif est de séparer la qualité du prompt, l’adéquation au modèle, la latence et le coût afin que l’équipe puisse choisir une route sur la base de preuves plutôt que de captures d’écran d’un playground.
Flatkey est utile dans ce flux de travail car le même compte peut appeler de nombreuses routes de modèle via une API compatible OpenAI, inspecter les modèles disponibles via la liste des modèles, et consulter les journaux d’utilisation au niveau des requêtes avec les noms de modèles, les nombres de jetons, le coût par requête, le statut et les horodatages. Utilisez cette couche partagée pour exécuter le test, puis stockez la cellule gagnante prompt/modèle comme base de régression.
La réponse courte
Un flux de travail de test de prompts multi-modèles fiable comporte huit étapes :
- Figez le contrat de la tâche avant de toucher aux paramètres du modèle.
- Séparez la version du prompt et la route du modèle en variables distinctes.
- Utilisez un jeu de données représentatif, pas trois exemples favoris.
- Exécutez des échantillons répétés là où le caractère non déterministe compte.
- Validez la structure avec du code avant de demander à un humain d’évaluer la qualité.
- Suivez le coût par tâche acceptée, pas seulement le prix des jetons.
- Ne promouvez un gagnant que s’il passe les portes de régression.
- Stockez l’enregistrement de la décision afin que le prochain test de modèle parte de preuves.
C’est la différence entre « Claude avait l’air meilleur dans une démo » et « Le prompt v2 sur la route B a passé 94 % de nos tests de contrat, est resté sous notre objectif de latence p95, et a réduit le coût par tâche acceptée après les nouvelles tentatives ».
Quand vous avez besoin de ce flux de travail
Utilisez un flux de travail de test de prompts multi-modèles lorsque l’une de ces स्थितions est vraie :
| Situation | Pourquoi le test sur un seul modèle est faible |
|---|---|
| Vous passez d’un fournisseur à un autre | La formulation du prompt, le comportement des appels d’outils, la fiabilité des sorties structurées et le style de refus peuvent tous changer. |
| Vous ajoutez une route de secours moins coûteuse | Le modèle moins cher peut nécessiter un prompt différent ou un validateur plus strict pour produire des résultats acceptés. |
| Vous testez des prompts à long contexte | La longueur du contexte change le coût, la latence, le comportement du cache et la probabilité de dérive des instructions. |
| Vous lancez un flux de travail produit | Les démos internes masquent les nouvelles tentatives, les sorties rejetées et les escalades au support. |
| Vous avez besoin d’une visibilité pour la finance | La finance ne se soucie pas seulement du prix des jetons ; elle a besoin du coût par tâche acceptée et de garde-fous budgétaires. |
Si la décision affecte le comportement en production, ne testez pas « modèle A vs modèle B » comme un simple ressenti. Testez plutôt la version du prompt par route de modèle comme une matrice.
Étape 1 : figer le contrat de la tâche
Avant de comparer les modèles, écrivez le contrat que le modèle doit respecter. Un contrat de tâche doit définir :
| Champ | Exemple |
|---|---|
| Travail de l’utilisateur | Classer les tickets de support et rédiger une réponse sûre. |
| Format de l’entrée | Texte du ticket, niveau du client, domaine du produit, nombre de réponses précédentes. |
| Résultat requis | JSON avec category, priority, reply, handoff_required et reason_codes. |
| Échecs bloquants | JSON invalide, champ requis manquant, promesse non prise en charge, langage de remboursement non sécurisé. |
| Critères de qualité | Catégorie correcte, réponse concise, aucune politique inventée, raison d’escalade utile. |
| Limites d’exploitation | Latence p95 inférieure à 4 secondes, coût par tâche acceptée inférieur au plafond de l’équipe. |
Faites cela d’abord, car le contrat maintient la méthode de test de prompts multi-modèles honnête. Sans lui, les évaluateurs optimiseront pour la réponse qui se lit le mieux dans un exemple, et non pour le parcours qui tient en production.
Étape 2 : Construire la matrice Prompt x Modèle
Séparez les variables. La version du prompt et la route du modèle doivent chacune avoir leur propre axe.
| Cellule de test | Prompt | Route du modèle | Ce qu’elle répond |
|---|---|---|---|
| A1 | Prompt v1 | Défaut actuel | La base est-elle toujours acceptable ? |
| A2 | Prompt v1 | Route candidate moins coûteuse | Le prompt actuel se transfère-t-il ? |
| B1 | Prompt v2 | Défaut actuel | Le prompt a-t-il amélioré la qualité sans changer de modèle ? |
| B2 | Prompt v2 | Route candidate moins coûteuse | Existe-t-il une meilleure paire prompt/modèle ? |
| C1 | Prompt v3 | Défaut actuel | Des instructions plus strictes ont-elles réduit les échecs ? |
| C2 | Prompt v3 | Route premium candidate | L’escalade vaut-elle le coût supplémentaire ? |
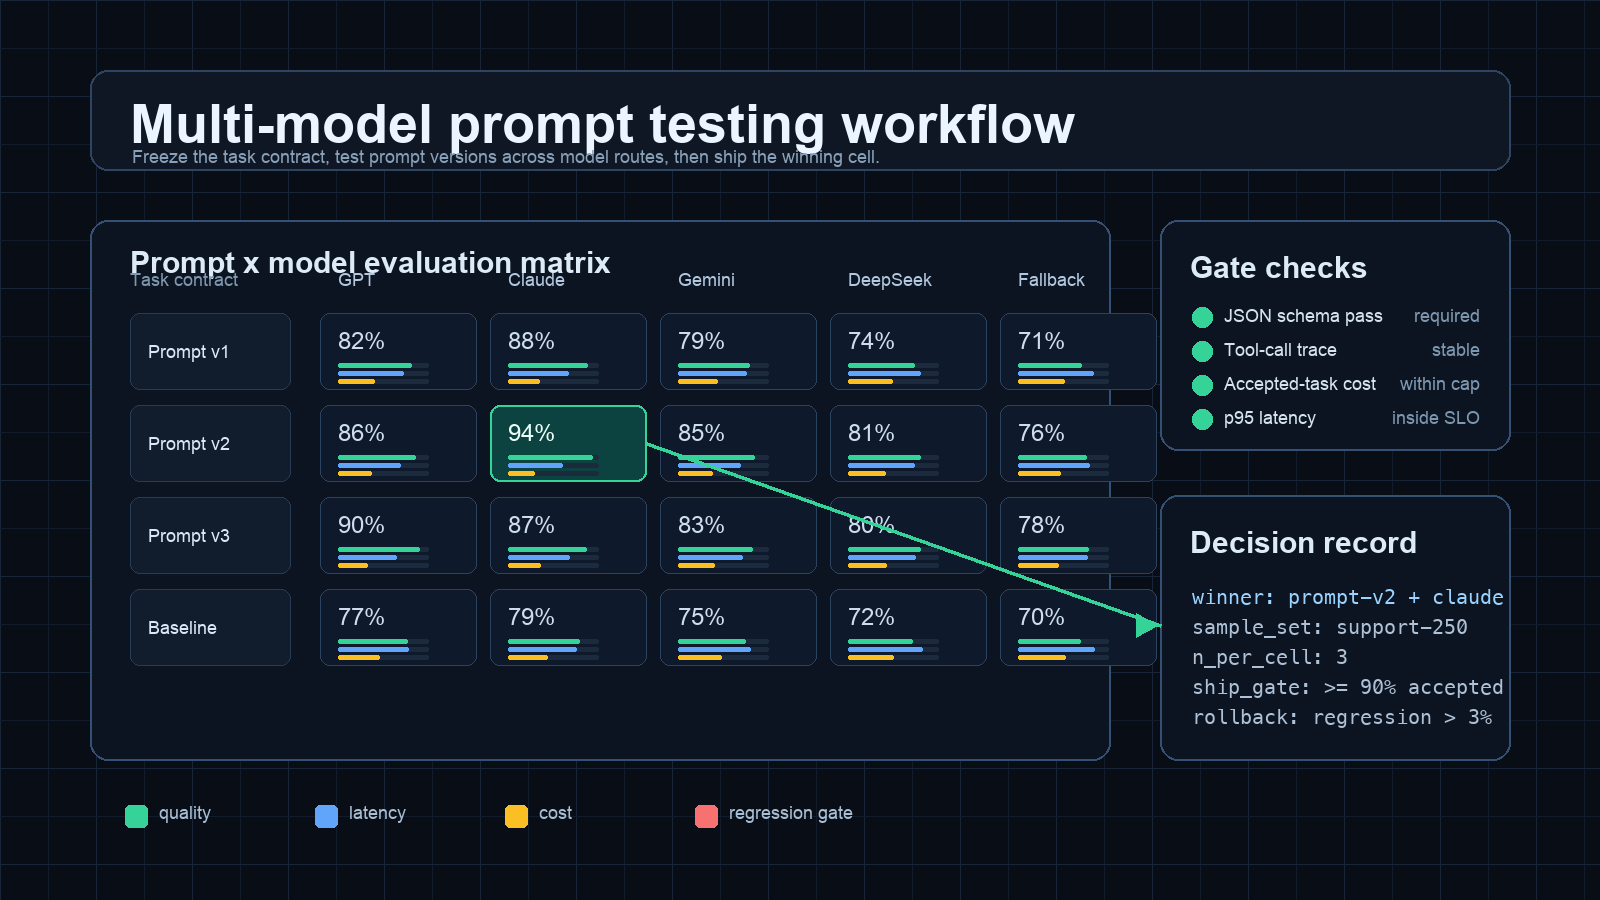
Cette matrice est le cœur de la méthode de test de prompts multi-modèles. Elle évite une erreur courante : blâmer le modèle alors que le prompt est la vraie variable, ou féliciter le prompt alors que le modèle compense des instructions faibles.
Étape 3 : Utiliser un jeu de données représentatif
Ne vous évaluez pas sur les exemples les plus faciles à copier. Construisez un petit jeu de données qui reflète le trafic réel.
Pour un flux de support, incluez :
- Les tickets courants qui devraient être faciles.
- Les cas limites où la politique est stricte.
- Les tickets ambigus et courts.
- Les tickets longs avec des détails non pertinents.
- Des exemples multilingues ou à langues mixtes s’ils apparaissent en production.
- Des échecs historiques connus.
- Des exemples qui devraient déclencher un transfert.
Pour chaque ligne, conservez le comportement attendu. Il n’a pas toujours besoin d’une réponse parfaite de référence, mais il doit y avoir suffisamment de vérité terrain pour qu’un validateur ou un évaluateur décide si le résultat est acceptable.
Un bon premier jeu de données comporte souvent 50 à 250 lignes. C’est assez petit pour être exécuté de façon répétée et assez grand pour révéler plus qu’un simple comportement de démo.
Étape 4 : Exécuter la matrice avec des échantillons répétés
Pour l’extraction ou la classification déterministe, une exécution par cellule peut suffire pour un premier filtrage. Pour la rédaction, le raisonnement, l’utilisation d’outils ou les tâches agentiques, exécutez plusieurs échantillons par cellule.
Utilisez cette règle de départ :
| Type de tâche | Exemples par ligne de test |
|---|---|
| Classification stricte | 1 à 2 |
| Extraction JSON | 2 |
| Rédaction orientée client | 3 |
| Appel d’outil | 3 |
| Raisonnement à long contexte | 3 à 5 |
| Flux de travail d’agent | 5 si le coût le permet |
Des exemples répétés montrent la variance. Un parcours qui obtient 94 % une fois et 71 % au passage suivant n’est pas prêt pour la production, même si le meilleur exemple paraît impressionnant.
Étape 5 : valider la structure avant la qualité
Chaque flux de travail de test de prompts multi-modèles doit évaluer la structure avant le style. Lancez d’abord des vérifications automatisées :
| Validateur | Ce qu’il détecte |
|---|---|
| Analyse JSON | Sortie structurée invalide. |
| Validation du schéma | Champs manquants, mauvaise énumération, mauvais type. |
| Vérifications par regex ou de politique | Phrases interdites, affirmations interdites, citations manquantes. |
| Validateur de trace d’outil | Mauvais outil, argument manquant, effet secondaire dangereux. |
| Vérifications unitaires déterministes | Mauvaise catégorie, mauvaise transformation numérique, traitement de date invalide. |
Seules les sorties structurellement acceptées devraient parvenir à la revue de qualité humaine ou assistée par modèle. Cela fait gagner du temps aux évaluateurs et maintient l’équité du scoring entre les parcours.
Étape 6 : suivre le coût par tâche acceptée
Ne comparez pas les parcours uniquement sur le prix affiché. Comparez ce que l’équipe paie réellement pour des résultats acceptés.
Utilisez cette métrique :
cost_per_accepted_task =
  total_cost_for_cell / accepted_outputs
Puis ajoutez le contexte :
accepted_output_rate =
  accepted_outputs / total_attempts

retry_adjusted_cost =
  total_cost_for_cell + retry_cost + reviewer_rerun_cost
Cela compte parce qu’un parcours avec un coût en tokens plus faible peut devenir plus cher s’il génère davantage de JSON invalide, des sorties plus longues, des erreurs d’appel d’outil ou des relances manuelles. Les journaux d’utilisation Flatkey sont conçus pour ce type de revue : chaque requête peut être inspectée par modèle, jetons d’entrée, jetons de sortie, coût, clé, statut et horodatage.
Si votre guide des coûts actuel est encore limité aux tokens, associez cet article au flux de travail interne de How to Compare AI Model Prices Before Switching API Providers. Le test de prompt doit répondre à la question suivante : quel parcours produit un travail accepté au coût opérationnel le plus bas ?
Étape 7 : noter la matrice
Utilisez un tableau de bord pondéré. Gardez la première version suffisamment simple pour que le produit, l’ingénierie et la finance puissent s’y accorder.
| Métrique | Poids | Mesure |
|---|---|---|
| Taux de réussite du contrat | 30% | Les vérifications requises du schéma et des politiques réussissent. |
| Acceptation humaine | 25% | L’évaluateur accepte la réponse pour une utilisation en production. |
| Coût par tâche acceptée | 20% | Dépense totale de la cellule divisée par les sorties acceptées. |
| Latence p95 | 15% | Latence de la route sous l’objectif du workflow. |
| Sécurité contre les régressions | 10% | Aucune baisse sur les cas d’échec historiques. |
Exemple de décision :
| Cellule prompt/modèle | Contrat réussi | Acceptation humaine | Coût/tâche | Latence p95 | Décision finale |
|---|---|---|---|---|---|
| Prompt v1 + route actuelle | 88% | 84% | 1,00x | Réussi | Conserver comme solution de secours de référence |
| Prompt v2 + route actuelle | 93% | 91% | 1,04x | Réussi | Solide mais pas le moins coûteux |
| Prompt v2 + route moins chère | 91% | 89% | 0,62x | Réussi | Déployer pour le trafic par défaut |
| Prompt v3 + route moins chère | 84% | 80% | 0,58x | Réussi | Rejeter en raison d’une baisse de qualité |
| Prompt v2 + route premium | 96% | 94% | 2,30x | Limite | Utiliser uniquement pour l’escalade |
La cellule gagnante n’est pas toujours celle qui obtient le meilleur score de qualité. C’est celle qui franchit les seuils de qualité, de latence, de fiabilité et de coût pour la tâche.
Étape 8 : stocker un enregistrement de décision
Un test de prompt qui ne peut pas être répété n’est pas un workflow. Enregistrez la décision avec le prompt, la route, le jeu de données, le tableau de bord de score et les conditions de retour arrière.
workflow: support_reply_generation
decision_date: 2026-09-26
dataset: support-eval-250
winner:
  prompt_version: prompt-v2
  model_route: candidate-cheaper-route
  reason: "Passed quality gate with lower cost per accepted task"
baseline:
  prompt_version: prompt-v1
  model_route: current-default
metrics:
  accepted_output_rate: 0.91
  cost_per_accepted_task_index: 0.62
  p95_latency_status: pass
regression_gates:
  - invalid_json_rate <= 0.02
  - policy_failure_rate <= 0.01
  - historical_failure_pass_rate >= 0.95
rollback_if:
  - accepted_output_rate drops below 0.88 for two days
  - p95 latency misses target for one release window
  - cost per accepted task rises above budget cap
Cet enregistrement permet au prochain évaluateur de se demander : le nouveau modèle a-t-il battu la cellule de production actuelle, ou n’a-t-il battu qu’un ancien souvenir du produit ?
Squelette exécutable à copier
Ce squelette de style TypeScript montre la structure de la boucle de test. Adaptez-le à votre stack.
type PromptVersion = {
  id: string;
  system: string;
};

type ModelRoute = {
  id: string;
  model: string;
};

type EvalRow = {
  id: string;
  input: Record<string, unknown>;
  expected: Record<string, unknown>;
};

type EvalResult = {
  rowId: string;
  promptId: string;
  routeId: string;
  sample: number;
  outputText: string;
  validJson: boolean;
  schemaPass: boolean;
  accepted: boolean;
  latencyMs: number;
  costUsd?: number;
};

async function runCell(
  prompt: PromptVersion,
  route: ModelRoute,
  rows: EvalRow[],
  samplesPerRow: number
): Promise<EvalResult[]> {
  const results: EvalResult[] = [];

  for (const row of rows) {
    for (let sample = 0; sample < samplesPerRow; sample++) {
      const started = Date.now();

      const response = await callModel({
        model: route.model,
        system: prompt.system,
        input: row.input,
      });

      const latencyMs = Date.now() - started;
      const parsed = safeJsonParse(response.text);
      const schemaPass = parsed.ok && validateSchema(parsed.value);
      const accepted = schemaPass && validateExpected(parsed.value, row.expected);

      results.push({
        rowId: row.id,
        promptId: prompt.id,
        routeId: route.id,
        sample,
        outputText: response.text,
        validJson: parsed.ok,
        schemaPass,
        accepted,
        latencyMs,
        costUsd: response.usageCost,
      });
    }
  }

  return results;
}
La partie importante n’est pas le langage. L’important est que chaque ligne de résultat comporte les champs de version de prompt, de route, de numéro d’échantillon, de résultats du validateur, de latence et de coût.
Que vérifier dans Flatkey après l’exécution
Une fois la matrice terminée, examinez la même fenêtre de test dans Flatkey :
- Filtrez les journaux d’utilisation par la clé API de test.
- Regroupez par route de modèle.
- Exportez les journaux de requêtes si la finance ou les opérations ont besoin d’une revue dans un tableur.
- Comparez les jetons d’entrée, les jetons de sortie, le statut et le coût par route.
- Vérifiez si les échecs se sont concentrés autour d’une version de prompt, d’un modèle ou d’un segment de jeu de données.
Ensuite, reliez le résultat à votre politique de routage. Si la route par défaut gagne en qualité mais qu’une route moins chère gagne en coût par tâche acceptée pour les cas simples, vous n’avez peut-être pas besoin d’un seul gagnant. Vous pourriez avoir besoin d’une route par défaut, d’une route d’escalade et d’une route de secours. Pour cette étape suivante, utilisez la logique de routage dans Model Fallback Strategy Workflow Playbook.
Erreurs courantes
| Erreur | Correction |
|---|---|
| Tester uniquement le prompt final sur cinq exemples | Utilisez un jeu de données représentatif et plusieurs versions de prompt. |
| Comparer les modèles sans validateurs | Analysez et vérifiez le schéma de chaque sortie structurée en premier. |
| Optimiser uniquement pour le score moyen | Suivez la variance et les cas d’échec historiques. |
| Ignorer les nouvelles tentatives | Utilisez le coût par tâche acceptée, pas le coût par appel brut. |
| Oublier la latence | Une route de haute qualité peut quand même dégrader l’expérience produit. |
| Perdre la décision | Stockez le résultat de la matrice comme base de référence de régression. |
Comment cela se relie à la prévision des coûts
L’URL canonique de cet article concerne la prévision des dépenses liées aux API d’IA, car les tests de prompts sont l’un des premiers endroits où les dépenses IA deviennent imprévisibles. Le flux de travail de test de prompts multi-modèles mis à jour rend les dépenses prévisibles en transformant l’évaluation en un tableau reproductible :
| Entrée de prévision | Provient de |
|---|---|
| Volume de tests | Lignes du jeu de données x versions de prompt x routes de modèle x échantillons. |
| Taux de nouvelle tentative | Validateurs en échec et sorties rejetées. |
| Coût par tâche acceptée | Journaux d’utilisation et nombre de sorties acceptées. |
| Réserve de lancement | Risque de régression, part de fallback et croissance attendue. |
| Contrôles budgétaires | Quota par clé, plafond mensuel et cadence de revue de l’utilisation. |
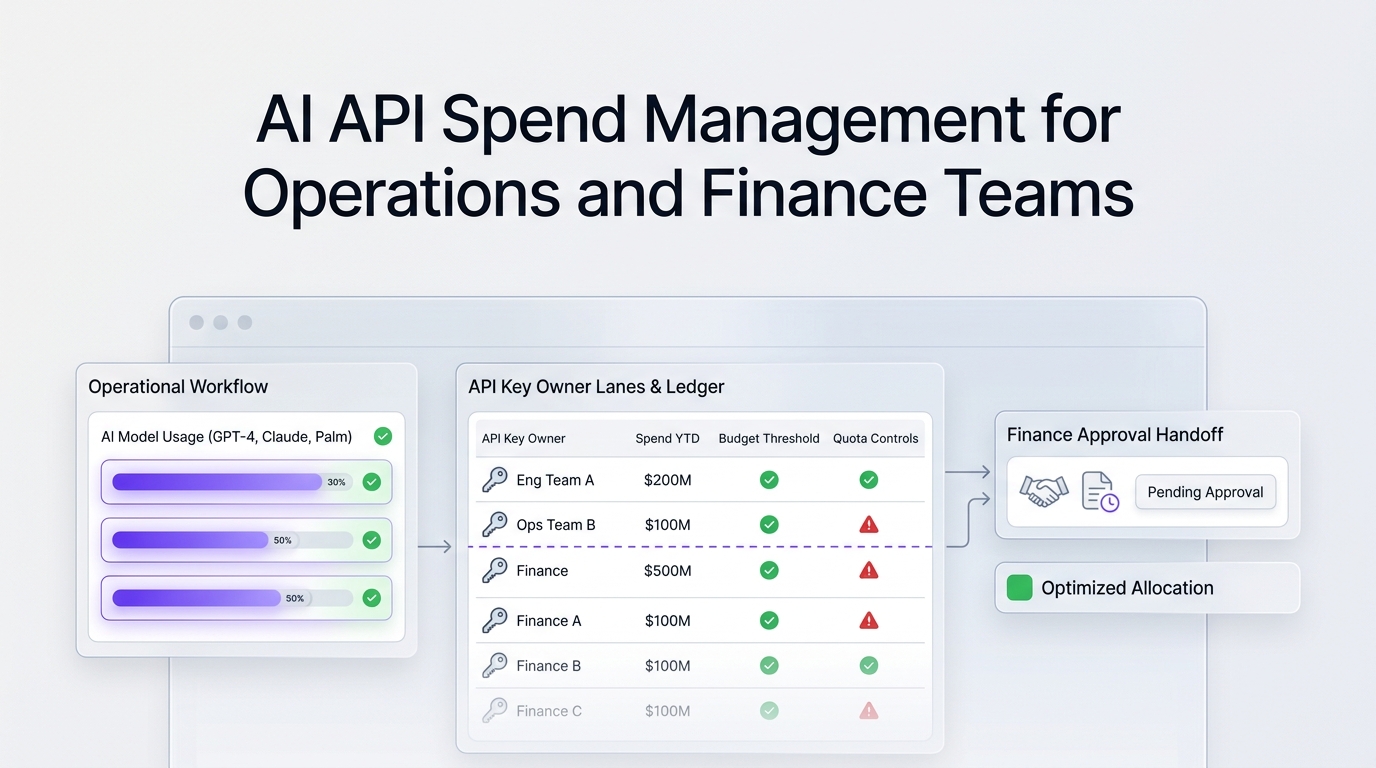
Pour un plan de déploiement prêt pour la finance, reliez la matrice de test à la gestion des dépenses des API IA pour les équipes opérations et finance.
FAQ
Qu’est-ce qu’un flux de travail de test de prompts multi-modèles ?
Un flux de travail de test de prompts multi-modèles est un processus reproductible permettant de tester plusieurs versions de prompts sur plusieurs routes de modèles, en évaluant chaque cellule avec des validateurs, une revue qualité, le coût, la latence et des garde-fous de régression.
Combien d’exemples me faut-il ?
Commencez avec 50 à 250 lignes représentatives. Ajoutez davantage de lignes lorsque la tâche est à haut risque, que le trafic est diversifié ou que la route prendra des décisions autonomes.
Dois-je utiliser un juge LLM ?
Vous pouvez, mais n’en faites pas le premier garde-fou. Utilisez des validateurs déterministes pour le schéma, la politique et les exigences exactes avant un scoring assisté par modèle. La revue humaine reste importante pour les flux de travail critiques au lancement.
À quelle fréquence devons-nous relancer le flux de travail ?
Relancez-le avant de changer les modèles par défaut, de modifier des prompts majeurs, d’ajouter des routes de secours, de modifier des schémas d’outils ou de lancer vers un nouveau segment. Relancez aussi un ensemble de régression plus réduit après des mises à jour du fournisseur ou du modèle.
Quelle est la place de Flatkey ?
Flatkey offre aux équipes une clé API et un catalogue de modèles uniques pour les tests multi-routes, ainsi qu’une visibilité sur l’utilisation pour le nom du modèle, les comptes de jetons, le coût des requêtes, la clé, le statut et l’horodatage. Cela rend le flux de travail de test de prompts multi-modèles plus facile à exécuter et plus facile à expliquer à la finance ou aux opérations.
Conclusion
Le prompt gagnant n’est pas un prompt. C’est une cellule prompt/modèle qui respecte le contrat de tâche dans des conditions réalistes de trafic, de budget et de latence. Utilisez le flux de travail de test de prompts multi-modèles ci-dessus pour transformer la sélection de modèle d’un débat en une trace de preuves : jeu de données, matrice, validateurs, coût par tâche acceptée, garde-fous de régression et registre de décision.
Lorsque votre équipe est prête à tester via une seule surface compatible OpenAI, commencez par le guide de démarrage rapide Flatkey, vérifiez les routes disponibles avec la liste des modèles, et consultez les dépenses dans les journaux d’utilisation.