Jika tim Anda menguji prompt pada satu model dalam satu waktu, kemungkinan besar Anda mengukur hal yang salah. Prompt yang terlihat kuat pada satu rute bisa gagal memenuhi kontrak JSON pada rute lain, menjadi terlalu lambat pada konteks yang lebih panjang, atau terlihat murah sampai retry dan output yang ditolak ikut dihitung.
Panduan ini memberi tim produk AI sebuah workflow pengujian prompt multi-model yang praktis untuk membandingkan versi prompt di berbagai rute model sebelum peluncuran. Tujuannya bukan untuk menobatkan satu pemenang universal. Tujuannya adalah memisahkan kualitas prompt, kecocokan model, latensi, dan biaya sehingga tim dapat memilih rute berdasarkan bukti, bukan screenshot dari playground.
Flatkey berguna dalam workflow ini karena akun yang sama dapat memanggil banyak rute model melalui API yang kompatibel dengan OpenAI, memeriksa model yang tersedia melalui daftar model, dan meninjau log penggunaan di level request dengan nama model, jumlah token, biaya per request, status, dan timestamp. Gunakan lapisan bersama itu untuk menjalankan pengujian, lalu simpan sel prompt/model yang menang sebagai baseline regresi.
Jawaban Singkat
Sebuah workflow pengujian prompt multi-model yang andal memiliki delapan bagian:
- Kunci kontrak tugas sebelum menyentuh pengaturan model.
- Pisahkan versi prompt dan rute model menjadi variabel yang terpisah.
- Gunakan dataset yang representatif, bukan tiga contoh favorit.
- Jalankan sampel berulang ketika nondeterminisme penting.
- Validasi struktur dengan kode sebelum meminta manusia menilai kualitas.
- Lacak biaya per tugas yang diterima, bukan hanya harga token.
- Promosikan pemenang hanya jika lolos gerbang regresi.
- Simpan catatan keputusan agar pengujian model berikutnya dimulai dari bukti.
Inilah perbedaan antara "Claude terlihat lebih baik dalam demo" dan "Prompt v2 pada rute B lolos 94% dari pengujian kontrak kami, tetap di bawah target latensi p95 kami, dan menurunkan biaya per tugas yang diterima setelah retry."
Kapan Anda Membutuhkan Workflow Ini
Gunakan workflow pengujian prompt multi-model ketika salah satu hal berikut benar:
| Situasi | Mengapa pengujian satu model lemah |
|---|---|
| Anda beralih dari satu penyedia ke penyedia lain | Formulasi prompt, perilaku pemanggilan tool, keandalan output terstruktur, dan gaya penolakan semuanya bisa berubah. |
| Anda menambahkan rute fallback yang lebih murah | Model yang lebih murah mungkin memerlukan prompt yang berbeda atau validator yang lebih ketat untuk menghasilkan hasil yang diterima. |
| Anda menguji prompt konteks panjang | Panjang konteks mengubah biaya, latensi, perilaku cache, dan peluang instruksi menyimpang. |
| Anda meluncurkan workflow produk | Demo internal menyembunyikan retry, output yang ditolak, dan eskalasi dukungan. |
| Anda membutuhkan visibilitas finansial | Bagian keuangan tidak peduli pada harga token saja; mereka membutuhkan biaya per tugas yang diterima dan pagar pembatas anggaran. |
Jika keputusan memengaruhi perilaku produksi, jangan uji "model A vs model B" sebagai cek perasaan. Uji versi prompt per rute model sebagai sebuah matriks.
Langkah 1: Kunci Kontrak Tugas
Sebelum membandingkan model, tuliskan kontrak yang harus dipenuhi model. Kontrak tugas harus mendefinisikan:
| Bidang | Contoh |
|---|---|
| Tugas pengguna | Klasifikasikan tiket dukungan dan buat satu balasan yang aman. |
| Bentuk input | Teks tiket, tier pelanggan, area produk, jumlah balasan sebelumnya. |
| Output yang diperlukan | JSON dengan category, priority, reply, handoff_required, dan reason_codes. |
| Kegagalan fatal | JSON tidak valid, field wajib hilang, janji yang tidak didukung, bahasa pengembalian dana yang tidak aman. |
| Kriteria kualitas | Kategori benar, balasan ringkas, tidak ada kebijakan yang dibuat-buat, alasan eskalasi yang berguna. |
| Batas operasional | Latensi p95 di bawah 4 detik, biaya per tugas yang diterima di bawah batas tim. |
Lakukan ini terlebih dahulu karena kontrak menjaga workflow pengujian prompt multi-model tetap jujur. Tanpa ini, peninjau akan mengoptimalkan respons yang paling baik dibaca dalam satu contoh, bukan rute yang bertahan di produksi.
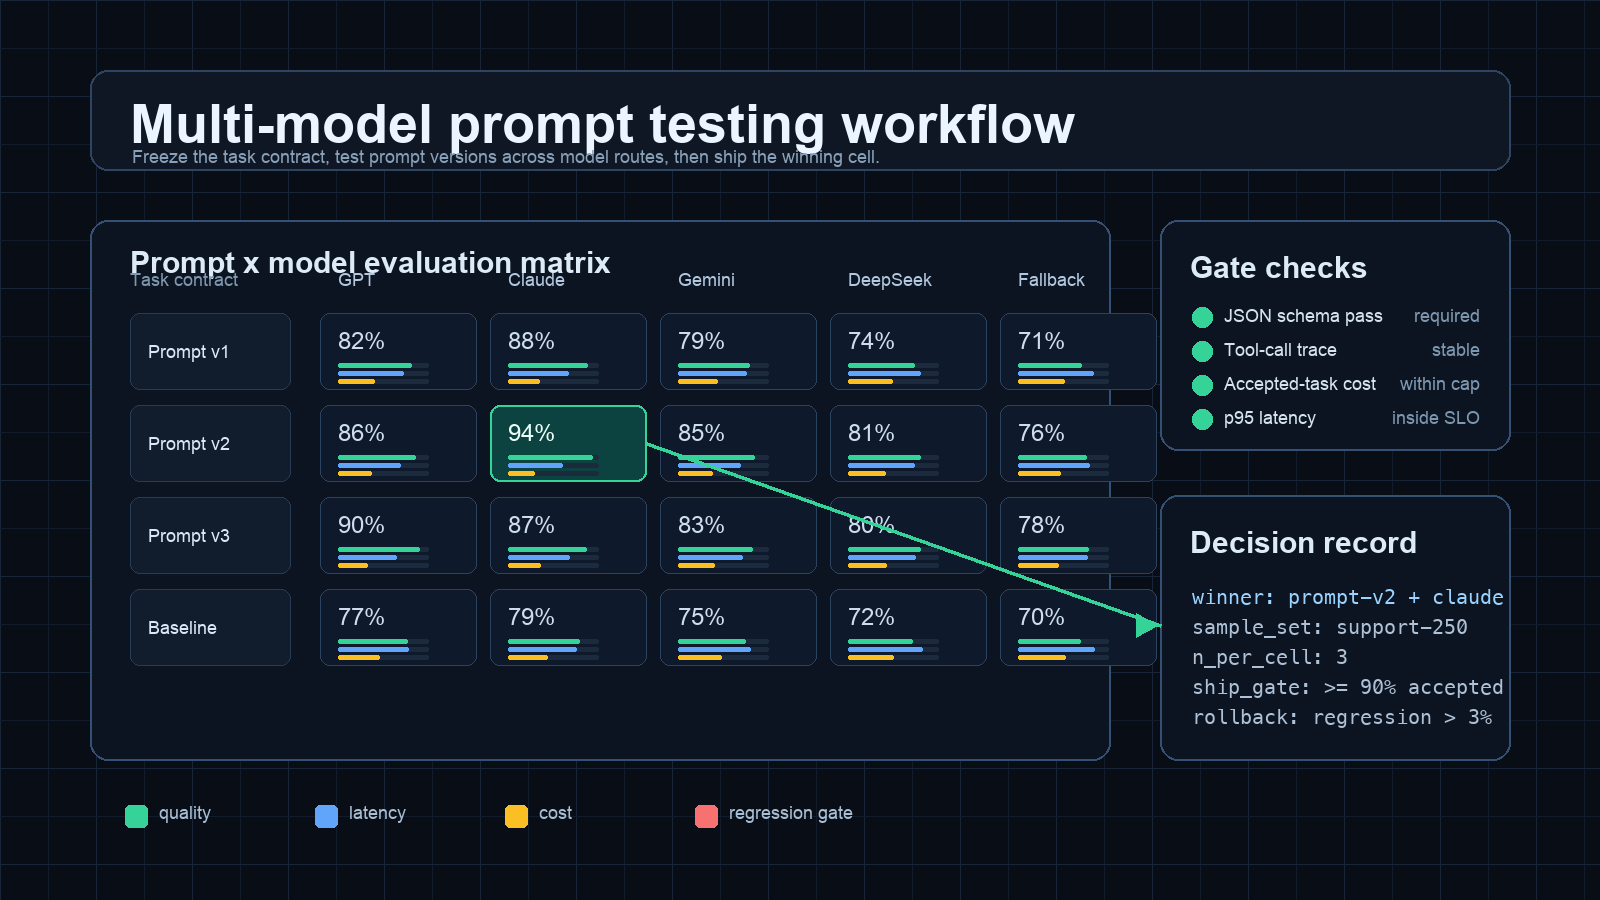
Langkah 2: Bangun Matriks Prompt x Model
Pisahkan variabelnya. Versi prompt dan rute model masing-masing harus memiliki sumbu sendiri.
| Sel pengujian | Prompt | Rute model | Menjawab apa |
|---|---|---|---|
| A1 | Prompt v1 | Default saat ini | Apakah baseline masih dapat diterima? |
| A2 | Prompt v1 | Rute kandidat yang lebih murah | Apakah prompt saat ini dapat dipindahkan? |
| B1 | Prompt v2 | Default saat ini | Apakah prompt meningkatkan kualitas tanpa mengubah model? |
| B2 | Prompt v2 | Rute kandidat yang lebih murah | Apakah ada pasangan prompt/model yang lebih baik? |
| C1 | Prompt v3 | Default saat ini | Apakah instruksi yang lebih ketat mengurangi kegagalan? |
| C2 | Prompt v3 | Rute premium kandidat | Apakah eskalasi sepadan dengan biaya tambahan? |
Matriks ini adalah inti dari workflow pengujian prompt multi-model. Ini mencegah kesalahan umum: menyalahkan model ketika prompt adalah variabel sebenarnya, atau memuji prompt ketika model yang menutupi instruksi lemah.
Langkah 3: Gunakan Dataset yang Representatif
Jangan mengevaluasi pada contoh yang paling mudah disalin. Bangun dataset kecil yang mencerminkan traffic nyata.
Untuk workflow dukungan, sertakan:
- Tiket umum yang seharusnya mudah.
- Kasus tepi tempat kebijakan sangat ketat.
- Tiket singkat yang ambigu.
- Tiket panjang dengan detail yang tidak relevan.
- Contoh multibahasa atau campuran bahasa jika memang muncul di produksi.
- Kegagalan historis yang sudah dikenal.
- Contoh yang seharusnya memicu handoff.
Untuk setiap baris, simpan perilaku yang diharapkan. Itu tidak selalu harus berupa jawaban emas yang sempurna, tetapi harus cukup memiliki ground truth agar validator atau peninjau dapat menentukan apakah hasilnya dapat diterima.
Dataset awal yang baik sering kali memiliki 50 hingga 250 baris. Itu cukup kecil untuk dijalankan berulang kali dan cukup besar untuk mengungkap lebih dari sekadar perilaku demo.
Langkah 4: Jalankan Matriks Dengan Sampel Berulang
Untuk ekstraksi atau klasifikasi yang deterministik, satu kali run per sel mungkin cukup untuk penyaringan awal. Untuk penulisan, penalaran, penggunaan alat, atau tugas agentik, jalankan beberapa sampel per sel.
Gunakan aturan awal ini:
| Jenis tugas | Contoh per baris pengujian |
|---|---|
| Klasifikasi ketat | 1 hingga 2 |
| Ekstraksi JSON | 2 |
| Penulisan untuk pelanggan | 3 |
| Pemanggilan alat | 3 |
| Penalaran konteks panjang | 3 hingga 5 |
| Alur kerja agen | 5 jika biaya memungkinkan |
Contoh yang berulang menunjukkan varians. Rute yang mendapat skor 94% sekali dan 71% pada putaran berikutnya belum siap produksi, meskipun sampel terbaiknya terlihat mengesankan.
Langkah 5: Validasi Struktur Sebelum Kualitas
Setiap workflow pengujian prompt multi-model harus menilai struktur sebelum selera. Jalankan pemeriksaan otomatis terlebih dahulu:
| Validator | Apa yang dideteksi |
|---|---|
| Parsing JSON | Output terstruktur yang tidak valid. |
| Validasi skema | Bidang hilang, enum salah, tipe salah. |
| Pemeriksaan regex atau kebijakan | Frasa yang tidak diperbolehkan, klaim yang dilarang, sitasi yang hilang. |
| Validator jejak alat | Alat salah, argumen hilang, efek samping tidak aman. |
| Pemeriksaan unit deterministik | Kategori salah, transformasi numerik salah, penanganan tanggal tidak valid. |
Hanya output struktural yang diterima yang boleh masuk ke peninjauan kualitas oleh manusia atau bantuan model. Itu menghemat waktu peninjau dan menjaga penilaian tetap adil di seluruh rute.
Langkah 6: Lacak Biaya per Tugas yang Diterima
Jangan membandingkan rute hanya berdasarkan harga daftar. Bandingkan apa yang sebenarnya dibayar tim untuk hasil yang diterima.
Gunakan metrik ini:
cost_per_accepted_task =
  total_cost_for_cell / accepted_outputs
Lalu tambahkan konteks:
accepted_output_rate =
  accepted_outputs / total_attempts

retry_adjusted_cost =
  total_cost_for_cell + retry_cost + reviewer_rerun_cost
Ini penting karena rute dengan harga token yang lebih rendah bisa menjadi lebih mahal jika menghasilkan lebih banyak JSON tidak valid, output yang lebih panjang, kesalahan pemanggilan alat, atau pengulangan manual. Flatkey Usage Logs dirancang untuk jenis peninjauan seperti ini: setiap permintaan dapat diperiksa berdasarkan model, token input, token output, biaya, kunci, status, dan stempel waktu.
Jika panduan biaya Anda yang ada masih hanya berbasis token, padukan artikel ini dengan alur kerja internal dari Cara Membandingkan Harga Model AI Sebelum Berpindah Penyedia API. Pengujian prompt harus menjawab pertanyaan berikutnya: rute mana yang menghasilkan pekerjaan yang diterima dengan biaya operasional terendah?
Langkah 7: Skor Matriks
Gunakan kartu skor berbobot. Buat versi pertama cukup sederhana agar produk, engineering, dan keuangan dapat menyepakatinya.
| Metrik | Bobot | Pengukuran |
|---|---|---|
| Contract pass rate | 30% | Pemeriksaan skema dan kebijakan yang diwajibkan lulus. |
| Human acceptance | 25% | Reviewer menerima jawaban untuk penggunaan produksi. |
| Cost per accepted task | 20% | Total biaya sel dibagi output yang diterima. |
| p95 latency | 15% | Latensi rute di bawah target workflow. |
| Regression safety | 10% | Tidak ada penurunan pada kasus kegagalan historis. |
Contoh keputusan:
| Sel prompt/model | Contract pass | Human accept | Cost/task | p95 latency | Keputusan akhir |
|---|---|---|---|---|---|
| Prompt v1 + route saat ini | 88% | 84% | 1.00x | Lulus | Pertahankan sebagai baseline cadangan |
| Prompt v2 + route saat ini | 93% | 91% | 1.04x | Lulus | Kuat tetapi bukan yang termurah |
| Prompt v2 + route yang lebih murah | 91% | 89% | 0.62x | Lulus | Rilis untuk lalu lintas default |
| Prompt v3 + route yang lebih murah | 84% | 80% | 0.58x | Lulus | Tolak karena penurunan kualitas |
| Prompt v2 + route premium | 96% | 94% | 2.30x | Perbatasan | Gunakan hanya untuk eskalasi |
Sel pemenang tidak selalu skor kualitas tertinggi. Sel pemenang adalah sel yang lolos gate kualitas, latensi, keandalan, dan biaya untuk tugas tersebut.
Langkah 8: Simpan Rekam Keputusan
Pengujian prompt yang tidak dapat diulang bukanlah sebuah workflow. Simpan rekam keputusan dengan prompt, route, dataset, scorecard, dan kondisi rollback.
workflow: support_reply_generation
decision_date: 2026-09-26
dataset: support-eval-250
winner:
  prompt_version: prompt-v2
  model_route: candidate-cheaper-route
  reason: "Lolos gate kualitas dengan biaya per tugas yang diterima lebih rendah"
baseline:
  prompt_version: prompt-v1
  model_route: current-default
metrics:
  accepted_output_rate: 0.91
  cost_per_accepted_task_index: 0.62
  p95_latency_status: pass
regression_gates:
  - invalid_json_rate <= 0.02
  - policy_failure_rate <= 0.01
  - historical_failure_pass_rate >= 0.95
rollback_if:
  - accepted_output_rate drops below 0.88 for two days
  - p95 latency misses target for one release window
  - cost per accepted task rises above budget cap
Rekam ini memungkinkan evaluator berikutnya bertanya: apakah model baru mengalahkan sel produksi saat ini, atau hanya mengalahkan ingatan lama tentang produk?
Kerangka Runner yang Bisa Disalin
Kerangka bergaya TypeScript ini menunjukkan bentuk loop pengujian. Sesuaikan dengan stack Anda.
type PromptVersion = {
  id: string;
  system: string;
};

type ModelRoute = {
  id: string;
  model: string;
};

type EvalRow = {
  id: string;
  input: Record<string, unknown>;
  expected: Record<string, unknown>;
};

type EvalResult = {
  rowId: string;
  promptId: string;
  routeId: string;
  sample: number;
  outputText: string;
  validJson: boolean;
  schemaPass: boolean;
  accepted: boolean;
  latencyMs: number;
  costUsd?: number;
};

async function runCell(
  prompt: PromptVersion,
  route: ModelRoute,
  rows: EvalRow[],
  samplesPerRow: number
): Promise<EvalResult[]> {
  const results: EvalResult[] = [];

  for (const row of rows) {
    for (let sample = 0; sample < samplesPerRow; sample++) {
      const started = Date.now();

      const response = await callModel({
        model: route.model,
        system: prompt.system,
        input: row.input,
      });

      const latencyMs = Date.now() - started;
      const parsed = safeJsonParse(response.text);
      const schemaPass = parsed.ok && validateSchema(parsed.value);
      const accepted = schemaPass && validateExpected(parsed.value, row.expected);

      results.push({
        rowId: row.id,
        promptId: prompt.id,
        routeId: route.id,
        sample,
        outputText: response.text,
        validJson: parsed.ok,
        schemaPass,
        accepted,
        latencyMs,
        costUsd: response.usageCost,
      });
    }
  }

  return results;
}
Bagian pentingnya bukan bahasanya. Yang penting adalah setiap baris hasil memiliki versi prompt, route, nomor sampel, hasil validator, latensi, dan field biaya.
Apa yang Perlu Ditinjau di Flatkey Setelah Run Selesai
Setelah matriks selesai, tinjau jendela pengujian yang sama di Flatkey:
- Filter log penggunaan berdasarkan test API key.
- Kelompokkan berdasarkan model route.
- Ekspor log permintaan jika finance atau ops memerlukan tinjauan spreadsheet.
- Bandingkan token input, token output, status, dan biaya per route.
- Periksa apakah kegagalan terkonsentrasi pada satu versi prompt, satu model, atau satu segmen dataset.
Kemudian hubungkan hasilnya ke kebijakan routing Anda. Jika route default menang dalam kualitas tetapi route yang lebih murah menang dalam biaya task yang diterima untuk kasus sederhana, Anda mungkin tidak memerlukan satu pemenang. Anda mungkin memerlukan route default, route eskalasi, dan route fallback. Untuk langkah berikutnya, gunakan logika routing dalam Model Fallback Strategy Workflow Playbook.
Kesalahan Umum
| Kesalahan | Perbaikan |
|---|---|
| Menguji hanya prompt final pada lima contoh | Gunakan dataset yang representatif dan beberapa versi prompt. |
| Membandingkan model tanpa validator | Parse dan cek skema setiap output terstruktur terlebih dahulu. |
| Mengoptimalkan hanya untuk skor rata-rata | Lacak varians dan kasus kegagalan historis. |
| Mengabaikan retry | Gunakan biaya per task yang diterima, bukan biaya per panggilan mentah. |
| Lupa latensi | Route berkualitas tinggi tetap bisa gagal dalam pengalaman produk. |
| Menghilangkan keputusan | Simpan hasil matriks sebagai baseline regresi. |
Bagaimana Ini Terhubung ke Peramalan Biaya
URL kanonik untuk artikel ini adalah tentang peramalan pengeluaran AI API karena pengujian prompt adalah salah satu tempat pertama pengeluaran AI menjadi tidak dapat diprediksi. workflow pengujian prompt multi-model yang diperbarui membuat pengeluaran dapat diprediksi dengan mengubah evaluasi menjadi tabel yang dapat diulang:
| Input perkiraan | Berasal dari |
|---|---|
| Volume pengujian | Baris dataset x versi prompt x rute model x sampel. |
| Tingkat retry | Validator yang gagal dan output yang ditolak. |
| Biaya per tugas yang diterima | Log penggunaan dan jumlah output yang diterima. |
| Buffer peluncuran | Risiko regresi, porsi fallback, dan pertumbuhan yang diharapkan. |
| Kontrol anggaran | Kuota per kunci, batas bulanan, dan frekuensi tinjau penggunaan. |
Untuk rencana peluncuran yang siap untuk keuangan, hubungkan matriks pengujian dengan Manajemen Pengeluaran AI API untuk Tim Operasi dan Keuangan.
FAQ
Apa itu workflow pengujian prompt multi-model?
workflow pengujian prompt multi-model adalah proses yang dapat diulang untuk menguji beberapa versi prompt di beberapa rute model, memberi skor pada setiap sel dengan validator, tinjauan kualitas, biaya, latensi, dan gate regresi.
Berapa banyak contoh yang saya perlukan?
Mulailah dengan 50 hingga 250 baris representatif. Tambahkan lebih banyak baris ketika tugasnya berisiko tinggi, trafiknya beragam, atau rutenya akan membuat keputusan otonom.
Haruskah saya menggunakan LLM judge?
Bisa, tetapi jangan jadikan itu gate pertama. Gunakan validator deterministik untuk skema, kebijakan, dan persyaratan yang tepat sebelum penilaian berbantuan model. Tinjauan manusia tetap penting untuk workflow yang kritis saat peluncuran.
Seberapa sering kami harus menjalankan ulang workflow ini?
Jalankan ulang sebelum mengganti model default, mengubah prompt utama, menambahkan rute fallback, mengubah skema alat, atau meluncurkan ke segmen baru. Jalankan ulang juga set regresi yang lebih kecil setelah pembaruan penyedia atau model.
Di mana Flatkey berperan?
Flatkey memberi tim satu kunci API dan satu katalog model untuk pengujian multi-rute, plus visibilitas penggunaan untuk nama model, jumlah token, biaya permintaan, kunci, status, dan timestamp. Itu membuat workflow pengujian prompt multi-model lebih mudah dijalankan dan lebih mudah dijelaskan kepada keuangan atau operasi.
Kesimpulan Akhir
Prompt yang menang bukanlah sebuah prompt. Itu adalah sel prompt/model yang lolos kontrak tugas dalam kondisi lalu lintas, anggaran, dan latensi yang realistis. Gunakan workflow pengujian prompt multi-model di atas untuk mengubah pemilihan model dari sebuah perdebatan menjadi jejak bukti: dataset, matriks, validator, biaya per tugas yang diterima, gate regresi, dan catatan keputusan.
Ketika tim Anda siap menguji melalui satu permukaan yang kompatibel dengan OpenAI, mulailah dengan panduan cepat Flatkey, verifikasi rute yang tersedia dengan daftar model, dan periksa pengeluaran di Log Penggunaan.