Se a sua equipe testa prompts em um modelo por vez, provavelmente está medindo a coisa errada. Um prompt que parece forte em uma rota pode falhar em um contrato JSON em outra, ficar lento demais com um contexto mais longo ou parecer barato até que as tentativas repetidas e as saídas rejeitadas sejam incluídas.
Este guia oferece às equipes de produto de IA um fluxo de trabalho prático de teste de prompts multi-modelo para comparar versões de prompts entre rotas de modelos antes do lançamento. O objetivo não é coroar um vencedor universal. O objetivo é separar qualidade do prompt, adequação ao modelo, latência e custo para que a equipe possa escolher uma rota com evidências em vez de capturas de tela de um playground.
Flatkey é útil neste fluxo de trabalho porque a mesma conta pode chamar muitas rotas de modelos por meio de uma API compatível com OpenAI, inspecionar os modelos disponíveis por meio da lista de modelos e revisar registros de uso em nível de requisição com nomes de modelos, contagem de tokens, custo por requisição, status e carimbos de data/hora. Use essa camada compartilhada para executar o teste e, depois, armazene a célula vencedora prompt/modelo como uma linha de base de regressão.
A Resposta Curta
Um fluxo de trabalho de teste de prompts multi-modelo confiável tem oito partes:
- Congele o contrato da tarefa antes de tocar nas configurações do modelo.
- Separe a versão do prompt e a rota do modelo em variáveis distintas.
- Use um conjunto de dados representativo, não três exemplos favoritos.
- Execute amostras repetidas quando a não determinismo importar.
- Valide a estrutura com código antes de pedir a um humano que avalie a qualidade.
- Acompanhe o custo por tarefa aceita, não apenas o preço por token.
- Promova um vencedor somente se ele passar nos gates de regressão.
- Armazene o registro da decisão para que o próximo teste de modelo comece com evidências.
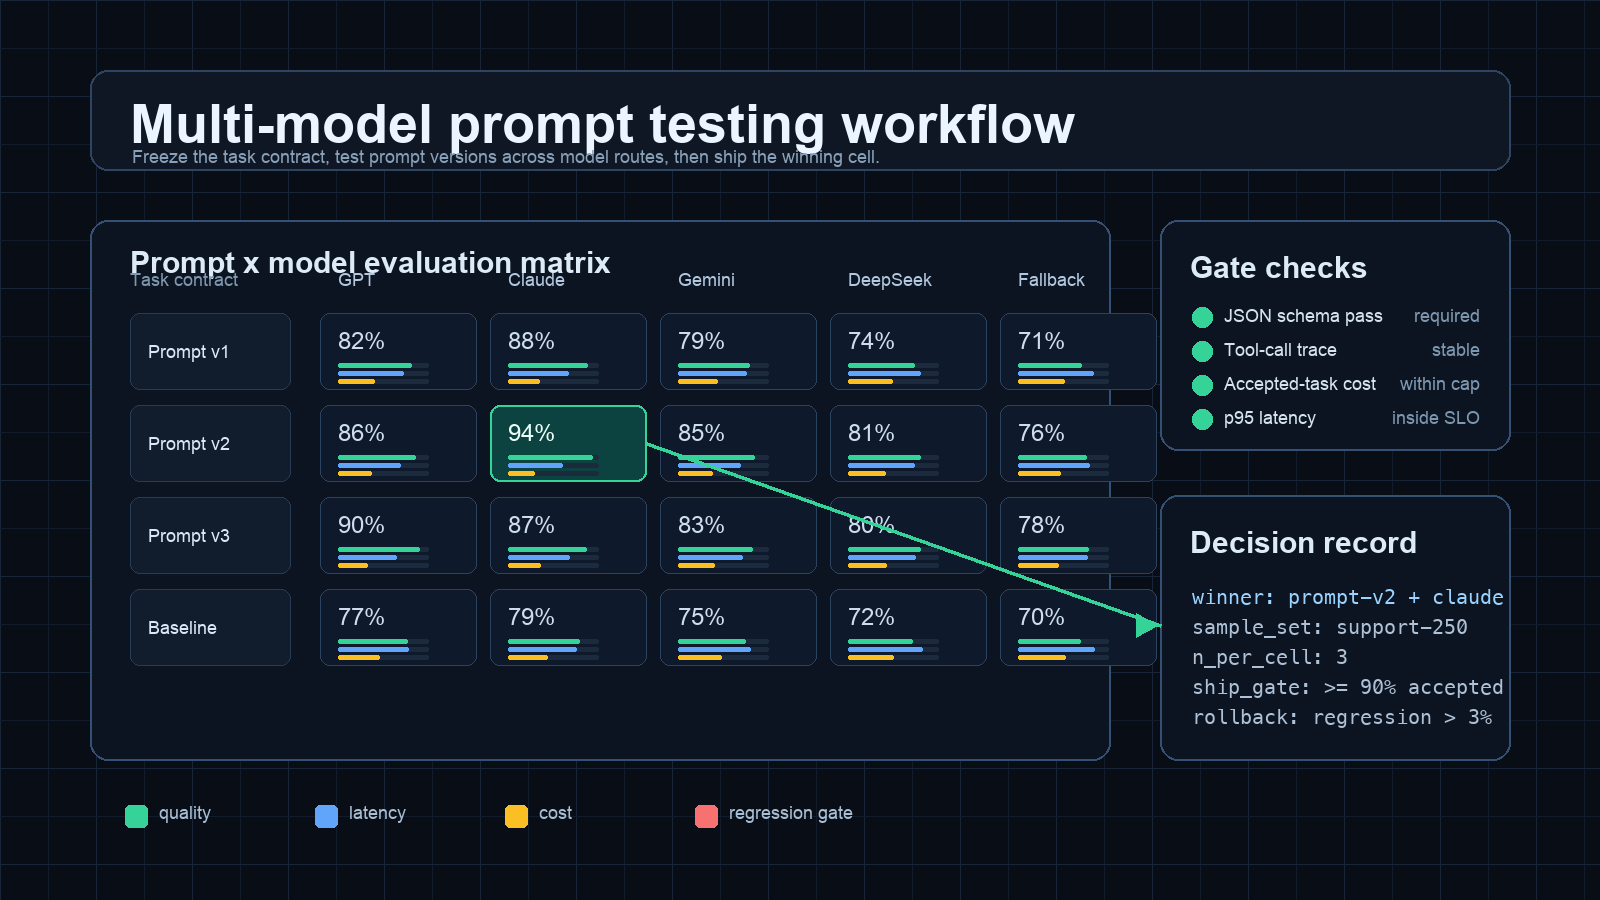
Essa é a diferença entre "Claude pareceu melhor em uma demo" e "Prompt v2 na rota B passou em 94% dos nossos testes de contrato, ficou abaixo da nossa meta de latência p95 e reduziu o custo por tarefa aceita após as novas tentativas."
Quando Você Precisa Deste Fluxo de Trabalho
Use um fluxo de trabalho de teste de prompts multi-modelo quando uma destas condições for verdadeira:
| Situação | Por que o teste em um único modelo é fraco |
|---|---|
| Você está trocando de um provedor para outro | A formulação do prompt, o comportamento de chamadas de ferramentas, a confiabilidade da saída estruturada e o estilo de recusa podem mudar. |
| Você está adicionando uma rota de fallback mais barata | O modelo mais barato pode precisar de um prompt diferente ou de um validador mais rigoroso para produzir resultados aceitos. |
| Você está testando prompts de contexto longo | O tamanho do contexto altera custo, latência, comportamento de cache e a chance de desvio de instruções. |
| Você está lançando um fluxo de trabalho de produto | Demonstrações internas ocultam tentativas repetidas, saídas rejeitadas e escalonamentos para suporte. |
| Você precisa de visibilidade financeira | O financeiro não se importa apenas com o preço por token; ele precisa do custo por tarefa aceita e de limites orçamentários. |
Se a decisão afeta o comportamento em produção, não teste "modelo A vs modelo B" como uma verificação de sensação. Teste versão do prompt por rota do modelo como uma matriz.
Passo 1: Congele O Contrato Da Tarefa
Antes de comparar modelos, escreva o contrato que o modelo precisa cumprir. Um contrato de tarefa deve definir:
| Campo | Exemplo |
|---|---|
| Trabalho do usuário | Classifique tickets de suporte e elabore uma resposta segura. |
| Formato de entrada | Texto do ticket, nível do cliente, área do produto, contagem de respostas anteriores. |
| Saída obrigatória | JSON com category, priority, reply, handoff_required e reason_codes. |
| Falhas críticas | JSON inválido, campo obrigatório ausente, promessa não suportada, linguagem de reembolso insegura. |
| Critérios de qualidade | Categoria correta, resposta concisa, nenhuma política inventada, motivo de escalonamento útil. |
| Limites operacionais | latência p95 abaixo de 4 segundos, custo por tarefa aceita abaixo do teto da equipe. |
Faça isso primeiro porque o contrato mantém o fluxo de trabalho de teste de prompts multi-modelo honesto. Sem ele, os revisores vão otimizar para a resposta que parece melhor em um exemplo, e não para o caminho que sobrevive em produção.
Etapa 2: Crie a Matriz Prompt x Modelo
Separe as variáveis. A versão do prompt e a rota do modelo devem ter cada uma seu próprio eixo.
| Celula de teste | Prompt | Rota do modelo | O que responde |
|---|---|---|---|
| A1 | Prompt v1 | Default atual | O baseline ainda é aceitável? |
| A2 | Prompt v1 | Rota candidata mais barata | O prompt atual funciona nessa rota? |
| B1 | Prompt v2 | Default atual | O prompt melhorou a qualidade sem mudar o modelo? |
| B2 | Prompt v2 | Rota candidata mais barata | Existe uma combinação melhor de prompt/modelo? |
| C1 | Prompt v3 | Default atual | Instruções mais rígidas reduziram falhas? |
| C2 | Prompt v3 | Rota candidata premium | A escalada vale o custo adicional? |
Essa matriz é o coração do fluxo de trabalho de teste de prompts multi-modelo. Ela evita um erro comum: culpar o modelo quando o prompt é a variável real, ou elogiar o prompt quando o modelo está compensando instruções fracas.
Etapa 3: Use Um Conjunto De Dados Representativo
Não avalie com os exemplos mais fáceis de copiar. Monte um pequeno conjunto de dados que reflita o tráfego real.
Para um fluxo de trabalho de suporte, inclua:
- Tickets comuns que devem ser fáceis.
- Casos extremos em que a política é rígida.
- Tickets curtos e ambíguos.
- Tickets longos com detalhes irrelevantes.
- Exemplos multilíngues ou em idioma misto, se ocorrerem em produção.
- Falhas históricas conhecidas.
- Exemplos que devem acionar handoff.
Para cada linha, mantenha o comportamento esperado. Nem sempre é necessário um golden answer perfeito, mas é preciso ground truth suficiente para que um validador ou revisor decida se o resultado é aceitável.
Um bom primeiro conjunto de dados costuma ter de 50 a 250 linhas. Isso é pequeno o bastante para executar repetidamente e grande o suficiente para expor mais do que comportamento de demo.
Etapa 4: Execute A Matriz Com Amostras Repetidas
Para extração ou classificação determinísticas, uma execução por célula pode ser suficiente para uma triagem inicial. Para escrita, raciocínio, uso de ferramentas ou tarefas agentivas, execute várias amostras por célula.
Use esta regra inicial:
| Tipo de tarefa | Exemplos por linha de teste |
|---|---|
| Classificação rígida | 1 a 2 |
| Extração de JSON | 2 |
| Redação voltada ao cliente | 3 |
| Chamada de ferramenta | 3 |
| Raciocínio de contexto longo | 3 a 5 |
| Fluxo de trabalho de agente | 5 se o custo permitir |
Exemplos repetidos mostram variância. Uma rota que marca 94% uma vez e 71% na passagem seguinte não está pronta para produção, mesmo que o melhor exemplo pareça impressionante.
Etapa 5: Valide a estrutura antes da qualidade
Todo fluxo de trabalho de teste de prompts multi-modelo deve avaliar a estrutura antes do estilo. Execute primeiro as verificações automatizadas:
| Validador | O que ele detecta |
|---|---|
| Parse de JSON | Saída estruturada inválida. |
| Validação de esquema | Campos ausentes, enum incorreto, tipo incorreto. |
| Verificações de regex ou política | Frases não permitidas, alegações proibidas, citações ausentes. |
| Validador de rastreamento de ferramenta | Ferramenta errada, argumento ausente, efeito colateral inseguro. |
| Verificações unitárias determinísticas | Categoria errada, transformação numérica errada, tratamento de data inválido. |
Somente saídas estruturais aceitas devem chegar à revisão de qualidade feita por humanos ou assistida por modelo. Isso economiza tempo dos revisores e mantém a pontuação justa entre as rotas.
Etapa 6: Acompanhe o custo por tarefa aceita
Não compare rotas apenas pelo preço de tabela. Compare o que a equipe realmente paga por resultados aceitos.
Use esta métrica:
cost_per_accepted_task =
  total_cost_for_cell / accepted_outputs
Depois, adicione contexto:
accepted_output_rate =
  accepted_outputs / total_attempts

retry_adjusted_cost =
  total_cost_for_cell + retry_cost + reviewer_rerun_cost
Isso importa porque uma rota com preço por token menor pode se tornar mais cara se gerar mais JSON inválido, saídas mais longas, erros de chamada de ferramenta ou reexecuções manuais. Os Flatkey Usage Logs foram projetados para esse tipo de análise: cada solicitação pode ser inspecionada por modelo, tokens de entrada, tokens de saída, custo, chave, status e timestamp.
Se o seu guia de custos existente ainda for apenas por token, combine este artigo com o fluxo de trabalho interno de Como comparar preços de modelos de IA antes de trocar de provedor de API. O teste de prompt deve responder à próxima pergunta: qual rota produz trabalho aceito com o menor custo operacional?
Etapa 7: Pontue a matriz
Use um cartão de pontuação ponderado. Mantenha a primeira versão simples o suficiente para que produto, engenharia e finanças concordem com ela.
| Métrica | Peso | Medição |
|---|---|---|
| Taxa de aprovação de contrato | 30% | As verificações obrigatórias de esquema e política são aprovadas. |
| Aceitação humana | 25% | O revisor aceita a resposta para uso em produção. |
| Custo por tarefa aceita | 20% | O gasto total da célula dividido pelos resultados aceitos. |
| Latência p95 | 15% | Latência da rota dentro da meta do fluxo de trabalho. |
| Segurança contra regressões | 10% | Sem queda nos casos históricos de falha. |
Exemplo de decisão:
| Célula de prompt/modelo | Aprovação de contrato | Aceitação humana | Custo/tarefa | Latência p95 | Decisão final |
|---|---|---|---|---|---|
| Prompt v1 + rota atual | 88% | 84% | 1.00x | Aprovado | Manter como linha de base de fallback |
| Prompt v2 + rota atual | 93% | 91% | 1.04x | Aprovado | Forte, mas não o mais barato |
| Prompt v2 + rota mais barata | 91% | 89% | 0.62x | Aprovado | Implantar para o tráfego padrão |
| Prompt v3 + rota mais barata | 84% | 80% | 0.58x | Aprovado | Rejeitar devido à queda de qualidade |
| Prompt v2 + rota premium | 96% | 94% | 2.30x | Limítrofe | Usar apenas para escalonamento |
A célula vencedora nem sempre é a de maior pontuação de qualidade. Ela é a célula que atende às restrições de qualidade, latência, confiabilidade e custo para o trabalho.
Passo 8: Armazenar um registro de decisão
Um teste de prompt que não pode ser repetido não é um fluxo de trabalho. Salve o registro de decisão com o prompt, a rota, o conjunto de dados, o painel de pontuação e as condições de reversão.
workflow: support_reply_generation
decision_date: 2026-09-26
dataset: support-eval-250
winner:
  prompt_version: prompt-v2
  model_route: candidate-cheaper-route
  reason: "Passou na barreira de qualidade com menor custo por tarefa aceita"
baseline:
  prompt_version: prompt-v1
  model_route: current-default
metrics:
  accepted_output_rate: 0.91
  cost_per_accepted_task_index: 0.62
  p95_latency_status: pass
regression_gates:
  - invalid_json_rate <= 0.02
  - policy_failure_rate <= 0.01
  - historical_failure_pass_rate >= 0.95
rollback_if:
  - accepted_output_rate drops below 0.88 for two days
  - p95 latency misses target for one release window
  - cost per accepted task rises above budget cap
Esse registro permite que o próximo avaliador pergunte: o novo modelo superou a célula atual de produção, ou apenas superou uma memória antiga do produto?
Um esqueleto de executor copiável
Este esqueleto no estilo TypeScript mostra a estrutura do loop de teste. Adapte-o à sua stack.
type PromptVersion = {
  id: string;
  system: string;
};

type ModelRoute = {
  id: string;
  model: string;
};

type EvalRow = {
  id: string;
  input: Record<string, unknown>;
  expected: Record<string, unknown>;
};

type EvalResult = {
  rowId: string;
  promptId: string;
  routeId: string;
  sample: number;
  outputText: string;
  validJson: boolean;
  schemaPass: boolean;
  accepted: boolean;
  latencyMs: number;
  costUsd?: number;
};

async function runCell(
  prompt: PromptVersion,
  route: ModelRoute,
  rows: EvalRow[],
  samplesPerRow: number
): Promise<EvalResult[]> {
  const results: EvalResult[] = [];

  for (const row of rows) {
    for (let sample = 0; sample < samplesPerRow; sample++) {
      const started = Date.now();

      const response = await callModel({
        model: route.model,
        system: prompt.system,
        input: row.input,
      });

      const latencyMs = Date.now() - started;
      const parsed = safeJsonParse(response.text);
      const schemaPass = parsed.ok && validateSchema(parsed.value);
      const accepted = schemaPass && validateExpected(parsed.value, row.expected);

      results.push({
        rowId: row.id,
        promptId: prompt.id,
        routeId: route.id,
        sample,
        outputText: response.text,
        validJson: parsed.ok,
        schemaPass,
        accepted,
        latencyMs,
        costUsd: response.usageCost,
      });
    }
  }

  return results;
}
A parte importante não é a linguagem. A parte importante é que cada linha de resultado tenha versão do prompt, rota, número da amostra, resultados do validador, latência e campos de custo.
O que revisar no Flatkey após a execução
Depois que a matriz terminar, revise a mesma janela de teste no Flatkey:
- Filtre os logs de uso pela chave de API de teste.
- Agrupe por rota de modelo.
- Exporte os logs de requisição se finanças ou operações precisarem de revisão em planilha.
- Compare tokens de entrada, tokens de saída, status e custo por rota.
- Verifique se as falhas se concentraram em uma versão de prompt, um modelo ou um segmento do conjunto de dados.
Depois conecte o resultado à sua política de roteamento. Se a rota padrão vencer em qualidade, mas uma rota mais barata vencer no custo por tarefa aceita para casos simples, talvez você não precise de um único vencedor. Você pode precisar de uma rota padrão, uma rota de escalonamento e uma rota de fallback. Para essa próxima etapa, use a lógica de roteamento no Model Fallback Strategy Workflow Playbook.
Erros comuns
| Erro | Correção |
|---|---|
| Testar apenas o prompt final em cinco exemplos | Use um conjunto de dados representativo e várias versões de prompt. |
| Comparar modelos sem validadores | Faça o parse e a verificação de esquema de toda saída estruturada primeiro. |
| Otimizar apenas pela pontuação média | Acompanhe a variância e os casos históricos de falha. |
| Ignorar retries | Use custo por tarefa aceita, não custo por chamada bruta. |
| Esquecer a latência | Uma rota de alta qualidade ainda pode falhar na experiência do produto. |
| Perder a decisão | Armazene o resultado da matriz como uma linha de base de regressão. |
Como isso se conecta à previsão de custos
A URL canônica deste artigo trata de previsão de gastos com API de IA porque o teste de prompts é um dos primeiros lugares em que os gastos com IA se tornam imprevisíveis. O fluxo de trabalho de teste de prompts multi-modelo atualizado torna os gastos previsíveis ao transformar a avaliação em uma tabela repetível:
| Entrada de previsão | Vem de |
|---|---|
| Volume de teste | Linhas do conjunto de dados x versões de prompt x rotas de modelo x amostras. |
| Taxa de repetição | Validadores com falha e saídas rejeitadas. |
| Custo por tarefa aceita | Registros de uso e contagem de saídas aceitas. |
| Reserva de lançamento | Risco de regressão, participação de fallback e crescimento esperado. |
| Controles de orçamento | Cota por chave, limite mensal e cadência de revisão de uso. |
Para um plano de implantação pronto para finanças, conecte a matriz de testes a Gerenciamento de gastos com API de IA para equipes de Operações e Finanças.
FAQ
O que é um fluxo de trabalho de teste de prompts multi-modelo?
Um fluxo de trabalho de teste de prompts multi-modelo é um processo repetível para testar várias versões de prompt em várias rotas de modelo, pontuando cada célula com validadores, revisão de qualidade, custo, latência e limites de regressão.
De quantos exemplos eu preciso?
Comece com 50 a 250 linhas representativas. Adicione mais linhas quando a tarefa for de alto risco, o tráfego for diversificado ou a rota tomar decisões autônomas.
Devo usar um juiz LLM?
Você pode, mas não o torne a primeira etapa de validação. Use validadores determinísticos para esquema, política e requisitos exatos antes da avaliação assistida por modelo. A revisão humana ainda é importante para fluxos de trabalho críticos de lançamento.
Com que frequência devemos executar o fluxo novamente?
Execute novamente antes de trocar os modelos padrão, alterar prompts importantes, adicionar rotas de fallback, mudar esquemas de ferramentas ou lançar para um novo segmento. Execute novamente também um conjunto menor de regressão após atualizações do provedor ou do modelo.
Onde a Flatkey entra?
A Flatkey oferece às equipes uma chave de API e um catálogo de modelos para testes multi-rota, além de visibilidade de uso por nome do modelo, contagens de tokens, custo da solicitação, chave, status e carimbo de data e hora. Isso torna o fluxo de trabalho de teste de prompts multi-modelo mais fácil de executar e mais fácil de explicar para finanças ou operações.
Conclusão final
O prompt vencedor não é um prompt. É uma célula prompt/modelo que atende ao contrato da tarefa sob condições realistas de tráfego, orçamento e latência. Use o fluxo de trabalho de teste de prompts multi-modelo acima para transformar a escolha do modelo de um debate em um registro de evidências: conjunto de dados, matriz, validadores, custo por tarefa aceita, limites de regressão e um registro de decisão.
Quando sua equipe estiver pronta para testar por meio de uma única superfície compatível com OpenAI, comece com o guia de início rápido da Flatkey, verifique as rotas disponíveis com a lista de modelos e inspecione os gastos em Registros de uso.