如果你的团队一次只在一个模型上测试提示词,那么你很可能测错了东西。一个在某条路径上表现很强的提示词,到了另一条路径上可能会违反 JSON 合约;在更长的上下文中可能变得过慢;或者看起来很便宜,直到把重试和被拒绝的输出也算进去。
本指南为 AI 产品团队提供了一个实用的多模型提示测试工作流,用于在发布前比较不同模型路径上的提示词版本。目标不是选出一个放之四海而皆准的赢家,而是把提示词质量、模型适配性、延迟和成本区分开来,让团队能够基于证据而不是试玩台里的截图来选择路径。
Flatkey 在这个工作流中很有用,因为同一个账号可以通过兼容 OpenAI 的 API 调用多种模型路径,通过模型列表查看可用模型,并用请求级使用日志审查模型名称、token 数量、单次请求成本、状态和时间戳。利用这一共享层来运行测试,然后把获胜的提示词/模型单元格保存为回归基线。
简短答案
一个可靠的多模型提示测试工作流包含八个部分:
- 在接触模型设置之前先冻结任务合约。
- 将提示词版本和模型路径拆分为独立变量。
- 使用具有代表性的数据集,而不是三个最喜欢的示例。
- 在非确定性重要时运行重复采样。
- 先用代码验证结构,再请人类评估质量。
- 跟踪每个被接受任务的成本,而不仅仅是 token 价格。
- 只有通过回归门槛时才推广获胜方案。
- 保存决策记录,以便下一次模型测试从证据开始。
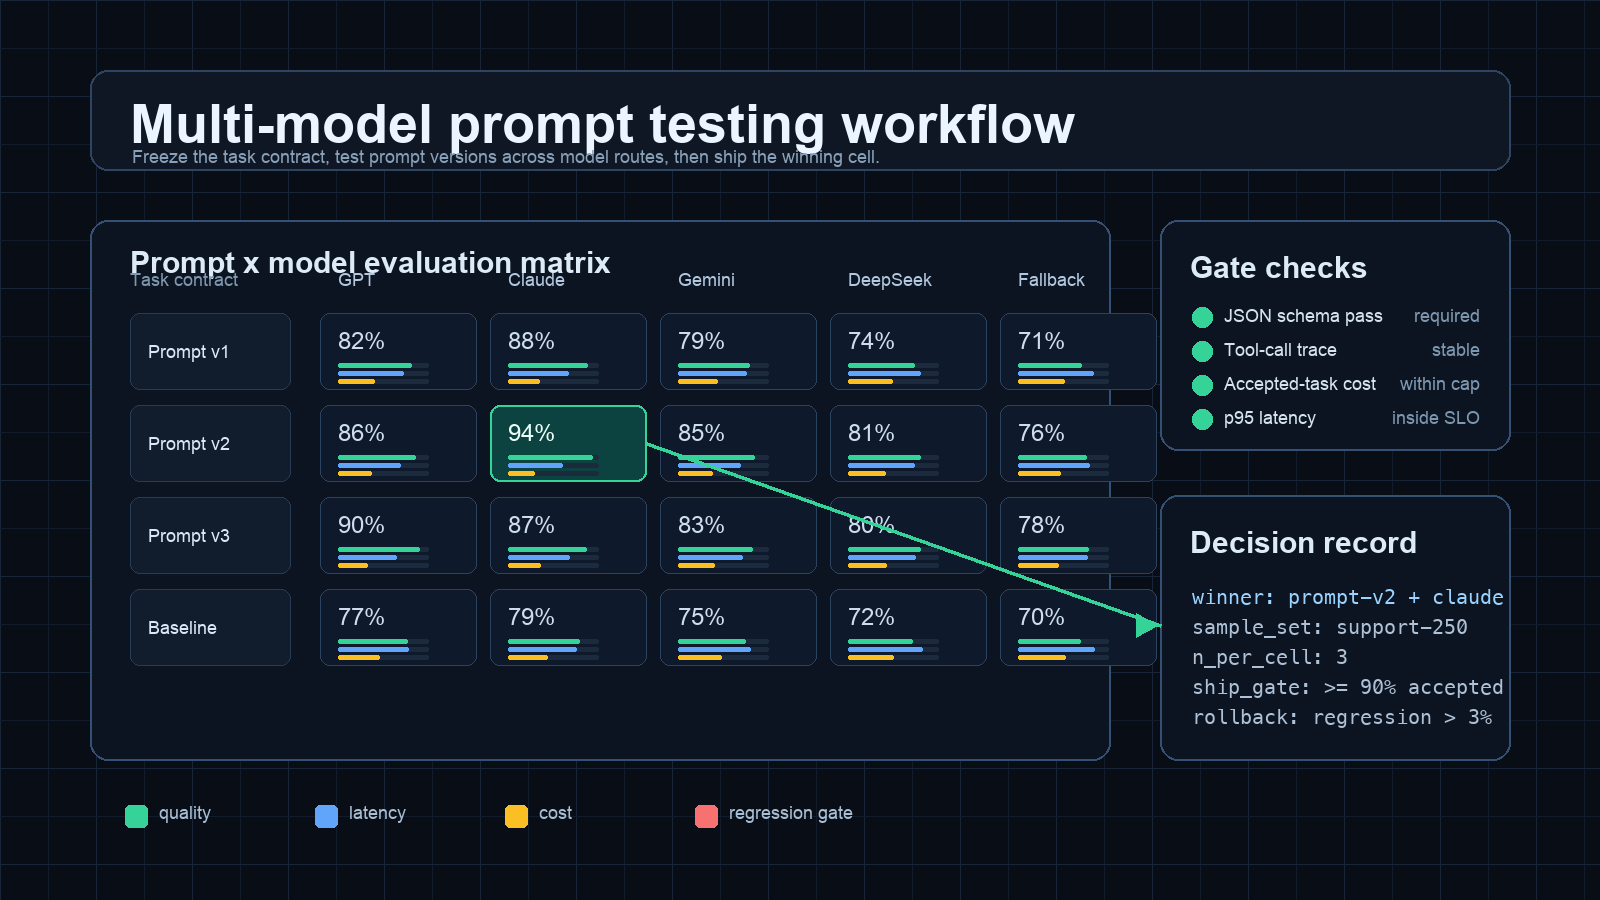
这就是“Claude 在演示里看起来更好”和“路径 B 上的 Prompt v2 通过了我们 94% 的合约测试,保持在 p95 延迟目标以内,并在计入重试后降低了每个被接受任务的成本”之间的区别。
何时需要这个工作流
当以下任一情况成立时,请使用多模型提示测试工作流:
| 场景 | 为什么单模型测试较弱 |
|---|---|
| 你正在从一个提供商切换到另一个提供商 | 提示词措辞、工具调用行为、结构化输出可靠性以及拒绝风格都可能变化。 |
| 你正在添加一个更便宜的回退路径 | 更便宜的模型可能需要不同的提示词,或需要更严格的验证器,才能产出可接受的结果。 |
| 你正在测试长上下文提示词 | 上下文长度会改变成本、延迟、缓存行为,以及指令漂移的概率。 |
| 你正在发布一个产品工作流 | 内部演示会掩盖重试、被拒绝的输出以及支持升级处理。 |
| 你需要财务可见性 | 财务并不只关心 token 价格;他们需要每个被接受任务的成本和预算护栏。 |
如果这个决策会影响生产行为,不要把“模型 A 对比模型 B”当作一种直觉检查。要把提示词版本与模型路径作为一个矩阵来测试。
第 1 步:冻结任务合约
在比较模型之前,先写下模型必须满足的合约。任务合约应定义:
| 字段 | 示例 |
|---|---|
| 用户工作 | 对支持工单进行分类并起草一条安全回复。 |
| 输入形态 | 工单文本、客户等级、产品领域、先前回复次数。 |
| 所需输出 | 包含 category、priority、reply、handoff_required 和 reason_codes 的 JSON。 |
| 严重失败 | 无效 JSON、缺少必需字段、不受支持的承诺、不安全的退款措辞。 |
| 质量标准 | 分类正确、回复简洁、不编造政策、升级原因有用。 |
| 运行限制 | p95 延迟低于 4 秒,单个被接受任务的成本低于团队上限。 |
先做这一步,因为契约会让多模型提示测试工作流保持诚实。没有它,评审会优化在某个示例里看起来最好的回复,而不是能在生产中存活的路径。
步骤 2:构建提示 x 模型矩阵
把变量分开。提示版本和模型路由都应该各自有自己的轴。
| 测试单元 | 提示 | 模型路由 | 它回答什么问题 |
|---|---|---|---|
| A1 | 提示 v1 | 当前默认 | 基线是否仍然可接受? |
| A2 | 提示 v1 | 候选更便宜路由 | 当前提示是否可迁移? |
| B1 | 提示 v2 | 当前默认 | 提示是否在不更换模型的情况下提升了质量? |
| B2 | 提示 v2 | 候选更便宜路由 | 是否存在更好的提示/模型组合? |
| C1 | 提示 v3 | 当前默认 | 更严格的指令是否减少了失败? |
| C2 | 提示 v3 | 候选高端路由 | 升级是否值得增加的成本? |
这个矩阵是多模型提示测试工作流的核心。它避免了一个常见错误:当真正的变量是提示时却怪罪模型,或者当模型只是靠着薄弱指令撑住时却去夸奖提示。
步骤 3:使用具有代表性的数据集
不要只用最容易复制的示例来评估。建立一个能反映真实流量的小型数据集。
对于支持工作流,应包括:
- 应该很容易处理的常见工单。
- 政策严格的边缘情况。
- 简短且含糊的工单。
- 带有无关细节的长工单。
- 如果生产中会出现,多语言或混合语言示例。
- 已知的历史失败案例。
- 应触发转交处理的示例。
对于每一行,都保留预期行为。它不总是需要完美的标准答案,但需要足够的真实依据,让验证器或评审者判断结果是否可接受。
一个好的初始数据集通常有 50 到 250 行。这个规模足够小,可以反复运行;又足够大,能够暴露超出演示级别的行为。
步骤 4:使用重复样本运行矩阵
对于确定性抽取或分类,早期筛查时每个单元运行一次可能就够了。对于写作、推理、工具使用或智能体任务,应对每个单元运行多个样本。
先使用这条规则:
| 任务类型 | 每个测试行的样本数 |
|---|---|
| 严格分类 | 1 到 2 |
| JSON 提取 | 2 |
| 面向客户的写作 | 3 |
| 工具调用 | 3 |
| 长上下文推理 | 3 到 5 |
| Agent 工作流 | 如果成本允许,5 个 |
重复样本会显示波动。某条路径第一次得分 94%,下一次却只有 71%,即使最佳样本看起来很出色,也还不能用于生产。
步骤 5:先验证结构,再看质量
每个 多模型提示测试工作流 都应该先按结构评分,而不是按风格偏好评分。先运行自动化检查:
| 验证器 | 它能捕捉什么 |
|---|---|
| JSON 解析 | 无效的结构化输出。 |
| Schema 验证 | 缺失字段、枚举错误、类型错误。 |
| 正则或策略检查 | 不允许的措辞、被禁止的声明、缺失引用。 |
| 工具轨迹验证器 | 错误的工具、缺少参数、不安全的副作用。 |
| 确定性单元检查 | 错误的类别、错误的数值转换、无效的日期处理。 |
只有被接受的结构化输出才应进入人工或模型辅助的质量审核。这可以节省审核者时间,并确保各条路径的评分公平。
步骤 6:跟踪每个已接受任务的成本
不要只按标价比较各条路径。要比较团队实际为已接受结果支付了多少。
使用这个指标:
cost_per_accepted_task =
  total_cost_for_cell / accepted_outputs
然后补充上下文:
accepted_output_rate =
  accepted_outputs / total_attempts

retry_adjusted_cost =
  total_cost_for_cell + retry_cost + reviewer_rerun_cost
这一点很重要,因为即使某条路径的 token 价格更低,如果它会产生更多无效 JSON、更长输出、工具调用错误或人工重跑,最终也可能更贵。Flatkey Usage Logs 正是为这类审查设计的:每个请求都可以按模型、输入 token、输出 token、成本、密钥、状态和时间戳进行检查。
如果你现有的成本指南仍然只看 token,那么可以把这篇文章与内部流程 如何在切换 API 提供商之前比较 AI 模型价格 配合使用。提示测试应回答下一个问题:哪条路径能以最低运营成本产出可接受的工作成果?
步骤 7:为矩阵评分
使用加权评分卡。让第一个版本足够简单,以便产品、工程和财务团队都能就其达成一致。
| 指标 | 权重 | 衡量方式 |
|---|---|---|
| 合同通过率 | 30% | 所需的 schema 和策略检查通过。 |
| 人工接受度 | 25% | 审阅者认可该答案可用于生产。 |
| 每个被接受任务的成本 | 20% | 总单元花费除以被接受的输出。 |
| p95 延迟 | 15% | 工作流目标范围内的路由延迟。 |
| 回归安全性 | 10% | 历史失败案例没有下降。 |
示例决策:
| 提示/模型单元 | 合同通过 | 人工接受 | 成本/任务 | p95 延迟 | 最终决策 |
|---|---|---|---|---|---|
| Prompt v1 + current route | 88% | 84% | 1.00x | Pass | 作为回退基线保留 |
| Prompt v2 + current route | 93% | 91% | 1.04x | Pass | 表现很强,但不是最便宜的 |
| Prompt v2 + cheaper route | 91% | 89% | 0.62x | Pass | 用于默认流量发布 |
| Prompt v3 + cheaper route | 84% | 80% | 0.58x | Pass | 因质量下降而拒绝 |
| Prompt v2 + premium route | 96% | 94% | 2.30x | Borderline | 仅用于升级处理 |
获胜的单元并不总是质量分最高的。它是那个在该任务上同时通过质量、延迟、可靠性和成本门槛的单元。
第 8 步:存储决策记录
无法重复的提示测试并不是工作流。请将决策记录保存下来,包括提示、路由、数据集、评分卡和回滚条件。
workflow: support_reply_generation
decision_date: 2026-09-26
dataset: support-eval-250
winner:
  prompt_version: prompt-v2
  model_route: candidate-cheaper-route
  reason: "通过质量门槛,且每个被接受任务的成本更低"
baseline:
  prompt_version: prompt-v1
  model_route: current-default
metrics:
  accepted_output_rate: 0.91
  cost_per_accepted_task_index: 0.62
  p95_latency_status: pass
regression_gates:
  - invalid_json_rate <= 0.02
  - policy_failure_rate <= 0.01
  - historical_failure_pass_rate >= 0.95
rollback_if:
  - accepted_output_rate drops below 0.88 for two days
  - p95 latency misses target for one release window
  - cost per accepted task rises above budget cap
这份记录能让下一位评估者提出这样的问题:新模型是否击败了当前生产单元,还是只击败了产品的一个旧记忆?
可复制的运行器骨架
这个 TypeScript 风格的骨架展示了测试循环的形状。请根据你的技术栈进行调整。
type PromptVersion = {
  id: string;
  system: string;
};

type ModelRoute = {
  id: string;
  model: string;
};

type EvalRow = {
  id: string;
  input: Record<string, unknown>;
  expected: Record<string, unknown>;
};

type EvalResult = {
  rowId: string;
  promptId: string;
  routeId: string;
  sample: number;
  outputText: string;
  validJson: boolean;
  schemaPass: boolean;
  accepted: boolean;
  latencyMs: number;
  costUsd?: number;
};

async function runCell(
  prompt: PromptVersion,
  route: ModelRoute,
  rows: EvalRow[],
  samplesPerRow: number
): Promise<EvalResult[]> {
  const results: EvalResult[] = [];

  for (const row of rows) {
    for (let sample = 0; sample < samplesPerRow; sample++) {
      const started = Date.now();

      const response = await callModel({
        model: route.model,
        system: prompt.system,
        input: row.input,
      });

      const latencyMs = Date.now() - started;
      const parsed = safeJsonParse(response.text);
      const schemaPass = parsed.ok && validateSchema(parsed.value);
      const accepted = schemaPass && validateExpected(parsed.value, row.expected);

      results.push({
        rowId: row.id,
        promptId: prompt.id,
        routeId: route.id,
        sample,
        outputText: response.text,
        validJson: parsed.ok,
        schemaPass,
        accepted,
        latencyMs,
        costUsd: response.usageCost,
      });
    }
  }

  return results;
}
重要的不是语言。重要的是每一行结果都包含提示词版本、路由、样本编号、验证器结果、延迟和成本字段。
在运行结束后在 Flatkey 中查看什么
矩阵完成后,在 Flatkey 中查看同一个测试窗口:
- 按测试 API 密钥筛选用量日志。
- 按模型路由分组。
- 如果财务或运营需要电子表格审阅,则导出请求日志。
- 比较每条路由的输入 token、输出 token、状态和成本。
- 检查失败是否集中在某一个提示词版本、某一个模型或某一个数据集分段。
然后将结果与您的路由策略关联起来。如果默认路由在质量上获胜,但某个更便宜的路由在简单情况下的已接受任务成本上获胜,那么您可能不需要唯一的赢家。您可能需要一个默认路由、一个升级路由和一个回退路由。对于下一步,请使用 模型回退策略工作流操作手册 中的路由逻辑。
常见错误
| 错误 | 修复 |
|---|---|
| 只用五个示例测试最终提示词 | 使用具有代表性的数据集和多个提示词版本。 |
| 在没有验证器的情况下比较模型 | 先解析并对每个结构化输出进行 schema 检查。 |
| 只针对平均分进行优化 | 跟踪方差和历史失败案例。 |
| 忽略重试 | 使用每个已接受任务的成本,而不是每次原始调用的成本。 |
| 忘记延迟 | 高质量路由仍然可能损害产品体验。 |
| 丢失决策结果 | 将矩阵结果存储为回归基线。 |
这如何与成本预测相连接
本文的规范 URL 之所以与 AI API 支出预测有关,是因为提示测试是 AI 支出开始变得不可预测的最早场景之一。更新后的 多模型提示测试工作流 通过将评估转化为可重复的表格,使支出变得可预测:
| 预测输入 | 来源于 |
|---|---|
| 测试量 | 数据集行数 x 提示版本 x 模型路由 x 样本数。 |
| 重试率 | 失败的验证器和被拒绝的输出。 |
| 每个已接受任务的成本 | 使用日志和已接受输出数量。 |
| 上线缓冲 | 回归风险、回退占比和预期增长。 |
| 预算控制 | 按密钥配额、月度上限和使用审查频率。 |
若要制定可供财务使用的发布计划,请将测试矩阵与 面向运营和财务团队的 AI API 支出管理 关联起来。
常见问题
什么是多模型提示测试工作流?
多模型提示测试工作流 是一种可重复的流程,用于跨多个模型路由测试多个提示版本,并使用验证器、质量审核、成本、延迟和回归门槛来为每个单元格打分。
我需要多少示例?
先从 50 到 250 行具有代表性的样本开始。如果任务风险较高、流量分布多样,或者该路由将做出自主决策,则增加更多样本。
我应该使用 LLM 评审器吗?
可以,但不要把它作为第一道门槛。在模型辅助评分之前,先使用确定性验证器检查 schema、策略和精确要求。对于上线关键工作流,人工审核仍然很重要。
我们应该多久重新运行一次工作流?
在切换默认模型、更改主要提示、添加回退路由、更改工具 schema 或发布到新细分市场之前,重新运行它。对于提供商或模型更新后,也要重新运行一组较小的回归集。
Flatkey 在哪里发挥作用?
Flatkey 为团队提供一个 API 密钥和一个用于多路由测试的模型目录,并提供模型名称、token 数量、请求成本、密钥、状态和时间戳的使用可见性。这使 多模型提示测试工作流 更易于运行,也更易于向财务或运营解释。
最终结论
真正获胜的提示并不是一个提示。它是一个在真实流量、预算和延迟条件下通过任务契约的提示/模型单元。使用上面的 多模型提示测试工作流,将模型选择从争论转化为证据链:数据集、矩阵、验证器、每个已接受任务的成本、回归门槛以及决策记录。
当你的团队准备通过一个与 OpenAI 兼容的统一入口进行测试时,请从 Flatkey 快速入门 开始,使用 模型列表 验证可用路由,并在 使用日志 中检查支出。