チームが一度に1つのモデルでしかプロンプトをテストしていないなら、おそらく測るべきものを取り違えています。ある経路では強く見えるプロンプトでも、別の経路ではJSON契約を満たせなかったり、コンテキストが長くなると遅すぎたり、リトライと却下された出力を含めると高コストに見えたりします。
このガイドでは、AIプロダクトチームがローンチ前にモデル経路をまたいでプロンプトのバージョンを比較するための実践的なマルチモデルのプロンプトテストワークフローを紹介します。目的は普遍的な勝者を決めることではありません。プロンプト品質、モデルとの適合性、レイテンシ、コストを切り分け、チームがプレイグラウンドのスクリーンショットではなく証拠に基づいて経路を選べるようにすることです。
Flatkeyはこのワークフローで役立ちます。なぜなら、同じアカウントからOpenAI互換APIを通じて多くのモデル経路を呼び出せ、モデル一覧を通じて利用可能なモデルを確認でき、モデル名、トークン数、リクエストごとのコスト、ステータス、タイムスタンプを含むリクエスト単位の使用ログを確認できるからです。その共有レイヤーを使ってテストを実行し、次に勝ったプロンプト/モデルのセルを回帰ベースラインとして保存します。
短い答え
信頼できるマルチモデルのプロンプトテストワークフローは、次の8つの要素で構成されます。
- モデル設定を触る前にタスク契約を固定する。
- プロンプトのバージョンとモデル経路を別々の変数に分ける。
- 3つのお気に入り例ではなく、代表的なデータセットを使う。
- 非決定性が重要な場合は、繰り返しサンプルを実行する。
- 人間に品質評価を依頼する前に、コードで構造を検証する。
- トークン単価だけでなく、承認されたタスクあたりのコストを追跡する。
- 回帰ゲートを通過した場合にのみ勝者を昇格させる。
- 次のモデルテストが証拠から始められるよう、意思決定記録を保存する。
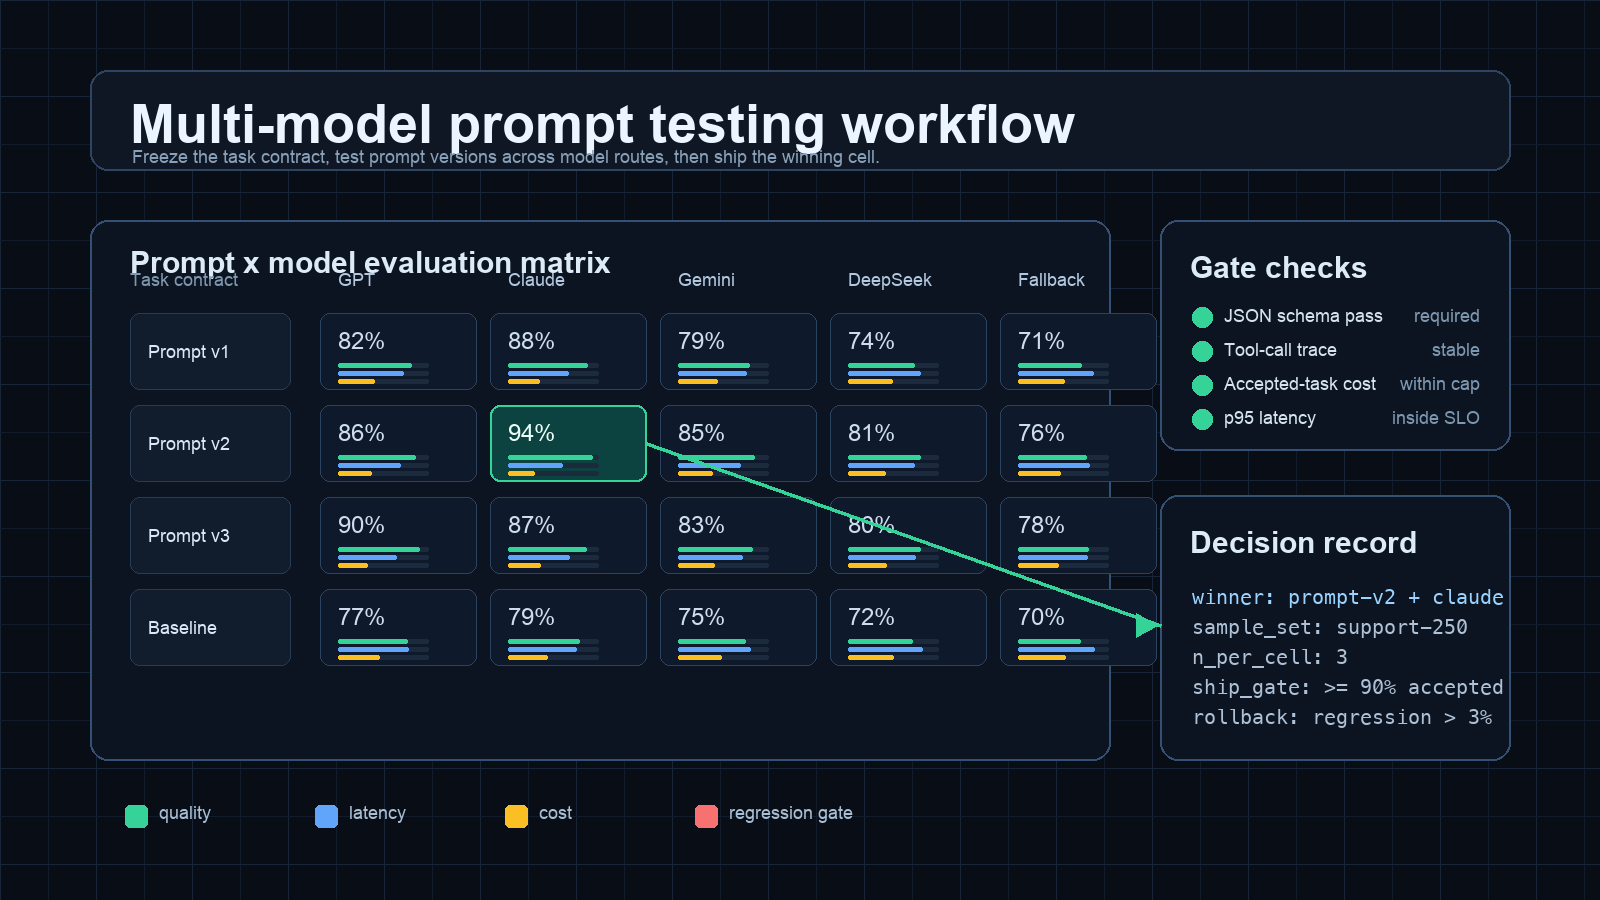
これは、「デモではClaudeのほうがよく見えた」と「ルートB上のPrompt v2は契約テストの94%に合格し、p95レイテンシ目標を下回り、リトライ後の承認済みタスクあたりコストを下げた」の違いです。
このワークフローが必要なとき
次のいずれかに当てはまる場合は、マルチモデルのプロンプトテストワークフローを使ってください。
| 状況 | 1モデルだけのテストが弱い理由 |
|---|---|
| あるプロバイダーから別のプロバイダーへ切り替える | プロンプトの文言、ツール呼び出しの挙動、構造化出力の信頼性、拒否のスタイルはすべて変わり得ます。 |
| より安価なフォールバック経路を追加する | 安価なモデルには、受理される結果を出すために別のプロンプトやより厳格なバリデータが必要な場合があります。 |
| 長文コンテキストのプロンプトをテストする | コンテキスト長は、コスト、レイテンシ、キャッシュ挙動、指示のずれが起こる可能性を変えます。 |
| プロダクトのワークフローをローンチする | 社内デモでは、リトライ、却下された出力、サポートへのエスカレーションが見えません。 |
| 財務の可視性が必要である | 財務部門が知りたいのはトークン単価だけではありません。承認済みタスクあたりのコストと予算ガードレールが必要です。 |
その判断が本番の挙動に影響するなら、「モデルA対モデルB」を感覚で試してはいけません。プロンプトのバージョンとモデル経路をマトリクスとしてテストしてください。
ステップ1: タスク契約を固定する
モデルを比較する前に、そのモデルが満たすべき契約を明文化します。タスク契約には次の内容を定義すべきです。
| 項目 | 例 |
|---|---|
| ユーザージョブ | サポートチケットを分類し、安全な返信を1件下書きする。 |
| 入力形式 | チケット本文、顧客ティア、製品領域、過去の返信回数。 |
| 必要な出力 | category、priority、reply、handoff_required、reason_codes を含むJSON。 |
| 重大な失敗 | 無効なJSON、必須フィールドの欠落、サポートされていない約束、安全でない返金表現。 |
| 品質基準 | 正しいカテゴリ、簡潔な返信、捏造したポリシーなし、有用なエスカレーション理由。 |
| 運用上の制約 | p95レイテンシーは4秒未満、受け入れられたタスク1件あたりのコストはチーム上限内。 |
まずこれを行うのは、契約によってマルチモデルのプロンプトテストワークフローに誠実さが保たれるからです。これがないと、レビュー担当者は本番で生き残る経路ではなく、1つの例で最も良く読める応答に最適化してしまいます。
ステップ2: プロンプト×モデルのマトリクスを構築する
変数を分けます。プロンプトのバージョンとモデル経路には、それぞれ独自の軸を持たせるべきです。
| テストセル | プロンプト | モデル経路 | 何を答えるか |
|---|---|---|---|
| A1 | プロンプト v1 | 現在のデフォルト | ベースラインはまだ許容できるか? |
| A2 | プロンプト v1 | 候補のより安価な経路 | 現在のプロンプトはそのまま通用するか? |
| B1 | プロンプト v2 | 現在のデフォルト | モデルを変えずにプロンプトで品質は改善したか? |
| B2 | プロンプト v2 | 候補のより安価な経路 | より良いプロンプト/モデルの組み合わせはあるか? |
| C1 | プロンプト v3 | 現在のデフォルト | より厳格な指示で失敗は減ったか? |
| C2 | プロンプト v3 | 候補のプレミアム経路 | 追加コストに見合ってエスカレーションする価値はあるか? |
このマトリクスは、マルチモデルのプロンプトテストワークフローの中核です。よくある間違いを防ぎます。つまり、実際にはプロンプトが変数なのにモデルのせいにしたり、弱い指示をモデルが補っているだけなのにプロンプトを称賛したりすることです。
ステップ3: 代表的なデータセットを使う
コピーしやすい例だけで評価してはいけません。実際のトラフィックを反映した小さなデータセットを作成します。
サポートワークフローの場合、以下を含めます。
- 簡単に処理できる一般的なチケット。
- ポリシーが厳格なエッジケース。
- 短く曖昧なチケット。
- 無関係な詳細を含む長いチケット。
- 本番で発生するなら、多言語または混在言語の例。
- 既知の過去の失敗。
- 引き継ぎをトリガーすべき例。
各行について、期待される動作を保持します。必ずしも完璧なゴールデンアンサーである必要はありませんが、検証者やレビュー担当者が結果を受け入れ可能かどうか判断できる程度の十分な正解は必要です。
優れた最初のデータセットは、50〜250行程度であることが多いです。繰り返し実行するには十分小さく、デモ的な挙動以上のものを明らかにするには十分な大きさです。
ステップ4: リピートサンプルでマトリクスを実行する
決定的な抽出や分類では、早期スクリーニングにはセルごとに1回の実行で十分な場合があります。文章生成、推論、ツール利用、エージェント的なタスクでは、セルごとに複数回サンプルを実行してください。
まずは次のルールを使います:
| タスクタイプ | テスト行ごとのサンプル数 |
|---|---|
| 厳密な分類 | 1〜2 |
| JSON抽出 | 2 |
| 顧客向けライティング | 3 |
| ツール呼び出し | 3 |
| 長文コンテキスト推論 | 3〜5 |
| エージェントワークフロー | コストが許せば5 |
繰り返しサンプルはばらつきを示します。あるルートが1回目に94%を記録し、次のパスで71%になるなら、たとえ最良のサンプルが印象的でも、本番投入可能ではありません。
ステップ5: 品質より先に構造を検証する
すべてのマルチモデルのプロンプトテストワークフローは、味わいより先に構造を採点すべきです。まず自動チェックを実行します:
| バリデーター | 検出できるもの |
|---|---|
| JSONパース | 無効な構造化出力。 |
| スキーマ検証 | 不足フィールド、誤った列挙値、誤った型。 |
| 正規表現またはポリシーチェック | 許可されないフレーズ、禁止された主張、欠落した引用。 |
| ツールトレースバリデーター | 誤ったツール、不足引数、危険な副作用。 |
| 決定的なユニットチェック | 誤ったカテゴリ、誤った数値変換、無効な日付処理。 |
人手またはモデル支援の品質レビューに回すべきなのは、構造的に受け入れられた出力だけです。そうすることでレビュー担当者の時間を節約し、ルート間の採点の公平性を保てます。
ステップ6: 受理済みタスクあたりのコストを追跡する
ルートを一覧価格だけで比較しないでください。チームが実際に受理された成果に対して支払う金額を比較します。
この指標を使います:
cost_per_accepted_task =
  total_cost_for_cell / accepted_outputs
そのうえで文脈を追加します:
accepted_output_rate =
  accepted_outputs / total_attempts

retry_adjusted_cost =
  total_cost_for_cell + retry_cost + reviewer_rerun_cost
これは、トークン単価が低いルートでも、無効なJSON、長すぎる出力、ツール呼び出しエラー、手動再実行が増えると、結果的に高くつく可能性があるため重要です。Flatkey Usage Logsはこの種のレビュー向けに設計されています。各リクエストはモデル、入力トークン、出力トークン、コスト、キー、ステータス、タイムスタンプで確認できます。
既存のコストガイドがまだトークン単位のみなら、この記事をAPIプロバイダーを切り替える前にAIモデル価格を比較する方法にある社内ワークフローと組み合わせてください。プロンプトテストは次の問いに答えるべきです: どのルートが最も低い運用コストで受理済みの成果を生み出すか?
ステップ7: マトリクスを採点する
重み付きスコアカードを使います。最初のバージョンは、プロダクト、エンジニアリング、財務が合意できる程度に十分シンプルに保ってください。
| 指標 | 重み | 測定 |
|---|---|---|
| 契約合格率 | 30% | 必須のスキーマとポリシーのチェックに合格。 |
| 人間による承認 | 25% | レビュアーが本番利用向けとして回答を承認する。 |
| 承認済みタスクあたりのコスト | 20% | セル全体の費用を承認済み出力数で割った値。 |
| p95レイテンシ | 15% | ワークフローの目標以内のルートレイテンシ。 |
| 回帰安全性 | 10% | 過去の失敗ケースで低下がないこと。 |
決定例:
| プロンプト/モデルのセル | 契約合格 | 人間による承認 | コスト/タスク | p95レイテンシ | 最終判断 |
|---|---|---|---|---|---|
| Prompt v1 + current route | 88% | 84% | 1.00x | Pass | フォールバックのベースラインとして保持 |
| Prompt v2 + current route | 93% | 91% | 1.04x | Pass | 高品質だが最安ではない |
| Prompt v2 + cheaper route | 91% | 89% | 0.62x | Pass | デフォルトトラフィック向けにリリース |
| Prompt v3 + cheaper route | 84% | 80% | 0.58x | Pass | 品質低下のため却下 |
| Prompt v2 + premium route | 96% | 94% | 2.30x | 境界線上 | エスカレーション時のみ使用 |
勝者となるセルは、常に最高品質スコアのものとは限りません。業務に対して品質、レイテンシ、信頼性、コストのゲートをすべてクリアするセルです。
Step 8: 記録を保存する
再現できないプロンプトテストはワークフローではありません。プロンプト、ルート、データセット、スコアカード、ロールバック条件を含む決定記録を保存してください。
workflow: support_reply_generation
decision_date: 2026-09-26
dataset: support-eval-250
winner:
  prompt_version: prompt-v2
  model_route: candidate-cheaper-route
  reason: "品質ゲートに合格し、承認済みタスクあたりのコストが低かったため"
baseline:
  prompt_version: prompt-v1
  model_route: current-default
metrics:
  accepted_output_rate: 0.91
  cost_per_accepted_task_index: 0.62
  p95_latency_status: pass
regression_gates:
  - invalid_json_rate <= 0.02
  - policy_failure_rate <= 0.01
  - historical_failure_pass_rate >= 0.95
rollback_if:
  - accepted_output_rate drops below 0.88 for two days
  - p95 latency misses target for one release window
  - cost per accepted task rises above budget cap
この記録があれば、次の評価者は次のように確認できます。新しいモデルは現在の本番セルに勝ったのか、それとも製品の古い記憶に勝っただけなのか。
コピー可能なランナースケルトン
このTypeScript風のスケルトンは、テストループの形を示しています。ご自身のスタックに合わせて調整してください。
type PromptVersion = {
  id: string;
  system: string;
};

type ModelRoute = {
  id: string;
  model: string;
};

type EvalRow = {
  id: string;
  input: Record<string, unknown>;
  expected: Record<string, unknown>;
};

type EvalResult = {
  rowId: string;
  promptId: string;
  routeId: string;
  sample: number;
  outputText: string;
  validJson: boolean;
  schemaPass: boolean;
  accepted: boolean;
  latencyMs: number;
  costUsd?: number;
};

async function runCell(
  prompt: PromptVersion,
  route: ModelRoute,
  rows: EvalRow[],
  samplesPerRow: number
): Promise<EvalResult[]> {
  const results: EvalResult[] = [];

  for (const row of rows) {
    for (let sample = 0; sample < samplesPerRow; sample++) {
      const started = Date.now();

      const response = await callModel({
        model: route.model,
        system: prompt.system,
        input: row.input,
      });

      const latencyMs = Date.now() - started;
      const parsed = safeJsonParse(response.text);
      const schemaPass = parsed.ok && validateSchema(parsed.value);
      const accepted = schemaPass && validateExpected(parsed.value, row.expected);

      results.push({
        rowId: row.id,
        promptId: prompt.id,
        routeId: route.id,
        sample,
        outputText: response.text,
        validJson: parsed.ok,
        schemaPass,
        accepted,
        latencyMs,
        costUsd: response.usageCost,
      });
    }
  }

  return results;
}
重要なのは言語ではありません。重要なのは、すべての結果行にプロンプトのバージョン、ルート、サンプル番号、バリデーターの結果、レイテンシー、コストの各フィールドが含まれていることです。
実行後にFlatkeyで確認する内容
マトリクスが完了したら、Flatkeyで同じテストウィンドウを確認します。
- テスト用APIキーで使用ログをフィルタする。
- モデルルートごとにグループ化する。
- 財務または運用チームがスプレッドシートでレビューする必要がある場合は、リクエストログをエクスポートする。
- ルートごとに入力トークン、出力トークン、ステータス、コストを比較する。
- 失敗が1つのプロンプトバージョン、1つのモデル、またはデータセットの1区分に集中していないか確認する。
次に、結果をルーティングポリシーに結び付けます。デフォルトルートが品質で勝っていても、より安価なルートが単純なケースで承認済みタスクのコストで勝つ場合、勝者を1つに絞る必要はないかもしれません。デフォルトルート、エスカレーションルート、フォールバックルートが必要になる可能性があります。次のステップでは、Model Fallback Strategy Workflow Playbook のルーティングロジックを使用してください。
よくあるミス
| ミス | 修正 |
|---|---|
| 最終プロンプトだけを5件のサンプルでテストする | 代表的なデータセットと複数のプロンプトバージョンを使用する。 |
| バリデーターなしでモデルを比較する | すべての構造化出力をまずパースし、スキーマチェックする。 |
| 平均スコアだけを最適化する | 分散と過去の失敗ケースを追跡する。 |
| 再試行を無視する | 生の呼び出し単価ではなく、承認済みタスクあたりのコストを使う。 |
| レイテンシーを忘れる | 高品質なルートでも、プロダクト体験を損なう可能性がある。 |
| 意思決定を保存しない | マトリクス結果を回帰ベースラインとして保存する。 |
これがコスト予測とどうつながるか
この記事の正規URLは、プロンプトテストはAI支出が最初に予測不能になる場所のひとつであるため、AI APIの支出予測に関するものです。更新されたマルチモデルのプロンプトテストワークフローは、評価を再現可能な表に変えることで支出を予測可能にします。
| 予測入力 | 由来 |
|---|---|
| テスト量 | データセットの行数 × プロンプトバージョン × モデルルート × サンプル。 |
| 再試行率 | 失敗したバリデーターと却下された出力。 |
| 承認済みタスクあたりのコスト | 利用ログと承認済み出力数。 |
| ローンチ用バッファ | 回帰リスク、フォールバック比率、想定成長。 |
| 予算管理 | キーごとのクォータ、月次上限、利用レビューの頻度。 |
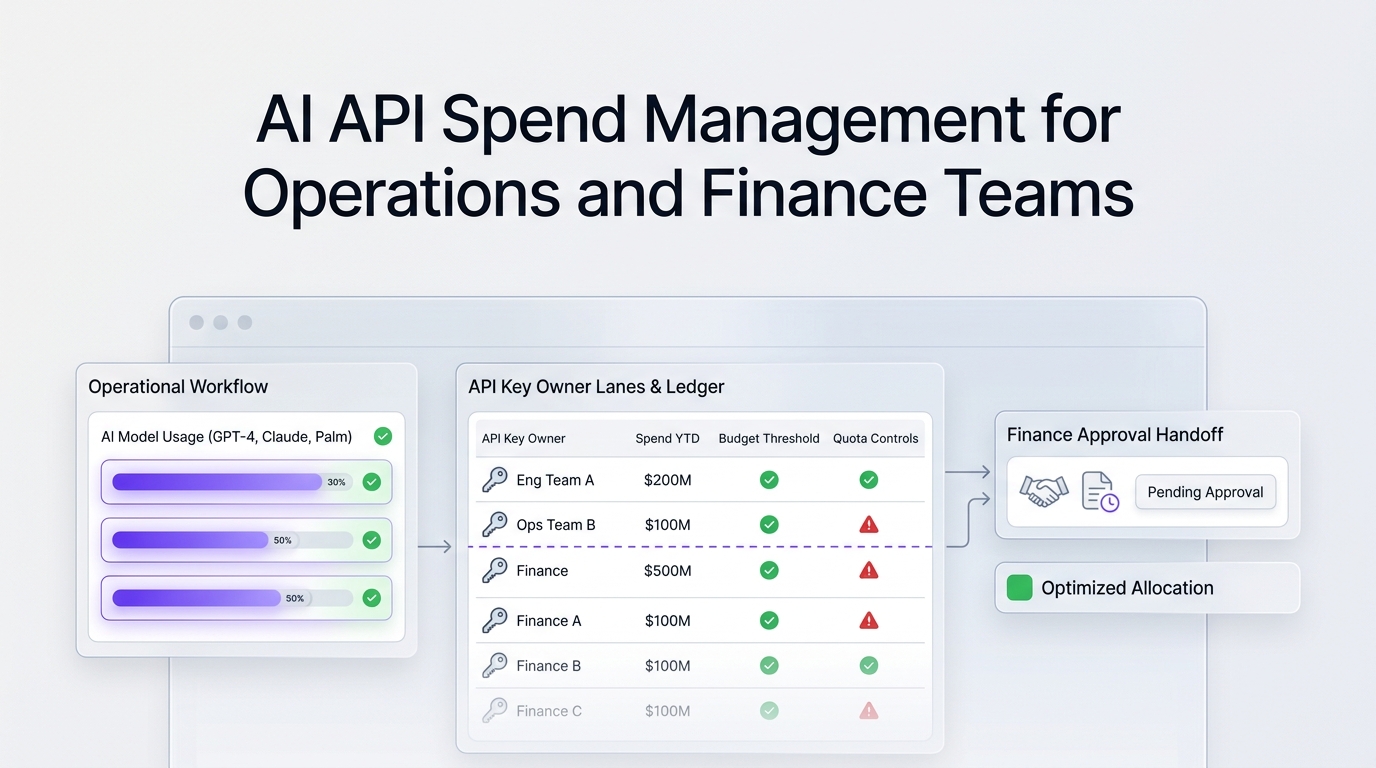
財務部門向けにそのまま使える展開計画については、テストマトリクスを運用・財務チーム向けのAI API支出管理につなげてください。
FAQ
マルチモデルのプロンプトテストワークフローとは何ですか?
マルチモデルのプロンプトテストワークフローは、複数のモデルルートにわたって複数のプロンプトバージョンをテストし、各セルをバリデーター、品質レビュー、コスト、レイテンシ、回帰ゲートで評価する再現可能なプロセスです。
何件の例が必要ですか?
まずは50〜250件の代表的な行から始めてください。タスクのリスクが高い、トラフィックが多様である、またはルートが自律的な意思決定を行う場合は、さらに行数を増やしてください。
LLMジャッジを使うべきですか?
使うことはできますが、最初のゲートにしないでください。モデル支援の採点の前に、スキーマ、ポリシー、厳密な要件については決定論的なバリデーターを使用してください。ローンチに重要なワークフローでは、人によるレビューも依然として重要です。
どのくらいの頻度でワークフローを再実行すべきですか?
既定モデルを切り替える前、主要なプロンプトを変更する前、フォールバックルートを追加する前、ツールスキーマを変更する前、新しいセグメントに展開する前に再実行してください。また、プロバイダーやモデルの更新後には、より小さな回帰セットも再実行してください。
Flatkeyはどこに当てはまりますか?
Flatkeyは、マルチルートテスト向けに1つのAPIキーと1つのモデルカタログをチームに提供し、さらにモデル名、トークン数、リクエストコスト、キー、ステータス、タイムスタンプの利用可視化も提供します。そのため、マルチモデルのプロンプトテストワークフローは実行しやすくなり、財務や運用部門にも説明しやすくなります。
最終的な要点
勝てるプロンプトは、単なるプロンプトではありません。現実的なトラフィック、予算、レイテンシ条件の下でタスク契約を満たす、プロンプト/モデルのセルです。上記のマルチモデルのプロンプトテストワークフローを使って、モデル選定を議論から証拠の記録へ変えましょう。つまり、データセット、マトリクス、バリデーター、承認済みタスクあたりのコスト、回帰ゲート、そして意思決定記録です。
チームが1つのOpenAI互換の接点を通じてテストする準備ができたら、Flatkeyのクイックスタートから始め、モデル一覧で利用可能なルートを確認し、利用ログで支出を確認してください。