Если ваша команда тестирует промпты по одной модели за раз, вы, скорее всего, измеряете не то, что нужно. Промпт, который выглядит сильным на одном маршруте, может провалить JSON-контракт на другом, стать слишком медленным при более длинном контексте или выглядеть дешёвым, пока не учтены повторные попытки и отклонённые ответы.
Это руководство даёт AI-продуктовым командам практический рабочий процесс тестирования промптов для нескольких моделей для сравнения версий промптов по маршрутам моделей до запуска. Цель не в том, чтобы выбрать единого победителя. Цель — отделить качество промпта, соответствие модели задаче, задержку и стоимость, чтобы команда могла выбрать маршрут на основе данных, а не скриншотов из playground.
Flatkey полезен в этом рабочем процессе, потому что один и тот же аккаунт может вызывать множество маршрутов моделей через OpenAI-совместимый API, просматривать доступные модели через список моделей и анализировать логи запросов на уровне запроса с именами моделей, числом токенов, стоимостью за запрос, статусом и временными метками. Используйте этот общий слой, чтобы провести тест, а затем сохраните выигравшую ячейку промпт/модель как базовую линию для регрессии.
Краткий ответ
Надёжный рабочий процесс тестирования промптов для нескольких моделей состоит из восьми частей:
- Зафиксируйте контракт задачи до того, как трогать настройки модели.
- Разделите версию промпта и маршрут модели как отдельные переменные.
- Используйте репрезентативный набор данных, а не три любимых примера.
- Запускайте повторные выборки там, где важна недетерминированность.
- Проверяйте структуру кодом, прежде чем просить человека оценивать качество.
- Отслеживайте стоимость за принятое задание, а не только цену за токены.
- Продвигайте победителя только если он проходит регрессионные пороги.
- Сохраняйте запись о решении, чтобы следующий тест модели начинался с данных.
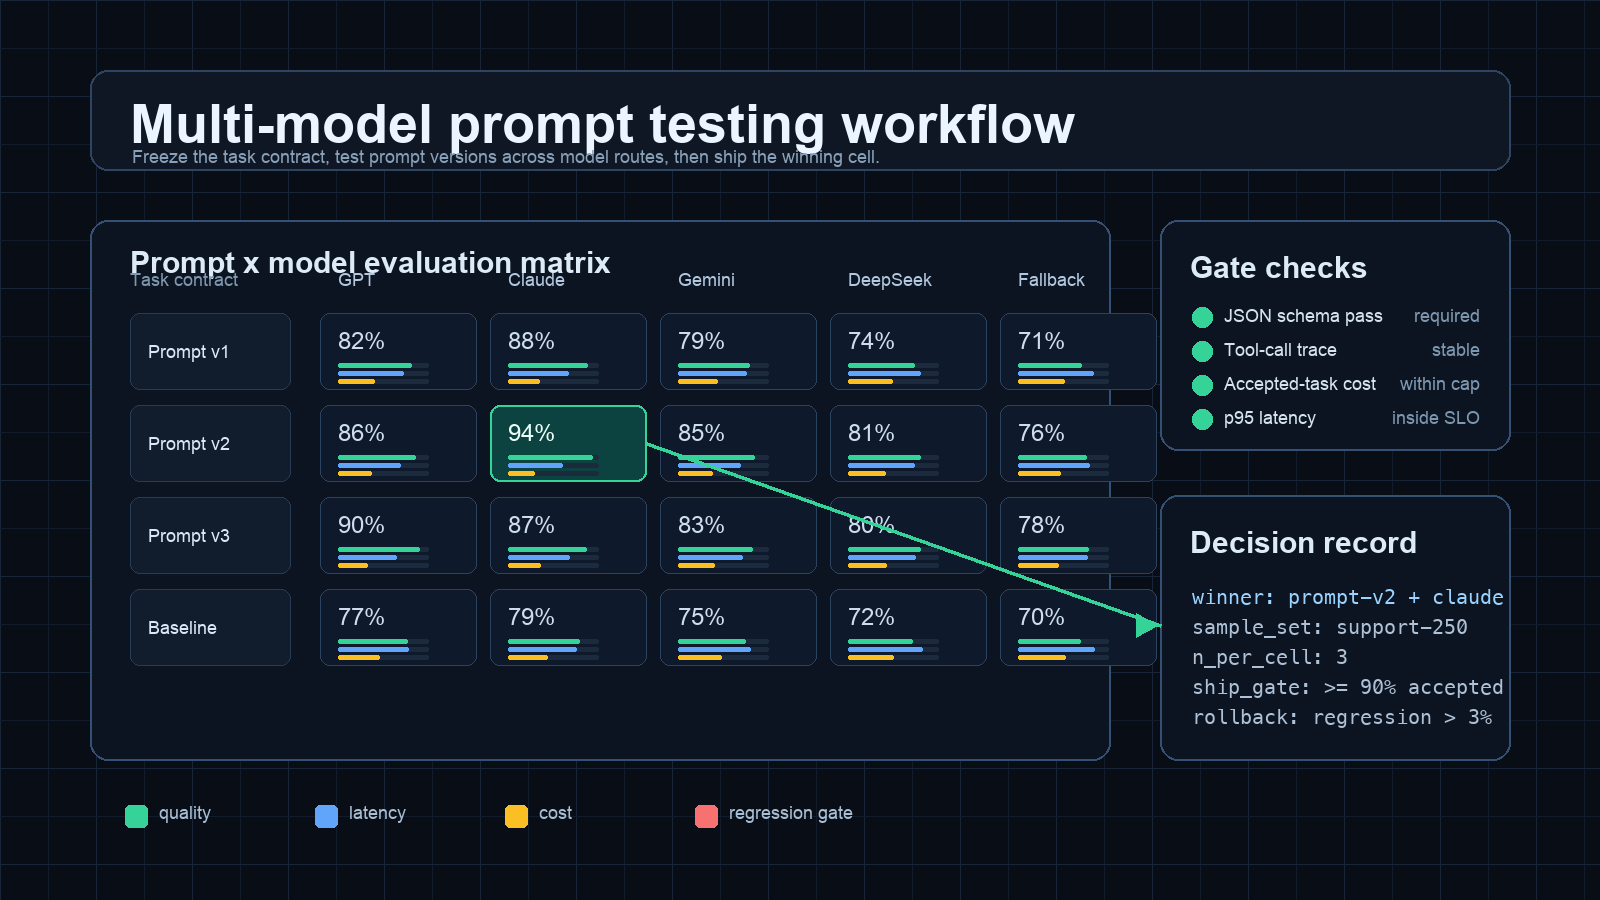
Разница здесь между «Claude выглядел лучше в демо» и «Prompt v2 на маршруте B прошёл 94% наших контрактных тестов, уложился в целевой p95 по задержке и снизил стоимость за принятое задание после повторных попыток».
Когда вам нужен этот рабочий процесс
Используйте рабочий процесс тестирования промптов для нескольких моделей, если верно одно из следующих утверждений:
| Ситуация | Почему тестирование на одной модели слабо |
|---|---|
| Вы переходите от одного провайдера к другому | Формулировка промпта, поведение вызова инструментов, надёжность структурированного вывода и стиль отказа могут измениться. |
| Вы добавляете более дешёвый резервный маршрут | Более дешёвой модели может понадобиться другой промпт или более строгий валидатор, чтобы выдавать принятые результаты. |
| Вы тестируете промпты с длинным контекстом | Длина контекста меняет стоимость, задержку, поведение кэша и вероятность дрейфа инструкций. |
| Вы запускаете продуктовый рабочий процесс | Внутренние демо скрывают повторные попытки, отклонённые ответы и эскалации в поддержку. |
| Вам нужна прозрачность для финансовой команды | Финансовой команде важна не только цена за токен; ей нужна стоимость за принятое задание и бюджетные ограничители. |
Если решение влияет на поведение в продакшене, не тестируйте «model A vs model B» как проверку на ощущениях. Тестируйте версию промпта по маршруту модели как матрицу.
Шаг 1: Зафиксируйте контракт задачи
Прежде чем сравнивать модели, запишите контракт, которому должна соответствовать модель. Контракт задачи должен определять:
| Поле | Пример |
|---|---|
| Задача пользователя | Классифицировать обращения в поддержку и подготовить один безопасный ответ. |
| Форма ввода | Текст обращения, уровень клиента, область продукта, количество предыдущих ответов. |
| Требуемый результат | JSON с category, priority, reply, handoff_required и reason_codes. |
| Критические ошибки | Недопустимый JSON, отсутствующее обязательное поле, неподдерживаемое обещание, небезопасная формулировка о возврате средств. |
| Критерии качества | Правильная категория, краткий ответ, без выдуманных правил политики, полезная причина эскалации. |
| Ограничения эксплуатации | Задержка p95 менее 4 секунд, стоимость на одну принятую задачу ниже командного лимита. |
Сделайте это первым, потому что контракт сохраняет рабочий процесс тестирования промптов для нескольких моделей честным. Без него рецензенты будут оптимизировать ответ, который лучше звучит на одном примере, а не маршрут, который выдерживает нагрузку в продакшене.
Шаг 2: Постройте матрицу промпт x модель
Разделите переменные. Версия промпта и маршрут модели должны иметь свои собственные оси.
| Ячейка теста | Промпт | Маршрут модели | На что отвечает |
|---|---|---|---|
| A1 | Prompt v1 | Текущий вариант по умолчанию | Остаётся ли базовый вариант приемлемым? |
| A2 | Prompt v1 | Кандидат на более дешёвый маршрут | Переходит ли текущий промпт на другой маршрут? |
| B1 | Prompt v2 | Текущий вариант по умолчанию | Улучшился ли промпт без смены модели? |
| B2 | Prompt v2 | Кандидат на более дешёвый маршрут | Есть ли лучшая пара промпт/модель? |
| C1 | Prompt v3 | Текущий вариант по умолчанию | Снизили ли более жёсткие инструкции число сбоев? |
| C2 | Prompt v3 | Кандидат на премиальный маршрут | Оправдана ли эскалация дополнительными затратами? |
Эта матрица — сердце рабочего процесса тестирования промптов для нескольких моделей. Она предотвращает распространённую ошибку: винить модель, когда настоящая переменная — промпт, или хвалить промпт, когда модель компенсирует слабые инструкции.
Шаг 3: Используйте репрезентативный набор данных
Не оценивайте на тех примерах, которые проще всего скопировать. Соберите небольшой набор данных, отражающий реальный трафик.
Для сценария поддержки включите:
- Типичные обращения, которые должны быть простыми.
- Пограничные случаи, где политика жёсткая.
- Короткие неоднозначные обращения.
- Длинные обращения с нерелевантными деталями.
- Примеры на нескольких языках или со смешением языков, если они встречаются в продакшене.
- Известные исторические сбои.
- Примеры, которые должны вызывать передачу другому специалисту.
Для каждой строки фиксируйте ожидаемое поведение. Не всегда нужен идеальный эталонный ответ, но нужно достаточно фактической базы, чтобы валидатор или рецензент мог решить, приемлем ли результат.
Хороший первый набор данных часто содержит от 50 до 250 строк. Этого достаточно, чтобы запускать его многократно, и при этом он достаточно велик, чтобы выявлять не только демонстрационное поведение.
Шаг 4: Запустите матрицу с повторными выборками
Для детерминированного извлечения или классификации одного запуска на ячейку может быть достаточно для первичного отбора. Для задач написания, рассуждений, использования инструментов или агентных задач запускайте несколько выборок на ячейку.
Используйте это начальное правило:
| Тип задачи | Образцов на строку теста |
|---|---|
| Строгая классификация | 1–2 |
| Извлечение JSON | 2 |
| Пользовательский текст | 3 |
| Вызов инструментов | 3 |
| Рассуждение на длинном контексте | 3–5 |
| Рабочий процесс агента | 5, если позволяет бюджет |
Повторяющиеся образцы показывают вариативность. Маршрут, который один раз набирает 94%, а при следующем проходе — 71%, не готов к продакшену, даже если лучший образец выглядит впечатляюще.
Шаг 5: проверьте структуру перед качеством
Каждый рабочий процесс тестирования промптов для нескольких моделей должен оценивать структуру раньше, чем качество текста. Сначала запустите автоматические проверки:
| Валидатор | Что он выявляет |
|---|---|
| Разбор JSON | Неверный структурированный вывод. |
| Проверка схемы | Отсутствующие поля, неверное enum, неверный тип. |
| Проверки regex или политики | Запрещенные фразы, недопустимые утверждения, отсутствующие цитаты. |
| Валидатор трассировки инструментов | Неправильный инструмент, отсутствующий аргумент, небезопасный побочный эффект. |
| Детерминированные unit-проверки | Неверная категория, неверное числовое преобразование, некорректная обработка даты. |
Только принятые структурные ответы должны попадать на человеческую или поддерживаемую моделью проверку качества. Это экономит время ревьюеров и делает оценку справедливой для разных маршрутов.
Шаг 6: отслеживайте стоимость на принятую задачу
Не сравнивайте маршруты только по прайс-листу. Сравнивайте то, что команда фактически платит за принятые результаты.
Используйте эту метрику:
cost_per_accepted_task =
  total_cost_for_cell / accepted_outputs
Затем добавьте контекст:
accepted_output_rate =
  accepted_outputs / total_attempts

retry_adjusted_cost =
  total_cost_for_cell + retry_cost + reviewer_rerun_cost
Это важно, потому что маршрут с более низкой ценой за токен может оказаться дороже, если он создает больше неверного JSON, более длинные ответы, ошибки вызова инструментов или ручные повторные запуски. Flatkey Usage Logs созданы именно для такого анализа: каждый запрос можно проверить по модели, входным токенам, выходным токенам, стоимости, ключу, статусу и временной метке.
Если ваш текущий гайд по стоимости по-прежнему учитывает только токены, сопоставьте эту статью с внутренним процессом из Как сравнивать цены моделей ИИ перед сменой API-провайдера. Тест промпта должен ответить на следующий вопрос: какой маршрут дает принятые результаты при самой низкой операционной стоимости?
Шаг 7: оцените матрицу
Используйте взвешенную оценочную таблицу. Сделайте первую версию достаточно простой, чтобы продукт, инженерия и финансы могли с ней согласиться.
| Метрика | Вес | Измерение |
|---|---|---|
| Процент успешного прохождения контракта | 30% | Обязательные проверки схемы и политики пройдены. |
| Принятие человеком | 25% | Рецензент принимает ответ для использования в продакшене. |
| Стоимость на одну принятую задачу | 20% | Общие затраты на ячейку, делённые на количество принятых результатов. |
| p95 задержка | 15% | Задержка маршрута в пределах целевого значения workflow. |
| Безопасность от регрессий | 10% | Нет ухудшения на исторических случаях отказов. |
Пример решения:
| Ячейка промпта/модели | Прохождение контракта | Принятие человеком | Стоимость/задача | p95 задержка | Итоговое решение |
|---|---|---|---|---|---|
| Prompt v1 + текущий маршрут | 88% | 84% | 1.00x | Pass | Оставить как базовый запасной вариант |
| Prompt v2 + текущий маршрут | 93% | 91% | 1.04x | Pass | Сильно, но не самый дешёвый вариант |
| Prompt v2 + более дешёвый маршрут | 91% | 89% | 0.62x | Pass | Выпустить для трафика по умолчанию |
| Prompt v3 + более дешёвый маршрут | 84% | 80% | 0.58x | Pass | Отклонить из-за снижения качества |
| Prompt v2 + премиальный маршрут | 96% | 94% | 2.30x | На грани | Использовать только для эскалации |
Побеждающая ячейка не всегда имеет самый высокий показатель качества. Это та ячейка, которая проходит пороги качества, задержки, надёжности и стоимости для данной задачи.
Шаг 8: Сохраните запись решения
Тест промпта, который нельзя повторить, не является workflow. Сохраните запись о решении с промптом, маршрутом, датасетом, оценочной таблицей и условиями отката.
workflow: support_reply_generation
decision_date: 2026-09-26
dataset: support-eval-250
winner:
  prompt_version: prompt-v2
  model_route: candidate-cheaper-route
  reason: "Passed quality gate with lower cost per accepted task"
baseline:
  prompt_version: prompt-v1
  model_route: current-default
metrics:
  accepted_output_rate: 0.91
  cost_per_accepted_task_index: 0.62
  p95_latency_status: pass
regression_gates:
  - invalid_json_rate <= 0.02
  - policy_failure_rate <= 0.01
  - historical_failure_pass_rate >= 0.95
rollback_if:
  - accepted_output_rate drops below 0.88 for two days
  - p95 latency misses target for one release window
  - cost per accepted task rises above budget cap
Эта запись позволяет следующему оценщику спросить: превзошла ли новая модель текущую production-ячейку или она лишь превзошла старое представление о продукте?
Копируемый шаблон запуска
Этот каркас в стиле TypeScript показывает структуру цикла тестирования. Адаптируйте его под ваш стек.
type PromptVersion = {
  id: string;
  system: string;
};

type ModelRoute = {
  id: string;
  model: string;
};

type EvalRow = {
  id: string;
  input: Record<string, unknown>;
  expected: Record<string, unknown>;
};

type EvalResult = {
  rowId: string;
  promptId: string;
  routeId: string;
  sample: number;
  outputText: string;
  validJson: boolean;
  schemaPass: boolean;
  accepted: boolean;
  latencyMs: number;
  costUsd?: number;
};

async function runCell(
  prompt: PromptVersion,
  route: ModelRoute,
  rows: EvalRow[],
  samplesPerRow: number
): Promise<EvalResult[]> {
  const results: EvalResult[] = [];

  for (const row of rows) {
    for (let sample = 0; sample < samplesPerRow; sample++) {
      const started = Date.now();

      const response = await callModel({
        model: route.model,
        system: prompt.system,
        input: row.input,
      });

      const latencyMs = Date.now() - started;
      const parsed = safeJsonParse(response.text);
      const schemaPass = parsed.ok && validateSchema(parsed.value);
      const accepted = schemaPass && validateExpected(parsed.value, row.expected);

      results.push({
        rowId: row.id,
        promptId: prompt.id,
        routeId: route.id,
        sample,
        outputText: response.text,
        validJson: parsed.ok,
        schemaPass,
        accepted,
        latencyMs,
        costUsd: response.usageCost,
      });
    }
  }

  return results;
}
Важная часть — не язык. Важная часть в том, чтобы каждая строка результата содержала версию промпта, маршрут, номер сэмпла, результаты валидатора, задержку и поля стоимости.
Что проверять в Flatkey после запуска
После завершения матрицы проверьте то же тестовое окно в Flatkey:
- Отфильтруйте логи использования по тестовому API-ключу.
- Сгруппируйте по маршруту модели.
- Экспортируйте логи запросов, если финансам или операционной команде нужна проверка в таблице.
- Сравните входные токены, выходные токены, статус и стоимость по маршруту.
- Проверьте, не были ли сбои сосредоточены вокруг одной версии промпта, одной модели или одного сегмента набора данных.
Затем свяжите результат с вашей политикой маршрутизации. Если маршрут по умолчанию выигрывает по качеству, а более дешевый маршрут выигрывает по стоимости принятой задачи для простых случаев, вам может быть не нужен один победитель. Вам может понадобиться маршрут по умолчанию, маршрут эскалации и резервный маршрут. Для следующего шага используйте логику маршрутизации в Руководстве по рабочему процессу стратегии резервного перехода между моделями.
Распространенные ошибки
| Ошибка | Исправление |
|---|---|
| Тестирование только финального промпта на пяти примерах | Используйте репрезентативный набор данных и несколько версий промпта. |
| Сравнение моделей без валидаторов | Сначала разбирайте и проверяйте по схеме каждый структурированный вывод. |
| Оптимизация только по среднему баллу | Отслеживайте дисперсию и исторические случаи сбоев. |
| Игнорирование повторных попыток | Используйте стоимость за принятую задачу, а не стоимость за сырое обращение. |
| Забывание о задержке | Маршрут с высоким качеством все равно может ухудшить пользовательский опыт продукта. |
| Потеря решения | Сохраните результат матрицы как базовый уровень для регрессии. |
Как это связано с прогнозированием затрат
Канонический URL этой статьи посвящен прогнозированию расходов на AI API, потому что тестирование промптов — одно из первых мест, где расходы на ИИ становятся непредсказуемыми. Обновленный workflow тестирования промптов для нескольких моделей делает расходы прогнозируемыми, превращая оценку в повторяемую таблицу:
| Вход для прогноза | Поступает из |
|---|---|
| Объем тестов | Строки датасета x версии промптов x маршруты моделей x сэмплы. |
| Процент повторных попыток | Не прошедшие валидаторы и отклоненные ответы. |
| Стоимость на принятый таск | Логи использования и количество принятых ответов. |
| Буфер на запуск | Риск регрессии, доля fallback и ожидаемый рост. |
| Контроли бюджета | Квота на ключ, ежемесячный лимит и частота пересмотра использования. |
Для плана запуска, готового для финансовой команды, свяжите тестовую матрицу с управлением расходами на AI API для операционных и финансовых команд.
FAQ
Что такое workflow тестирования промптов для нескольких моделей?
Workflow тестирования промптов для нескольких моделей — это повторяемый процесс тестирования нескольких версий промптов через несколько маршрутов моделей с оценкой каждой ячейки по валидаторам, проверке качества, стоимости, задержке и регрессионным критериям.
Сколько примеров мне нужно?
Начните с 50–250 репрезентативных строк. Добавляйте больше строк, если задача высокорисковая, трафик разнообразен или маршрут будет принимать автономные решения.
Стоит ли использовать LLM-judge?
Можно, но не делайте его первым фильтром. Используйте детерминированные валидаторы для схемы, политики и точных требований до оценки с помощью модели. Ручная проверка по-прежнему важна для workflow, критичных к запуску.
Как часто следует повторно запускать workflow?
Перезапускайте его перед сменой моделей по умолчанию, изменением крупных промптов, добавлением fallback-маршрутов, изменением схем инструментов или запуском в новом сегменте. Также повторно запускайте меньший регрессионный набор после обновлений провайдера или модели.
Где здесь место Flatkey?
Flatkey дает командам один API-ключ и один каталог моделей для тестов по нескольким маршрутам, а также видимость использования по имени модели, количеству токенов, стоимости запроса, ключу, статусу и временной метке. Это делает workflow тестирования промптов для нескольких моделей проще в запуске и проще для объяснения финансам или операционной команде.
Итоговый вывод
Побеждает не сам промпт. Побеждает ячейка prompt/model, которая проходит контракт задачи в реалистичных условиях трафика, бюджета и задержки. Используйте workflow тестирования промптов для нескольких моделей выше, чтобы превратить выбор модели из спора в цепочку доказательств: датасет, матрица, валидаторы, стоимость на принятый таск, регрессионные критерии и запись о решении.
Когда вашей команде будет готова тестировать через один OpenAI-совместимый интерфейс, начните с quickstart Flatkey, проверьте доступные маршруты с помощью списка моделей и изучите расходы в журналах использования.