Nếu nhóm của bạn kiểm thử prompt trên từng mô hình một, rất có thể bạn đang đo sai thứ cần đo. Một prompt trông mạnh trên một tuyến có thể thất bại với hợp đồng JSON ở tuyến khác, trở nên quá chậm khi ngữ cảnh dài hơn, hoặc trông rẻ cho đến khi tính cả các lần thử lại và đầu ra bị từ chối.
Hướng dẫn này cung cấp cho các nhóm sản phẩm AI một quy trình kiểm thử prompt đa mô hình thực tế để so sánh các phiên bản prompt trên nhiều tuyến mô hình trước khi ra mắt. Mục tiêu không phải là chọn ra một người chiến thắng tuyệt đối. Mục tiêu là tách biệt chất lượng prompt, mức độ phù hợp với mô hình, độ trễ và chi phí để nhóm có thể chọn một tuyến dựa trên bằng chứng thay vì ảnh chụp màn hình từ playground.
Flatkey hữu ích trong quy trình này vì cùng một tài khoản có thể gọi nhiều tuyến mô hình thông qua API tương thích OpenAI, kiểm tra các mô hình khả dụng qua danh sách mô hình, và xem lại nhật ký sử dụng ở cấp độ request với tên mô hình, số token, chi phí mỗi request, trạng thái và dấu thời gian. Hãy dùng lớp dùng chung đó để chạy kiểm thử, rồi lưu ô prompt/mô hình chiến thắng làm baseline hồi quy.
Câu trả lời ngắn gọn
Một quy trình kiểm thử prompt đa mô hình đáng tin cậy có tám phần:
- Đóng băng hợp đồng tác vụ trước khi chạm vào cài đặt mô hình.
- Tách phiên bản prompt và tuyến mô hình thành các biến riêng biệt.
- Dùng một bộ dữ liệu đại diện, không phải ba ví dụ yêu thích.
- Chạy các mẫu lặp lại khi tính phi tất định là yếu tố quan trọng.
- Xác thực cấu trúc bằng code trước khi nhờ con người chấm chất lượng.
- Theo dõi chi phí trên mỗi tác vụ được chấp nhận, không chỉ giá token.
- Chỉ chọn người thắng nếu nó vượt qua các cổng hồi quy.
- Lưu bản ghi quyết định để lần kiểm thử mô hình tiếp theo bắt đầu từ bằng chứng.
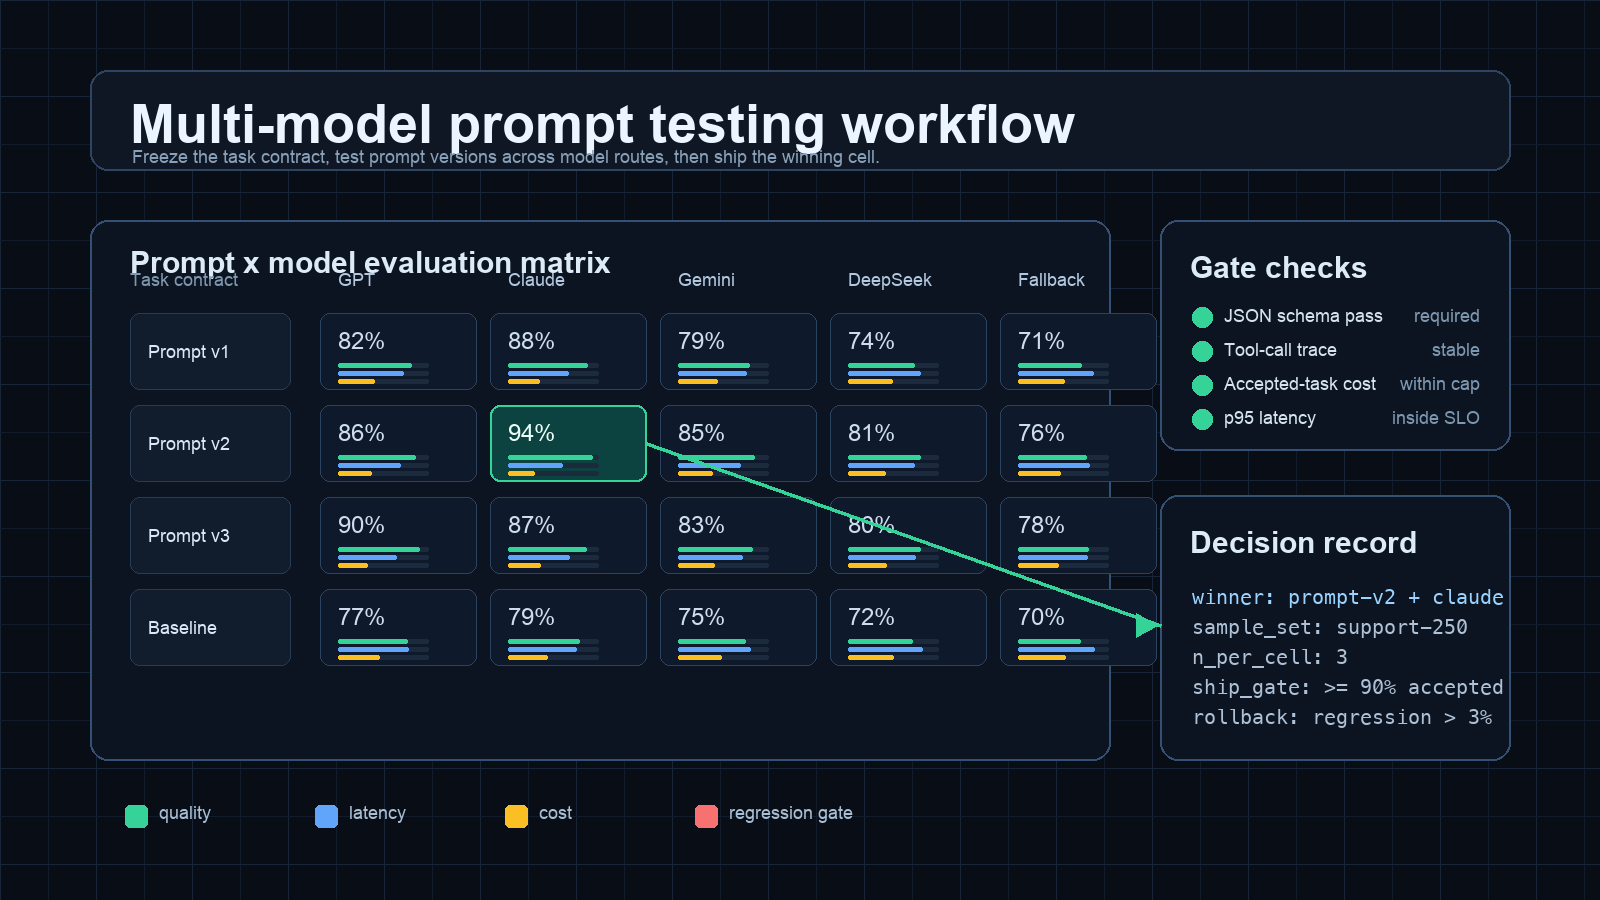
Đó là sự khác biệt giữa "Claude trông tốt hơn trong một bản demo" và "Prompt v2 trên tuyến B đã vượt qua 94% các bài kiểm thử hợp đồng của chúng tôi, vẫn nằm dưới mục tiêu độ trễ p95, và giảm chi phí trên mỗi tác vụ được chấp nhận sau khi tính cả các lần thử lại."
Khi Bạn Cần Quy Trình Này
Hãy dùng quy trình kiểm thử prompt đa mô hình khi một trong các điều sau đúng:
| Tình huống | Vì sao kiểm thử trên một mô hình là yếu |
|---|---|
| Bạn đang chuyển từ một nhà cung cấp sang nhà cung cấp khác | Cách diễn đạt prompt, hành vi gọi công cụ, độ tin cậy của đầu ra có cấu trúc, và phong cách từ chối đều có thể thay đổi. |
| Bạn đang thêm một tuyến dự phòng rẻ hơn | Mô hình rẻ hơn có thể cần một prompt khác hoặc bộ kiểm định chặt hơn để tạo ra kết quả được chấp nhận. |
| Bạn đang kiểm thử các prompt ngữ cảnh dài | Độ dài ngữ cảnh làm thay đổi chi phí, độ trễ, hành vi cache, và khả năng lệch khỏi chỉ dẫn. |
| Bạn đang ra mắt một quy trình sản phẩm | Các bản demo nội bộ che giấu các lần thử lại, đầu ra bị từ chối, và việc leo thang hỗ trợ. |
| Bạn cần khả năng hiển thị cho tài chính | Bộ phận tài chính không quan tâm chỉ đến giá token; họ cần chi phí trên mỗi tác vụ được chấp nhận và các rào chắn ngân sách. |
Nếu quyết định đó ảnh hưởng đến hành vi production, đừng kiểm thử "model A vs model B" như một phép cảm nhận. Hãy kiểm thử theo ma trận giữa phiên bản prompt và tuyến mô hình.
Bước 1: Đóng Băng Hợp Đồng Tác Vụ
Trước khi so sánh các mô hình, hãy ghi rõ hợp đồng mà mô hình phải đáp ứng. Một hợp đồng tác vụ nên xác định:
| Trường | Ví dụ |
|---|---|
| Công việc của người dùng | Phân loại ticket hỗ trợ và soạn một phản hồi an toàn. |
| Dạng đầu vào | Văn bản ticket, cấp khách hàng, khu vực sản phẩm, số lần phản hồi trước đó. |
| Đầu ra bắt buộc | JSON với category, priority, reply, handoff_required, và reason_codes. |
| Lỗi nghiêm trọng | JSON không hợp lệ, thiếu trường bắt buộc, lời hứa không được hỗ trợ, ngôn ngữ hoàn tiền không an toàn. |
| Tiêu chí chất lượng | Danh mục chính xác, phản hồi ngắn gọn, không bịa chính sách, lý do chuyển tiếp hữu ích. |
| Giới hạn vận hành | Độ trễ p95 dưới 4 giây, chi phí mỗi tác vụ được chấp nhận dưới mức trần của nhóm. |
Hãy làm bước này trước vì hợp đồng giữ cho quy trình kiểm thử prompt đa mô hình luôn trung thực. Nếu không, người đánh giá sẽ tối ưu cho phản hồi trông hay nhất trong một ví dụ, chứ không phải hướng đi sống sót trong sản xuất.
Bước 2: Xây dựng Ma trận Prompt x Mô hình
Tách các biến ra. Phiên bản prompt và tuyến mô hình nên mỗi thứ có một trục riêng.
| Ô kiểm thử | Prompt | Tuyến mô hình | Nó trả lời điều gì |
|---|---|---|---|
| A1 | Prompt v1 | Mặc định hiện tại | Baseline hiện tại còn chấp nhận được không? |
| A2 | Prompt v1 | Tuyến thay thế rẻ hơn | Prompt hiện tại có chuyển giao được không? |
| B1 | Prompt v2 | Mặc định hiện tại | Prompt đã cải thiện chất lượng mà không thay đổi mô hình chưa? |
| B2 | Prompt v2 | Tuyến thay thế rẻ hơn | Có cặp prompt/mô hình nào tốt hơn không? |
| C1 | Prompt v3 | Mặc định hiện tại | Chỉ dẫn chặt hơn có giảm lỗi không? |
| C2 | Prompt v3 | Tuyến cao cấp thay thế | Có đáng để chuyển tiếp với chi phí tăng thêm không? |
Ma trận này là trung tâm của quy trình kiểm thử prompt đa mô hình. Nó ngăn một sai lầm phổ biến: đổ lỗi cho mô hình khi prompt mới là biến thực sự, hoặc khen prompt khi mô hình đang gánh các chỉ dẫn yếu.
Bước 3: Sử dụng Một Bộ Dữ liệu Đại diện
Đừng đánh giá trên những ví dụ dễ sao chép nhất. Hãy xây dựng một bộ dữ liệu nhỏ phản ánh lưu lượng thực tế.
Với quy trình hỗ trợ, hãy bao gồm:
- Các ticket phổ biến đáng lẽ phải dễ xử lý.
- Các trường hợp biên khi chính sách rất nghiêm ngặt.
- Ticket ngắn, mơ hồ.
- Ticket dài với nhiều chi tiết không liên quan.
- Ví dụ đa ngôn ngữ hoặc pha trộn ngôn ngữ nếu chúng xuất hiện trong sản xuất.
- Các lỗi lịch sử đã biết.
- Những ví dụ nên kích hoạt chuyển tiếp.
Với mỗi hàng, hãy giữ lại hành vi kỳ vọng. Không phải lúc nào cũng cần một đáp án vàng hoàn hảo, nhưng cần đủ cơ sở thực tế để bộ kiểm tra hoặc người đánh giá quyết định xem kết quả có chấp nhận được hay không.
Một bộ dữ liệu khởi đầu tốt thường có từ 50 đến 250 hàng. Như vậy đủ nhỏ để chạy lặp lại và đủ lớn để bộc lộ nhiều hơn hành vi trình diễn.
Bước 4: Chạy Ma trận Với Các Mẫu Lặp Lại
Với trích xuất hoặc phân loại tất định, một lần chạy cho mỗi ô có thể đủ cho sàng lọc ban đầu. Với các tác vụ viết, suy luận, dùng công cụ hoặc dạng tác nhân, hãy chạy nhiều mẫu cho mỗi ô.
Hãy dùng quy tắc khởi đầu này:
| Loại tác vụ | Mẫu mỗi hàng kiểm thử |
|---|---|
| Phân loại nghiêm ngặt | 1 đến 2 |
| Trích xuất JSON | 2 |
| Viết nội dung hướng tới khách hàng | 3 |
| Gọi công cụ | 3 |
| Suy luận ngữ cảnh dài | 3 đến 5 |
| Luồng tác tử | 5 nếu chi phí cho phép |
Các mẫu lặp lại cho thấy độ biến thiên. Một luồng đạt 94% ở lần đầu và 71% ở lần chạy tiếp theo thì chưa sẵn sàng cho sản xuất, ngay cả khi mẫu tốt nhất trông rất ấn tượng.
Step 5: Xác thực cấu trúc trước chất lượng
Mỗi quy trình kiểm thử prompt đa mô hình nên đánh giá cấu trúc trước khi đánh giá chất lượng cảm nhận. Hãy chạy các kiểm tra tự động trước:
| Trình xác thực | Nó phát hiện gì |
|---|---|
| Phân tích cú pháp JSON | Đầu ra có cấu trúc không hợp lệ. |
| Xác thực lược đồ | Thiếu trường, enum sai, kiểu sai. |
| Kiểm tra regex hoặc chính sách | Cụm từ không được phép, tuyên bố bị cấm, thiếu trích dẫn. |
| Trình xác thực dấu vết công cụ | Công cụ sai, thiếu đối số, tác dụng phụ không an toàn. |
| Kiểm tra đơn vị xác định | Phân loại sai, biến đổi số sai, xử lý ngày không hợp lệ. |
Chỉ những đầu ra cấu trúc đã được chấp nhận mới nên chuyển sang đánh giá chất lượng bởi con người hoặc có sự hỗ trợ của mô hình. Điều đó tiết kiệm thời gian cho người đánh giá và giữ cho việc chấm điểm công bằng giữa các luồng.
Step 6: Theo dõi chi phí cho mỗi tác vụ được chấp nhận
Đừng chỉ so sánh các luồng dựa trên giá niêm yết. Hãy so sánh số tiền mà nhóm thực sự trả cho các kết quả được chấp nhận.
Sử dụng chỉ số này:
cost_per_accepted_task =
  total_cost_for_cell / accepted_outputs
Sau đó bổ sung ngữ cảnh:
accepted_output_rate =
  accepted_outputs / total_attempts

retry_adjusted_cost =
  total_cost_for_cell + retry_cost + reviewer_rerun_cost
Điều này quan trọng vì một luồng có giá token thấp hơn có thể trở nên đắt hơn nếu nó tạo ra nhiều JSON không hợp lệ, đầu ra dài hơn, lỗi gọi công cụ, hoặc phải chạy lại thủ công nhiều hơn. Flatkey Usage Logs được thiết kế cho kiểu xem xét này: mỗi yêu cầu có thể được kiểm tra theo mô hình, token đầu vào, token đầu ra, chi phí, khóa, trạng thái và dấu thời gian.
Nếu hướng dẫn chi phí hiện tại của bạn vẫn chỉ dựa trên token, hãy ghép bài viết này với quy trình nội bộ từ Cách so sánh giá mô hình AI trước khi chuyển nhà cung cấp API. Bài kiểm thử prompt nên trả lời câu hỏi tiếp theo: luồng nào tạo ra công việc được chấp nhận với chi phí vận hành thấp nhất?
Step 7: Chấm điểm ma trận
Hãy dùng một bảng điểm có trọng số. Giữ cho phiên bản đầu tiên đủ đơn giản để sản phẩm, kỹ thuật và tài chính có thể đồng thuận.
| Chỉ số | Trọng số | Đo lường |
|---|---|---|
| Tỷ lệ vượt qua hợp đồng | 30% | Đạt các kiểm tra bắt buộc về schema và chính sách. |
| Chấp nhận của con người | 25% | Người đánh giá chấp nhận câu trả lời để sử dụng trong sản xuất. |
| Chi phí trên mỗi tác vụ được chấp nhận | 20% | Tổng chi tiêu của cell chia cho các đầu ra được chấp nhận. |
| Độ trễ p95 | 15% | Độ trễ của tuyến xử lý nằm dưới mục tiêu của workflow. |
| An toàn trước regression | 10% | Không sụt giảm trên các ca lỗi lịch sử. |
Ví dụ quyết định:
| Prompt/model cell | Vượt qua hợp đồng | Con người chấp nhận | Chi phí/tác vụ | Độ trễ p95 | Quyết định cuối cùng |
|---|---|---|---|---|---|
| Prompt v1 + current route | 88% | 84% | 1.00x | Đạt | Giữ làm baseline dự phòng |
| Prompt v2 + current route | 93% | 91% | 1.04x | Đạt | Mạnh nhưng không rẻ nhất |
| Prompt v2 + cheaper route | 91% | 89% | 0.62x | Đạt | Triển khai cho lưu lượng mặc định |
| Prompt v3 + cheaper route | 84% | 80% | 0.58x | Đạt | Từ chối do giảm chất lượng |
| Prompt v2 + premium route | 96% | 94% | 2.30x | Ở mức ranh giới | Chỉ dùng cho escalation |
Cell chiến thắng không phải lúc nào cũng là cell có điểm chất lượng cao nhất. Đó là cell vượt qua các ngưỡng về chất lượng, độ trễ, độ tin cậy và chi phí cho công việc.
Step 8: Lưu một bản ghi quyết định
Một bài kiểm thử prompt không thể lặp lại thì không phải là một workflow. Hãy lưu bản ghi quyết định cùng prompt, route, bộ dữ liệu, scorecard và các điều kiện rollback.
workflow: support_reply_generation
decision_date: 2026-09-26
dataset: support-eval-250
winner:
  prompt_version: prompt-v2
  model_route: candidate-cheaper-route
  reason: "Đã vượt qua ngưỡng chất lượng với chi phí trên mỗi tác vụ được chấp nhận thấp hơn"
baseline:
  prompt_version: prompt-v1
  model_route: current-default
metrics:
  accepted_output_rate: 0.91
  cost_per_accepted_task_index: 0.62
  p95_latency_status: pass
regression_gates:
  - invalid_json_rate <= 0.02
  - policy_failure_rate <= 0.01
  - historical_failure_pass_rate >= 0.95
rollback_if:
  - accepted_output_rate drops below 0.88 for two days
  - p95 latency misses target for one release window
  - cost per accepted task rises above budget cap
Bản ghi này giúp người đánh giá tiếp theo hỏi: mô hình mới có vượt qua cell sản xuất hiện tại không, hay chỉ vượt qua một ký ức cũ về sản phẩm?
Một skeleton runner có thể sao chép
Skeleton theo kiểu TypeScript này cho thấy hình dạng của vòng lặp kiểm thử. Hãy điều chỉnh nó cho phù hợp với stack của bạn.
type PromptVersion = {
  id: string;
  system: string;
};

type ModelRoute = {
  id: string;
  model: string;
};

type EvalRow = {
  id: string;
  input: Record<string, unknown>;
  expected: Record<string, unknown>;
};

type EvalResult = {
  rowId: string;
  promptId: string;
  routeId: string;
  sample: number;
  outputText: string;
  validJson: boolean;
  schemaPass: boolean;
  accepted: boolean;
  latencyMs: number;
  costUsd?: number;
};

async function runCell(
  prompt: PromptVersion,
  route: ModelRoute,
  rows: EvalRow[],
  samplesPerRow: number
): Promise<EvalResult[]> {
  const results: EvalResult[] = [];

  for (const row of rows) {
    for (let sample = 0; sample < samplesPerRow; sample++) {
      const started = Date.now();

      const response = await callModel({
        model: route.model,
        system: prompt.system,
        input: row.input,
      });

      const latencyMs = Date.now() - started;
      const parsed = safeJsonParse(response.text);
      const schemaPass = parsed.ok && validateSchema(parsed.value);
      const accepted = schemaPass && validateExpected(parsed.value, row.expected);

      results.push({
        rowId: row.id,
        promptId: prompt.id,
        routeId: route.id,
        sample,
        outputText: response.text,
        validJson: parsed.ok,
        schemaPass,
        accepted,
        latencyMs,
        costUsd: response.usageCost,
      });
    }
  }

  return results;
}
Phần quan trọng không phải là ngôn ngữ. Phần quan trọng là mỗi hàng kết quả đều có phiên bản prompt, route, số mẫu, kết quả bộ kiểm tra, độ trễ và các trường chi phí.
Những gì cần xem lại trong Flatkey sau khi chạy
Sau khi ma trận hoàn tất, hãy xem lại cùng cửa sổ kiểm thử trong Flatkey:
- Lọc log sử dụng theo API key kiểm thử.
- Nhóm theo model route.
- Xuất log yêu cầu nếu bộ phận tài chính hoặc vận hành cần xem xét bằng bảng tính.
- So sánh số token đầu vào, token đầu ra, trạng thái và chi phí theo từng route.
- Kiểm tra xem lỗi có tập trung quanh một phiên bản prompt, một mô hình hay một phân đoạn dữ liệu nào không.
Sau đó, hãy liên kết kết quả với chính sách định tuyến của bạn. Nếu route mặc định thắng về chất lượng nhưng một route rẻ hơn thắng về chi phí cho tác vụ đã được chấp nhận trong các trường hợp đơn giản, bạn có thể không cần một người thắng duy nhất. Bạn có thể cần một route mặc định, một route chuyển tiếp và một route dự phòng. Cho bước tiếp theo đó, hãy dùng logic định tuyến trong Sách hướng dẫn quy trình chiến lược dự phòng mô hình.
Các lỗi thường gặp
| Lỗi | Cách khắc phục |
|---|---|
| Chỉ kiểm thử prompt cuối cùng trên năm ví dụ | Sử dụng bộ dữ liệu đại diện và nhiều phiên bản prompt. |
| So sánh các mô hình mà không có bộ kiểm tra | Phân tích cú pháp và kiểm tra schema cho mọi đầu ra có cấu trúc trước tiên. |
| Tối ưu chỉ theo điểm trung bình | Theo dõi độ biến thiên và các trường hợp lỗi trong quá khứ. |
| Bỏ qua các lần thử lại | Sử dụng chi phí trên mỗi tác vụ được chấp nhận, không phải chi phí trên mỗi lần gọi thô. |
| Quên độ trễ | Một route chất lượng cao vẫn có thể làm hỏng trải nghiệm sản phẩm. |
| Làm mất quyết định | Lưu kết quả ma trận làm baseline hồi quy. |
Cách điều này liên kết với dự báo chi phí
URL chuẩn tắc cho bài viết này là về dự báo chi tiêu API AI vì kiểm thử prompt là một trong những nơi đầu tiên khiến chi tiêu AI trở nên khó đoán. Quy trình kiểm thử prompt đa mô hình được cập nhật giúp chi tiêu có thể dự báo bằng cách biến đánh giá thành một bảng lặp lại được:
| Đầu vào dự báo | Đến từ |
|---|---|
| Khối lượng kiểm thử | Số hàng dữ liệu x phiên bản prompt x tuyến mô hình x mẫu. |
| Tỷ lệ thử lại | Các trình xác thực thất bại và đầu ra bị từ chối. |
| Chi phí mỗi tác vụ được chấp nhận | Nhật ký sử dụng và số lượng đầu ra được chấp nhận. |
| Khoảng đệm khi ra mắt | Rủi ro hồi quy, tỷ trọng fallback và tăng trưởng kỳ vọng. |
| Kiểm soát ngân sách | Hạn mức theo khóa, trần hàng tháng và tần suất rà soát sử dụng. |
Để có một kế hoạch triển khai sẵn sàng cho tài chính, hãy kết nối ma trận kiểm thử với Quản lý chi tiêu API AI cho các nhóm vận hành và tài chính.
Câu hỏi thường gặp
Quy trình kiểm thử prompt đa mô hình là gì?
Quy trình kiểm thử prompt đa mô hình là một quy trình lặp lại để kiểm thử nhiều phiên bản prompt trên nhiều tuyến mô hình, chấm điểm từng ô bằng trình xác thực, rà soát chất lượng, chi phí, độ trễ và các cổng kiểm soát hồi quy.
Tôi cần bao nhiêu ví dụ?
Bắt đầu với 50 đến 250 hàng đại diện. Thêm nhiều hàng hơn khi tác vụ có rủi ro cao, lưu lượng đa dạng, hoặc tuyến sẽ đưa ra quyết định tự chủ.
Tôi có nên dùng LLM làm bộ phán xét không?
Bạn có thể, nhưng đừng để nó làm cổng kiểm soát đầu tiên. Hãy dùng các trình xác thực xác định cho lược đồ, chính sách và các yêu cầu chính xác trước khi chấm điểm có hỗ trợ mô hình. Rà soát của con người vẫn rất quan trọng đối với các quy trình then chốt khi ra mắt.
Chúng ta nên chạy lại quy trình với tần suất thế nào?
Chạy lại trước khi chuyển đổi mô hình mặc định, thay đổi prompt chính, thêm tuyến fallback, thay đổi lược đồ công cụ, hoặc ra mắt cho một phân khúc mới. Đồng thời chạy lại một bộ hồi quy nhỏ hơn sau khi nhà cung cấp hoặc mô hình được cập nhật.
Flatkey phù hợp ở đâu?
Flatkey cung cấp cho các nhóm một API key và một danh mục mô hình cho các bài kiểm thử đa tuyến, cùng khả năng quan sát việc sử dụng theo tên mô hình, số token, chi phí yêu cầu, khóa, trạng thái và dấu thời gian. Điều đó giúp quy trình kiểm thử prompt đa mô hình dễ vận hành hơn và dễ giải thích hơn với tài chính hoặc vận hành.
Kết luận cuối cùng
Prompt chiến thắng không phải là một prompt. Nó là một ô prompt/mô hình vượt qua hợp đồng tác vụ trong điều kiện lưu lượng, ngân sách và độ trễ thực tế. Hãy dùng quy trình kiểm thử prompt đa mô hình ở trên để biến việc chọn mô hình từ một cuộc tranh luận thành một dấu vết bằng chứng: bộ dữ liệu, ma trận, trình xác thực, chi phí mỗi tác vụ được chấp nhận, cổng kiểm soát hồi quy và bản ghi quyết định.
Khi nhóm của bạn sẵn sàng kiểm thử qua một bề mặt tương thích với OpenAI, hãy bắt đầu với Flatkey quickstart, xác minh các tuyến khả dụng bằng danh sách mô hình, và kiểm tra chi tiêu trong Usage Logs.