Si su equipo prueba prompts en un modelo a la vez, probablemente esté midiendo la cosa equivocada. Un prompt que parece sólido en una ruta puede fallar un contrato JSON en otra, volverse demasiado lento con un contexto más largo o parecer barato hasta que se incluyan los reintentos y las salidas rechazadas.
Esta guía ofrece a los equipos de producto de IA un flujo de trabajo de pruebas de prompts multimodelo práctico para comparar versiones de prompts entre rutas de modelos antes del lanzamiento. El objetivo no es coronar a un ganador universal. El objetivo es separar la calidad del prompt, la adecuación del modelo, la latencia y el coste para que el equipo pueda elegir una ruta con evidencia en lugar de capturas de pantalla de un playground.
Flatkey es útil en este flujo de trabajo porque la misma cuenta puede llamar a muchas rutas de modelos a través de una API compatible con OpenAI, inspeccionar los modelos disponibles mediante la lista de modelos y revisar registros de uso a nivel de solicitud con nombres de modelos, recuentos de tokens, coste por solicitud, estado y marcas de tiempo. Use esa capa compartida para ejecutar la prueba y luego almacene la celda ganadora de prompt/modelo como una línea base de regresión.
La respuesta corta
Un flujo de trabajo de pruebas de prompts multimodelo fiable tiene ocho partes:
- Congele el contrato de la tarea antes de tocar la configuración del modelo.
- Separe la versión del prompt y la ruta del modelo en variables distintas.
- Use un conjunto de datos representativo, no tres ejemplos favoritos.
- Ejecute muestras repetidas donde la no determinación importe.
- Valide la estructura con código antes de pedir a una persona que califique la calidad.
- Haga seguimiento del coste por tarea aceptada, no solo del precio por token.
- Promueva a un ganador solo si pasa los controles de regresión.
- Almacene el registro de la decisión para que la siguiente prueba de modelo parta de la evidencia.
Esta es la diferencia entre "Claude se vio mejor en una demo" y "El prompt v2 en la ruta B superó el 94% de nuestras pruebas de contrato, se mantuvo por debajo de nuestro objetivo de latencia p95 y redujo el coste por tarea aceptada después de los reintentos".
Cuándo necesitas este flujo de trabajo
Use un flujo de trabajo de pruebas de prompts multimodelo cuando una de estas situaciones sea verdadera:
| Situación | Por qué las pruebas con un solo modelo son débiles |
|---|---|
| Está cambiando de un proveedor a otro | La redacción del prompt, el comportamiento de llamadas a herramientas, la fiabilidad de la salida estructurada y el estilo de rechazo pueden cambiar. |
| Está añadiendo una ruta de respaldo más barata | El modelo más barato puede necesitar un prompt diferente o un validador más estricto para producir resultados aceptados. |
| Está probando prompts de contexto largo | La longitud del contexto cambia el coste, la latencia, el comportamiento de caché y la probabilidad de deriva de instrucciones. |
| Está lanzando un flujo de trabajo de producto | Las demostraciones internas ocultan reintentos, salidas rechazadas y escaladas de soporte. |
| Necesita visibilidad financiera | A Finanzas no le importa solo el precio por token; necesita coste por tarea aceptada y límites presupuestarios. |
Si la decisión afecta el comportamiento en producción, no pruebe "modelo A vs modelo B" como una comprobación de sensaciones. Pruebe versión de prompt por ruta de modelo como una matriz.
Paso 1: Congela el contrato de la tarea
Antes de comparar modelos, escriba el contrato que el modelo debe cumplir. Un contrato de tarea debería definir:
| Campo | Ejemplo |
|---|---|
| Trabajo del usuario | Clasificar tickets de soporte y redactar una respuesta segura. |
| Forma de entrada | Texto del ticket, nivel del cliente, área del producto, recuento de respuestas anteriores. |
| Salida requerida | JSON con category, priority, reply, handoff_required y reason_codes. |
| Fallos críticos | JSON no válido, campo requerido faltante, promesa no admitida, lenguaje de reembolso no seguro. |
| Criterios de calidad | Categoría correcta, respuesta concisa, sin política inventada, motivo de escalado útil. |
| Límites operativos | latencia p95 por debajo de 4 segundos, coste por tarea aceptada por debajo del límite del equipo. |
Haz esto primero porque el contrato mantiene honesto el flujo de trabajo de pruebas de prompts multimodelo. Sin él, los revisores optimizarán para la respuesta que se lee mejor en un ejemplo, no para la ruta que sobrevive en producción.
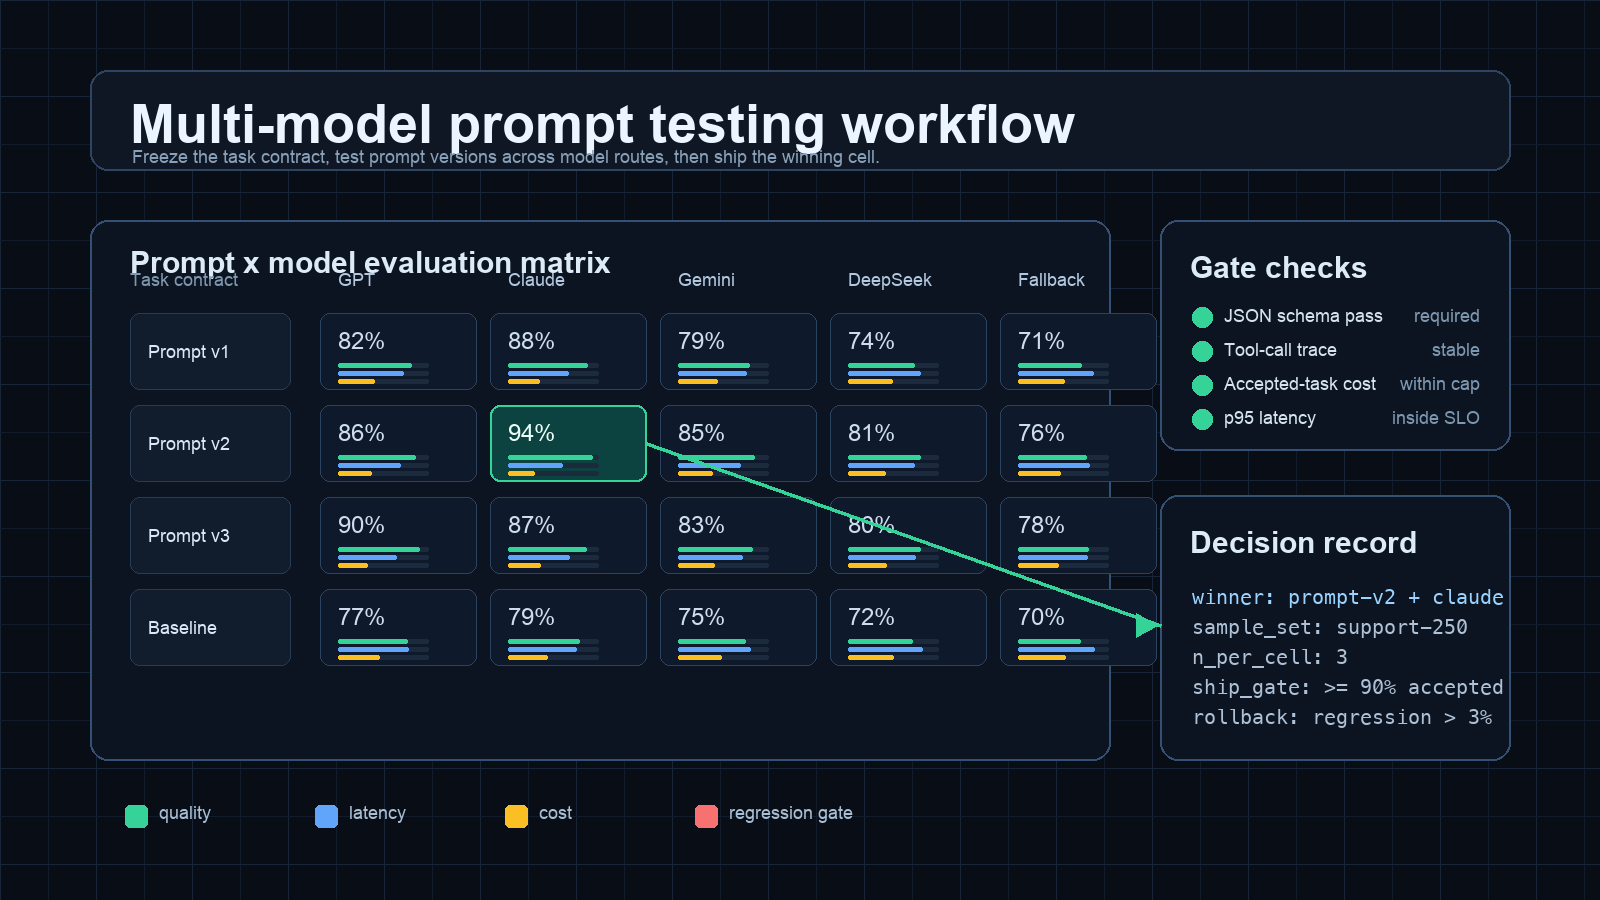
Paso 2: Crea la matriz de prompt x modelo
Separa las variables. La versión del prompt y la ruta del modelo deben tener cada una su propio eje.
| Celda de prueba | Prompt | Ruta del modelo | Qué responde |
|---|---|---|---|
| A1 | Prompt v1 | Predeterminado actual | ¿Sigue siendo aceptable la línea base? |
| A2 | Prompt v1 | Ruta más barata candidata | ¿Se transfiere el prompt actual? |
| B1 | Prompt v2 | Predeterminado actual | ¿Mejoró el prompt la calidad sin cambiar el modelo? |
| B2 | Prompt v2 | Ruta más barata candidata | ¿Hay una mejor combinación de prompt/modelo? |
| C1 | Prompt v3 | Predeterminado actual | ¿Reducjeron las instrucciones más estrictas los fallos? |
| C2 | Prompt v3 | Ruta premium candidata | ¿Merece la pena la escalada por el coste añadido? |
Esta matriz es el núcleo del flujo de trabajo de pruebas de prompts multimodelo. Evita un error común: culpar al modelo cuando el prompt es la verdadera variable, o elogiar el prompt cuando el modelo está sosteniendo instrucciones débiles.
Paso 3: Usa un conjunto de datos representativo
No evalúes con los ejemplos que sean más fáciles de copiar. Crea un conjunto de datos pequeño que refleje el tráfico real.
Para un flujo de trabajo de soporte, incluye:
- Tickets comunes que deberían ser fáciles.
- Casos límite donde la política es estricta.
- Tickets breves y ambiguos.
- Tickets largos con detalles irrelevantes.
- Ejemplos multilingües o en lenguaje mixto si ocurren en producción.
- Fallos históricos conocidos.
- Ejemplos que deberían activar la derivación.
Para cada fila, conserva el comportamiento esperado. No siempre necesita una respuesta ideal perfecta, pero sí suficiente verdad de referencia para que un validador o revisor decida si el resultado es aceptable.
Un buen conjunto de datos inicial suele tener entre 50 y 250 filas. Eso es lo bastante pequeño para ejecutarlo repetidamente y lo bastante grande para exponer más que comportamiento de demo.
Paso 4: Ejecuta la matriz con muestras repetidas
Para extracción o clasificación deterministas, una ejecución por celda puede ser suficiente para una evaluación inicial. Para tareas de escritura, razonamiento, uso de herramientas o tareas agénticas, ejecuta varias muestras por celda.
Usa esta regla inicial:
| Tipo de tarea | Muestras por fila de prueba |
|---|---|
| Clasificación estricta | 1 a 2 |
| Extracción de JSON | 2 |
| Redacción dirigida al cliente | 3 |
| Llamada a herramientas | 3 |
| Razonamiento de contexto largo | 3 a 5 |
| Flujo de trabajo de agente | 5 si el coste lo permite |
Las muestras repetidas muestran variación. Una ruta que obtiene un 94% una vez y un 71% en la siguiente pasada no está lista para producción, aunque la mejor muestra parezca impresionante.
Step 5: Validar la estructura antes que la calidad
Todo flujo de trabajo de pruebas de prompts multimodelo debe evaluar la estructura antes que el estilo. Ejecute primero las comprobaciones automatizadas:
| Validador | Qué detecta |
|---|---|
| Parseo de JSON | Salida estructurada inválida. |
| Validación de esquema | Campos faltantes, enum incorrecto, tipo incorrecto. |
| Comprobaciones de expresiones regulares o de política | Frases no permitidas, afirmaciones prohibidas, citas faltantes. |
| Validador de traza de herramientas | Herramienta incorrecta, argumento faltante, efecto secundario inseguro. |
| Comprobaciones unitarias deterministas | Categoría incorrecta, transformación numérica incorrecta, manejo de fechas inválido. |
Solo las salidas estructurales aceptadas deben llegar a la revisión de calidad humana o asistida por modelo. Eso ahorra tiempo al revisor y mantiene justa la puntuación entre rutas.
Step 6: Registrar el coste por tarea aceptada
No compare las rutas solo por el precio de lista. Compare lo que el equipo realmente paga por los resultados aceptados.
Use esta métrica:
cost_per_accepted_task =
  total_cost_for_cell / accepted_outputs
Luego añada contexto:
accepted_output_rate =
  accepted_outputs / total_attempts

retry_adjusted_cost =
  total_cost_for_cell + retry_cost + reviewer_rerun_cost
Esto importa porque una ruta con un precio por token más bajo puede resultar más cara si crea más JSON inválidos, salidas más largas, errores de llamada a herramientas o reejecuciones manuales. Flatkey Usage Logs están diseñados para este tipo de revisión: cada solicitud puede inspeccionarse por modelo, tokens de entrada, tokens de salida, coste, clave, estado y marca de tiempo.
Si su guía de costes actual sigue basada solo en tokens, combine este artículo con el flujo interno de Cómo comparar los precios de modelos de IA antes de cambiar de proveedor de API. La prueba del prompt debe responder la siguiente pregunta: ¿qué ruta produce trabajo aceptado al menor coste operativo?
Step 7: Puntuar la matriz
Utilice una tarjeta de puntuación ponderada. Mantenga la primera versión lo bastante simple como para que producto, ingeniería y finanzas puedan ponerse de acuerdo sobre ella.
| Métrica | Peso | Medición |
|---|---|---|
| Tasa de aprobación de contrato | 30% | Se superan las comprobaciones obligatorias de esquema y políticas. |
| Aceptación humana | 25% | El revisor acepta la respuesta para uso en producción. |
| Coste por tarea aceptada | 20% | El gasto total de la celda dividido por las salidas aceptadas. |
| Latencia p95 | 15% | La latencia de la ruta está por debajo del objetivo del flujo de trabajo. |
| Seguridad ante regresiones | 10% | No hay descenso en los casos históricos de fallo. |
Ejemplo de decisión:
| Celda de prompt/modelo | Aprobación de contrato | Aceptación humana | Coste/tarea | Latencia p95 | Decisión final |
|---|---|---|---|---|---|
| Prompt v1 + ruta actual | 88% | 84% | 1.00x | Pass | Mantener como línea base de respaldo |
| Prompt v2 + ruta actual | 93% | 91% | 1.04x | Pass | Fuerte, pero no la más barata |
| Prompt v2 + ruta más barata | 91% | 89% | 0.62x | Pass | Desplegar para el tráfico predeterminado |
| Prompt v3 + ruta más barata | 84% | 80% | 0.58x | Pass | Rechazar por caída de calidad |
| Prompt v2 + ruta premium | 96% | 94% | 2.30x | Borderline | Usar solo para escalado |
La celda ganadora no siempre es la de mayor puntuación de calidad. Es la celda que supera los límites de calidad, latencia, fiabilidad y coste para el trabajo.
Paso 8: Guarda un registro de decisión
Una prueba de prompt que no puede repetirse no es un flujo de trabajo. Guarda el registro de decisión con el prompt, la ruta, el conjunto de datos, la tarjeta de puntuación y las condiciones de reversión.
workflow: support_reply_generation
decision_date: 2026-09-26
dataset: support-eval-250
winner:
  prompt_version: prompt-v2
  model_route: candidate-cheaper-route
  reason: "Passed quality gate with lower cost per accepted task"
baseline:
  prompt_version: prompt-v1
  model_route: current-default
metrics:
  accepted_output_rate: 0.91
  cost_per_accepted_task_index: 0.62
  p95_latency_status: pass
regression_gates:
  - invalid_json_rate <= 0.02
  - policy_failure_rate <= 0.01
  - historical_failure_pass_rate >= 0.95
rollback_if:
  - accepted_output_rate drops below 0.88 for two days
  - p95 latency misses target for one release window
  - cost per accepted task rises above budget cap
Este registro permite al siguiente evaluador preguntar: ¿el nuevo modelo superó la celda de producción actual, o solo superó un recuerdo antiguo del producto?
Un esqueleto de ejecución copiable
Este esqueleto de estilo TypeScript muestra la forma del ciclo de pruebas. Adáptalo a tu pila.
type PromptVersion = {
  id: string;
  system: string;
};

type ModelRoute = {
  id: string;
  model: string;
};

type EvalRow = {
  id: string;
  input: Record<string, unknown>;
  expected: Record<string, unknown>;
};

type EvalResult = {
  rowId: string;
  promptId: string;
  routeId: string;
  sample: number;
  outputText: string;
  validJson: boolean;
  schemaPass: boolean;
  accepted: boolean;
  latencyMs: number;
  costUsd?: number;
};

async function runCell(
  prompt: PromptVersion,
  route: ModelRoute,
  rows: EvalRow[],
  samplesPerRow: number
): Promise<EvalResult[]> {
  const results: EvalResult[] = [];

  for (const row of rows) {
    for (let sample = 0; sample < samplesPerRow; sample++) {
      const started = Date.now();

      const response = await callModel({
        model: route.model,
        system: prompt.system,
        input: row.input,
      });

      const latencyMs = Date.now() - started;
      const parsed = safeJsonParse(response.text);
      const schemaPass = parsed.ok && validateSchema(parsed.value);
      const accepted = schemaPass && validateExpected(parsed.value, row.expected);

      results.push({
        rowId: row.id,
        promptId: prompt.id,
        routeId: route.id,
        sample,
        outputText: response.text,
        validJson: parsed.ok,
        schemaPass,
        accepted,
        latencyMs,
        costUsd: response.usageCost,
      });
    }
  }

  return results;
}
La parte importante no es el lenguaje. Lo importante es que cada fila de resultado tenga la versión del prompt, la ruta, el número de muestra, los resultados del validador, la latencia y los campos de coste.
Qué revisar en Flatkey después de la ejecución
Una vez que termine la matriz, revisa la misma ventana de prueba en Flatkey:
- Filtra los registros de uso por la clave API de prueba.
- Agrupa por ruta de modelo.
- Exporta los registros de solicitudes si finanzas u operaciones necesitan revisarlos en una hoja de cálculo.
- Compara tokens de entrada, tokens de salida, estado y coste por ruta.
- Comprueba si los fallos se agruparon alrededor de una versión de prompt, un modelo o un segmento del conjunto de datos.
Luego conecta el resultado con tu política de enrutamiento. Si la ruta predeterminada gana en calidad, pero una ruta más barata gana en coste por tarea aceptada para casos simples, puede que no necesites un único ganador. Puede que necesites una ruta predeterminada, una ruta de escalado y una ruta de respaldo. Para ese siguiente paso, usa la lógica de enrutamiento en Model Fallback Strategy Workflow Playbook.
Errores comunes
| Error | Corrección |
|---|---|
| Probar solo el prompt final con cinco ejemplos | Usa un conjunto de datos representativo y varias versiones de prompt. |
| Comparar modelos sin validadores | Primero analiza y comprueba el esquema de cada salida estructurada. |
| Optimizar solo para la puntuación media | Haz seguimiento de la varianza y de los casos de fallo históricos. |
| Ignorar los reintentos | Usa el coste por tarea aceptada, no el coste por llamada en bruto. |
| Olvidar la latencia | Una ruta de alta calidad aún puede perjudicar la experiencia del producto. |
| Perder la decisión | Guarda el resultado de la matriz como una línea base de regresión. |
Cómo se conecta esto con la previsión de costes
La URL canónica de este artículo trata sobre la previsión del gasto en API de IA porque las pruebas de prompts son uno de los primeros lugares donde el gasto en IA se vuelve impredecible. El flujo de trabajo de pruebas de prompts multimodelo actualizado hace que el gasto sea predecible al convertir la evaluación en una tabla repetible:
| Entrada de previsión | Procede de |
|---|---|
| Volumen de pruebas | Filas del conjunto de datos x versiones de prompts x rutas de modelo x muestras. |
| Tasa de reintentos | Validadores fallidos y resultados rechazados. |
| Coste por tarea aceptada | Registros de uso y recuento de resultados aceptados. |
| Margen de lanzamiento | Riesgo de regresión, proporción de respaldo y crecimiento esperado. |
| Controles de presupuesto | Cuota por clave, tope mensual y cadencia de revisión del uso. |
Para un plan de despliegue listo para finanzas, conecta la matriz de pruebas con Gestión del gasto en API de IA para equipos de operaciones y finanzas.
Preguntas frecuentes
¿Qué es un flujo de trabajo de pruebas de prompts multimodelo?
Un flujo de trabajo de pruebas de prompts multimodelo es un proceso repetible para probar múltiples versiones de prompts en múltiples rutas de modelo, puntuando cada celda con validadores, revisión de calidad, coste, latencia y barreras de regresión.
¿Cuántos ejemplos necesito?
Empieza con 50 a 250 filas representativas. Añade más filas cuando la tarea sea de alto riesgo, el tráfico sea diverso o la ruta vaya a tomar decisiones autónomas.
¿Debería usar un juez LLM?
Puedes hacerlo, pero no lo conviertas en la primera barrera. Usa validadores deterministas para el esquema, la política y los requisitos exactos antes de la evaluación asistida por modelo. La revisión humana sigue siendo importante para los flujos de trabajo críticos para el lanzamiento.
¿Con qué frecuencia deberíamos volver a ejecutar el flujo de trabajo?
Vuelve a ejecutarlo antes de cambiar los modelos predeterminados, modificar prompts importantes, añadir rutas de respaldo, cambiar esquemas de herramientas o lanzar a un nuevo segmento. También vuelve a ejecutar un conjunto de regresión más pequeño después de actualizaciones del proveedor o del modelo.
¿Dónde encaja Flatkey?
Flatkey proporciona a los equipos una clave de API y un catálogo de modelos para pruebas multi-ruta, además de visibilidad del uso para el nombre del modelo, los recuentos de tokens, el coste de la solicitud, la clave, el estado y la marca de tiempo. Eso hace que el flujo de trabajo de pruebas de prompts multimodelo sea más fácil de ejecutar y más fácil de explicar a finanzas u operaciones.
Conclusión final
El prompt ganador no es un prompt. Es una celda prompt/modelo que supera el contrato de la tarea bajo condiciones realistas de tráfico, presupuesto y latencia. Usa el flujo de trabajo de pruebas de prompts multimodelo anterior para convertir la selección de modelo de un debate en un rastro de evidencia: conjunto de datos, matriz, validadores, coste por tarea aceptada, barreras de regresión y un registro de decisión.
Cuando tu equipo esté listo para probar a través de una única superficie compatible con OpenAI, comienza con el inicio rápido de Flatkey, verifica las rutas disponibles con la lista de modelos e inspecciona el gasto en Registros de uso.