
NVIDIA B200 vs H200 : quel GPU est le meilleur pour l'inférence de LLM ?
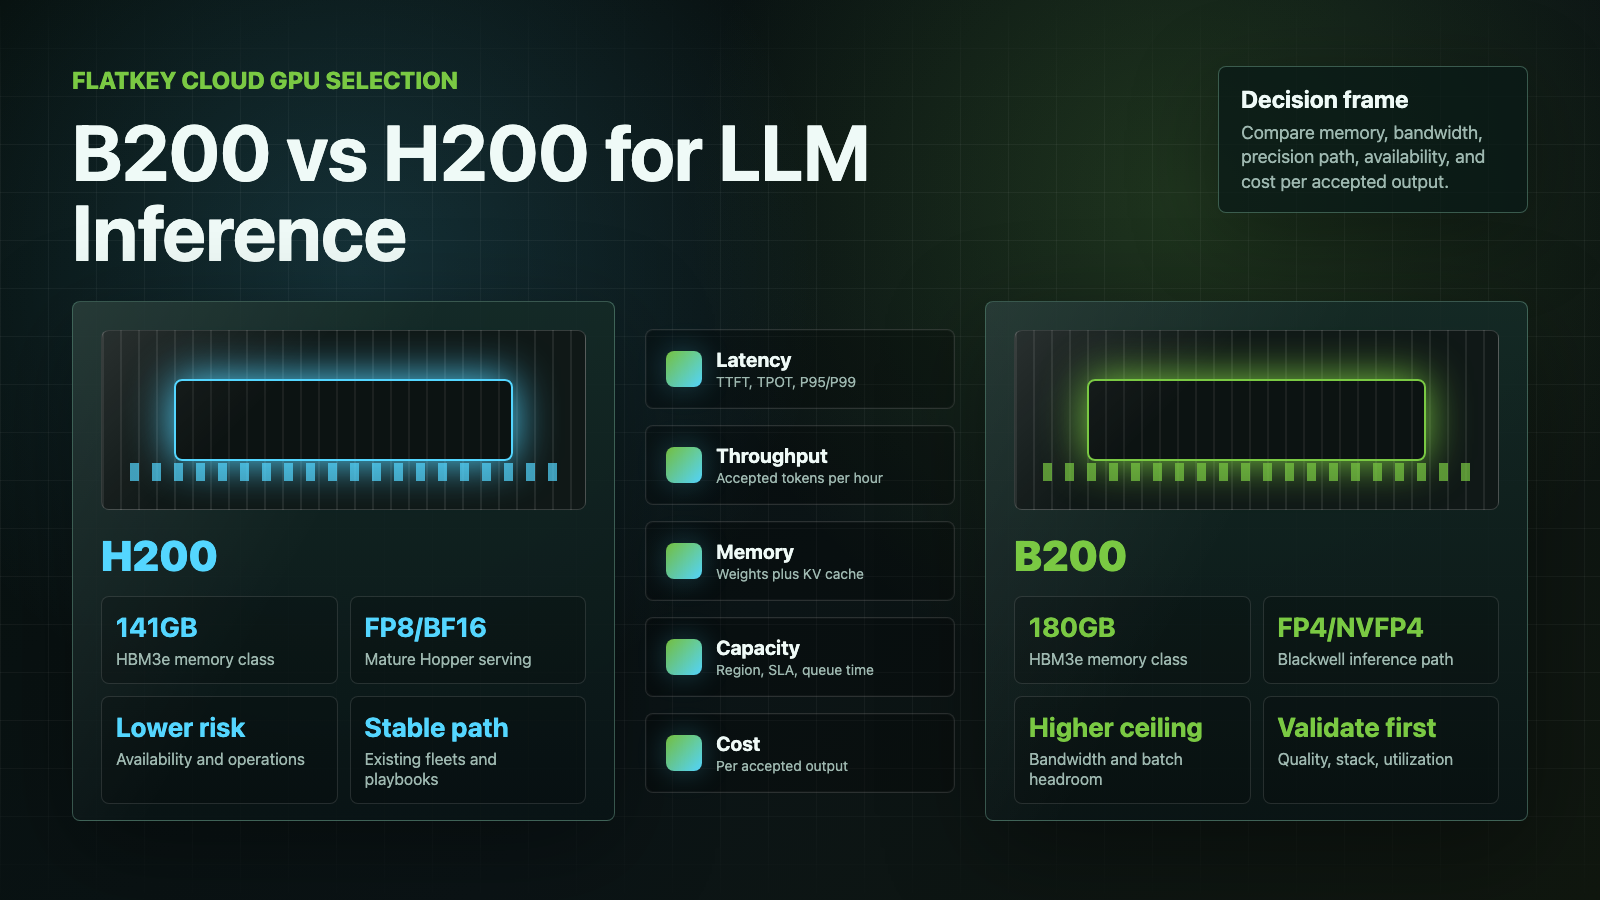
B200 vs H200 n'est pas une simple décision du type « le GPU le plus récent gagne ». Le NVIDIA B200 offre le plafond le plus élevé pour l'inférence de LLM lorsque votre pile peut utiliser les chemins basse précision de Blackwell, en particulier FP4/NVFP4, et lorsque la bande passante mémoire est le goulot d'étranglement. Le NVIDIA H200 est généralement le choix le moins risqué lorsque vous avez besoin de capacité disponible, d'un support de service Hopper mature, d'un comportement FP8/BF16 stable et d'une découverte des prix plus simple aujourd'hui.
Ce guide s'adresse aux équipes IA d'entreprise qui comparent la capacité GPU cloud pour l'inférence de LLM, pas aux collectionneurs de puces. La question pratique est la suivante : quel GPU offre la meilleure latence, le meilleur débit, la meilleure fiabilité et le meilleur coût par sortie acceptée pour votre modèle, votre longueur de contexte, votre profil de trafic et votre pile de service ?
Vérifié le 13 octobre 2026.
B200 vs H200 : la réponse rapide
Choisissez B200 lorsque votre charge de travail est limitée par le débit, par la bande passante mémoire, ou prête pour une précision réduite optimisée pour Blackwell. C'est la meilleure plateforme d'inférence tournée vers l'avenir pour les services à haut volume 70B+, les charges de travail à long contexte, et les équipes capables de tester sérieusement TensorRT-LLM, FP4/NVFP4 et le batching moderne avant d'engager de la capacité.
Choisissez H200 lorsque vous avez besoin de capacité plus rapidement, que vos charges de travail fonctionnent déjà bien sur Hopper, que votre pile est construite autour de FP8/BF16, ou que les achats nécessitent un marché du GPU cloud plus mature. Le H200 reste un excellent GPU d'inférence LLM car il associe la maturité logicielle de Hopper à 141 Go de mémoire HBM3e et à une bande passante mémoire élevée.
Le raccourci pour l'acheteur :
| Décision | Meilleur point de départ | Pourquoi |
|---|---|---|
| Nouveau cluster d'inférence LLM à haut débit | B200 | Plus de mémoire par GPU, bande passante mémoire plus élevée, chemin basse précision Blackwell, conceptions système plus récentes. |
| Extension d'un parc Hopper existant | H200 | Continuité opérationnelle plus simple à partir de H100/H200, moins de changements de pile, recettes de service matures. |
| Évaluation FP4 ou NVFP4 | B200 | Blackwell est conçu pour la nouvelle voie d'inférence basse précision. |
| Service de production FP8/BF16 | H200 d'abord, puis benchmark B200 | Le support Hopper est mature ; le B200 nécessite encore une validation spécifique à la charge de travail. |
| Capacité rare à la fenêtre de lancement | Le fournisseur capable de contractualiser une capacité fiable | Le temps de file d'attente et le SLA peuvent compter davantage que le pic théorique du GPU. |
| Approvisionnement au risque le plus faible | H200 | Mode d'achat cloud plus familier et références de prix plus nombreuses. |
| Meilleur plafond à long terme | B200 | Plus de marge si le logiciel, l'utilisation et la disponibilité s'alignent. |
Comparaison des spécifications pour l'inférence de LLM
Utilisez ce tableau comme premier filtre, puis exécutez votre propre benchmark. N'achetez pas un B200 ou un H200 uniquement sur la base de pics théoriques.
| Catégorie | NVIDIA H200 | NVIDIA B200 | Pourquoi cela compte pour l'inférence de LLM |
|---|---|---|---|
| Architecture | Hopper | Blackwell | Le B200 ajoute des fonctionnalités de service Blackwell et une accélération basse précision ; le H200 hérite de la maturité de Hopper. |
| Capacité mémoire | 141 Go HBM3e | 180 Go HBM3e dans les configurations SXM/DGX B200 courantes | Plus de mémoire aide pour les modèles plus grands, les fenêtres de contexte plus longues, un KV cache plus important et des tailles de batch plus élevées. |
| Bande passante mémoire | Jusqu'à 4,8 To/s | Jusqu'à environ 8 To/s dans les systèmes B200 de classe SXM | La génération de jetons et les charges de travail intensives en attention peuvent devenir limitées par la bande passante mémoire. |
| Précision réduite | FP8, BF16, FP16, TF32 et autres modes pris en charge | FP4/NVFP4, FP8, BF16, FP16, TF32 et autres modes pris en charge | L'avantage du B200 est le plus fort lorsque le modèle et la pile de service peuvent utiliser la précision réduite Blackwell sans perte de qualité. |
| Maturité logicielle | Écosystème Hopper très mature | Écosystème Blackwell en maturation rapide | Le H200 présente un risque d'adoption plus faible ; le B200 peut nécessiter davantage de benchmarks et de réglages. |
| État des achats | Schéma cloud H100/H200 plus large | Plus récent et souvent plus contraint en capacité | La disponibilité peut trancher la réponse avant les benchmarks. |
Sources principales à garder ouvertes pendant l'évaluation : NVIDIA H200, NVIDIA DGX B200, la fiche technique Tensor Core GPU de NVIDIA, et la vue d'ensemble des performances de TensorRT-LLM.
Pourquoi le B200 peut surpasser le H200 pour l'inférence de LLM
L'argument le plus solide en faveur du B200 vs H200 n'est pas seulement le calcul brut. C'est la combinaison de la capacité mémoire, de la bande passante mémoire, de conceptions d'interconnexion/système plus récentes et de l'inférence basse précision de Blackwell.
1. Plus de marge mémoire
Le H200 dispose déjà d'un avantage mémoire majeur par rapport aux déploiements H100 80 Go précédents. Le B200 pousse cette marge encore plus loin. C'est important car l'inférence LLM en production ne se limite pas aux poids du modèle. Il faut aussi de l'espace pour le KV cache, la surcharge d'exécution, le batching, les tampons du framework, l'état du speculative decoding et des marges de sécurité pour les prompts longs.
Pour les modèles de classe 70B, un H200 bien optimisé peut suffire. Pour des modèles plus grands, une concurrence plus élevée, des fenêtres de contexte plus longues ou des points de terminaison multi-tenant, la mémoire supplémentaire du B200 peut réduire la pression de sharding et rendre des tailles de batch plus élevées plus réalistes.
2. Bande passante mémoire plus élevée
De nombreux parcours d’inférence de LLM sont limités par les transferts mémoire, pas seulement par le pic de calcul tensoriel. Pendant la génération, chaque jeton peut nécessiter des mouvements répétés des poids et des données du cache KV. Une bande passante mémoire plus élevée peut améliorer le débit si le moteur de service, la quantification, les kernels d’attention et la politique de batching alimentent efficacement le GPU.
C’est pourquoi une comparaison de performances entre B200 et H200 doit enregistrer à la fois la latence et le débit. Un GPU qui obtient le meilleur nombre maximal de jetons par seconde peut ne pas atteindre votre objectif de latence P95, et un GPU qui semble coûteux à l’heure peut coûter moins cher par million de jetons acceptés si l’utilisation est élevée.
3. Chemins basse précision de Blackwell
Le B200 est particulièrement intéressant lorsque vous pouvez valider les modes de précision optimisés pour Blackwell. FP4/NVFP4 peuvent modifier de manière significative la courbe de coût pour certains workloads d’inférence, mais les économies ne sont pas automatiques. Vous devez tester la qualité, le comportement de refus, la précision des appels d’outils, la dérive des résumés, la sensibilité de la recherche et le comportement sur longs contextes avant de basculer un endpoint orienté client.
Si votre politique de production exige aujourd’hui du BF16 ou du FP8, le H200 peut être le premier déploiement le plus prévisible. Si vous construisez la prochaine plateforme d’inférence et pouvez investir dans l’étalonnage et le benchmarking spécifiques au modèle, le B200 mérite la première place dans la file de benchmark.
Pourquoi le H200 peut encore être le meilleur achat
Le H200 n’est pas un GPU ancien au sens où l’A100 est désormais souvent considéré pour l’inférence de LLM de pointe. C’est une puce Hopper à grande mémoire avec une pile logicielle mature, une large familiarité des opérateurs, et suffisamment de mémoire pour de nombreux workloads sérieux d’inférence de LLM.
1. La disponibilité peut l’emporter sur les performances de pointe
Le « meilleur GPU » est inutile si vous ne pouvez pas en obtenir un pendant une fenêtre de lancement. Dans l’approvisionnement de GPU cloud, le temps de file d’attente, les conditions de réservation, le temps de réponse du support, la région, le réseau et le risque d’annulation font partie des performances. Si un fournisseur peut livrer une capacité H200 fiable dès maintenant alors que la capacité B200 n’est disponible que sur devis ou est en rupture de stock, le H200 peut être la meilleure décision commerciale.
Pour les tarifs actuels, consultez les pages des fournisseurs telles que tarifs RunPod, tarifs Lambda GPU Cloud, tarifs Vast.ai et tarifs Massed Compute. Considérez ces pages comme des vérifications de source en direct, et non comme des grilles tarifaires permanentes.
2. Le service Hopper est opérationnellement familier
De nombreuses équipes savent déjà faire fonctionner vLLM, SGLang, TensorRT-LLM, TGI, Ray Serve, des opérateurs Kubernetes, la supervision et l’autoscaling autour de GPU de classe Hopper. Cela réduit le risque de migration. Si votre parc H100 ou H200 dispose déjà d’images validées, de kernels, de seuils d’alerte, d’objectifs d’utilisation et de guides d’intervention connus et fiables, étendre le H200 peut être préférable à une migration B200 précipitée.
3. Le H200 peut suffire pour l’inférence de production 70B
Pour les déploiements 7B, 8B, 14B, 32B et de nombreux 70B, le H200 dispose souvent de suffisamment de mémoire et de débit si le workload est optimisé. La vraie question n’est pas « Le H200 peut-il servir ce modèle ? » La vraie question est « Le H200 peut-il servir ce modèle à notre latence cible, notre longueur de contexte, notre taille de batch, notre objectif de disponibilité et notre coût par réponse acceptée ? »
Si la réponse est oui, le B200 doit justifier sa valeur par une meilleure économie délivrée, et pas seulement par de meilleures spécifications.
DGX B200 vs H200 : comparez le système, pas seulement le GPU
Le mot-clé « DGX B200 vs H200 » mélange généralement deux niveaux de comparaison :
- Comparaison de GPU : GPU B200 contre GPU H200.
- Comparaison de système : systèmes de type DGX B200 ou HGX B200 contre systèmes H200.
Pour les achats, le niveau système est plus important. Un serveur avec huit GPU B200 n’est pas simplement huit accélérateurs isolés. Il comprend la conception de l’hôte CPU, la mémoire, la topologie NVLink/NVSwitch, le réseau, le stockage, l’alimentation, le refroidissement, le support du fournisseur et l’intégration au cluster.
Lors de la comparaison de la capacité DGX B200 vs H200, demandez :
| Question sur le système | Pourquoi c’est important |
|---|---|
| Nombre de GPU et format | Les systèmes PCIe, SXM, HGX, DGX et NVL ont des performances et une maintenabilité différentes. |
| Topologie NVLink/NVSwitch | Le parallélisme tensoriel multi-GPU et le découpage du modèle dépendent de la qualité de l’interconnexion. |
| Réseau | L’inférence et l’entraînement multi-nœuds nécessitent une planification InfiniBand, RoCE ou un réseau équivalent. |
| Puissance et densité en rack | Les systèmes B200 peuvent modifier la conception des racks, le refroidissement et le calendrier de déploiement. |
| Chemin de stockage | Le temps de chargement du modèle et le déplacement des checkpoints influencent le temps de démarrage facturable. |
| Support et SLA de remplacement | Les temps d’arrêt font partie du coût par sortie acceptée. |
Si un fournisseur annonce une capacité « B200 », confirmez le système réel. Un nœud B200 PCIe, un nœud HGX B200 et un système DGX B200 ne sont pas des unités d’achat interchangeables.
Performances B200 vs H200 : que benchmarker
Aucun benchmark public ne peut, à lui seul, trancher votre décision B200 vs H200. Une comparaison utile des performances NVIDIA B200 vs H200 nécessite un benchmark reproductible utilisant votre modèle, votre tokenizer, votre distribution de contexte, votre schéma de trafic et votre seuil de qualité.
Utilisez trois modes de benchmark :
| Mode | Ce qu’il prouve | Erreur courante |
|---|---|---|
| Latence d’une seule requête | Temps jusqu’au premier token et réactivité par utilisateur | Optimiser une requête et supposer que cela prédit le débit en production. |
| Débit saturé | Nombre maximal de tokens de sortie par seconde sous charge | Ignorer la latence P95/P99 et le comportement de mise en file d’attente. |
| Relecture de production | Coût et latence avec de vraies longueurs de prompt et en concurrence réelle | Utiliser des prompts synthétiques plus courts que le trafic réel des utilisateurs. |
Suivez ces champs :
model_id:
weights_precision:
runtime: vLLM | SGLang | TensorRT-LLM | TGI | custom
gpu: H200 | B200
gpu_count:
context_input_p50:
context_input_p95:
output_tokens_p50:
output_tokens_p95:
target_ttft_ms:
target_tpot_ms:
concurrency:
batching_policy:
kv_cache_policy:
quality_eval_suite:
hourly_gpu_cost:
tokens_per_second:
accepted_answers_per_hour:
cost_per_1m_accepted_output_tokens:
La métrique clé est le coût par sortie acceptée, et non les tokens par seconde seuls. Si B200 est plus rapide mais coûte beaucoup plus cher par heure réservée fiable, H200 peut quand même l’emporter. Si B200 permet une taille de batch beaucoup plus grande, une précision plus faible avec une qualité acceptable, ou moins de GPU par point de terminaison, B200 peut gagner même avec un tarif horaire plus élevé.
Pour une feuille de calcul de coût plus large, associez ce benchmark avec les prix de location des GPU, la comparaison des prix des modèles d’IA et comment comparer les prix des modèles d’IA.
Recommandation charge de travail par charge de travail
| Charge de travail | Meilleur premier benchmark | Raison |
|---|---|---|
| Modèle 8B ou plus petit, API sensible à la latence | H200 | La charge de travail n’a peut-être pas besoin de la marge mémoire du B200 ; la maturité logicielle compte. |
| Service 70B FP8/BF16 | H200 et B200 | H200 peut suffire ; B200 peut l’emporter si la bande passante mémoire et le batching dominent. |
| Service 70B FP4 | B200 | La voie de précision favorise Blackwell, mais la validation de la qualité est obligatoire. |
| Service de modèle 405B ou très grand modèle | B200 | Davantage de mémoire et une bande passante système plus récente sont utiles, bien que la topologie multi-GPU domine. |
| Point de terminaison RAG à long contexte | B200 | La pression sur le cache KV et la bande passante peuvent rendre B200 attrayant. |
| Inférence hors ligne par lots | B200 si l’utilisation est élevée | Le plafond de débit compte si les tâches maintiennent le GPU saturé. |
| Inférence à destination de clients avec pics de trafic | H200 ou API du modèle en premier | Une capacité B200 inactive peut être coûteuse si le trafic est irrégulier. |
| Plateforme H100/H200 existante | Extension H200 en premier | La continuité opérationnelle peut l’emporter sur une migration vers une nouvelle pile. |
Liste de contrôle des prix et de la disponibilité
Ne comparez pas B200 et H200 uniquement sur le prix horaire. Comparez l’économie de la charge de travail terminée.
| Champ | Capture H200 | Capture B200 |
|---|---|---|
| Fournisseur | Cloud, marketplace, cluster dédié, système en colocation | Cloud, marketplace, cluster dédié, système en colocation |
| Mode de contrat | À la demande, réservé, engagé, cluster privé | À la demande, réservé, engagé, cluster privé |
| Système réel | H200 PCIe, H200 SXM, H200 NVL, DGX/HGX | B200 PCIe, B200 SXM, HGX, DGX B200, option GB200 |
| Région | Latence, règles de données, disponibilité | Latence, règles de données, disponibilité |
| Coût horaire ou mensuel | Inclure le stockage, le support, l’egress, le temps d’inactivité | Inclure le stockage, le support, l’egress, le temps d’inactivité |
| Utilisation | Temps réel d’activité GPU | Temps réel d’activité GPU |
| Coût des échecs et des réessais | OOM, éviction, mauvaise image, problème réseau | OOM, bugs de migration, échecs de réglage |
| Taux de sortie acceptée | Réponses, tokens, tâches ou requêtes qui passent le contrôle qualité | Réponses, tokens, tâches ou requêtes qui passent le contrôle qualité |
Pour l’approvisionnement, demandez aux fournisseurs de chiffrer la même unité de charge de travail :
Veuillez chiffrer la capacité pour :
- modèle et précision
- trafic cible
- distribution des tokens d’entrée/de sortie
- latence P95 cible
- région requise
- durée d’engagement
- support/SLA
- hypothèses de stockage et de réseau
- coût attendu par 1M de tokens de sortie acceptés
Cette dernière ligne est importante. Si le fournisseur ne peut pas aider à relier le coût GPU au coût de sortie, votre équipe assume tout le risque de modélisation.
Quand ni B200 ni H200 n’est la bonne réponse
Parfois, la bonne réponse n’est pas du tout un cluster GPU. Si l’utilisation est faible, la demande est irrégulière, le produit change fréquemment de modèle, ou si l’équipe ne veut pas exploiter d’infrastructure de service, une API de modèle peut être moins chère et plus rapide que la location de GPU.
Flatkey se situe du côté API de cette décision. Il donne aux équipes une seule clé, un seul solde, une seule facture et un registre d’utilisation sur plus de 300 modèles officiels et plus de 1 000 outils. Si votre feuille de calcul B200 vs H200 montre une faible utilisation ou des frais d’exploitation élevés, comparez une voie via API de modèle avant de signer un contrat de cluster. Pour la gouvernance, le budget et les contrôles de routage, voir tarification des passerelles d’IA, gestion des dépenses des API d’IA, et contrôles de quota des API d’IA.
Cela ne signifie pas que les API de modèles battent toujours les GPU. Cela signifie que la décision GPU doit être mesurée par rapport à une alternative API en utilisant la même métrique de sortie acceptée.
Recommandation finale
Pour la plupart des équipes IA d’entreprise, la réponse pratique à B200 vs H200 est :
- Commencez avec H200 si vous avez besoin rapidement d’une capacité fiable, si vous exploitez déjà Hopper, ou si vous servez des charges FP8/BF16 avec des outils matures.
- Commencez avec B200 si vous construisez une nouvelle plateforme d’inférence LLM à haut débit, pouvez valider la qualité FP4/NVFP4, et pouvez sécuriser suffisamment de capacité pour maintenir les GPU à un niveau d’utilisation élevé.
- N’engagez-vous pour aucun des deux GPU avant d’avoir benchmarké le coût par sortie acceptée sur vos invites réelles, longueurs de contexte et niveaux de concurrence.
Si B200 est disponible à un tarif engagé raisonnable et que votre pile logicielle peut exploiter Blackwell, c’est la meilleure plateforme d’inférence LLM à long terme. Si la disponibilité, le prix et le risque opérationnel dominent la décision d’achat, H200 reste un choix très crédible et souvent plus pratique.
Questions fréquemment posées
Le B200 est-il meilleur que le H200 pour l’inférence LLM ?
Le B200 est généralement meilleur pour les charges d’inférence LLM à très haut débit, fortement dépendantes de la bande passante mémoire, et optimisées pour Blackwell. Le H200 peut être meilleur lorsque la maturité logicielle Hopper, la capacité immédiate et un prix prévisible comptent davantage.
Quelle est la plus grande différence de performance entre NVIDIA B200 et H200 ?
La plus grande différence de performance entre NVIDIA B200 et H200 est la combinaison de la mémoire plus grande du B200, de sa bande passante mémoire plus élevée et de la prise en charge du faible précision Blackwell. L’écart réel dépend de la taille du modèle, de la précision, du moteur de service, du batching et de l’objectif de latence.
Dois-je choisir H200 ou B200 pour un modèle 70B ?
Pour H200 vs B200 sur un modèle 70B, benchmarkez les deux si vous le pouvez. Le H200 peut suffire pour un service en FP8/BF16 avec des outils matures. Le B200 est plus attractif pour une forte concurrence, des contextes longs ou un service en FP4/NVFP4 après validation de la qualité.
DGX B200 vs H200 change-t-il la réponse ?
Oui. DGX B200 vs H200 est une décision au niveau du système, pas seulement du GPU. Comparez le nombre de GPU, la topologie NVLink/NVSwitch, le réseau, la puissance du rack, le refroidissement, le stockage, le support et les conditions de capacité engagée.
Le B200 est-il toujours moins cher par token que le H200 ?
Non. Le B200 peut être moins cher par token lorsqu’il est fortement utilisé et que la pile de service exploite Blackwell efficacement. Le H200 peut être moins cher lorsque les tarifs horaires du B200, le temps d’attente en file, le travail de migration ou une sous-utilisation compensent le gain de performance.
Que devrais-je mesurer avant d’acheter de la capacité B200 ou H200 ?
Mesurez le temps jusqu’au premier token, les tokens par seconde de sortie, la latence P95/P99, les réponses acceptées par heure, l’utilisation du GPU, le taux d’échec, le coût de redémarrage, le stockage, l’egress, le support et le coût par 1 M de tokens de sortie acceptés.


