
NVIDIA B200 vs H200: LLM推論に最適なのはどちらのGPUか?
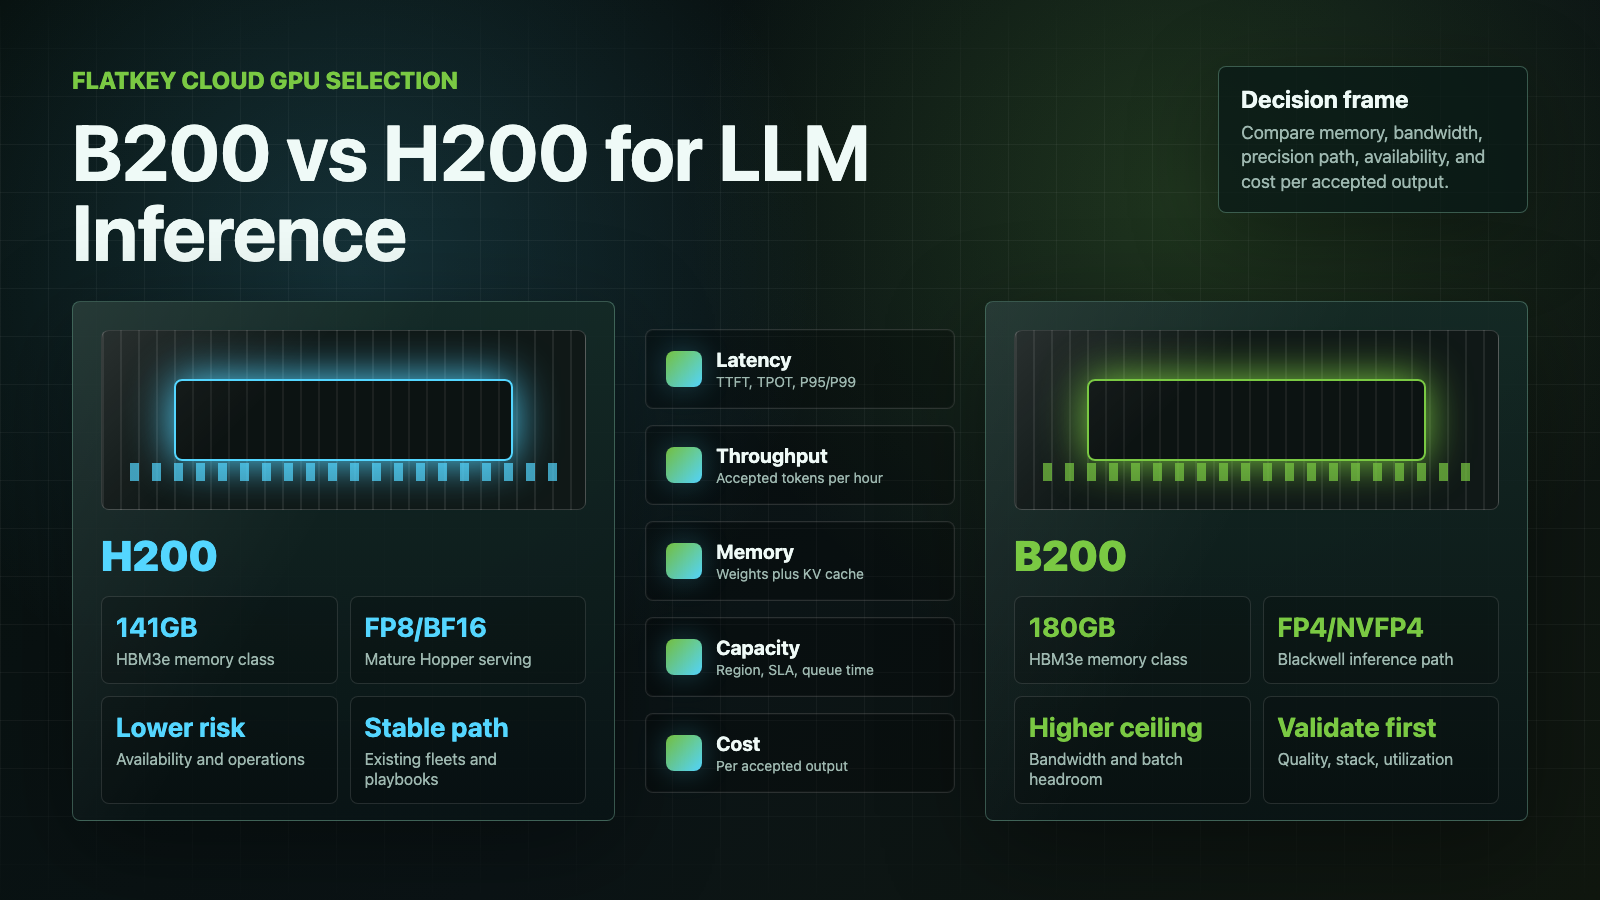
B200 vs H200 は、単純に「新しいGPUが勝つ」という判断ではありません。NVIDIA B200 は、スタックが Blackwell の低精度パス、特に FP4/NVFP4 を利用でき、かつボトルネックがメモリ帯域幅にある場合、LLM 推論でより高い上限を持ちます。NVIDIA H200 は通常、容量をすぐに確保する必要がある場合、成熟した Hopper のサービングサポート、安定した FP8/BF16 の挙動、そして今日より容易な価格把握が必要な場合に、よりリスクの低い選択です。
このガイドは、チップ収集家向けではなく、LLM 推論のためのクラウドGPU容量を比較するエンタープライズAIチーム向けです。実務上の問いは、あなたのモデル、コンテキスト長、トラフィック形状、そしてサービングスタックに対して、どのGPUが最良のレイテンシ、スループット、信頼性、そして受理済み出力あたりのコストをもたらすか、ということです。
2026年10月13日時点で確認。
B200 vs H200: ひとことで言うと
ワークロードがスループット制約、メモリ帯域幅制約、または Blackwell 最適化の低精度に対応可能なら、B200 を選びましょう。これは、70B超の高スループット推論、長文コンテキストのワークロード、そして容量を確保する前に TensorRT-LLM、FP4/NVFP4、最新のバッチ処理を本格的にベンチマークできるチームにとって、より将来性の高い推論プラットフォームです。
より早く容量が必要で、既存のワークロードがすでに Hopper で良好に動作し、スタックが FP8/BF16 を中心に構築されている、または調達により成熟したクラウドGPU市場が必要な場合は、H200 を選びましょう。H200 は、Hopper のソフトウェア成熟度に 141GB の HBM3e メモリと高いメモリ帯域幅を組み合わせているため、依然として強力な LLM 推論GPUです。
購入者向けのショートカット:
| 判断 | より良い出発点 | 理由 |
|---|---|---|
| 新しい高スループットLLM推論クラスタ | B200 | GPUあたりのメモリ増加、より高いメモリ帯域幅、Blackwell の低精度パス、新しいシステム設計。 |
| 既存の Hopper フリート拡張 | H200 | H100/H200 からの運用継続が容易、スタック変更が少ない、成熟したサービング手法。 |
| FP4 または NVFP4 の評価 | B200 | Blackwell は新しい低精度推論パス向けに設計されている。 |
| FP8/BF16 本番サービング | まず H200、その後 B200 をベンチマーク | Hopper のサポートは成熟している。B200 は依然としてワークロード固有の検証が必要。 |
| 発売初期の希少な容量 | 信頼できる容量を契約できるプロバイダ | 待ち時間とSLAは、理論上のGPUピーク性能より重要になることがある。 |
| 最も低い調達リスク | H200 | より馴染みのあるクラウド購入フローと価格参照。 |
| 長期的な最高到達点 | B200 | ソフトウェア、稼働率、可用性が揃えば、より大きな余地がある。 |
LLM推論向けの仕様比較
この表は最初のふるいとして使い、その後に自分のベンチマークを実施してください。理論上のピーク値だけで B200 や H200 を購入してはいけません。
| カテゴリ | NVIDIA H200 | NVIDIA B200 | LLM推論で重要な理由 |
|---|---|---|---|
| アーキテクチャ | Hopper | Blackwell | B200 は Blackwell のサービング機能と低精度高速化を追加する。H200 は Hopper の成熟度を継承する。 |
| メモリ容量 | 141GB HBM3e | 一般的な SXM/DGX B200 構成では 180GB HBM3e | より多いメモリは、より大きなモデル、より長いコンテキストウィンドウ、より大きな KV キャッシュ、より高いバッチサイズに役立つ。 |
| メモリ帯域幅 | 最大 4.8TB/s | B200 SXM クラスシステムで最大約 8TB/s | トークン生成や注意機構の重いワークロードは、メモリ帯域幅に制約されることがある。 |
| 低精度 | FP8、BF16、FP16、TF32、その他サポートされるモード | FP4/NVFP4、FP8、BF16、FP16、TF32、その他サポートされるモード | B200 の利点が最も大きいのは、モデルとサービングスタックが品質低下なしに Blackwell の低精度を利用できる場合。 |
| ソフトウェア成熟度 | 非常に成熟した Hopper エコシステム | 急速に成熟している Blackwell エコシステム | H200 は採用リスクが低い。B200 はより多くのベンチマークとチューニングが必要な場合がある。 |
| 調達状況 | より広範な H100/H200 のクラウド構成 | 新しく、しばしば容量制約が大きい | 可用性が、ベンチマークより先に答えを決めることがある。 |
評価中に開いておくべき主なソース: NVIDIA H200、NVIDIA DGX B200、NVIDIA の Tensor Core GPU データシート、そして TensorRT-LLM performance overview。
LLM推論でB200がH200を上回り得る理由
B200 vs H200 における最も強い論点は、単なる生の計算性能ではありません。メモリ容量、メモリ帯域幅、新しい相互接続/システム設計、そして Blackwell の低精度推論の組み合わせです。
1. より大きいメモリ余裕
H200 はすでに、以前の H100 80GB 展開に対して大きなメモリ上の優位性を持っています。B200 はその余裕をさらに押し広げます。なぜなら、本番の LLM 推論はモデル重みだけではないからです。KV キャッシュ、ランタイムのオーバーヘッド、バッチ処理、フレームワークのバッファ、投機的デコードの状態、そして長いプロンプトに対する安全マージンのためのスペースも必要です。
70B クラスのモデルであれば、十分にチューニングされた H200 で足りることがあります。より大きなモデル、より高い同時実行数、より長いコンテキストウィンドウ、あるいはマルチテナントのエンドポイントでは、B200 の追加メモリによってシャーディングの圧力を減らし、より高いバッチサイズを現実的にできます。
2. より高いメモリ帯域幅
多くのLLM推論パスは、テンソルのピーク性能だけでなく、メモリ移動によって制約されます。生成時には、各トークンごとに重みとKVキャッシュデータを繰り返し移動する必要がある場合があります。高いメモリ帯域幅は、サービングエンジン、量子化、アテンションカーネル、バッチング方針がGPUに効率よく供給できるなら、スループットを向上させます。
そのため、B200 vs H200の性能比較では、レイテンシとスループットの両方を記録すべきです。1秒あたりの最大トークン数で勝つGPUが、P95レイテンシの目標で勝つとは限りません。また、1時間あたりの価格が高く見えるGPUでも、利用率が高ければ、受理された100万トークンあたりのコストはより安くなる場合があります。
3. Blackwellの低精度パス
B200が最も魅力的なのは、Blackwell向けに最適化された精度モードを検証できる場合です。FP4/NVFP4は、推論ワークロードによってはコスト曲線を大きく変えられますが、その節約は自動的には得られません。顧客向けエンドポイントに切り替える前に、品質、拒否挙動、ツール呼び出しの精度、要約のドリフト、検索感度、長文コンテキストの挙動をテストする必要があります。
現在の本番ポリシーがBF16またはFP8を必要とするなら、H200のほうがより予測しやすい最初の導入先かもしれません。次世代の推論基盤を構築していて、モデル固有のキャリブレーションとベンチマークに投資できるなら、B200は最初にベンチマークを実施する候補に値します。
それでもH200のほうが良い購入になり得る理由
H200は、A100がフロンティアLLMのサービング用途でしばしば扱われるような、もはや古いGPUではありません。大容量メモリを備えたHopper世代の製品であり、成熟したソフトウェア経路、幅広いオペレータの習熟、そして多くの本格的なLLM推論ワークロードに十分なメモリを持っています。
1. 供給性がピーク性能を上回ることがある
発売のタイミングで確保できなければ、「最良のGPU」は無意味です。クラウドGPU調達では、待ち時間、予約条件、サポート対応、リージョン、ネットワーク、キャンセルリスクも性能の一部です。プロバイダーが今すぐ信頼できるH200容量を提供できる一方で、B200が見積もりのみ、またはバックオーダー状態であれば、H200のほうがより良いビジネス判断になる可能性があります。
現在の料金については、RunPod pricing、Lambda GPU Cloud pricing、Vast.ai pricing、Massed Compute pricingなどのプロバイダーページを確認してください。これらのページは恒久的な料金表ではなく、ライブのソースチェックとして扱ってください。
2. Hopperのサービングは運用上なじみがある
多くのチームはすでに、HopperクラスGPUを中心にvLLM、SGLang、TensorRT-LLM、TGI、Ray Serve、Kubernetesオペレータ、監視、自動スケーリングを運用する方法を知っています。そのため移行リスクが下がります。H100またはH200のファリートには、すでに検証済みのイメージ、カーネル、警告しきい値、利用率目標、障害対応手順があるなら、急いでB200へ移行するよりもH200の拡張のほうが優れている場合があります。
3. H200は70Bの本番推論に十分な場合がある
7B、8B、14B、32B、そして多くの70Bデプロイメントでは、ワークロードが適切に調整されていれば、H200には十分なメモリとスループットがあります。難しい問いは「H200でこのモデルを提供できるか?」ではありません。難しい問いは「H200で、目標レイテンシ、コンテキスト長、バッチサイズ、可用性目標、受理された回答1件あたりのコストを満たしてこのモデルを提供できるか?」です。
答えがイエスなら、B200は単に仕様が優れているだけでなく、提供される経済性で自らを正当化しなければなりません。
DGX B200 vs H200: GPUだけでなくシステムを比較する
キーワード「DGX B200 vs H200」は、通常2つの比較レベルを混在させます。
- GPU比較: B200 GPU 対 H200 GPU。
- システム比較: DGX B200またはHGX B200型システム 対 H200システム。
調達では、システムレベルのほうが重要です。8基のB200 GPUを搭載したサーバーは、単に8つの独立したアクセラレータではありません。CPUホスト設計、メモリ、NVLink/NVSwitchトポロジ、ネットワーク、ストレージ、電力、冷却、ベンダーサポート、クラスタ統合が含まれます。
DGX B200 vs H200の容量を比較する際は、次を確認してください。
| システムに関する質問 | 重要な理由 |
|---|---|
| GPU数とフォームファクタ | PCIe、SXM、HGX、DGX、NVLシステムでは性能と保守性が異なります。 |
| NVLink/NVSwitchトポロジ | マルチGPUのテンソル並列処理とモデル分割は相互接続品質に依存します。 |
| ネットワークファブリック | マルチノード推論と学習にはInfiniBand、RoCE、または同等のファブリック計画が必要です。 |
| 電力とラック密度 | B200システムは、ラック設計、冷却、導入タイムラインを変える可能性があります。 |
| ストレージ経路 | モデルの読み込み時間とチェックポイント移動は、課金対象の起動時間に影響します。 |
| サポートと交換SLA | ダウンタイムは、受理された出力1件あたりのコストの一部です。 |
プロバイダーが「B200」容量を提示する場合は、実際のシステムを確認してください。B200 PCIeノード、HGX B200ノード、DGX B200システムは、同じ購入単位ではありません。
B200 vs H200の性能: 何をベンチマークすべきか
公開ベンチマークだけで、あなたのB200 vs H200の判断を下すことはできません。NVIDIA B200 vs H200の有用な性能比較には、あなたのモデル、トークナイザー、コンテキスト分布、トラフィックパターン、品質しきい値を用いた再現可能なベンチマークが必要です。
次の3つのベンチマークモードを使用してください:
| モード | 何を証明するか | よくある誤り |
|---|---|---|
| 単一リクエストのレイテンシ | 最初のトークンまでの時間とユーザーごとの応答性 | 1件のリクエストを最適化して、それが本番のスループットを予測すると考えること。 |
| 飽和時スループット | 負荷時の1秒あたり最大出力トークン数 | P95/P99レイテンシやキューイング挙動を無視すること。 |
| 本番リプレイ | 実際のプロンプト長と同時実行数におけるコストとレイテンシ | 実際のユーザートラフィックより短い合成プロンプトを使うこと。 |
次の項目を記録してください:
model_id:
weights_precision:
runtime: vLLM | SGLang | TensorRT-LLM | TGI | custom
gpu: H200 | B200
gpu_count:
context_input_p50:
context_input_p95:
output_tokens_p50:
output_tokens_p95:
target_ttft_ms:
target_tpot_ms:
concurrency:
batching_policy:
kv_cache_policy:
quality_eval_suite:
hourly_gpu_cost:
tokens_per_second:
accepted_answers_per_hour:
cost_per_1m_accepted_output_tokens:重要な指標は承認済み出力あたりのコストであり、トークン/秒だけではありません。B200の方が速くても、信頼できる予約時間あたりのコストがかなり高ければ、H200が勝つことがあります。B200によって大きなバッチサイズ、許容可能な品質を伴う低精度、またはエンドポイントあたりのGPU台数削減が実現するなら、時間単価が高くてもB200が勝つことがあります。
より広いコスト計算表については、このベンチマークをGPUレンタル価格、AIモデル価格比較、およびAIモデル価格の比較方法と組み合わせてください。
ワークロード別の推奨
| ワークロード | まず試すべきベンチマーク | 理由 |
|---|---|---|
| 8Bまたは小規模モデル、レイテンシ重視のAPI | H200 | このワークロードではB200のメモリ余裕が不要かもしれず、ソフトウェアの成熟度が重要です。 |
| 70B FP8/BF16サービング | H200とB200 | H200で十分な場合があります。メモリ帯域幅とバッチ処理が支配的ならB200が勝つかもしれません。 |
| 70B FP4サービング | B200 | 精度経路はBlackwellに有利ですが、品質検証は必須です。 |
| 405Bまたは非常に大規模なモデルのサービング | B200 | より大きなメモリと新しいシステム帯域幅は有利ですが、マルチGPUトポロジーの影響が大きいです。 |
| 長文コンテキストRAGエンドポイント | B200 | KVキャッシュの圧迫と帯域幅によりB200が魅力的になる場合があります。 |
| バッチのオフライン推論 | 稼働率が高いならB200 | ジョブによってGPUが飽和するなら、スループット上限が重要です。 |
| 突発的な顧客向け推論 | H200またはまずモデルAPI | トラフィックがスパikyな場合、アイドル状態のB200容量は高コストになりえます。 |
| 既存のH100/H200プラットフォーム | まずH200拡張 | 新しいスタックへの移行より、運用継続性が勝ることがあります。 |
価格と可用性のチェックリスト
B200とH200を時間単価だけで比較してはいけません。完了したワークロードの経済性を比較してください。
| 項目 | H200の取得内容 | B200の取得内容 |
|---|---|---|
| 提供元 | クラウド、マーケットプレイス、専用クラスタ、コロケーションシステム | クラウド、マーケットプレイス、専用クラスタ、コロケーションシステム |
| 契約形態 | オンデマンド、予約、コミット、プライベートクラスタ | オンデマンド、予約、コミット、プライベートクラスタ |
| 実際のシステム | H200 PCIe、H200 SXM、H200 NVL、DGX/HGX | B200 PCIe、B200 SXM、HGX、DGX B200、GB200オプション |
| リージョン | レイテンシ、データ規制、可用性 | レイテンシ、データ規制、可用性 |
| 時間単価または月額 | ストレージ、サポート、転送料、アイドル時間を含める | ストレージ、サポート、転送料、アイドル時間を含める |
| 利用率 | 実際のGPU稼働時間 | 実際のGPU稼働時間 |
| 障害および再試行コスト | OOM、退避、不良イメージ、ネットワーク問題 | OOM、移行バグ、チューニング失敗 |
| 承認済み出力率 | QAを通過した回答、トークン、ジョブ、またはリクエスト | QAを通過した回答、トークン、ジョブ、またはリクエスト |
調達では、プロバイダーに同じワークロード単位で見積もりを依頼してください:
以下について容量見積もりをお願いします:
- モデルと精度
- 目標トラフィック
- 入出力トークン分布
- 目標P95レイテンシ
- 必要リージョン
- 契約期間
- サポート/SLA
- ストレージとネットワークの前提条件
- 承認済み出力トークン100万件あたりの予想コスト
最後の行が重要です。プロバイダーがGPUコストを出力コストに対応付ける支援をできない場合、そのモデリングリスクはすべてあなたのチームが負うことになります。
B200でもH200でもないのが正解な場合
ときには、正解はGPUクラスタではありません。利用率が低い、需要が断続的、製品が頻繁にモデルを変更する、またはチームがサービングインフラを運用したくない場合、モデルAPIのほうがGPUを借りるよりも安く、速くなることがあります。
Flatkey は、その判断における API 側に位置します。1つのキー、1つの残高、1つの請求書、そして 300 以上の公式モデルと 1,000 以上のツールにまたがる使用台帳をチームに提供します。B200 vs H200 の検討シートで利用率の低さや運用オーバーヘッドの高さが示されているなら、クラスター契約に署名する前にモデル API 経路を比較してください。ガバナンス、予算、ルーティング制御については、AI gateway pricing、AI API spend management、AI API quota controls を参照してください。
これは、モデル API が常に GPU に勝つという意味ではありません。同じ承認済み出力メトリクスを使って、GPU の判断を API の代替案と比較して測定すべきだという意味です。
最終的な推奨
ほとんどのエンタープライズ AI チームにとって、B200 vs H200 の実務的な答えは次のとおりです。
- 信頼できるキャパシティを迅速に必要とし、すでに Hopper を運用しているか、成熟したツール群で FP8/BF16 ワークロードを提供しているなら、H200 から始める。
- 新しい高スループットの LLM 推論プラットフォームを構築しており、FP4/NVFP4 の品質を検証でき、GPU を高い利用率に保てるだけの十分なキャパシティを確保できるなら、B200 から始める。
- 実際のプロンプト、コンテキスト長、同時実行数に基づく承認済み出力あたりのコストをベンチマークするまでは、どちらの GPU にもコミットしない。
B200 が妥当な確約レートで利用でき、ソフトウェアスタックが Blackwell を活用できるなら、長期的にはより強力な LLM 推論プラットフォームです。可用性、価格、運用リスクが購入判断の主因であるなら、H200 は依然として非常に有力で、しばしばより実用的な選択肢です。
よくある質問
LLM 推論では B200 は H200 より優れていますか?
B200 は通常、最高スループットでメモリ帯域を多く消費し、Blackwell に最適化された LLM 推論ワークロードにより適しています。H200 は、Hopper のソフトウェア成熟度、即時のキャパシティ、予測しやすい価格のほうが重要な場合に優位となることがあります。
NVIDIA B200 vs H200 の性能差で最も大きい違いは何ですか?
NVIDIA B200 vs H200 の性能差で最も大きいのは、B200 のより大きなメモリ、より高いメモリ帯域幅、そして Blackwell の低精度サポートの組み合わせです。実際の差は、モデルサイズ、精度、サービングエンジン、バッチ処理、レイテンシ目標によって変わります。
70B モデルでは H200 と B200 のどちらを選ぶべきですか?
70B モデルの H200 vs B200 については、可能であれば両方をベンチマークしてください。H200 は、成熟したツール群による FP8/BF16 サービングには十分な場合があります。B200 は、品質検証後の高同時実行、長いコンテキスト、FP4/NVFP4 サービングにより魅力的です。
DGX B200 vs H200 で答えは変わりますか?
はい。DGX B200 vs H200 は、GPU の判断だけでなくシステムレベルの判断です。GPU 数、NVLink/NVSwitch のトポロジ、ネットワーク、ラック電力、冷却、ストレージ、サポート、確約キャパシティ条件を比較してください。
B200 は常に H200 よりトークンあたりのコストが安いですか?
いいえ。B200 は、高い利用率で運用され、サービングスタックが Blackwell を効率的に使う場合に、トークンあたりのコストが安くなることがあります。H200 は、B200 の時間単価、待ち時間、移行作業、または低利用率が性能向上を相殺する場合に、より安くなることがあります。
B200 または H200 のキャパシティを購入する前に何を測定すべきですか?
最初のトークンまでの時間、1 秒あたりの出力トークン数、P95/P99 レイテンシ、1 時間あたりの承認済み回答数、GPU 利用率、障害率、再起動コスト、ストレージ、egress、サポート、そして 100 万承認済み出力トークンあたりのコストを測定してください。


