
NVIDIA B200 vs H200: GPU Mana yang Lebih Baik untuk Inference LLM?
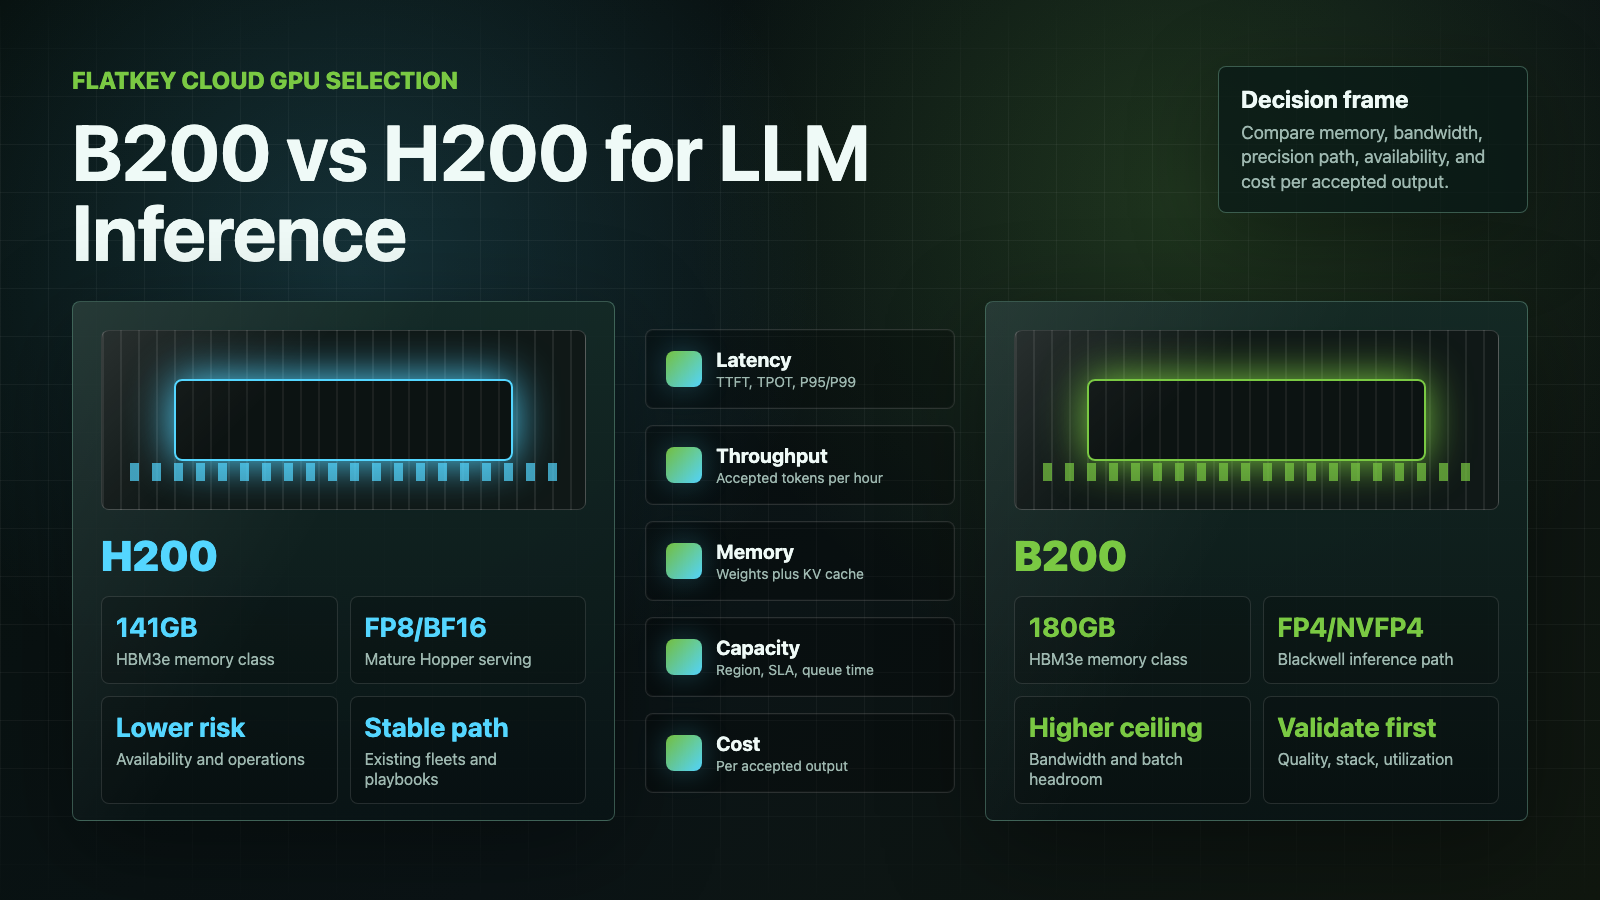
B200 vs H200 bukan keputusan sederhana "GPU yang lebih baru pasti menang". NVIDIA B200 memiliki batas atas yang lebih tinggi untuk inference LLM ketika stack Anda dapat memanfaatkan jalur low-precision Blackwell, terutama FP4/NVFP4, dan ketika bandwidth memori menjadi bottleneck. NVIDIA H200 biasanya menjadi pilihan yang lebih rendah risikonya ketika Anda membutuhkan kapasitas yang tersedia, dukungan serving Hopper yang matang, perilaku FP8/BF16 yang stabil, dan discovery harga yang lebih mudah saat ini.
Panduan ini ditujukan untuk tim AI enterprise yang membandingkan kapasitas GPU cloud untuk inference LLM, bukan untuk kolektor chip. Pertanyaan praktisnya adalah: GPU mana yang memberikan latency, throughput, reliabilitas, dan biaya per output yang diterima terbaik untuk model, panjang konteks, bentuk traffic, dan serving stack Anda?
Diperiksa pada 13 Oktober 2026.
B200 vs H200: jawaban singkat
Pilih B200 ketika workload Anda dibatasi throughput, dibatasi bandwidth memori, atau siap untuk low precision yang dioptimalkan Blackwell. Ini adalah platform inference yang lebih baik untuk jangka panjang bagi serving volume tinggi 70B+, workload konteks panjang, dan tim yang dapat melakukan benchmark TensorRT-LLM, FP4/NVFP4, dan batching modern dengan serius sebelum mengontrak kapasitas.
Pilih H200 ketika Anda membutuhkan kapasitas lebih cepat, workload Anda sudah berjalan baik di Hopper, stack Anda dibangun di sekitar FP8/BF16, atau pengadaan memerlukan pasar GPU cloud yang lebih matang. H200 masih merupakan GPU inference LLM yang kuat karena menggabungkan kematangan software Hopper dengan memori HBM3e 141GB dan bandwidth memori yang tinggi.
Shortcut untuk pembeli:
| Keputusan | Titik awal yang lebih baik | Mengapa |
|---|---|---|
| Cluster inference LLM throughput tinggi baru | B200 | Memori per GPU lebih besar, bandwidth memori lebih tinggi, jalur low precision Blackwell, desain sistem yang lebih baru. |
| Ekspansi armada Hopper yang sudah ada | H200 | Kontinuitas operasional lebih mudah dari H100/H200, lebih sedikit perubahan stack, resep serving yang matang. |
| Evaluasi FP4 atau NVFP4 | B200 | Blackwell dibangun untuk jalur inference low precision yang lebih baru. |
| Serving produksi FP8/BF16 | H200 dulu, lalu benchmark B200 | Dukungan Hopper sudah matang; B200 masih memerlukan validasi spesifik workload. |
| Kapasitas window peluncuran yang langka | Mana pun penyedia yang dapat mengontrak kapasitas yang andal | Waktu antre dan SLA bisa lebih penting daripada puncak GPU teoritis. |
| Pengadaan dengan risiko terendah | H200 | Gerakan pembelian cloud dan referensi harga yang lebih familiar. |
| Batas atas jangka panjang terbaik | B200 | Lebih banyak ruang jika software, utilisasi, dan ketersediaan selaras. |
Perbandingan spesifikasi untuk inference LLM
Gunakan tabel ini sebagai penyaring pertama, lalu jalankan benchmark Anda sendiri. Jangan membeli B200 atau H200 hanya berdasarkan angka puncak teoritis.
| Kategori | NVIDIA H200 | NVIDIA B200 | Mengapa ini penting untuk inference LLM |
|---|---|---|---|
| Arsitektur | Hopper | Blackwell | B200 menambahkan fitur serving Blackwell dan akselerasi low precision; H200 mewarisi kematangan Hopper. |
| Kapasitas memori | 141GB HBM3e | 180GB HBM3e pada konfigurasi SXM/DGX B200 yang umum | Memori yang lebih besar membantu model yang lebih besar, jendela konteks yang lebih panjang, KV cache yang lebih besar, dan batch size yang lebih tinggi. |
| Bandwidth memori | Hingga 4,8TB/s | Hingga sekitar 8TB/s pada sistem kelas B200 SXM | Generasi token dan workload yang berat pada attention dapat menjadi dibatasi bandwidth memori. |
| Low precision | FP8, BF16, FP16, TF32 dan mode lain yang didukung | FP4/NVFP4, FP8, BF16, FP16, TF32 dan mode lain yang didukung | Keunggulan B200 paling kuat saat model dan serving stack dapat menggunakan low precision Blackwell tanpa kehilangan kualitas. |
| Kematangan software | Ekosistem Hopper yang sangat matang | Ekosistem Blackwell yang berkembang pesat | H200 memiliki risiko adopsi yang lebih rendah; B200 mungkin memerlukan lebih banyak benchmarking dan tuning. |
| Status pengadaan | Pola cloud H100/H200 yang lebih luas | Lebih baru dan sering kali lebih terbatas kapasitasnya | Ketersediaan bisa menentukan jawabannya sebelum benchmark dilakukan. |
Sumber utama yang perlu dibuka saat mengevaluasi: NVIDIA H200, NVIDIA DGX B200, datasheet Tensor Core GPU dari NVIDIA, dan gambaran performa TensorRT-LLM.
Mengapa B200 bisa mengungguli H200 untuk inference LLM
Argumen terkuat untuk B200 vs H200 bukan hanya komputasi mentah. Ini adalah kombinasi dari kapasitas memori, bandwidth memori, desain interconnect/sistem yang lebih baru, dan inference low precision Blackwell.
1. Ruang memori yang lebih besar
H200 sudah memiliki keunggulan memori yang besar dibanding deployment H100 80GB sebelumnya. B200 mendorong ruang itu lebih jauh. Itu penting karena inference LLM produksi bukan hanya bobot model. Anda juga memerlukan ruang untuk KV cache, overhead runtime, batching, buffer framework, state speculative decoding, dan margin keamanan untuk prompt yang panjang.
Untuk model kelas 70B, H200 yang dituning dengan baik bisa cukup. Untuk model yang lebih besar, concurrency yang lebih berat, jendela konteks yang lebih panjang, atau endpoint multi-tenant, memori tambahan B200 dapat mengurangi tekanan sharding dan membuat batch size yang lebih tinggi lebih realistis.
2. Bandwidth memori lebih tinggi
Banyak jalur inference LLM dibatasi oleh pergerakan memori, bukan hanya puncak tensor. Selama pembuatan token, setiap token mungkin memerlukan pemindahan bobot dan data KV-cache yang berulang. Bandwidth memori yang lebih tinggi dapat meningkatkan throughput jika mesin serving, kuantisasi, kernel attention, dan kebijakan batching dapat memberi data ke GPU secara efisien.
Itulah sebabnya perbandingan performa B200 vs H200 harus mencatat latensi dan throughput sekaligus. GPU yang menang dalam token per detik maksimum belum tentu menang pada target latensi P95 Anda, dan GPU yang terlihat mahal per jam bisa lebih murah per juta token yang diterima jika utilisasinya tinggi.
3. Jalur presisi rendah Blackwell
B200 paling menarik ketika Anda dapat memvalidasi mode presisi yang dioptimalkan untuk Blackwell. FP4/NVFP4 dapat mengubah kurva biaya secara material untuk beberapa workload inference, tetapi penghematan tersebut tidak otomatis. Anda perlu menguji kualitas, perilaku penolakan, akurasi tool-call, drift ringkasan, sensitivitas retrieval, dan perilaku konteks panjang sebelum beralih ke endpoint yang menghadap pelanggan.
Jika kebijakan produksi Anda saat ini memerlukan BF16 atau FP8, H200 mungkin menjadi deployment awal yang lebih dapat diprediksi. Jika Anda sedang membangun platform inference berikutnya dan dapat berinvestasi dalam kalibrasi serta benchmarking khusus model, B200 layak mendapat slot benchmark pertama.
Mengapa H200 masih bisa menjadi pembelian yang lebih baik
H200 bukan GPU lawas seperti halnya A100 yang kini sering diperlakukan untuk serving LLM frontier. Ini adalah part Hopper berkapasitas memori besar dengan jalur software yang matang, familiaritas operator yang luas, dan memori yang cukup untuk banyak workload inference LLM yang serius.
1. Ketersediaan bisa mengalahkan performa puncak
"GPU terbaik" tidak berguna jika Anda tidak bisa mendapatkannya selama jendela peluncuran. Dalam pengadaan GPU cloud, waktu antrean, ketentuan reservasi, respons dukungan, region, networking, dan risiko pembatalan adalah bagian dari performa. Jika penyedia dapat memberikan kapasitas H200 yang andal sekarang sementara kapasitas B200 hanya berdasarkan penawaran harga atau masih backorder, H200 bisa menjadi keputusan bisnis yang lebih baik.
Untuk tarif terkini, periksa halaman penyedia seperti harga RunPod, harga Lambda GPU Cloud, harga Vast.ai, dan harga Massed Compute. Perlakukan halaman-halaman tersebut sebagai pengecekan sumber langsung, bukan kartu tarif permanen.
2. Serving Hopper sudah familiar secara operasional
Banyak tim sudah tahu cara menjalankan vLLM, SGLang, TensorRT-LLM, TGI, Ray Serve, operator Kubernetes, monitoring, dan autoscaling di sekitar GPU kelas Hopper. Itu mengurangi risiko migrasi. Jika fleet H100 atau H200 Anda sudah memiliki image yang terbukti baik, kernel, ambang alert, target utilisasi, dan playbook insiden yang sudah diketahui, memperluas H200 bisa lebih baik daripada migrasi B200 yang terburu-buru.
3. H200 bisa cukup untuk inference produksi 70B
Untuk deployment 7B, 8B, 14B, 32B, dan banyak 70B, H200 sering kali memiliki memori dan throughput yang cukup jika workload-nya dituning. Pertanyaan sulitnya bukan "Bisakah H200 menjalankan model ini?" Pertanyaan sulitnya adalah "Bisakah H200 menjalankan model ini pada latensi target, panjang konteks, ukuran batch, target ketersediaan, dan biaya per jawaban yang diterima?"
Jika jawabannya ya, B200 harus membuktikan dirinya melalui ekonomi yang lebih baik dalam hasil nyata, bukan hanya spesifikasi yang lebih baik.
DGX B200 vs H200: bandingkan sistemnya, bukan hanya GPU-nya
Kata kunci "DGX B200 vs H200" biasanya mencampur dua level perbandingan:
- Perbandingan GPU: GPU B200 versus GPU H200.
- Perbandingan sistem: sistem bergaya DGX B200 atau HGX B200 versus sistem H200.
Untuk pengadaan, level sistem lebih penting. Server dengan delapan GPU B200 bukan sekadar delapan akselerator yang terisolasi. Server tersebut mencakup desain host CPU, memori, topologi NVLink/NVSwitch, networking, storage, daya, pendinginan, dukungan vendor, dan integrasi cluster.
Saat membandingkan kapasitas DGX B200 vs H200, mintalah:
| Pertanyaan sistem | Mengapa ini penting |
|---|---|
| Jumlah GPU dan faktor bentuk | Sistem PCIe, SXM, HGX, DGX, dan NVL memiliki performa dan kemudahan servis yang berbeda. |
| Topologi NVLink/NVSwitch | Tensor parallelism multi-GPU dan pembagian model bergantung pada kualitas interkoneksi. |
| Fabric jaringan | Inference dan training multi-node memerlukan InfiniBand, RoCE, atau perencanaan fabric setara. |
| Daya dan kepadatan rak | Sistem B200 dapat mengubah desain rak, pendinginan, dan timeline deployment. |
| Jalur storage | Waktu load model dan perpindahan checkpoint memengaruhi waktu startup yang ditagihkan. |
| Dukungan dan SLA penggantian | Downtime adalah bagian dari biaya per output yang diterima. |
Jika penyedia mengutip kapasitas "B200", pastikan sistem yang sebenarnya. Node B200 PCIe, node HGX B200, dan sistem DGX B200 bukan unit pembelian yang dapat dipertukarkan.
Performa B200 vs H200: apa yang harus dibenchmark
Tidak ada benchmark publik yang dapat menjawab keputusan B200 vs H200 Anda sendirian. Perbandingan performa NVIDIA B200 vs H200 yang berguna membutuhkan benchmark yang dapat direproduksi menggunakan model, tokenizer, distribusi konteks, pola traffic, dan ambang kualitas Anda.
Gunakan tiga mode benchmark:
| Mode | Apa yang dibuktikannya | Kesalahan umum |
|---|---|---|
| Latensi single-request | Waktu ke token pertama dan responsivitas per pengguna | Mengoptimalkan satu permintaan dan menganggapnya dapat memprediksi throughput produksi. |
| Throughput jenuh | Jumlah token output maksimum per detik saat beban tinggi | Mengabaikan latensi P95/P99 dan perilaku antrean. |
| Replay produksi | Biaya dan latensi pada panjang prompt dan konkurensi yang nyata | Menggunakan prompt sintetis yang lebih pendek daripada trafik pengguna nyata. |
Lacak field berikut:
model_id:
weights_precision:
runtime: vLLM | SGLang | TensorRT-LLM | TGI | custom
gpu: H200 | B200
gpu_count:
context_input_p50:
context_input_p95:
output_tokens_p50:
output_tokens_p95:
target_ttft_ms:
target_tpot_ms:
concurrency:
batching_policy:
kv_cache_policy:
quality_eval_suite:
hourly_gpu_cost:
tokens_per_second:
accepted_answers_per_hour:
cost_per_1m_accepted_output_tokens:
Metrik kuncinya adalah biaya per output yang diterima, bukan token per detik saja. Jika B200 lebih cepat tetapi biayanya jauh lebih mahal per jam terjamin yang andal, H200 tetap bisa menang. Jika B200 memungkinkan ukuran batch yang jauh lebih besar, presisi lebih rendah dengan kualitas yang dapat diterima, atau lebih sedikit GPU per endpoint, B200 bisa menang bahkan dengan tarif per jam yang lebih tinggi.
Untuk lembar kerja biaya yang lebih luas, pasangkan benchmark ini dengan harga sewa GPU, perbandingan harga model AI, dan cara membandingkan harga model AI.
Rekomendasi per workload
| Workload | Benchmark pertama yang lebih baik | Alasan |
|---|---|---|
| Model 8B atau model kecil, API sensitif latensi | H200 | Workload ini mungkin tidak membutuhkan ruang memori ekstra B200; kematangan software penting. |
| Serving 70B FP8/BF16 | H200 dan B200 | H200 mungkin sudah cukup; B200 dapat menang jika bandwidth memori dan batching mendominasi. |
| Serving 70B FP4 | B200 | Jalur presisi menguntungkan Blackwell, tetapi validasi kualitas wajib dilakukan. |
| Serving model 405B atau model yang sangat besar | B200 | Memori yang lebih besar dan bandwidth sistem yang lebih baru sangat bernilai, meskipun topologi multi-GPU lebih dominan. |
| Endpoint RAG konteks panjang | B200 | Tekanan KV-cache dan bandwidth dapat membuat B200 menarik. |
| Inferensi batch offline | B200 jika utilisasi tinggi | Batas throughput penting jika job membuat GPU terus jenuh. |
| Inferensi yang meledak-ledak untuk customer-facing | H200 atau model API terlebih dahulu | Kapasitas B200 yang menganggur bisa mahal jika trafiknya sporadis. |
| Platform H100/H200 yang sudah ada | Ekspansi H200 terlebih dahulu | Keberlanjutan operasional bisa lebih baik daripada migrasi ke stack baru. |
Daftar periksa harga dan ketersediaan
Jangan membandingkan B200 vs H200 hanya dari harga per jam. Bandingkan ekonomi workload yang selesai.
| Field | H200 capture | B200 capture |
|---|---|---|
| Provider | Cloud, marketplace, dedicated cluster, sistem colocated | Cloud, marketplace, dedicated cluster, sistem colocated |
| Mode kontrak | On-demand, reserved, committed, private cluster | On-demand, reserved, committed, private cluster |
| Sistem aktual | H200 PCIe, H200 SXM, H200 NVL, DGX/HGX | B200 PCIe, B200 SXM, HGX, DGX B200, opsi GB200 |
| Region | Latensi, aturan data, ketersediaan | Latensi, aturan data, ketersediaan |
| Biaya per jam atau per bulan | Termasuk storage, dukungan, egress, waktu idle | Termasuk storage, dukungan, egress, waktu idle |
| Utilisasi | Waktu GPU aktif yang nyata | Waktu GPU aktif yang nyata |
| Biaya kegagalan dan retry | OOM, eviction, image buruk, masalah jaringan | OOM, bug migrasi, kegagalan tuning |
| Tingkat output yang diterima | Jawaban, token, job, atau permintaan yang lolos QA | Jawaban, token, job, atau permintaan yang lolos QA |
Untuk pengadaan, mintalah provider mengutip unit workload yang sama:
Please quote capacity for:
- model and precision
- target traffic
- input/output token distribution
- target P95 latency
- required region
- committed term
- support/SLA
- storage and network assumptions
- expected cost per 1M accepted output tokens
Baris terakhir itu penting. Jika provider tidak dapat membantu memetakan biaya GPU ke biaya output, tim Anda menanggung seluruh risiko pemodelan.
Saat B200 maupun H200 bukan jawaban yang tepat
Terkadang jawaban yang tepat bukan cluster GPU sama sekali. Jika utilisasi rendah, permintaan sporadis, produk sering berganti model, atau tim tidak ingin mengoperasikan infrastruktur serving, API model bisa lebih murah dan lebih cepat daripada menyewa GPU.
Flatkey berada di sisi API dari keputusan tersebut. Platform ini memberi tim satu key, satu saldo, satu invoice, dan ledger penggunaan di seluruh 300+ model resmi dan 1.000+ tools. Jika worksheet B200 vs H200 Anda menunjukkan utilisasi rendah atau overhead operasional tinggi, bandingkan jalur API model sebelum menandatangani kontrak cluster. Untuk kontrol governance, anggaran, dan routing, lihat harga AI gateway, manajemen pengeluaran AI API, dan kontrol kuota AI API.
Ini tidak berarti API model selalu mengalahkan GPU. Artinya, keputusan GPU harus diukur terhadap alternatif API menggunakan metrik output yang diterima yang sama.
Rekomendasi akhir
Untuk sebagian besar tim AI enterprise, jawaban praktis B200 vs H200 adalah:
- Mulailah dengan H200 jika Anda membutuhkan kapasitas andal dengan cepat, sudah menjalankan Hopper, atau melayani workload FP8/BF16 dengan tooling yang matang.
- Mulailah dengan B200 jika Anda membangun platform inference LLM throughput tinggi yang baru, dapat memvalidasi kualitas FP4/NVFP4, dan dapat mengamankan kapasitas yang cukup untuk menjaga GPU tetap terutilisasi tinggi.
- Jangan berkomitmen pada salah satu GPU sampai Anda membenchmark biaya per output yang diterima pada prompt, panjang konteks, dan concurrency aktual Anda.
Jika B200 tersedia dengan committed rate yang wajar dan stack software Anda dapat memanfaatkan Blackwell, itu adalah platform inference LLM jangka panjang yang lebih kuat. Jika ketersediaan, harga, dan risiko operasional lebih dominan dalam keputusan pembelian, H200 tetap merupakan pilihan yang sangat kredibel dan sering kali lebih praktis.
Pertanyaan yang Sering Diajukan
Apakah B200 lebih baik daripada H200 untuk inference LLM?
B200 biasanya lebih baik untuk workload inference LLM berthroughput tertinggi, berat pada bandwidth memori, dan dioptimalkan untuk Blackwell. H200 bisa lebih baik ketika kematangan software Hopper, kapasitas yang tersedia segera, dan harga yang dapat diprediksi lebih penting.
Apa perbedaan terbesar dalam performa NVIDIA B200 vs H200?
Perbedaan terbesar dalam performa NVIDIA B200 vs H200 adalah kombinasi memori B200 yang lebih besar, bandwidth memori yang lebih tinggi, dan dukungan low-precision Blackwell. Kesenjangan yang terealisasi bergantung pada ukuran model, presisi, serving engine, batching, dan target latensi.
Haruskah saya memilih H200 vs B200 untuk model 70B?
Untuk H200 vs B200 pada model 70B, benchmark keduanya jika memungkinkan. H200 mungkin sudah cukup untuk serving FP8/BF16 dengan tooling yang matang. B200 lebih menarik untuk concurrency tinggi, context panjang, atau serving FP4/NVFP4 setelah validasi kualitas.
Apakah DGX B200 vs H200 mengubah jawabannya?
Ya. DGX B200 vs H200 adalah keputusan di tingkat sistem, bukan hanya keputusan GPU. Bandingkan jumlah GPU, topologi NVLink/NVSwitch, networking, daya rack, pendinginan, storage, dukungan, dan ketentuan committed capacity.
Apakah B200 selalu lebih murah per token daripada H200?
Tidak. B200 bisa lebih murah per token ketika utilisasinya tinggi dan stack serving menggunakan Blackwell secara efisien. H200 bisa lebih murah ketika tarif per jam B200, waktu antre, pekerjaan migrasi, atau utilisasi rendah mengimbangi keuntungan performanya.
Apa yang harus saya ukur sebelum membeli kapasitas B200 atau H200?
Ukur time to first token, tokens per output second, latensi P95/P99, accepted answers per hour, utilisasi GPU, failure rate, biaya restart, storage, egress, dukungan, dan biaya per 1 juta token output yang diterima.


