
NVIDIA B200 vs H200: ¿Qué GPU es mejor para la inferencia de LLM?
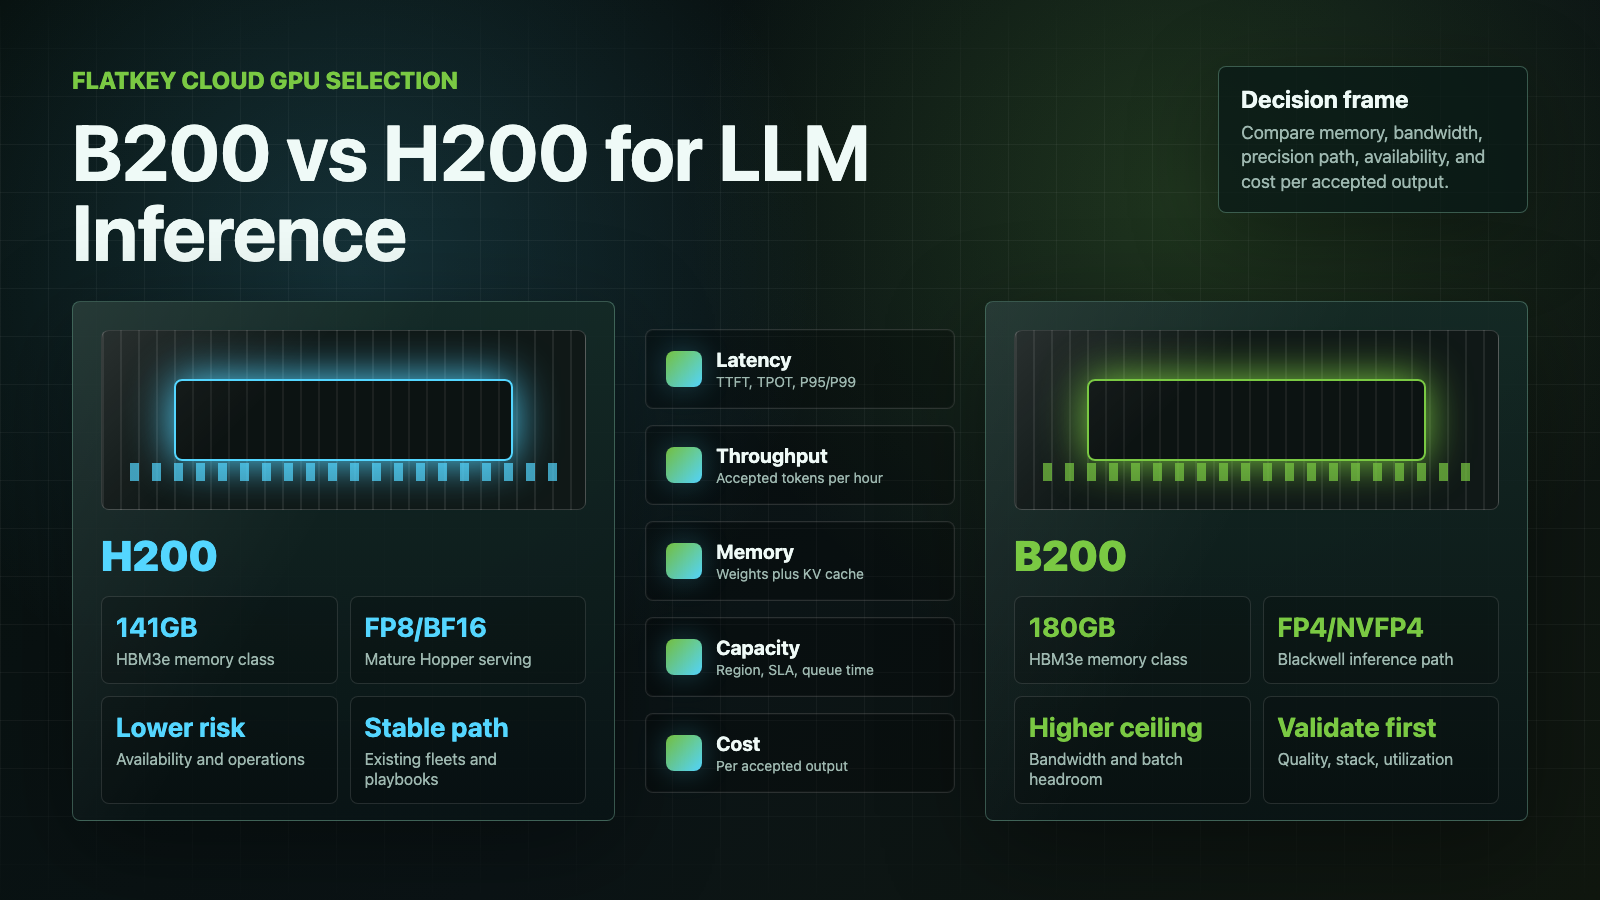
B200 vs H200 no es una decisión simple de "la GPU más nueva gana". NVIDIA B200 tiene un techo más alto para la inferencia de LLM cuando tu stack puede usar rutas de baja precisión de Blackwell, especialmente FP4/NVFP4, y cuando el ancho de banda de memoria es el cuello de botella. NVIDIA H200 suele ser la opción de menor riesgo cuando necesitas capacidad disponible, soporte maduro de serving en Hopper, comportamiento estable de FP8/BF16 y una fijación de precios más fácil hoy.
Esta guía está dirigida a equipos de IA empresarial que comparan capacidad de GPU en la nube para inferencia de LLM, no a coleccionistas de chips. La pregunta práctica es: ¿qué GPU ofrece la mejor latencia, rendimiento, fiabilidad y coste por salida aceptada para tu modelo, longitud de contexto, forma del tráfico y stack de serving?
Revisado el 13 de octubre de 2026.
B200 vs H200: la respuesta rápida
Elige B200 cuando tu carga de trabajo esté limitada por el rendimiento, por el ancho de banda de memoria, o esté lista para la baja precisión optimizada para Blackwell. Es la mejor plataforma de inferencia orientada al futuro para serving de gran volumen de 70B+, cargas de trabajo de contexto largo y equipos que pueden evaluar seriamente TensorRT-LLM, FP4/NVFP4 y el batching moderno antes de comprometer capacidad.
Elige H200 cuando necesites capacidad antes, tus cargas de trabajo ya funcionen bien en Hopper, tu stack esté construido alrededor de FP8/BF16, o las compras necesiten un mercado de GPU en la nube más maduro. H200 sigue siendo una GPU sólida para inferencia de LLM porque combina la madurez del software de Hopper con 141GB de memoria HBM3e y alto ancho de banda de memoria.
La guía rápida para el comprador:
| Decisión | Mejor punto de partida | Por qué |
|---|---|---|
| Nuevo clúster de inferencia de LLM de alto rendimiento | B200 | Más memoria por GPU, mayor ancho de banda de memoria, ruta de baja precisión de Blackwell, diseños de sistema más nuevos. |
| Expansión de una flota Hopper existente | H200 | Mayor continuidad operativa desde H100/H200, menos cambios en el stack, recetas de serving maduras. |
| Evaluación de FP4 o NVFP4 | B200 | Blackwell está diseñado para la nueva ruta de inferencia de baja precisión. |
| Serving en producción con FP8/BF16 | H200 primero, luego evaluar B200 | El soporte de Hopper es maduro; B200 aún necesita validación específica de la carga de trabajo. |
| Capacidad escasa en la ventana de lanzamiento | El proveedor que pueda contratar capacidad fiable | El tiempo en cola y el SLA pueden importar más que el pico teórico de la GPU. |
| Adquisición con el menor riesgo | H200 | Movimiento de compra en la nube más familiar y referencias de precios. |
| Mejor techo a largo plazo | B200 | Más margen si el software, la utilización y la disponibilidad encajan. |
Comparación de especificaciones para inferencia de LLM
Usa esta tabla como primer filtro y luego ejecuta tu propio benchmark. No compres B200 o H200 basándote solo en cifras teóricas de pico.
| Categoría | NVIDIA H200 | NVIDIA B200 | Por qué importa para la inferencia de LLM |
|---|---|---|---|
| Arquitectura | Hopper | Blackwell | B200 añade funciones de serving de Blackwell y aceleración de baja precisión; H200 hereda la madurez de Hopper. |
| Capacidad de memoria | 141GB HBM3e | 180GB HBM3e en configuraciones comunes SXM/DGX B200 | Más memoria ayuda con modelos más grandes, ventanas de contexto más largas, mayor KV cache y tamaños de batch más altos. |
| Ancho de banda de memoria | Hasta 4,8TB/s | Hasta unos 8TB/s en sistemas B200 de clase SXM | La generación de tokens y las cargas de trabajo intensivas en atención pueden quedar limitadas por el ancho de banda de memoria. |
| Baja precisión | FP8, BF16, FP16, TF32 y otros modos compatibles | FP4/NVFP4, FP8, BF16, FP16, TF32 y otros modos compatibles | La ventaja del B200 es más fuerte cuando el modelo y el stack de serving pueden usar la baja precisión de Blackwell sin pérdida de calidad. |
| Madurez del software | Ecosistema Hopper muy maduro | Ecosistema Blackwell en rápida maduración | H200 tiene un menor riesgo de adopción; B200 puede requerir más benchmarking y ajuste. |
| Estado de adquisición | Patrón cloud más amplio de H100/H200 | Más nuevo y a menudo con más limitaciones de capacidad | La disponibilidad puede decidir la respuesta antes que los benchmarks. |
Fuentes principales que conviene tener abiertas durante la evaluación: NVIDIA H200, NVIDIA DGX B200, la ficha técnica de Tensor Core GPU de NVIDIA y la visión general del rendimiento de TensorRT-LLM.
Por qué B200 puede superar a H200 en inferencia de LLM
El argumento más sólido a favor de B200 frente a H200 no es solo el cómputo bruto. Es la combinación de capacidad de memoria, ancho de banda de memoria, diseños más nuevos de interconexión/sistema e inferencia de baja precisión de Blackwell.
1. Más margen de memoria
H200 ya tiene una ventaja importante de memoria frente a los despliegues anteriores de H100 de 80GB. B200 lleva ese margen aún más lejos. Eso importa porque la inferencia de LLM en producción no consiste solo en los pesos del modelo. También necesitas espacio para la KV cache, la sobrecarga de ejecución, el batching, los buffers del framework, el estado de speculative decoding y márgenes de seguridad para prompts largos.
Para modelos de clase 70B, un H200 bien ajustado puede ser suficiente. Para modelos más grandes, mayor concurrencia, ventanas de contexto más largas o endpoints multi-tenant, la memoria adicional del B200 puede reducir la presión de sharding y hacer que tamaños de batch más altos sean más realistas.
2. Mayor ancho de banda de memoria
Muchas rutas de inferencia de LLM están limitadas por el movimiento de memoria, no solo por el pico de tensor. Durante la generación, cada token puede requerir movimientos repetidos de pesos y datos de la caché KV. Un mayor ancho de banda de memoria puede mejorar el rendimiento si el motor de serving, la cuantización, los kernels de atención y la política de batching pueden alimentar la GPU de manera eficiente.
Por eso una comparación de rendimiento entre B200 y H200 debe registrar tanto la latencia como el throughput. Una GPU que gana en tokens máximos por segundo puede no alcanzar su objetivo de latencia P95, y una GPU que parece cara por hora puede ser más barata por millón de tokens aceptados si la utilización es alta.
3. Rutas de baja precisión de Blackwell
B200 es más convincente cuando puede validar modos de precisión optimizados para Blackwell. FP4/NVFP4 puede cambiar de forma material la curva de costes para algunas cargas de trabajo de inferencia, pero el ahorro no es automático. Debe probar la calidad, el comportamiento de rechazo, la precisión en llamadas a herramientas, la deriva en resúmenes, la sensibilidad en recuperación y el comportamiento en contextos largos antes de cambiar un endpoint orientado al cliente.
Si su política de producción hoy requiere BF16 o FP8, H200 puede ser la primera implementación más predecible. Si está construyendo la próxima plataforma de inferencia y puede invertir en calibración y benchmarking específicos del modelo, B200 merece el primer puesto en la lista de pruebas.
Por qué H200 aún puede ser la mejor compra
H200 no es una GPU heredada de la forma en que ahora a menudo se trata a A100 para el serving de LLM de vanguardia. Es una pieza Hopper de alta memoria con una ruta de software madura, amplia familiaridad operativa y suficiente memoria para muchas cargas de trabajo serias de inferencia de LLM.
1. La disponibilidad puede superar al rendimiento máximo
La "mejor GPU" es inútil si no puede conseguirla durante una ventana de lanzamiento. En la adquisición de GPU en la nube, el tiempo en cola, los términos de reserva, la respuesta de soporte, la región, la red y el riesgo de cancelación forman parte del rendimiento. Si un proveedor puede entregar capacidad H200 fiable ahora mientras que la capacidad B200 solo está disponible bajo presupuesto o está atrasada, H200 puede ser la mejor decisión de negocio.
Para las tarifas actuales, consulte páginas de proveedores como precios de RunPod, precios de Lambda GPU Cloud, precios de Vast.ai y precios de Massed Compute. Trate esas páginas como comprobaciones de fuente en vivo, no como tarifas permanentes.
2. El serving en Hopper es operacionalmente familiar
Muchos equipos ya saben cómo ejecutar vLLM, SGLang, TensorRT-LLM, TGI, Ray Serve, operadores de Kubernetes, monitorización y autoscaling en GPUs de clase Hopper. Eso reduce el riesgo de migración. Si su flota de H100 o H200 ya tiene imágenes, kernels, umbrales de alertas, objetivos de utilización y manuales de incidentes probados, ampliar H200 puede ser mejor que una migración apresurada a B200.
3. H200 puede ser suficiente para inferencia de producción de 70B
Para implementaciones de 7B, 8B, 14B, 32B y muchas de 70B, H200 a menudo tiene suficiente memoria y throughput si la carga de trabajo está ajustada. La pregunta difícil no es "¿Puede H200 servir este modelo?" La pregunta difícil es "¿Puede H200 servir este modelo con nuestra latencia objetivo, longitud de contexto, tamaño de lote, objetivo de disponibilidad y coste por respuesta aceptada?"
Si la respuesta es sí, B200 tiene que justificar su caso mediante una mejor economía entregada, no solo mejores especificaciones.
DGX B200 vs H200: compare el sistema, no solo la GPU
La palabra clave "DGX B200 vs H200" suele mezclar dos niveles de comparación:
- Comparación de GPU: GPU B200 frente a GPU H200.
- Comparación de sistema: sistemas DGX B200 o de estilo HGX B200 frente a sistemas H200.
Para la adquisición, el nivel de sistema importa más. Un servidor con ocho GPUs B200 no son solo ocho aceleradores aislados. Incluye el diseño del host CPU, memoria, topología NVLink/NVSwitch, red, almacenamiento, potencia, refrigeración, soporte del proveedor e integración del clúster.
Al comparar la capacidad de DGX B200 vs H200, pida:
| Pregunta sobre el sistema | Por qué importa |
|---|---|
| Cantidad de GPU y formato | Los sistemas PCIe, SXM, HGX, DGX y NVL tienen distinto rendimiento y facilidad de servicio. |
| Topología NVLink/NVSwitch | El paralelismo de tensor multi-GPU y el particionado del modelo dependen de la calidad de la interconexión. |
| Red de interconexión | La inferencia y el entrenamiento multinodo necesitan InfiniBand, RoCE o una planificación de red equivalente. |
| Potencia y densidad por rack | Los sistemas B200 pueden cambiar el diseño del rack, la refrigeración y el calendario de despliegue. |
| Ruta de almacenamiento | El tiempo de carga del modelo y el movimiento de checkpoints afectan al tiempo de inicio facturable. |
| Soporte y SLA de reemplazo | El tiempo de inactividad forma parte del coste por salida aceptada. |
Si un proveedor ofrece capacidad "B200", confirme el sistema real. Un nodo B200 PCIe, un nodo HGX B200 y un sistema DGX B200 no son unidades de compra intercambiables.
Rendimiento B200 vs H200: qué medir
Ningún benchmark público puede responder por sí solo a su decisión entre B200 y H200. Una comparación útil de rendimiento NVIDIA B200 vs H200 necesita un benchmark reproducible con su modelo, tokenizador, distribución de contexto, patrón de tráfico y umbral de calidad.
Use tres modos de benchmark:
| Modo | Qué demuestra | Error común |
|---|---|---|
| Latencia de solicitud única | Tiempo hasta el primer token y capacidad de respuesta por usuario | Optimizar una solicitud y asumir que predice el rendimiento de producción. |
| Rendimiento saturado | Máximo de tokens de salida por segundo bajo carga | Ignorar la latencia P95/P99 y el comportamiento de encolamiento. |
| Reproducción de producción | Coste y latencia con longitudes de prompt reales y concurrencia real | Usar prompts sintéticos más cortos que el tráfico real de usuarios. |
Seguimiento de estos campos:
model_id:
weights_precision:
runtime: vLLM | SGLang | TensorRT-LLM | TGI | custom
gpu: H200 | B200
gpu_count:
context_input_p50:
context_input_p95:
output_tokens_p50:
output_tokens_p95:
target_ttft_ms:
target_tpot_ms:
concurrency:
batching_policy:
kv_cache_policy:
quality_eval_suite:
hourly_gpu_cost:
tokens_per_second:
accepted_answers_per_hour:
cost_per_1m_accepted_output_tokens:
La métrica clave es coste por salida aceptada, no solo tokens por segundo. Si B200 es más rápida pero cuesta mucho más por hora reservada confiable, H200 aún puede ganar. Si B200 permite un tamaño de lote mucho mayor, menor precisión con calidad aceptable o menos GPUs por endpoint, B200 puede ganar incluso con una tarifa horaria más alta.
Para una hoja de cálculo de costes más amplia, combina este benchmark con precios de alquiler de GPU, comparación de precios de modelos de IA, y cómo comparar precios de modelos de IA.
Recomendación por carga de trabajo
| Carga de trabajo | Mejor primer benchmark | Motivo |
|---|---|---|
| Modelo 8B o pequeño, API sensible a la latencia | H200 | La carga de trabajo puede no necesitar el margen de memoria de B200; la madurez del software importa. |
| Servicio de 70B FP8/BF16 | H200 y B200 | H200 puede ser suficiente; B200 puede ganar si el ancho de banda de memoria y el batching dominan. |
| Servicio de 70B FP4 | B200 | La ruta de precisión favorece a Blackwell, pero la validación de calidad es obligatoria. |
| Servicio de modelo 405B o muy grande | B200 | Más memoria y un ancho de banda de sistema más nuevo son valiosos, aunque la topología multi-GPU domina. |
| Endpoint RAG de contexto largo | B200 | La presión sobre la caché KV y el ancho de banda pueden hacer atractivo a B200. |
| Inferencia por lotes offline | B200 si la utilización es alta | El límite de rendimiento importa si los trabajos mantienen la GPU saturada. |
| Inferencia intermitente orientada al cliente | H200 o API del modelo primero | La capacidad ociosa de B200 puede ser costosa si el tráfico es irregular. |
| Plataforma existente H100/H200 | Primero expansión H200 | La continuidad operativa puede superar una migración a una nueva pila. |
Lista de verificación de precio y disponibilidad
No compares B200 vs H200 solo por el precio por hora. Compara la economía de la carga de trabajo completada.
| Campo | Captura H200 | Captura B200 |
|---|---|---|
| Proveedor | Nube, marketplace, clúster dedicado, sistema en colocation | Nube, marketplace, clúster dedicado, sistema en colocation |
| Modo de contrato | Bajo demanda, reservado, comprometido, clúster privado | Bajo demanda, reservado, comprometido, clúster privado |
| Sistema real | H200 PCIe, H200 SXM, H200 NVL, DGX/HGX | B200 PCIe, B200 SXM, HGX, DGX B200, opción GB200 |
| Región | Latencia, normas de datos, disponibilidad | Latencia, normas de datos, disponibilidad |
| Coste por hora o por mes | Incluye almacenamiento, soporte, egreso, tiempo ocioso | Incluye almacenamiento, soporte, egreso, tiempo ocioso |
| Utilización | Tiempo real activo de GPU | Tiempo real activo de GPU |
| Coste de fallos y reintentos | OOM, expulsión, imagen defectuosa, problema de red | OOM, errores de migración, fallos de ajuste |
| Tasa de salida aceptada | Respuestas, tokens, trabajos o solicitudes que pasan QA | Respuestas, tokens, trabajos o solicitudes que pasan QA |
Para compras, pide a los proveedores que coticen la misma unidad de trabajo:
Por favor, cotice capacidad para:
- modelo y precisión
- tráfico objetivo
- distribución de tokens de entrada/salida
- latencia P95 objetivo
- región requerida
- plazo comprometido
- soporte/SLA
- supuestos de almacenamiento y red
- coste esperado por 1M de tokens de salida aceptados
La última línea es importante. Si el proveedor no puede ayudar a relacionar el coste de la GPU con el coste de salida, tu equipo asume todo el riesgo de modelado.
Cuando ni B200 ni H200 son la respuesta correcta
A veces la respuesta correcta no es un clúster de GPU en absoluto. Si la utilización es baja, la demanda es irregular, el producto cambia de modelos con frecuencia o el equipo no quiere operar la infraestructura de serving, una API de modelo puede ser más barata y rápida que alquilar GPUs.
Flatkey se sitúa en el lado de la API de esa decisión. Ofrece a los equipos una sola clave, un solo saldo, una sola factura y un registro de uso en más de 300 modelos oficiales y más de 1.000 herramientas. Si tu hoja de trabajo de B200 vs H200 muestra una baja utilización o una alta sobrecarga operativa, compara una ruta de API de modelo antes de firmar un contrato de clúster. Para controles de gobernanza, presupuesto y enrutamiento, consulta precios de gateways de IA, gestión del gasto en API de IA y controles de cuota de API de IA.
Esto no significa que las APIs de modelo siempre superen a las GPU. Significa que la decisión sobre la GPU debe medirse frente a una alternativa de API usando la misma métrica de salida aceptada.
Recomendación final
Para la mayoría de los equipos de IA empresarial, la respuesta práctica a B200 vs H200 es:
- Empieza con H200 si necesitas capacidad fiable rápidamente, ya trabajas con Hopper o sirves cargas FP8/BF16 con herramientas maduras.
- Empieza con B200 si estás construyendo una nueva plataforma de inferencia de LLM de alto rendimiento, puedes validar la calidad de FP4/NVFP4 y puedes asegurar suficiente capacidad para mantener las GPU con una alta utilización.
- No te comprometas con ninguna de las dos GPU hasta que compares el coste por salida aceptada en tus prompts reales, longitudes de contexto y concurrencia.
Si B200 está disponible a una tarifa comprometida razonable y tu pila de software puede aprovechar Blackwell, es la plataforma de inferencia de LLM más sólida a largo plazo. Si la disponibilidad, el precio y el riesgo operativo dominan la decisión de compra, H200 sigue siendo una opción muy creíble y, a menudo, más práctica.
Preguntas frecuentes
¿Es B200 mejor que H200 para la inferencia de LLM?
B200 suele ser mejor para las cargas de inferencia de LLM con mayor rendimiento, gran demanda de ancho de banda de memoria y optimizadas para Blackwell. H200 puede ser mejor cuando la madurez del software de Hopper, la capacidad inmediata y un precio predecible son más importantes.
¿Cuál es la mayor diferencia en el rendimiento de NVIDIA B200 vs H200?
La mayor diferencia en el rendimiento de NVIDIA B200 vs H200 es la combinación de la mayor memoria del B200, el mayor ancho de banda de memoria y el soporte de baja precisión de Blackwell. La brecha real depende del tamaño del modelo, la precisión, el motor de serving, el batching y el objetivo de latencia.
¿Debería elegir H200 vs B200 para un modelo de 70B?
Para H200 vs B200 en un modelo de 70B, compara ambos si puedes. H200 puede ser suficiente para serving en FP8/BF16 con herramientas maduras. B200 resulta más atractivo para alta concurrencia, contexto largo o serving en FP4/NVFP4 tras validar la calidad.
¿DGX B200 vs H200 cambia la respuesta?
Sí. DGX B200 vs H200 es una decisión a nivel de sistema, no solo una decisión sobre la GPU. Compara el número de GPU, la topología NVLink/NVSwitch, la red, la potencia del rack, la refrigeración, el almacenamiento, el soporte y los términos de capacidad comprometida.
¿B200 siempre es más barato por token que H200?
No. B200 puede ser más barato por token cuando está muy utilizado y la pila de serving usa Blackwell de forma eficiente. H200 puede ser más barato cuando las tarifas por hora de B200, el tiempo de cola, el trabajo de migración o una baja utilización compensan la ganancia de rendimiento.
¿Qué debo medir antes de comprar capacidad B200 o H200?
Mide el tiempo hasta el primer token, los tokens por segundo de salida, la latencia P95/P99, las respuestas aceptadas por hora, la utilización de la GPU, la tasa de fallo, el coste de reinicio, el almacenamiento, el egreso, el soporte y el coste por 1 millón de tokens de salida aceptados.


