
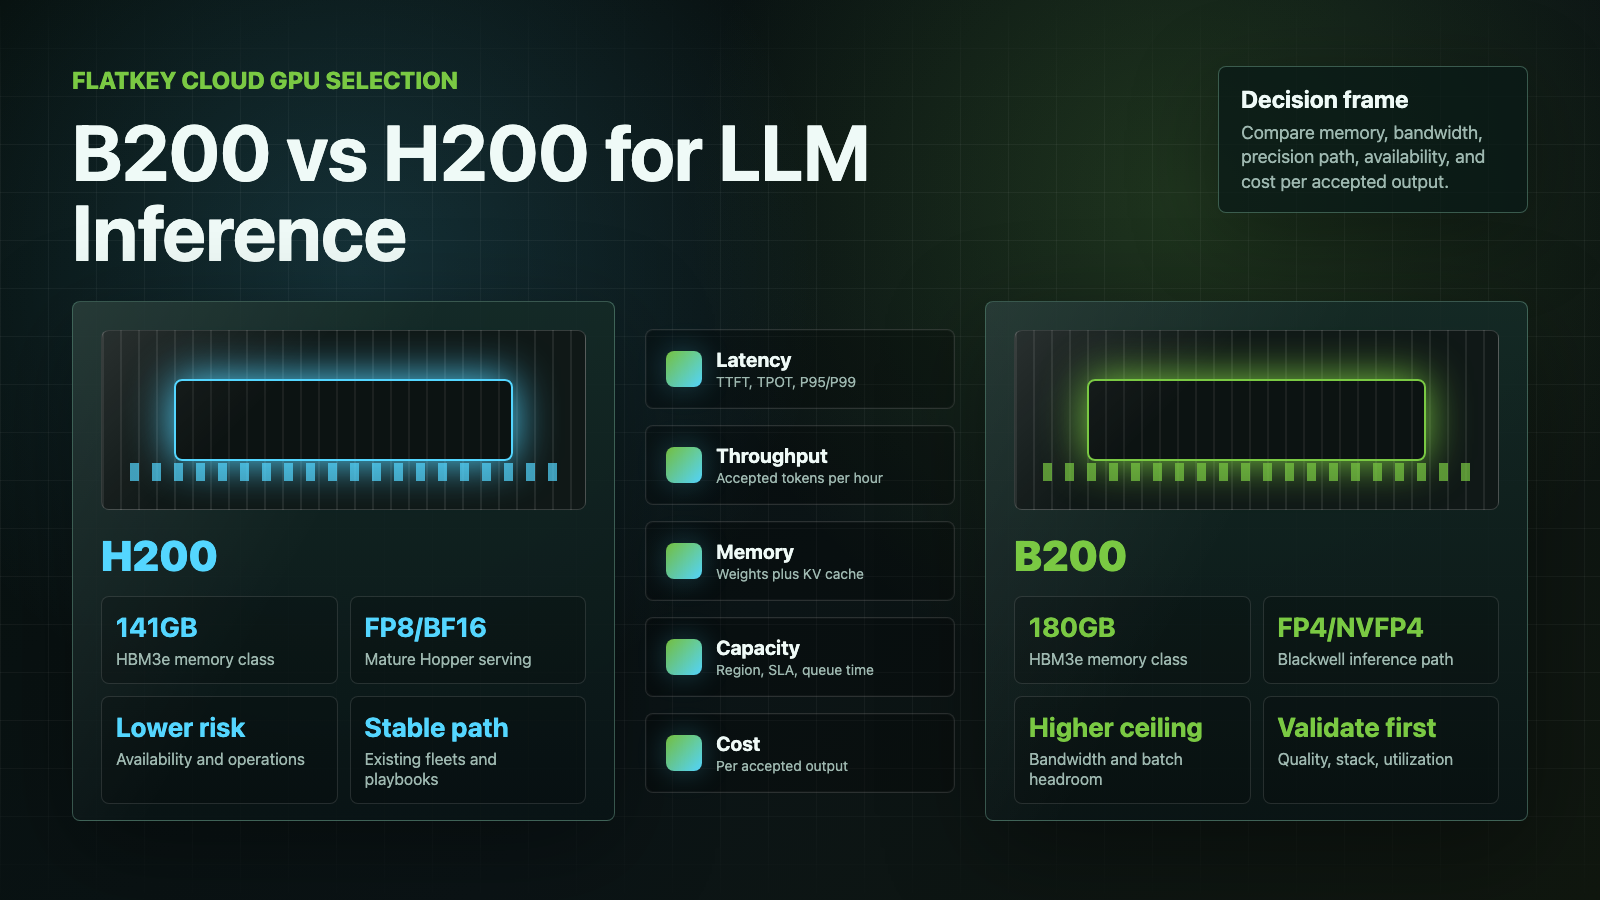
NVIDIA B200 vs H200: Qual GPU é melhor para inferência de LLM?
B200 vs H200 não é uma decisão simples de "a GPU mais nova vence". A NVIDIA B200 tem o teto mais alto para inferência de LLM quando seu stack pode usar caminhos de baixa precisão do Blackwell, especialmente FP4/NVFP4, e quando a largura de banda de memória é o gargalo. A NVIDIA H200 costuma ser a opção de menor risco quando você precisa de capacidade disponível, suporte maduro de serving para Hopper, comportamento estável em FP8/BF16 e descoberta de preço mais fácil hoje.
Este guia é para equipes de IA corporativa que comparam capacidade de GPU em nuvem para inferência de LLM, não para colecionadores de chips. A questão prática é: qual GPU oferece a melhor latência, throughput, confiabilidade e custo por saída aceita para o seu modelo, comprimento de contexto, padrão de tráfego e stack de serving?
Verificado em 13 de outubro de 2026.
B200 vs H200: a resposta rápida
Escolha B200 quando sua carga de trabalho for limitada por throughput, limitada por largura de banda de memória, ou estiver pronta para a baixa precisão otimizada para Blackwell. É a melhor plataforma de inferência com visão de futuro para serving de 70B+ em alto volume, workloads de contexto longo e equipes que podem benchmarkar TensorRT-LLM, FP4/NVFP4 e batching moderno com seriedade antes de comprometer capacidade.
Escolha H200 quando você precisar de capacidade mais cedo, suas cargas já rodarem bem em Hopper, seu stack for baseado em FP8/BF16, ou o procurement precisar de um mercado de GPU em nuvem mais maduro. A H200 ainda é uma GPU forte para inferência de LLM porque combina a maturidade de software de Hopper com 141GB de memória HBM3e e alta largura de banda de memória.
Atalho para compradores:
| Decisão | Melhor ponto de partida | Por quê |
|---|---|---|
| Novo cluster de inferência de LLM com alto throughput | B200 | Mais memória por GPU, maior largura de banda de memória, caminho de baixa precisão do Blackwell, designs de sistema mais novos. |
| Expansão de frota Hopper existente | H200 | Continuidade operacional mais fácil a partir de H100/H200, menos mudanças no stack, receitas de serving maduras. |
| Avaliação de FP4 ou NVFP4 | B200 | Blackwell foi construído para o caminho mais novo de inferência de baixa precisão. |
| Serving em produção com FP8/BF16 | H200 primeiro, depois benchmark da B200 | O suporte em Hopper é maduro; a B200 ainda precisa de validação específica da carga de trabalho. |
| Capacidade escassa na janela de lançamento | O provedor que conseguir contratar capacidade confiável | Tempo de fila e SLA podem importar mais do que o pico teórico da GPU. |
| Procurement de menor risco | H200 | Movimento de compra em nuvem mais familiar e referências de preço. |
| Melhor teto de longo prazo | B200 | Mais margem se software, utilização e disponibilidade se alinharem. |
Comparação de especificações para inferência de LLM
Use esta tabela como o primeiro filtro e depois execute seu próprio benchmark. Não compre B200 ou H200 com base apenas em números teóricos de pico.
| Categoria | NVIDIA H200 | NVIDIA B200 | Por que isso importa para inferência de LLM |
|---|---|---|---|
| Arquitetura | Hopper | Blackwell | A B200 adiciona recursos de serving do Blackwell e aceleração de baixa precisão; a H200 herda a maturidade de Hopper. |
| Capacidade de memória | 141GB HBM3e | 180GB HBM3e em configurações SXM/DGX B200 comuns | Mais memória ajuda com modelos maiores, janelas de contexto mais longas, KV cache maior e tamanhos de batch mais altos. |
| Largura de banda de memória | Até 4,8TB/s | Até cerca de 8TB/s em sistemas B200 classe SXM | Geração de tokens e workloads intensivos em atenção podem ficar limitados pela largura de banda de memória. |
| Baixa precisão | FP8, BF16, FP16, TF32 e outros modos suportados | FP4/NVFP4, FP8, BF16, FP16, TF32 e outros modos suportados | A vantagem da B200 é mais forte quando o modelo e o stack de serving podem usar a baixa precisão do Blackwell sem perda de qualidade. |
| Maturidade de software | Ecossistema Hopper muito maduro | Ecossistema Blackwell em rápida maturação | A H200 tem menor risco de adoção; a B200 pode exigir mais benchmark e ajuste fino. |
| Estado de procurement | Padrão de nuvem H100/H200 mais amplo | Mais nova e frequentemente mais limitada em capacidade | A disponibilidade pode decidir a resposta antes mesmo dos benchmarks. |
Fontes primárias para manter abertas durante a avaliação: NVIDIA H200, NVIDIA DGX B200, a folha de dados da Tensor Core GPU da NVIDIA e a visão geral de desempenho do TensorRT-LLM.
Por que a B200 pode superar a H200 para inferência de LLM
O argumento mais forte para B200 vs H200 não é apenas computação bruta. É a combinação de capacidade de memória, largura de banda de memória, designs mais novos de interconexão/sistema e inferência de baixa precisão do Blackwell.
1. Mais margem de memória
A H200 já tem uma grande vantagem de memória em relação às implantações anteriores da H100 80GB. A B200 leva essa margem ainda mais longe. Isso importa porque a inferência de LLM em produção não é apenas pesos do modelo. Você também precisa de espaço para KV cache, overhead de runtime, batching, buffers do framework, estado de speculative decoding e margens de segurança para prompts longos.
Para modelos na classe de 70B, uma H200 bem ajustada pode ser suficiente. Para modelos maiores, maior concorrência, janelas de contexto mais longas ou endpoints multi-tenant, a memória extra da B200 pode reduzir a pressão de sharding e tornar batches maiores mais realistas.
2. Maior largura de banda de memória
Muitos caminhos de inferência de LLM são limitados pelo movimento de memória, e não apenas pelo pico de tensor. Durante a geração, cada token pode exigir movimentação repetida de pesos e dados de cache KV. Uma maior largura de banda de memória pode melhorar a taxa de transferência se o mecanismo de serving, a quantização, os kernels de atenção e a política de batching conseguirem alimentar a GPU de forma eficiente.
É por isso que uma comparação de desempenho entre B200 e H200 deve registrar tanto a latência quanto a taxa de transferência. Uma GPU que vence em tokens máximos por segundo pode não vencer seu alvo de latência P95, e uma GPU que parece cara por hora pode sair mais barata por milhão de tokens aceitos se a utilização for alta.
3. Caminhos de baixa precisão do Blackwell
A B200 é mais atraente quando você consegue validar modos de precisão otimizados para Blackwell. FP4/NVFP4 pode alterar materialmente a curva de custo de algumas cargas de trabalho de inferência, mas a economia não é automática. Você precisa testar qualidade, comportamento de recusa, precisão em chamadas de ferramentas, desvio em sumarização, sensibilidade em recuperação e comportamento em contexto longo antes de trocar para um endpoint voltado ao cliente.
Se sua política de produção exige BF16 ou FP8 hoje, a H200 pode ser a primeira implantação mais previsível. Se você está construindo a próxima plataforma de inferência e pode investir em calibração e benchmark específicos do modelo, a B200 merece a primeira posição no benchmark.
Por que a H200 ainda pode ser a melhor compra
A H200 não é uma GPU legada da forma como a A100 é agora frequentemente tratada para serving de LLM de ponta. Ela é uma peça Hopper com muita memória, um caminho de software maduro, ampla familiaridade com operadores e memória suficiente para muitas cargas de trabalho sérias de inferência de LLM.
1. Disponibilidade pode superar desempenho de pico
A "melhor GPU" é inútil se você não conseguir garanti-la durante uma janela de lançamento. Na aquisição de GPU em nuvem, tempo na fila, termos de reserva, resposta de suporte, região, rede e risco de cancelamento fazem parte do desempenho. Se um provedor pode entregar capacidade H200 confiável agora enquanto a capacidade B200 depende de orçamento ou está em atraso, a H200 pode ser a melhor decisão de negócio.
Para as taxas atuais, consulte páginas de provedores como preços da RunPod, preços da Lambda GPU Cloud, preços da Vast.ai e preços da Massed Compute. Trate essas páginas como verificações de fonte ao vivo, não como tabelas de preços permanentes.
2. O serving em Hopper é operacionalmente familiar
Muitas equipes já sabem como executar vLLM, SGLang, TensorRT-LLM, TGI, Ray Serve, operadores Kubernetes, monitoramento e autoscaling em GPUs da classe Hopper. Isso reduz o risco de migração. Se sua frota H100 ou H200 já tem imagens, kernels, limiares de alerta, metas de utilização e playbooks de incidentes conhecidos como confiáveis, expandir H200 pode ser melhor do que uma migração apressada para B200.
3. A H200 pode ser suficiente para inferência em produção de 70B
Para implantações de 7B, 8B, 14B, 32B e muitas de 70B, a H200 frequentemente tem memória e throughput suficientes se a carga de trabalho estiver ajustada. A pergunta difícil não é "A H200 consegue servir este modelo?" A pergunta difícil é "A H200 consegue servir este modelo com nossa latência alvo, comprimento de contexto, tamanho de lote, meta de disponibilidade e custo por resposta aceita?"
Se a resposta for sim, a B200 precisa se justificar por uma economia melhor entregue, e não apenas por especificações melhores.
DGX B200 vs H200: compare o sistema, não apenas a GPU
A palavra-chave "DGX B200 vs H200" normalmente mistura dois níveis de comparação:
- Comparação de GPU: GPU B200 versus GPU H200.
- Comparação de sistema: sistemas no estilo DGX B200 ou HGX B200 versus sistemas H200.
Para aquisição, o nível do sistema importa mais. Um servidor com oito GPUs B200 não é apenas oito aceleradores isolados. Ele inclui design do host CPU, memória, topologia NVLink/NVSwitch, rede, armazenamento, energia, refrigeração, suporte do fornecedor e integração com o cluster.
Ao comparar capacidade DGX B200 vs H200, peça por:
| Pergunta sobre o sistema | Por que isso importa |
|---|---|
| Quantidade de GPUs e fator de forma | Sistemas PCIe, SXM, HGX, DGX e NVL têm desempenho e facilidade de manutenção diferentes. |
| Topologia NVLink/NVSwitch | Paralelismo tensorial multi-GPU e particionamento de modelo dependem da qualidade da interconexão. |
| Malha de rede | Inferência e treinamento multi-nó precisam de planejamento de malha InfiniBand, RoCE ou equivalente. |
| Energia e densidade em rack | Sistemas B200 podem mudar o design do rack, o resfriamento e o cronograma de implantação. |
| Caminho de armazenamento | O tempo de carregamento do modelo e a movimentação de checkpoints afetam o tempo de inicialização faturável. |
| Suporte e SLA de substituição | Tempo de inatividade faz parte do custo por saída aceita. |
Se um provedor cotar capacidade "B200", confirme o sistema real. Um nó B200 PCIe, um nó HGX B200 e um sistema DGX B200 não são unidades de compra intercambiáveis.
Desempenho B200 vs H200: o que benchmarkar
Nenhum benchmark público pode responder sozinho à sua decisão entre B200 e H200. Uma comparação útil de desempenho NVIDIA B200 vs H200 precisa de um benchmark reproduzível usando seu modelo, tokenizer, distribuição de contexto, padrão de tráfego e limite de qualidade.
Use três modos de benchmark:
| Modo | O que comprova | Erro comum |
|---|---|---|
| Latência de solicitação única | Tempo até o primeiro token e responsividade por usuário | Otimizar uma solicitação e assumir que isso prevê a vazão em produção. |
| Vazão saturada | Máximo de tokens de saída por segundo sob carga | Ignorar a latência P95/P99 e o comportamento de fila. |
| Reprodução de produção | Custo e latência sob comprimentos reais de prompt e concorrência | Usar prompts sintéticos mais curtos do que o tráfego real dos usuários. |
Acompanhe estes campos:
model_id:
weights_precision:
runtime: vLLM | SGLang | TensorRT-LLM | TGI | custom
gpu: H200 | B200
gpu_count:
context_input_p50:
context_input_p95:
output_tokens_p50:
output_tokens_p95:
target_ttft_ms:
target_tpot_ms:
concurrency:
batching_policy:
kv_cache_policy:
quality_eval_suite:
hourly_gpu_cost:
tokens_per_second:
accepted_answers_per_hour:
cost_per_1m_accepted_output_tokens:
A métrica principal é custo por saída aceita, não apenas tokens por segundo. Se a B200 for mais rápida, mas custar muito mais por hora reservada confiável, a H200 ainda pode vencer. Se a B200 permitir um tamanho de lote muito maior, precisão menor com qualidade aceitável ou menos GPUs por endpoint, a B200 pode vencer mesmo com uma taxa horária mais alta.
Para uma planilha de custos mais ampla, combine este benchmark com preços de aluguel de GPU, comparação de preços de modelos de IA e como comparar preços de modelos de IA.
Recomendação por tipo de workload
| Workload | Melhor primeiro benchmark | Motivo |
|---|---|---|
| API sensível à latência com modelo 8B ou menor | H200 | O workload pode não precisar da folga de memória da B200; a maturidade do software importa. |
| Serviço 70B FP8/BF16 | H200 e B200 | A H200 pode ser suficiente; a B200 pode vencer se largura de banda de memória e batching forem predominantes. |
| Serviço 70B FP4 | B200 | O caminho de precisão favorece Blackwell, mas a validação de qualidade é obrigatória. |
| Serviço de modelo 405B ou muito grande | B200 | Mais memória e largura de banda de sistema mais nova são valiosas, embora a topologia multi-GPU seja dominante. |
| Endpoint RAG de contexto longo | B200 | A pressão sobre o KV cache e a largura de banda podem tornar a B200 atraente. |
| Inferência offline em lote | B200 se a utilização for alta | O teto de vazão importa se os jobs mantiverem a GPU saturada. |
| Inferência voltada ao cliente com picos | H200 ou API de modelo primeiro | A capacidade ociosa da B200 pode ser cara se o tráfego for irregular. |
| Plataforma H100/H200 existente | Primeiro, expansão com H200 | A continuidade operacional pode superar uma migração para uma nova stack. |
Checklist de preço e disponibilidade
Não compare B200 vs H200 apenas pelo preço por hora. Compare a economia do workload concluído.
| Campo | Captura H200 | Captura B200 |
|---|---|---|
| Provedor | Nuvem, marketplace, cluster dedicado, sistema em colocation | Nuvem, marketplace, cluster dedicado, sistema em colocation |
| Modo de contrato | Sob demanda, reservado, comprometido, cluster privado | Sob demanda, reservado, comprometido, cluster privado |
| Sistema real | H200 PCIe, H200 SXM, H200 NVL, DGX/HGX | B200 PCIe, B200 SXM, HGX, DGX B200, opção GB200 |
| Região | Latência, regras de dados, disponibilidade | Latência, regras de dados, disponibilidade |
| Custo por hora ou por mês | Inclua armazenamento, suporte, egress, tempo ocioso | Inclua armazenamento, suporte, egress, tempo ocioso |
| Utilização | Tempo real em que a GPU esteve ativa | Tempo real em que a GPU esteve ativa |
| Custo de falha e repetição | OOM, expulsão, imagem ruim, problema de rede | OOM, bugs de migração, falhas de ajuste |
| Taxa de saída aceita | Respostas, tokens, jobs ou requests que passam pela QA | Respostas, tokens, jobs ou requests que passam pela QA |
Para aquisição, peça que os provedores cotem a mesma unidade de workload:
Por favor, cotem a capacidade para:
- modelo e precisão
- tráfego-alvo
- distribuição de tokens de entrada/saída
- latência P95-alvo
- região necessária
- prazo comprometido
- suporte/SLA
- hipóteses de armazenamento e rede
- custo esperado por 1M de tokens de saída aceitos
Essa última linha é importante. Se o provedor não puder ajudar a mapear o custo da GPU para o custo de saída, sua equipe assume todo o risco de modelagem.
Quando nem B200 nem H200 são a resposta certa
Às vezes, a resposta certa não é um cluster de GPU. Se a utilização for baixa, a demanda for irregular, o produto mudar de modelo com frequência ou a equipe não quiser operar a infraestrutura de serving, uma API de modelo pode ser mais barata e mais rápida do que alugar GPUs.
Flatkey fica do lado da API dessa decisão. Ele oferece às equipes uma única chave, um único saldo, uma única fatura e um registro de uso em mais de 300 modelos oficiais e mais de 1.000 ferramentas. Se sua planilha de B200 vs H200 mostrar baixa utilização ou alto overhead operacional, compare uma rota de API de modelo antes de assinar um contrato de cluster. Para governança, orçamento e controles de roteamento, veja preços de gateway de IA, gestão de gastos com APIs de IA e controles de cota de API de IA.
Isso não significa que as APIs de modelo sempre superem as GPUs. Significa que a decisão sobre GPU deve ser medida em relação a uma alternativa de API usando a mesma métrica de saída aceita.
Recomendação final
Para a maioria das equipes corporativas de IA, a resposta prática para B200 vs H200 é:
- Comece com H200 se você precisar de capacidade confiável rapidamente, já operar Hopper ou atender cargas de trabalho FP8/BF16 com tooling maduro.
- Comece com B200 se estiver construindo uma nova plataforma de inferência de LLM de alto throughput, puder validar a qualidade de FP4/NVFP4 e conseguir garantir capacidade suficiente para manter as GPUs altamente utilizadas.
- Não se comprometa com nenhuma das GPUs até comparar o custo por saída aceita em seus prompts reais, comprimentos de contexto e concorrência.
Se a B200 estiver disponível por uma taxa contratada razoável e sua pilha de software puder explorar o Blackwell, ela é a plataforma de inferência de LLM mais forte no longo prazo. Se disponibilidade, preço e risco operacional dominarem a decisão de compra, a H200 continua sendo uma opção muito confiável e muitas vezes mais prática.
Perguntas frequentes
A B200 é melhor do que a H200 para inferência de LLM?
A B200 geralmente é melhor para cargas de inferência de LLM com maior throughput, intensivas em largura de banda de memória e otimizadas para Blackwell. A H200 pode ser melhor quando a maturidade do software Hopper, a capacidade imediata e um preço previsível importam mais.
Qual é a maior diferença no desempenho entre NVIDIA B200 vs H200?
A maior diferença no desempenho entre NVIDIA B200 vs H200 é a combinação da memória maior da B200, maior largura de banda de memória e suporte a baixa precisão do Blackwell. A diferença real depende do tamanho do modelo, precisão, mecanismo de serving, batching e objetivo de latência.
Devo escolher H200 vs B200 para um modelo de 70B?
Para H200 vs B200 em um modelo de 70B, faça benchmark de ambas se possível. A H200 pode ser suficiente para serving em FP8/BF16 com tooling maduro. A B200 é mais atraente para alta concorrência, contexto longo ou serving em FP4/NVFP4 após validação de qualidade.
DGX B200 vs H200 muda a resposta?
Sim. DGX B200 vs H200 é uma decisão no nível do sistema, não apenas da GPU. Compare número de GPUs, topologia NVLink/NVSwitch, rede, energia do rack, refrigeração, armazenamento, suporte e termos de capacidade contratada.
A B200 é sempre mais barata por token do que a H200?
Não. A B200 pode ser mais barata por token quando está altamente utilizada e a pilha de serving usa o Blackwell de forma eficiente. A H200 pode ser mais barata quando as taxas horárias da B200, o tempo de fila, o trabalho de migração ou a subutilização anulam o ganho de desempenho.
O que devo medir antes de comprar capacidade B200 ou H200?
Meça tempo até o primeiro token, tokens por segundo de saída, latência P95/P99, respostas aceitas por hora, utilização da GPU, taxa de falhas, custo de reinicialização, armazenamento, egress, suporte e custo por 1 milhão de tokens de saída aceitos.


