
NVIDIA B200 против H200: какой GPU лучше для инференса LLM?
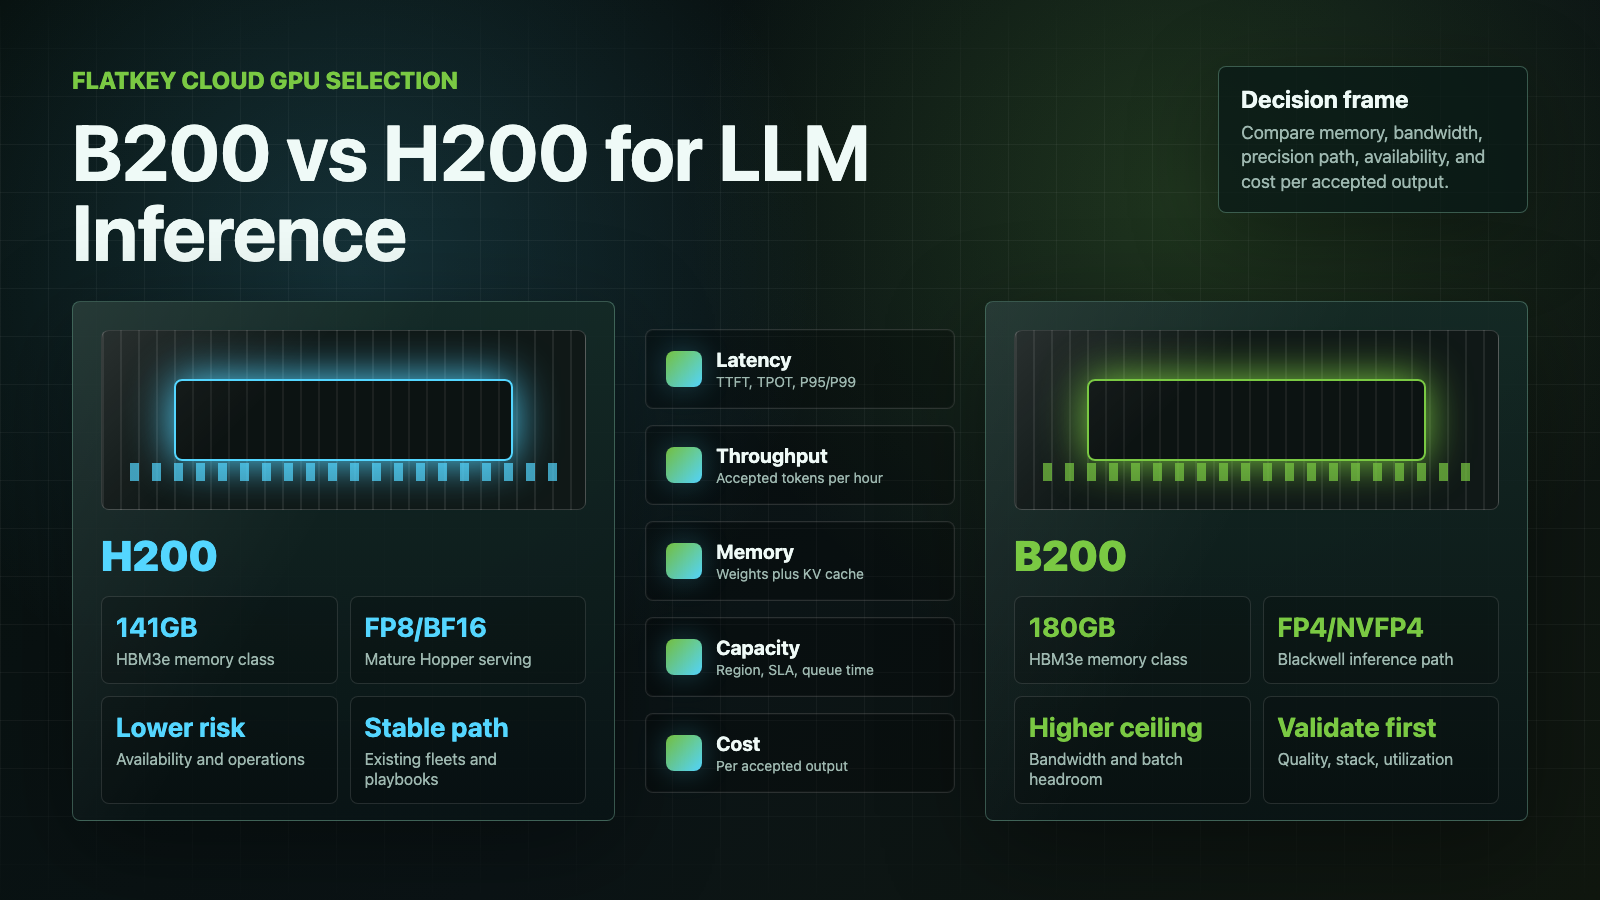
B200 против H200 — это не простое решение в духе «новее значит лучше». NVIDIA B200 имеет более высокий потолок для инференса LLM, когда ваш стек может использовать низкоточные пути Blackwell, особенно FP4/NVFP4, и когда узким местом является пропускная способность памяти. NVIDIA H200 обычно является менее рискованным выбором, когда вам нужна доступная мощность, зрелая поддержка обслуживания Hopper, стабильное поведение FP8/BF16 и более простое ценообразование уже сегодня.
Это руководство предназначено для enterprise AI-команд, сравнивающих облачную GPU-мощность для инференса LLM, а не для коллекционеров чипов. Практический вопрос таков: какой GPU даст лучшую задержку, пропускную способность, надежность и стоимость за принятый результат для вашей модели, длины контекста, характера трафика и стека обслуживания?
Проверено 13 октября 2026 года.
B200 против H200: краткий ответ
Выбирайте B200, когда ваша нагрузка ограничена пропускной способностью, пропускной способностью памяти или готова к низкой точности, оптимизированной для Blackwell. Это лучшая платформа для инференса с прицелом на будущее для высоконагруженного обслуживания моделей 70B+, задач с длинным контекстом и команд, которые могут серьезно протестировать TensorRT-LLM, FP4/NVFP4 и современные методы батчинга, прежде чем выделять мощности.
Выбирайте H200, когда вам нужна мощность быстрее, ваши нагрузки уже хорошо работают на Hopper, ваш стек построен вокруг FP8/BF16 или закупкам нужен более зрелый облачный рынок GPU. H200 по-прежнему является сильным GPU для инференса LLM, поскольку сочетает зрелость ПО Hopper с памятью 141 ГБ HBM3e и высокой пропускной способностью памяти.
Краткая подсказка для покупателя:
| Решение | Лучшая отправная точка | Почему |
|---|---|---|
| Новый кластер инференса LLM с высокой пропускной способностью | B200 | Больше памяти на GPU, более высокая пропускная способность памяти, низкоточный путь Blackwell, более новые системные дизайны. |
| Расширение существующего пула Hopper | H200 | Более простая операционная преемственность от H100/H200, меньше изменений в стеке, зрелые рецепты обслуживания. |
| Оценка FP4 или NVFP4 | B200 | Blackwell создан для нового низкоточного пути инференса. |
| Продакшн-обслуживание на FP8/BF16 | Сначала H200, затем бенчмарк B200 | Поддержка Hopper зрелая; B200 по-прежнему требует проверки под конкретную нагрузку. |
| Дефицитная мощность в окне запуска | Тот провайдер, который может гарантировать надежную мощность по контракту | Время ожидания и SLA могут иметь большее значение, чем теоретический пик GPU. |
| Закупка с наименьшим риском | H200 | Более привычный процесс покупки в облаке и ценовые ориентиры. |
| Лучший долгосрочный потолок | B200 | Больше запаса, если сошлись ПО, утилизация и доступность. |
Сравнение характеристик для инференса LLM
Используйте эту таблицу как первый фильтр, а затем проведите собственный бенчмарк. Не покупайте B200 или H200, опираясь только на теоретические пиковые значения.
| Категория | NVIDIA H200 | NVIDIA B200 | Почему это важно для инференса LLM |
|---|---|---|---|
| Архитектура | Hopper | Blackwell | B200 добавляет возможности обслуживания Blackwell и ускорение низкой точности; H200 наследует зрелость Hopper. |
| Объем памяти | 141 ГБ HBM3e | 180 ГБ HBM3e в распространенных конфигурациях SXM/DGX B200 | Больше памяти помогает с более крупными моделями, более длинными окнами контекста, большим KV cache и более высокими размерами батча. |
| Пропускная способность памяти | До 4,8 ТБ/с | До примерно 8 ТБ/с в системах класса B200 SXM | Генерация токенов и нагрузки с интенсивным attention могут упираться в пропускную способность памяти. |
| Низкая точность | FP8, BF16, FP16, TF32 и другие поддерживаемые режимы | FP4/NVFP4, FP8, BF16, FP16, TF32 и другие поддерживаемые режимы | Преимущество B200 наиболее сильно, когда модель и стек обслуживания могут использовать низкую точность Blackwell без потери качества. |
| Зрелость ПО | Очень зрелая экосистема Hopper | Быстро взрослеющая экосистема Blackwell | У H200 ниже риск внедрения; B200 может потребовать больше бенчмаркинга и настройки. |
| Состояние закупок | Более широкий облачный паттерн H100/H200 | Новее и часто более ограничен по мощности | Доступность может определить ответ еще до бенчмарков. |
Основные источники, которые стоит держать открытыми во время оценки: NVIDIA H200, NVIDIA DGX B200, datasheet NVIDIA Tensor Core GPU и обзор производительности TensorRT-LLM.
Почему B200 может обойти H200 в инференсе LLM
Самый сильный аргумент в пользу B200 против H200 — это не только сырой compute. Это сочетание объема памяти, пропускной способности памяти, более новых interconnect/system design и низкоточного инференса Blackwell.
1. Больше запаса по памяти
H200 уже имеет серьезное преимущество по памяти по сравнению с более ранними развертываниями H100 80GB. B200 еще больше расширяет этот запас. Это важно, потому что production-инференс LLM — это не только веса модели. Вам также нужно место для KV cache, runtime-накладных расходов, батчинга, буферов фреймворка, состояния speculative decoding и запасов безопасности для длинных промптов.
Для моделей класса 70B хорошо настроенного H200 может быть достаточно. Для более крупных моделей, более высокой конкурентной нагрузки, более длинных окон контекста или multi-tenant endpoints дополнительная память B200 может снизить давление на шардинг и сделать более высокие размеры батча более реалистичными.
2. Более высокая пропускная способность памяти
Многие пути инференса LLM ограничены не только пиковыми вычислениями тензоров, но и перемещением данных в памяти. Во время генерации каждый токен может требовать многократного перемещения весов и данных KV-кэша. Более высокая пропускная способность памяти может повысить throughput, если движок сервинга, квантизация, attention-ядра и политика батчинга способны эффективно загружать GPU.
Именно поэтому сравнение производительности B200 vs H200 должно учитывать и задержку, и throughput. GPU, который показывает лучший результат по максимальному числу токенов в секунду, может не выиграть по вашему целевому P95 latency, а GPU, который кажется дорогим в расчете на час, может оказаться дешевле на миллион принятых токенов, если у него высокая утилизация.
3. Низкоточные пути Blackwell
B200 наиболее привлекателен тогда, когда вы можете подтвердить оптимизированные для Blackwell режимы точности. FP4/NVFP4 могут существенно изменить кривую затрат для некоторых задач инференса, но экономия не возникает автоматически. Перед переключением клиентского endpoint нужно протестировать качество, поведение при отказах, точность вызовов инструментов, дрейф суммаризации, чувствительность к retrieval и поведение на длинном контексте.
Если ваша production-политика сегодня требует BF16 или FP8, H200 может быть более предсказуемым первым вариантом внедрения. Если вы строите следующую платформу инференса и готовы инвестировать в калибровку и бенчмаркинг под конкретную модель, B200 заслуживает первого места в очереди на тестирование.
Почему H200 по-прежнему может быть более выгодной покупкой
H200 — это не устаревший GPU в том смысле, в каком A100 сейчас часто рассматривают для обслуживания frontier LLM. Это решение Hopper с большим объемом памяти, зрелым программным стеком, широкой привычностью для операторов и достаточным объемом памяти для многих серьезных задач инференса LLM.
1. Доступность может быть важнее пиковой производительности
«Лучший GPU» бесполезен, если вы не можете получить его в период запуска. В закупке облачных GPU время в очереди, условия резервации, реакция поддержки, регион, сеть и риск отмены являются частью производительности. Если провайдер может сейчас обеспечить надежную емкость H200, тогда как емкость B200 доступна только по запросу или с задержкой поставки, H200 может быть лучшим бизнес-решением.
Актуальные тарифы смотрите на страницах провайдеров, например RunPod pricing, Lambda GPU Cloud pricing, Vast.ai pricing и Massed Compute pricing. Рассматривайте эти страницы как актуальные источники проверки, а не как постоянные прайс-листы.
2. Сервинг на Hopper операционно хорошо знаком
Многие команды уже знают, как запускать vLLM, SGLang, TensorRT-LLM, TGI, Ray Serve, операторы Kubernetes, мониторинг и autoscaling вокруг GPU класса Hopper. Это снижает риск миграции. Если у вашего парка H100 или H200 уже есть проверенные образы, ядра, пороги оповещений, целевые показатели утилизации и инструкции по инцидентам, расширение H200 может оказаться лучше, чем поспешная миграция на B200.
3. H200 может быть достаточен для production-инференса 70B
Для развертываний 7B, 8B, 14B, 32B и многих моделей 70B у H200 часто достаточно памяти и throughput, если нагрузка настроена. Сложный вопрос не в том, «может ли H200 обслуживать эту модель?». Сложный вопрос в том, «может ли H200 обслуживать эту модель при нашей целевой задержке, длине контекста, размере батча, целевом уровне доступности и стоимости за принятый ответ?»
Если ответ «да», то B200 должен оправдать себя лучшей фактической экономикой, а не только лучшими спецификациями.
DGX B200 vs H200: сравнивайте систему, а не только GPU
Ключевая фраза «DGX B200 vs H200» обычно смешивает два уровня сравнения:
- Сравнение GPU: B200 GPU против H200 GPU.
- Сравнение системы: системы в стиле DGX B200 или HGX B200 против систем H200.
Для закупки уровень системы важнее. Сервер с восемью GPU B200 — это не просто восемь изолированных ускорителей. Он включает дизайн CPU-хоста, память, топологию NVLink/NVSwitch, сеть, хранилище, питание, охлаждение, поддержку вендора и интеграцию в кластер.
При сравнении емкости DGX B200 vs H200 запросите:
| Вопрос по системе | Почему это важно |
|---|---|
| Количество GPU и форм-фактор | Системы PCIe, SXM, HGX, DGX и NVL имеют разную производительность и обслуживаемость. |
| Топология NVLink/NVSwitch | Многопроцессорный tensor parallelism и шардирование модели зависят от качества interconnect. |
| Сетевая fabric | Многоузловой инференс и обучение требуют InfiniBand, RoCE или сопоставимого планирования fabric. |
| Питание и плотность размещения в стойке | Системы B200 могут изменить проект стойки, охлаждение и сроки развертывания. |
| Путь к хранилищу | Время загрузки модели и перемещение checkpoint влияют на оплачиваемое время запуска. |
| Поддержка и SLA на замену | Простой — это часть стоимости одного принятого вывода. |
Если провайдер предлагает емкость «B200», уточните реальную систему. Узел B200 PCIe, узел HGX B200 и система DGX B200 не являются взаимозаменяемыми единицами закупки.
Производительность B200 vs H200: что бенчмаркить
Ни один публичный бенчмарк сам по себе не ответит на ваш выбор B200 vs H200. Полезное сравнение производительности NVIDIA B200 vs H200 требует воспроизводимого бенчмарка с использованием вашей модели, tokenizer, распределения контекста, паттерна трафика и порога качества.
Используйте три режима бенчмарка:
| Режим | Что он доказывает | Распространённая ошибка |
|---|---|---|
| Задержка одного запроса | Время до первого токена и отзывчивость для пользователя | Оптимизировать один запрос и считать, что это предсказывает производительность в продакшене. |
| Насыщенная пропускная способность | Максимальное число выходных токенов в секунду под нагрузкой | Игнорировать задержку P95/P99 и поведение очереди. |
| Повторный прогон продакшена | Стоимость и задержка при реальных длинах промптов и уровне конкуренции | Использовать синтетические промпты, которые короче реального пользовательского трафика. |
Отслеживайте эти поля:
model_id:
weights_precision:
runtime: vLLM | SGLang | TensorRT-LLM | TGI | custom
gpu: H200 | B200
gpu_count:
context_input_p50:
context_input_p95:
output_tokens_p50:
output_tokens_p95:
target_ttft_ms:
target_tpot_ms:
concurrency:
batching_policy:
kv_cache_policy:
quality_eval_suite:
hourly_gpu_cost:
tokens_per_second:
accepted_answers_per_hour:
cost_per_1m_accepted_output_tokens:
Ключевая метрика — стоимость за принятый вывод, а не просто токены в секунду. Если B200 быстрее, но обходится намного дороже за надёжный зарезервированный час, H200 всё равно может выиграть. Если B200 позволяет гораздо больший размер батча, более низкую точность при приемлемом качестве или меньшее число GPU на конечную точку, B200 может выиграть даже при более высокой почасовой ставке.
Для более широкой таблицы затрат сопоставьте этот бенчмарк с ценами аренды GPU, сравнением цен на AI-модели и тем, как сравнивать цены на AI-модели.
Рекомендации по сценариям нагрузки
| Нагрузка | Лучший первый бенчмарк | Причина |
|---|---|---|
| API для модели 8B или меньше, чувствительный к задержке | H200 | Для этой нагрузки может не понадобиться запас памяти B200; важна зрелость ПО. |
| Обслуживание 70B FP8/BF16 | H200 и B200 | H200 может быть достаточен; B200 может выиграть, если доминируют пропускная способность памяти и батчинг. |
| Обслуживание 70B FP4 | B200 | Путь точности благоприятствует Blackwell, но проверка качества обязательна. |
| Обслуживание 405B или очень большой модели | B200 | Больше памяти и более широкая системная пропускная способность ценны, хотя топология multi-GPU доминирует. |
| RAG-конечная точка с длинным контекстом | B200 | Нагрузка на KV-кэш и пропускная способность могут сделать B200 привлекательным. |
| Пакетный офлайн-инференс | B200, если загрузка высокая | Потолок пропускной способности важен, если задания держат GPU в насыщенном режиме. |
| Периодический пользовательский инференс | Сначала H200 или model API | Неиспользуемая мощность B200 может быть дорогой, если трафик идёт всплесками. |
| Уже существующая платформа H100/H200 | Сначала расширение H200 | Операционная непрерывность может оказаться важнее миграции на новый стек. |
Чек-лист по цене и доступности
Не сравнивайте B200 и H200 только по почасовой цене. Сравнивайте экономику завершённой нагрузки.
| Поле | Сбор для H200 | Сбор для B200 |
|---|---|---|
| Провайдер | Облако, маркетплейс, выделенный кластер, колокированная система | Облако, маркетплейс, выделенный кластер, колокированная система |
| Модель контракта | On-demand, reserved, committed, private cluster | On-demand, reserved, committed, private cluster |
| Фактическая система | H200 PCIe, H200 SXM, H200 NVL, DGX/HGX | B200 PCIe, B200 SXM, HGX, DGX B200, опция GB200 |
| Регион | Задержка, правила обработки данных, доступность | Задержка, правила обработки данных, доступность |
| Почасовая или помесячная стоимость | Включите хранилище, поддержку, egress, простои | Включите хранилище, поддержку, egress, простои |
| Утилизация | Реальное время активности GPU | Реальное время активности GPU |
| Стоимость сбоев и повторов | OOM, эвикция, плохой образ, сетевая проблема | OOM, ошибки миграции, сбои настройки |
| Принятый темп вывода | Ответы, токены, задания или запросы, прошедшие QA | Ответы, токены, задания или запросы, прошедшие QA |
Для закупки попросите провайдеров указать цену для одного и того же единичного сценария:
Please quote capacity for:
- model and precision
- target traffic
- input/output token distribution
- target P95 latency
- required region
- committed term
- support/SLA
- storage and network assumptions
- expected cost per 1M accepted output tokens
Последняя строка важна. Если провайдер не может помочь связать стоимость GPU со стоимостью вывода, вся ответственность за моделирование риска ложится на вашу команду.
Когда ни B200, ни H200 не являются правильным ответом
Иногда правильный ответ — вовсе не кластер GPU. Если загрузка низкая, спрос скачкообразный, продукт часто меняет модели или команда не хочет эксплуатировать инфраструктуру обслуживания, model API может оказаться дешевле и быстрее, чем аренда GPU.
Flatkey находится на стороне API в рамках этого выбора. Он дает командам один ключ, один баланс, один счет и журнал использования по более чем 300 официальным моделям и 1,000+ инструментам. Если ваш рабочий лист по сравнению B200 и H200 показывает низкую загрузку или высокие операционные накладные расходы, сравните путь через API модели, прежде чем подписывать контракт на кластер. Для управления, бюджета и контроля маршрутизации см. ценообразование AI gateway, управление расходами на AI API и контроль квот AI API.
Это не означает, что API моделей всегда лучше GPU. Это означает, что решение по GPU следует сопоставлять с альтернативой в виде API, используя ту же метрику принятых результатов.
Итоговая рекомендация
Для большинства корпоративных AI-команд практический ответ на вопрос B200 vs H200 таков:
- Начинайте с H200, если вам нужна надежная мощность быстро, вы уже используете Hopper или обслуживаете нагрузки FP8/BF16 с зрелым инструментарием.
- Начинайте с B200, если вы строите новую высокопроизводительную платформу инференса LLM, можете подтвердить качество FP4/NVFP4 и способны обеспечить достаточно ресурсов, чтобы GPU оставались высоко загруженными.
- Не принимайте обязательств по любой из этих GPU, пока не сравните стоимость на один принятый результат на ваших реальных промптах, длинах контекста и уровне параллелизма.
Если B200 доступен по разумной фиксированной ставке и ваш программный стек может эффективно использовать Blackwell, это более сильная долгосрочная платформа для инференса LLM. Если в решении о покупке главную роль играют доступность, цена и операционные риски, H200 остается очень убедительным и часто более практичным выбором.
Часто задаваемые вопросы
Лучше ли B200, чем H200, для инференса LLM?
B200 обычно лучше для самых высокопроизводительных нагрузок инференса LLM с упором на пропускную способность и пропускную способность памяти, оптимизированных под Blackwell. H200 может быть лучше, когда важнее зрелость программного обеспечения Hopper, немедленная доступность и предсказуемая цена.
Какое самое большое различие в производительности NVIDIA B200 vs H200?
Самое большое различие в производительности NVIDIA B200 vs H200 — это сочетание большего объема памяти у B200, более высокой пропускной способности памяти и поддержки низкой точности в Blackwell. Реальный разрыв зависит от размера модели, точности, сервинг-движка, батчинга и целевой задержки.
Стоит ли выбирать H200 vs B200 для модели 70B?
Для H200 vs B200 на модели 70B по возможности протестируйте оба варианта. H200 может быть достаточно хорош для обслуживания FP8/BF16 с зрелым инструментарием. B200 выглядит более привлекательным для высокой конкурентной нагрузки, длинного контекста или обслуживания FP4/NVFP4 после проверки качества.
Меняет ли DGX B200 vs H200 ответ?
Да. DGX B200 vs H200 — это решение на уровне системы, а не только GPU. Сравнивайте количество GPU, топологию NVLink/NVSwitch, сеть, энергопотребление стойки, охлаждение, хранилище, поддержку и условия по гарантированной мощности.
Всегда ли B200 дешевле за токен, чем H200?
Нет. B200 может быть дешевле за токен, когда он хорошо загружен, а сервинг-стек эффективно использует Blackwell. H200 может оказаться дешевле, когда почасовые ставки B200, время в очереди, затраты на миграцию или недоиспользование нивелируют выигрыш в производительности.
Что нужно измерить перед покупкой мощности B200 или H200?
Измерьте время до первого токена, количество токенов в секунду вывода, задержку P95/P99, количество принятых ответов в час, загрузку GPU, частоту сбоев, стоимость перезапуска, хранилище, исходящий трафик, поддержку и стоимость за 1 млн принятых выходных токенов.


