
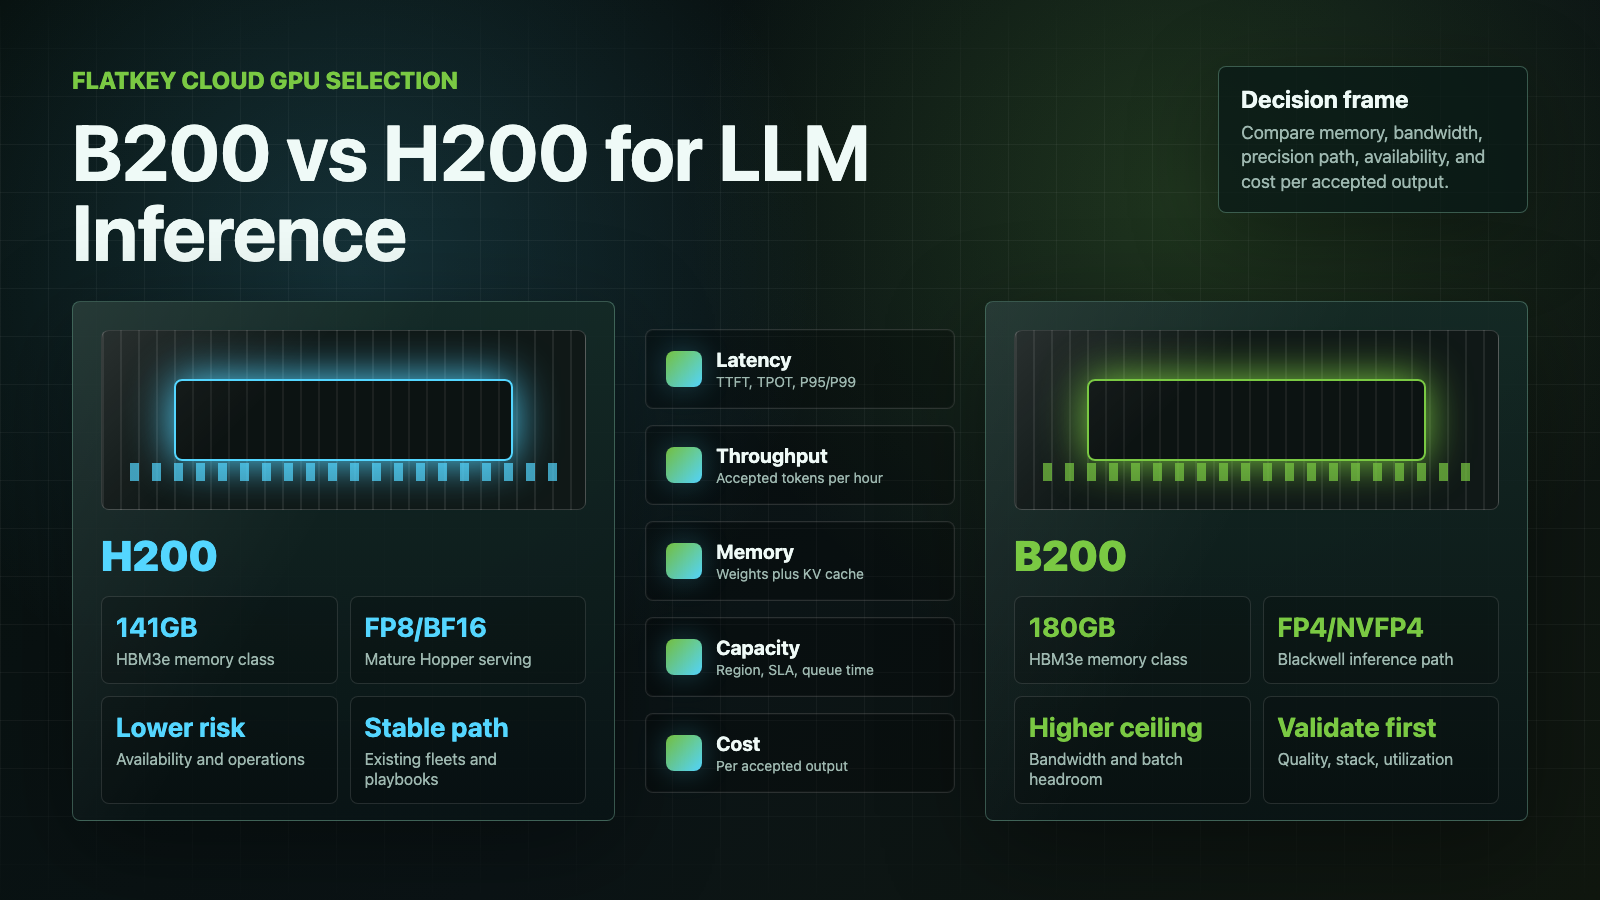
NVIDIA B200 so với H200: GPU nào tốt hơn cho suy luận LLM?
B200 so với H200 không phải là một quyết định đơn giản kiểu "GPU mới hơn thắng". NVIDIA B200 có trần hiệu năng cao hơn cho suy luận LLM khi hệ thống của bạn có thể tận dụng các đường dẫn độ chính xác thấp của Blackwell, đặc biệt là FP4/NVFP4, và khi băng thông bộ nhớ là nút thắt cổ chai. NVIDIA H200 thường là lựa chọn ít rủi ro hơn khi bạn cần dung lượng khả dụng, hỗ trợ phục vụ Hopper trưởng thành, hành vi FP8/BF16 ổn định và việc xác định giá hiện nay dễ dàng hơn.
Hướng dẫn này dành cho các đội AI doanh nghiệp đang so sánh dung lượng GPU đám mây cho suy luận LLM, chứ không phải cho người sưu tầm chip. Câu hỏi thực tế là: GPU nào mang lại độ trễ, thông lượng, độ tin cậy và chi phí trên mỗi đầu ra được chấp nhận tốt nhất cho mô hình, độ dài ngữ cảnh, kiểu lưu lượng và ngăn xếp phục vụ của bạn?
Kiểm tra vào ngày 13 tháng 10 năm 2026.
B200 so với H200: câu trả lời nhanh
Chọn B200 khi khối lượng công việc của bạn bị giới hạn bởi thông lượng, băng thông bộ nhớ, hoặc đã sẵn sàng cho độ chính xác thấp được tối ưu cho Blackwell. Đây là nền tảng suy luận hướng tương lai tốt hơn cho phục vụ 70B+ khối lượng lớn, các tải có ngữ cảnh dài, và những đội có thể benchmark TensorRT-LLM, FP4/NVFP4 và batching hiện đại một cách nghiêm túc trước khi cam kết dung lượng.
Chọn H200 khi bạn cần dung lượng sớm hơn, các khối lượng công việc hiện tại đã chạy tốt trên Hopper, ngăn xếp của bạn được xây dựng quanh FP8/BF16, hoặc bộ phận mua sắm cần một thị trường GPU đám mây trưởng thành hơn. H200 vẫn là một GPU suy luận LLM mạnh vì nó kết hợp độ trưởng thành của phần mềm Hopper với 141GB bộ nhớ HBM3e và băng thông bộ nhớ cao.
Phím tắt cho người mua:
| Quyết định | Điểm khởi đầu tốt hơn | Vì sao |
|---|---|---|
| Cụm suy luận LLM thông lượng cao mới | B200 | Nhiều bộ nhớ hơn trên mỗi GPU, băng thông bộ nhớ cao hơn, đường dẫn độ chính xác thấp của Blackwell, thiết kế hệ thống mới hơn. |
| Mở rộng đội hình Hopper hiện có | H200 | Duy trì vận hành dễ hơn từ H100/H200, ít thay đổi ngăn xếp hơn, công thức phục vụ trưởng thành. |
| Đánh giá FP4 hoặc NVFP4 | B200 | Blackwell được xây dựng cho đường dẫn suy luận độ chính xác thấp mới hơn. |
| Phục vụ sản xuất FP8/BF16 | H200 trước, rồi benchmark B200 | Hỗ trợ Hopper đã trưởng thành; B200 vẫn cần xác thực theo từng khối lượng công việc. |
| Dung lượng hạn chế trong giai đoạn ra mắt | Nhà cung cấp nào có thể cam kết dung lượng đáng tin cậy | Thời gian chờ và SLA có thể quan trọng hơn đỉnh GPU lý thuyết. |
| Mua sắm với rủi ro thấp nhất | H200 | Quy trình mua cloud quen thuộc hơn và có nhiều tham chiếu giá hơn. |
| Trần hiệu năng dài hạn tốt nhất | B200 | Nhiều dư địa hơn nếu phần mềm, mức sử dụng và độ sẵn sàng phù hợp. |
So sánh thông số cho suy luận LLM
Hãy dùng bảng này như bộ lọc đầu tiên, rồi tự chạy benchmark. Đừng mua B200 hoặc H200 chỉ dựa trên các con số đỉnh lý thuyết.
| Hạng mục | NVIDIA H200 | NVIDIA B200 | Vì sao điều này quan trọng với suy luận LLM |
|---|---|---|---|
| Kiến trúc | Hopper | Blackwell | B200 bổ sung các tính năng phục vụ Blackwell và tăng tốc độ chính xác thấp; H200 thừa hưởng độ trưởng thành của Hopper. |
| Dung lượng bộ nhớ | 141GB HBM3e | 180GB HBM3e trong các cấu hình SXM/DGX B200 phổ biến | Nhiều bộ nhớ hơn giúp cho các mô hình lớn hơn, cửa sổ ngữ cảnh dài hơn, KV cache lớn hơn và kích thước batch cao hơn. |
| Băng thông bộ nhớ | Tối đa 4.8TB/s | Tối đa khoảng 8TB/s trong các hệ thống lớp B200 SXM | Tạo token và các khối lượng công việc nặng về attention có thể trở thành nút thắt băng thông bộ nhớ. |
| Độ chính xác thấp | FP8, BF16, FP16, TF32 và các chế độ được hỗ trợ khác | FP4/NVFP4, FP8, BF16, FP16, TF32 và các chế độ được hỗ trợ khác | Lợi thế của B200 mạnh nhất khi mô hình và ngăn xếp phục vụ có thể dùng độ chính xác thấp của Blackwell mà không làm giảm chất lượng. |
| Độ trưởng thành của phần mềm | Hệ sinh thái Hopper rất trưởng thành | Hệ sinh thái Blackwell đang trưởng thành nhanh chóng | H200 có rủi ro áp dụng thấp hơn; B200 có thể cần benchmark và tinh chỉnh nhiều hơn. |
| Tình trạng mua sắm | Mẫu cloud H100/H200 phổ biến hơn | Mới hơn và thường bị giới hạn dung lượng hơn | Tính sẵn có có thể quyết định câu trả lời trước cả benchmark. |
Các nguồn chính nên mở khi đánh giá: NVIDIA H200, NVIDIA DGX B200, bảng dữ liệu Tensor Core GPU của NVIDIA, và tổng quan hiệu năng TensorRT-LLM.
Vì sao B200 có thể vượt H200 trong suy luận LLM
Lý do mạnh nhất để chọn B200 thay vì H200 không chỉ là năng lực tính toán thô. Đó là sự kết hợp giữa dung lượng bộ nhớ, băng thông bộ nhớ, thiết kế liên kết/hệ thống mới hơn, và suy luận độ chính xác thấp của Blackwell.
1. Nhiều dư địa bộ nhớ hơn
H200 đã có lợi thế bộ nhớ lớn so với các triển khai H100 80GB trước đây. B200 đẩy mức dư địa này xa hơn nữa. Điều đó quan trọng vì suy luận LLM trong sản xuất không chỉ là trọng số mô hình. Bạn còn cần không gian cho KV cache, phần overhead thời gian chạy, batching, bộ đệm của framework, trạng thái speculative decoding, và biên an toàn cho các prompt dài.
Đối với các mô hình cỡ 70B, một H200 được tinh chỉnh tốt có thể đã đủ. Với các mô hình lớn hơn, mức đồng thời cao hơn, cửa sổ ngữ cảnh dài hơn, hoặc các endpoint đa thuê bao, bộ nhớ bổ sung của B200 có thể giảm áp lực phân mảnh và làm cho các batch size lớn hơn trở nên khả thi hơn.
2. Băng thông bộ nhớ cao hơn
Nhiều đường suy luận LLM bị giới hạn bởi việc di chuyển dữ liệu bộ nhớ, không chỉ bởi đỉnh thông lượng tensor. Trong quá trình sinh, mỗi token có thể yêu cầu di chuyển lặp lại trọng số và dữ liệu KV-cache. Băng thông bộ nhớ cao hơn có thể cải thiện thông lượng nếu engine phục vụ, lượng tử hóa, kernel attention và chính sách batching có thể nạp dữ liệu cho GPU một cách hiệu quả.
Đó là lý do vì sao một so sánh hiệu năng B200 so với H200 nên ghi nhận cả độ trễ lẫn thông lượng. Một GPU thắng về số token tối đa mỗi giây chưa chắc thắng mục tiêu độ trễ P95 của bạn, và một GPU trông đắt theo giờ có thể rẻ hơn trên mỗi triệu token được chấp nhận nếu mức sử dụng cao.
3. Các đường dẫn độ chính xác thấp của Blackwell
B200 hấp dẫn nhất khi bạn có thể xác thực các chế độ độ chính xác được tối ưu cho Blackwell. FP4/NVFP4 có thể thay đổi đáng kể đường cong chi phí cho một số khối lượng suy luận, nhưng mức tiết kiệm không tự động có. Bạn cần kiểm thử chất lượng, hành vi từ chối, độ chính xác gọi công cụ, độ trôi khi tóm tắt, độ nhạy truy xuất và hành vi ngữ cảnh dài trước khi chuyển sang một endpoint hướng tới khách hàng.
Nếu chính sách sản xuất của bạn hiện yêu cầu BF16 hoặc FP8, H200 có thể là triển khai ban đầu dễ dự đoán hơn. Nếu bạn đang xây dựng nền tảng suy luận tiếp theo và có thể đầu tư vào hiệu chỉnh và benchmark theo từng mô hình, B200 xứng đáng có vị trí benchmark đầu tiên.
Vì sao H200 vẫn có thể là lựa chọn mua tốt hơn
H200 không phải là GPU cũ theo cách mà A100 hiện nay thường bị xem là như vậy đối với phục vụ LLM tiên tiến. Đây là một phần tử Hopper có bộ nhớ lớn, với đường dẫn phần mềm trưởng thành, mức độ quen thuộc rộng rãi với operator, và đủ bộ nhớ cho nhiều khối lượng suy luận LLM nghiêm túc.
1. Tính sẵn có có thể vượt cả hiệu năng đỉnh
"GPU tốt nhất" cũng vô dụng nếu bạn không thể đảm bảo được nó trong cửa sổ ra mắt. Trong mua sắm GPU trên đám mây, thời gian chờ, điều khoản đặt trước, phản hồi hỗ trợ, khu vực, mạng và rủi ro hủy là một phần của hiệu năng. Nếu một nhà cung cấp có thể cung cấp dung lượng H200 đáng tin cậy ngay bây giờ trong khi dung lượng B200 chỉ báo giá hoặc đang backorder, H200 có thể là quyết định kinh doanh tốt hơn.
Với mức giá hiện tại, hãy kiểm tra các trang nhà cung cấp như bảng giá RunPod, bảng giá Lambda GPU Cloud, bảng giá Vast.ai, và bảng giá Massed Compute. Hãy xem các trang đó như các kiểm tra nguồn trực tiếp, không phải bảng giá cố định.
2. Phục vụ trên Hopper đã rất quen thuộc về vận hành
Nhiều đội ngũ đã biết cách chạy vLLM, SGLang, TensorRT-LLM, TGI, Ray Serve, các operator Kubernetes, giám sát và tự động mở rộng xung quanh các GPU thuộc lớp Hopper. Điều đó làm giảm rủi ro chuyển đổi. Nếu cụm H100 hoặc H200 của bạn đã có image, kernel, ngưỡng cảnh báo, mục tiêu sử dụng và playbook xử lý sự cố đã biết là tốt, thì mở rộng H200 có thể tốt hơn một cuộc di chuyển B200 vội vàng.
3. H200 có thể đủ cho suy luận sản xuất 70B
Đối với các triển khai 7B, 8B, 14B, 32B và nhiều triển khai 70B, H200 thường có đủ bộ nhớ và thông lượng nếu khối lượng công việc được tinh chỉnh. Câu hỏi khó không phải là "H200 có thể phục vụ mô hình này không?" Câu hỏi khó là "H200 có thể phục vụ mô hình này ở độ trễ mục tiêu, độ dài ngữ cảnh, kích thước batch, mục tiêu sẵn sàng và chi phí trên mỗi câu trả lời được chấp nhận của chúng ta không?"
Nếu câu trả lời là có, thì B200 phải tự chứng minh bằng kinh tế hiệu quả được cải thiện, chứ không chỉ bằng thông số tốt hơn.
DGX B200 so với H200: hãy so sánh hệ thống, không chỉ GPU
Từ khóa "DGX B200 vs H200" thường trộn lẫn hai cấp độ so sánh:
- So sánh GPU: GPU B200 so với GPU H200.
- So sánh hệ thống: các hệ thống kiểu DGX B200 hoặc HGX B200 so với hệ thống H200.
Đối với mua sắm, cấp độ hệ thống quan trọng hơn. Một máy chủ với tám GPU B200 không chỉ là tám bộ tăng tốc tách biệt. Nó bao gồm thiết kế host CPU, bộ nhớ, kiến trúc NVLink/NVSwitch, mạng, lưu trữ, điện, làm mát, hỗ trợ của nhà cung cấp và tích hợp cụm.
Khi so sánh năng lực DGX B200 so với H200, hãy yêu cầu:
| Câu hỏi về hệ thống | Vì sao điều đó quan trọng |
|---|---|
| Số lượng GPU và form factor | Hệ thống PCIe, SXM, HGX, DGX và NVL có hiệu năng và khả năng bảo trì khác nhau. |
| Kiến trúc NVLink/NVSwitch | Suy luận tensor song song đa GPU và chia nhỏ mô hình phụ thuộc vào chất lượng liên kết nội bộ. |
| Hạ tầng mạng | Suy luận và huấn luyện đa nút cần InfiniBand, RoCE hoặc một hạ tầng tương đương được lên kế hoạch phù hợp. |
| Nguồn điện và mật độ rack | Các hệ thống B200 có thể thay đổi thiết kế rack, làm mát và thời gian triển khai. |
| Đường dẫn lưu trữ | Thời gian nạp mô hình và di chuyển checkpoint ảnh hưởng đến thời gian khởi động tính phí. |
| Hỗ trợ và SLA thay thế | Thời gian ngừng hoạt động là một phần của chi phí trên mỗi đầu ra được chấp nhận. |
Nếu một nhà cung cấp báo giá dung lượng "B200", hãy xác nhận hệ thống thực tế. Một node B200 PCIe, một node HGX B200 và một hệ thống DGX B200 không phải là các đơn vị mua sắm có thể thay thế cho nhau.
Hiệu năng B200 so với H200: cần benchmark gì
Không có benchmark công khai nào tự nó có thể trả lời quyết định B200 so với H200 của bạn. Một so sánh hiệu năng NVIDIA B200 so với H200 hữu ích cần một benchmark có thể tái lập bằng mô hình, tokenizer, phân bố ngữ cảnh, mẫu lưu lượng và ngưỡng chất lượng của bạn.
Hãy dùng ba chế độ benchmark:
| Chế độ | Điều nó chứng minh | Sai lầm thường gặp |
|---|---|---|
| Độ trễ một yêu cầu | Thời gian đến token đầu tiên và khả năng phản hồi cho từng người dùng | Tối ưu một yêu cầu rồi cho rằng nó dự đoán được thông lượng sản xuất. |
| Thông lượng bão hòa | Số token đầu ra tối đa mỗi giây dưới tải | Bỏ qua độ trễ P95/P99 và hành vi xếp hàng. |
| Tái phát trong môi trường sản xuất | Chi phí và độ trễ với độ dài prompt thực tế và mức đồng thời thực tế | Sử dụng prompt tổng hợp ngắn hơn lưu lượng người dùng thực. |
Theo dõi các trường sau:
model_id:
weights_precision:
runtime: vLLM | SGLang | TensorRT-LLM | TGI | custom
gpu: H200 | B200
gpu_count:
context_input_p50:
context_input_p95:
output_tokens_p50:
output_tokens_p95:
target_ttft_ms:
target_tpot_ms:
concurrency:
batching_policy:
kv_cache_policy:
quality_eval_suite:
hourly_gpu_cost:
tokens_per_second:
accepted_answers_per_hour:
cost_per_1m_accepted_output_tokens:
Chỉ số then chốt là chi phí trên mỗi đầu ra được chấp nhận, chứ không chỉ riêng token mỗi giây. Nếu B200 nhanh hơn nhưng chi phí trên mỗi giờ đặt trước đáng tin cậy cao hơn nhiều, H200 vẫn có thể thắng. Nếu B200 cho phép batch lớn hơn nhiều, độ chính xác thấp hơn nhưng chất lượng chấp nhận được, hoặc ít GPU hơn cho mỗi endpoint, B200 có thể thắng ngay cả khi chi phí theo giờ cao hơn.
Để có một bảng tính chi phí rộng hơn, hãy ghép benchmark này với giá thuê GPU, so sánh giá mô hình AI, và cách so sánh giá mô hình AI trước khi chuyển nhà cung cấp.
Khuyến nghị theo từng khối lượng công việc
| Khối lượng công việc | Benchmark đầu tiên tốt hơn | Lý do |
|---|---|---|
| API model nhỏ hoặc 8B, nhạy cảm với độ trễ | H200 | Khối lượng công việc có thể không cần nhiều bộ nhớ dư của B200; độ trưởng thành của phần mềm rất quan trọng. |
| Phục vụ 70B FP8/BF16 | H200 và B200 | H200 có thể đã đủ; B200 có thể thắng nếu băng thông bộ nhớ và batching chi phối. |
| Phục vụ 70B FP4 | B200 | Lộ trình độ chính xác thiên về Blackwell, nhưng việc xác thực chất lượng là bắt buộc. |
| Phục vụ model 405B hoặc rất lớn | B200 | Bộ nhớ lớn hơn và băng thông hệ thống mới hơn rất giá trị, dù topology đa GPU là yếu tố chi phối. |
| Endpoint RAG ngữ cảnh dài | B200 | Áp lực KV-cache và băng thông có thể làm B200 trở nên hấp dẫn. |
| Suy luận batch ngoại tuyến | B200 nếu mức sử dụng cao | Trần thông lượng quan trọng nếu các job giữ cho GPU luôn bão hòa. |
| Suy luận hướng tới khách hàng với lưu lượng bùng nổ | H200 hoặc API model trước | Phần công suất B200 nhàn rỗi có thể rất tốn kém nếu lưu lượng tăng giảm thất thường. |
| Nền tảng H100/H200 hiện có | Ưu tiên mở rộng H200 | Tính liên tục vận hành có thể tốt hơn việc di chuyển sang một stack mới. |
Danh sách kiểm tra giá và tính sẵn có
Đừng so sánh B200 với H200 chỉ dựa trên giá theo giờ. Hãy so sánh kinh tế của khối lượng công việc đã hoàn thành.
| Trường | Ghi nhận H200 | Ghi nhận B200 |
|---|---|---|
| Nhà cung cấp | Cloud, marketplace, cụm dedicated, hệ thống colocated | Cloud, marketplace, cụm dedicated, hệ thống colocated |
| Chế độ hợp đồng | Theo nhu cầu, reserved, committed, private cluster | Theo nhu cầu, reserved, committed, private cluster |
| Hệ thống thực tế | H200 PCIe, H200 SXM, H200 NVL, DGX/HGX | B200 PCIe, B200 SXM, HGX, DGX B200, tùy chọn GB200 |
| Khu vực | Độ trễ, quy định dữ liệu, tính sẵn có | Độ trễ, quy định dữ liệu, tính sẵn có |
| Chi phí theo giờ hoặc theo tháng | Bao gồm lưu trữ, hỗ trợ, egress, thời gian nhàn rỗi | Bao gồm lưu trữ, hỗ trợ, egress, thời gian nhàn rỗi |
| Mức sử dụng | Thời gian GPU hoạt động thực tế | Thời gian GPU hoạt động thực tế |
| Chi phí lỗi và thử lại | OOM, bị thu hồi, image lỗi, sự cố mạng | OOM, lỗi di chuyển, lỗi tinh chỉnh |
| Tỷ lệ đầu ra được chấp nhận | Câu trả lời, token, job, hoặc yêu cầu vượt QA | Câu trả lời, token, job, hoặc yêu cầu vượt QA |
Với mua sắm, hãy yêu cầu nhà cung cấp báo giá theo cùng một đơn vị khối lượng công việc:
Vui lòng báo giá dung lượng cho:
- model và độ chính xác
- lưu lượng mục tiêu
- phân phối token đầu vào/đầu ra
- độ trễ P95 mục tiêu
- khu vực yêu cầu
- thời hạn cam kết
- hỗ trợ/SLA
- giả định về lưu trữ và mạng
- chi phí dự kiến trên mỗi 1 triệu token đầu ra được chấp nhận
Dòng cuối cùng đó rất quan trọng. Nếu nhà cung cấp không thể giúp quy đổi chi phí GPU sang chi phí đầu ra, đội của bạn sẽ phải tự gánh toàn bộ rủi ro mô hình hóa.
Khi cả B200 lẫn H200 đều không phải là câu trả lời đúng
Đôi khi câu trả lời đúng không phải là một cụm GPU. Nếu mức sử dụng thấp, nhu cầu tăng vọt thất thường, sản phẩm thường xuyên thay đổi model, hoặc đội ngũ không muốn vận hành hạ tầng phục vụ, thì một API model có thể rẻ hơn và nhanh hơn so với thuê GPU.
Flatkey nằm ở phía API của quyết định đó. Nó cung cấp cho các đội ngũ một khóa, một số dư, một hóa đơn và một sổ ghi sử dụng trên hơn 300 mô hình chính thức và hơn 1.000 công cụ. Nếu bảng tính B200 so với H200 của bạn cho thấy mức sử dụng thấp hoặc chi phí vận hành cao, hãy so sánh một lộ trình API mô hình trước khi ký hợp đồng cluster. Về quản trị, ngân sách và kiểm soát định tuyến, xem định giá AI gateway, quản lý chi tiêu AI API, và kiểm soát hạn ngạch AI API.
Điều này không có nghĩa là API mô hình luôn vượt trội hơn GPU. Nó có nghĩa là quyết định về GPU nên được đo lường so với một phương án API bằng cùng một chỉ số đầu ra được chấp nhận.
Khuyến nghị cuối cùng
Đối với hầu hết các đội ngũ AI doanh nghiệp, câu trả lời thực tế cho B200 so với H200 là:
- Bắt đầu với H200 nếu bạn cần năng lực đáng tin cậy một cách nhanh chóng, đã chạy Hopper sẵn rồi, hoặc phục vụ khối lượng công việc FP8/BF16 với công cụ trưởng thành.
- Bắt đầu với B200 nếu bạn đang xây dựng một nền tảng suy luận LLM thông lượng cao mới, có thể xác thực chất lượng FP4/NVFP4, và có thể đảm bảo đủ năng lực để giữ cho GPU được tận dụng ở mức cao.
- Đừng cam kết với bất kỳ GPU nào cho đến khi bạn benchmark chi phí trên mỗi đầu ra được chấp nhận bằng chính các prompt, độ dài ngữ cảnh và mức đồng thời thực tế của bạn.
Nếu B200 có sẵn với mức giá cam kết hợp lý và ngăn xếp phần mềm của bạn có thể khai thác Blackwell, đây là nền tảng suy luận LLM dài hạn mạnh hơn. Nếu tính sẵn có, giá cả và rủi ro vận hành là yếu tố quyết định mua hàng, H200 vẫn là một lựa chọn rất đáng tin cậy và thường thực tế hơn.
Câu hỏi thường gặp
B200 có tốt hơn H200 cho suy luận LLM không?
B200 thường tốt hơn cho các khối lượng công việc suy luận LLM có thông lượng cao nhất, phụ thuộc nhiều vào băng thông bộ nhớ, được tối ưu cho Blackwell. H200 có thể tốt hơn khi độ trưởng thành của phần mềm Hopper, năng lực sẵn có ngay lập tức và mức giá dự đoán được quan trọng hơn.
Khác biệt lớn nhất về hiệu năng giữa NVIDIA B200 và H200 là gì?
Khác biệt lớn nhất về hiệu năng giữa NVIDIA B200 và H200 là sự kết hợp giữa bộ nhớ lớn hơn của B200, băng thông bộ nhớ cao hơn và hỗ trợ độ chính xác thấp của Blackwell. Mức chênh lệch thực tế phụ thuộc vào kích thước mô hình, độ chính xác, công cụ phục vụ, batching và mục tiêu độ trễ.
Tôi nên chọn H200 hay B200 cho một mô hình 70B?
Với H200 so với B200 cho một mô hình 70B, hãy benchmark cả hai nếu có thể. H200 có thể đã đủ cho phục vụ FP8/BF16 với công cụ trưởng thành. B200 hấp dẫn hơn cho mức đồng thời cao, ngữ cảnh dài, hoặc phục vụ FP4/NVFP4 sau khi đã xác thực chất lượng.
DGX B200 so với H200 có thay đổi câu trả lời không?
Có. DGX B200 so với H200 là một quyết định ở cấp hệ thống, không chỉ là quyết định về GPU. Hãy so sánh số lượng GPU, topology NVLink/NVSwitch, mạng, điện năng rack, làm mát, lưu trữ, hỗ trợ và các điều khoản năng lực cam kết.
B200 có luôn rẻ hơn trên mỗi token so với H200 không?
Không. B200 có thể rẻ hơn trên mỗi token khi được sử dụng ở mức cao và ngăn xếp phục vụ tận dụng Blackwell hiệu quả. H200 có thể rẻ hơn khi giá theo giờ của B200, thời gian xếp hàng, công sức di chuyển, hoặc tình trạng sử dụng thấp bù trừ cho lợi thế hiệu năng.
Tôi nên đo gì trước khi mua năng lực B200 hoặc H200?
Hãy đo thời gian đến token đầu tiên, số token mỗi giây đầu ra, độ trễ P95/P99, số câu trả lời được chấp nhận mỗi giờ, mức sử dụng GPU, tỷ lệ lỗi, chi phí khởi động lại, lưu trữ, egress, hỗ trợ và chi phí trên mỗi 1 triệu token đầu ra được chấp nhận.


