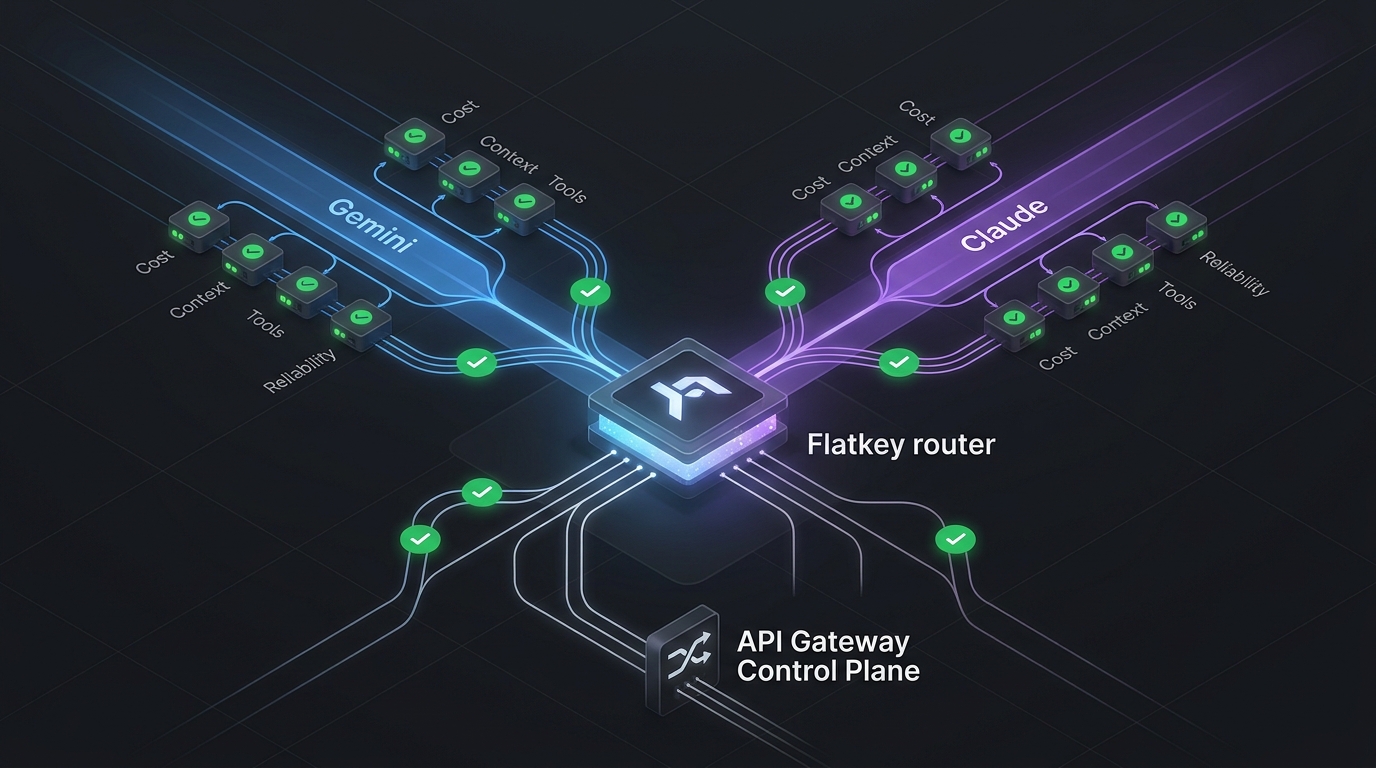
Jika Anda membandingkan Gemini dan Claude untuk alur kerja API, jangan berhenti pada "model mana yang lebih baik." Dalam produksi, pertanyaan yang lebih tepat adalah: rute mana yang sebaiknya menerima kelas permintaan ini, apa yang harus terjadi saat gagal, dan bagaimana Anda akan membuktikan biaya serta kualitas hasil setelah panggilan?
Itulah tugas praktis dari Routing API Gemini vs Claude: Biaya, Konteks, Tools, dan Pemeriksaan Keandalan. Gemini dan Claude sama-sama mendukung beban kerja aplikasi yang serius, tetapi keduanya membuat trade-off yang berbeda dalam unit harga, jendela konteks, pemanggilan tool, output terstruktur, pemrosesan batch, caching, batas rate, dan verifikasi operasional. Kebijakan routing harus membuat trade-off tersebut eksplisit sebelum trafik dipindahkan.
Panduan ini memberi tim daftar periksa berbasis sumber untuk memutuskan kapan harus merutekan ke Gemini, kapan harus merutekan ke Claude, dan kapan menempatkan keduanya di belakang gateway yang kompatibel dengan OpenAI seperti Flatkey. Gunakan ini sebelum migrasi, peluncuran agen, tinjauan biaya prompt, atau rollout fallback.
Jika Anda masih memilih pola gateway itu sendiri, padukan artikel ini dengan panduan Flatkey tentang menggunakan API AI terpadu dan menggunakan alternatif API OpenAI. Jika pertanyaan utamanya adalah pengukuran, mulailah dengan framework metrik API routing AI terlebih dahulu.
Jawaban singkat untuk routing API Gemini vs Claude
Gunakan Gemini sebagai rute pertama ketika beban kerja sensitif terhadap harga, ber-konteks besar, multimodal, atau cocok untuk batch dan set evaluasi Anda mengonfirmasi kualitas output yang dapat diterima. Gunakan Claude sebagai rute pertama ketika beban kerja membutuhkan penalaran panjang yang kuat, kepatuhan instruksi yang cermat, penggunaan tool dengan keyakinan tinggi, atau fitur agen khusus Anthropic. Gunakan rute gateway ketika aplikasi harus berganti model tanpa menulis ulang kode SDK, membandingkan log penggunaan di satu tempat, atau menyiapkan fallback yang telah diuji dan siap digunakan.
| Pertanyaan routing | Rute Gemini biasanya menarik ketika... | Rute Claude biasanya menarik ketika... | Periksa sebelum produksi |
|---|---|---|---|
| Biaya | Tugas dapat menggunakan model gaya Flash / Flash-Lite, diskon batch, atau unit input multimodal yang lebih murah. | Tugas membenarkan tarif per-token yang lebih tinggi melalui acceptance rate yang lebih baik, retry yang lebih sedikit, atau biaya review yang lebih rendah. | Normalisasikan ke biaya per output yang diterima, bukan harga input yang tercantum. |
| Konteks | Anda memerlukan konteks luas untuk dokumen, codebase, transkrip, atau paket retrieval. | Anda memerlukan penalaran konteks panjang dengan lini model Claude saat ini dan batas outputnya. | Uji recall, disiplin sitasi, latensi, dan mode kegagalan pada ukuran konteks yang nyata. |
| Tools | Anda memerlukan function calling plus opsi ekosistem tool native Google. | Anda memerlukan pola penggunaan tool Claude untuk agent, client tools, server tools, dan pemanggilan tool terstruktur. | Jalankan skema tool yang sama dan verifikasi argumen, retry, serta panggilan yang tidak valid. |
| Output terstruktur | Anda memerlukan kepatuhan JSON Schema untuk alur aplikasi bertipe. | Anda memerlukan kontrol output JSON atau pola penggunaan tool yang ketat untuk kepatuhan skema. | Validasi output yang diparse terhadap skema Anda, bukan hanya kebenaran visual. |
| Keandalan | Anda dapat menyerap variabilitas rate limit provider dengan queueing atau fallback. | Anda dapat menyerap batas Anthropic dan overhead token tool dengan kontrol rollout. | Catat provider, model, jumlah token, latensi, status, dan alasan fallback. |
Singkatnya: pemenangnya jarang "Gemini" atau "Claude" secara global. Pemenangnya adalah rute yang lolos pemeriksaan spesifik beban kerja Anda dengan biaya output yang diterima paling rendah dan kejutan operasional yang paling sedikit.
Normalisasikan biaya sebelum membandingkan harga model
Bagian tersulit dari Routing API Gemini vs Claude adalah halaman harga tidak disusun dengan cara yang sama. Google mencantumkan harga Gemini berdasarkan model, moda, unit input/output, mode batch, dan terkadang tier konteks. Anthropic mencantumkan harga Claude berdasarkan keluarga model, token input/output, prompt caching, pemrosesan batch, dan overhead token spesifik fitur.
Mulailah dengan lembar kerja biaya, bukan perdebatan:
| Bidang biaya | Mengapa ini penting |
|---|---|
| Input tokens | Prompt panjang, dokumen yang diambil kembali, skema tool, dan instruksi sistem dapat mendominasi biaya permintaan. |
| Output tokens | Rencana agen, diff kode, payload JSON, dan ringkasan dapat menggeser biaya ke token completion. |
| Cache write dan cache read | Prompt caching Claude dapat mengubah ekonomi untuk konteks berulang; context caching Gemini perlu diperiksa ketika konteks berulang bersifat material. |
| Diskon batch | Google dan Anthropic sama-sama mendokumentasikan diskon pemrosesan batch, tetapi batch hanya membantu ketika respons tertunda dapat diterima. |
| Overhead tool | Definisi tool, skema, dan panggilan tool antara menambah token. Anthropic secara eksplisit mendokumentasikan biaya token seputar penggunaan tool; payload tool Gemini juga perlu akuntansi token yang terukur. |
| Retry rate | Model yang lebih murah bisa menjadi mahal jika validasi menolak lebih banyak output. |
| Biaya review manusia | Untuk alur kerja support, legal, finance, atau code-review, acceptance rate bisa lebih penting daripada harga token mentah. |
Untuk Gemini, biarkan halaman harga Gemini API tetap terbuka saat menyusun worksheet. Per saat pengecekan sumber ini, Google mencantumkan harga berbeda untuk Gemini Flash, Flash-Lite, Pro, batch, dan kasus bertingkat konteks, termasuk baris Gemini 3.x dan Gemini 2.5 yang lebih baru. Untuk Claude, gunakan halaman harga Claude dari Anthropic dan perhitungkan tier model, prompt caching, perilaku konteks panjang, dan pemrosesan batch.
Untuk pekerjaan pricing yang lebih mendalam, gunakan panduan Flatkey tentang harga Gemini API dan harga Claude API sebagai pendamping, lalu bawa angka final kembali ke worksheet routing ini.
Metrik routing seharusnya:
accepted_output_cost =
  (input_cost + output_cost + cache_write_cost + cache_read_cost + tool_overhead_cost + retry_cost)
  / accepted_outputs
Rumus itu mencegah kesalahan umum: memilih harga input terendah yang tercantum sambil mengabaikan output yang lebih panjang, JSON yang tidak valid, retry tool, atau pembersihan manual.
Periksa window konteks dengan payload nyata
Klaim window konteks memang berguna, tetapi itu tidak sama dengan konteks yang benar-benar dapat digunakan. Sebuah model bisa menerima konteks besar dan tetap melewatkan instruksi yang tersembunyi, kehilangan jejak entitas, melambat melebihi SLA Anda, atau menghasilkan respons yang tidak bisa divalidasi.
Halaman model Gemini dari Google mendokumentasikan opsi model konteks panjang, termasuk Gemini 2.5 Flash dengan window konteks 1M token. Gambaran umum model Claude dari Anthropic mendokumentasikan konteks dan batas output model Claude saat ini, termasuk konteks 1M token untuk beberapa model saat ini dan window yang lebih kecil untuk route kelas Haiku. Angka-angka ini penting, tetapi keputusan routing harus berasal dari pengujian.
Jalankan paket konteks yang sama melalui route kandidat:
- Prompt singkat tanpa konteks yang diambil kembali.
- Prompt sedang dengan paket retrieval yang umum.
- Prompt p90 dengan konteks pelanggan nyata atau basis kode.
- Prompt kasus terburuk yang mendekati batas Anda.
- Prompt terdegradasi dengan potongan retrieved yang tidak relevan.
Untuk setiap run, catat:
| Metrik konteks | Apa yang harus dicatat |
|---|---|
| Tingkat jawaban yang diterima | Apakah jawaban lolos rubrik Anda atau validator downstream? |
| Latensi pada p50 / p90 / p99 | Apakah prompt panjang tetap berada di dalam SLA produk? |
| Kegagalan lost-in-context | Apakah model mengabaikan fakta berposisi rendah, batasan tool, atau instruksi akhir? |
| Perubahan panjang output | Apakah konteks panjang menyebabkan verbositas yang tidak perlu atau output terpotong? |
| Biaya per output yang diterima | Apakah prompt yang lebih besar sepadan dengan biayanya? |
Jika Gemini menangani konteks penuh dengan biaya murah tetapi membutuhkan lebih banyak retry, arahkan tugas yang lebih sempit ke sana dan gunakan Claude untuk penalaran berisiko tinggi. Jika Claude menghasilkan acceptance yang lebih tinggi pada paket konteks panjang yang sama, harga token mentahnya yang lebih tinggi mungkin tetap lebih murah setelah biaya review dan retry.
Bandingkan pemanggilan tool dan output terstruktur secara langsung
Beban kerja agen biasanya gagal dengan cara yang membosankan: argumen yang salah format, enum yang dibuat-buat, key ekstra di JSON, pemanggilan tool pada waktu yang salah, atau respons yang terlihat bagus tetapi tidak bisa diparse. Itulah sebabnya Routing API Gemini vs Claude membutuhkan pemeriksaan tool dan schema, bukan hanya skor benchmark.
Google mendokumentasikan function calling untuk menghubungkan model Gemini ke tool dan mengembalikan parameter, serta structured output untuk respons berbasis JSON Schema. Anthropic mendokumentasikan Claude tool use untuk tool client dan server serta structured outputs untuk respons berorientasi schema.
Gunakan satu test harness bersama:
| Uji | Perilaku yang lulus |
|---|---|
| Pemanggilan tool yang diwajibkan | Model memanggil tool yang benar dan tidak menjawab langsung. |
| Skenario tanpa tool | Model menolak memanggil tool ketika informasi yang cukup sudah tersedia. |
| Field enum | Model hanya mengembalikan nilai enum yang diizinkan. |
| Objek bertingkat | Model mengisi field bertingkat yang wajib tanpa menambahkan field yang tidak didukung. |
| Kesalahan tool | Model mencoba lagi, meminta data yang hilang, atau gagal dengan baik sesuai kebijakan. |
| Streaming | Output parsial tidak merusak parser atau pengalaman pengguna Anda. |
| Upaya injeksi | Model mengikuti kebijakan sistem dan tool, bukan teks retrieved yang bersifat hostile. |
Jangan menilai jawaban bahasa alami terlebih dahulu. Parse output, validasi JSON, inspeksi argumen tool, lalu nilai jawaban. Route yang menghasilkan prosa paling menarik tetap bisa menjadi route yang salah untuk agen jika menyebabkan lebih banyak tindakan yang tidak valid.
Gunakan batch dan caching hanya di tempat alur kerja mengizinkannya
Kedua penyedia mendokumentasikan mekanisme penghematan biaya yang dapat mengubah keputusan routing.
Batch API Google dirancang untuk permintaan asinkron bervolume besar dan mendokumentasikan target biaya standar 50% untuk beban kerja batch yang memenuhi syarat. Dokumentasi Message Batches Anthropic juga menjelaskan pengurangan biaya 50% untuk pemrosesan batch, dengan sebagian besar batch selesai dalam waktu kurang dari satu jam serta batas ukuran permintaan yang didokumentasikan.
Batch adalah pilihan yang kuat untuk:
- Klasifikasi offline.
- Backfill.
- Pelabelan dataset.
- Jalankan evaluasi skala besar.
- Generasi laporan mingguan.
- Ringkasan yang tidak mendesak.
Batch adalah pilihan yang kurang cocok untuk:
- Turn chat.
- Dukungan realtime.
- Loop internal coding agent.
- Retry yang berhadapan langsung dengan pengguna.
- Alur kerja apa pun di mana output yang usang mahal biayanya.
Caching memiliki bentuk yang berbeda. Jika prompt Anda berulang pada kebijakan besar, peta codebase, katalog produk, atau template kontrak, pembacaan cache dapat membuat rute yang berkualitas lebih tinggi menjadi masuk akal secara ekonomi. Jika prompt sebagian besar unik, caching mungkin tidak membantu. Untuk Claude, halaman harga Anthropic mencakup pengali write dan read untuk prompt cache; untuk Gemini, periksa dokumentasi context-caching dan baris harga terkini sebelum berasumsi penghematannya berlaku untuk beban kerja Anda.
Aturan routing harus sederhana:
route_policy:
  realtime_user_request:
    primary: low_latency_model_that_passes_schema_tests
    fallback: safest_validated_model
    batch: false
  offline_backfill:
    primary: lowest_accepted_output_cost
    fallback: retry_later_or_second_provider
    batch: true
  repeated_context_agent:
    primary: best_cache_adjusted_acceptance_rate
    fallback: model_with_shorter_context_pack
    batch: false
Pemeriksaan keandalan sebelum route Gemini atau Claude aktif
Status penyedia dan batas yang dipublikasikan hanyalah titik awal. Google mendokumentasikan batas rate Gemini berdasarkan dimensi seperti permintaan per menit, token input per menit, permintaan per hari, dan batas berbasis pengeluaran, dengan batas diterapkan per project dan kapasitas aktual tidak dijamin. Dokumentasi Anthropic menjelaskan harga model, konteks, tools, caching, dan batas batch yang memengaruhi berapa banyak panggilan yang dapat didorong alur kerja Anda dengan aman.
Sebelum traffic produksi dipindahkan, jalankan daftar periksa route:
| Pemeriksaan | Apa yang perlu diverifikasi |
|---|---|
| Autentikasi | Kunci provider langsung atau kunci gateway dicakup untuk lingkungan yang tepat. |
| ID model | ID model yang tepat masih terbaru dan didukung oleh rute akun. |
| Bentuk request | Pesan, tools, skema JSON, streaming, dan field modality cocok dengan rute. |
| Batas rate | Jenis traffic tetap berada dalam batas RPM, TPM, harian, dan pengeluaran. |
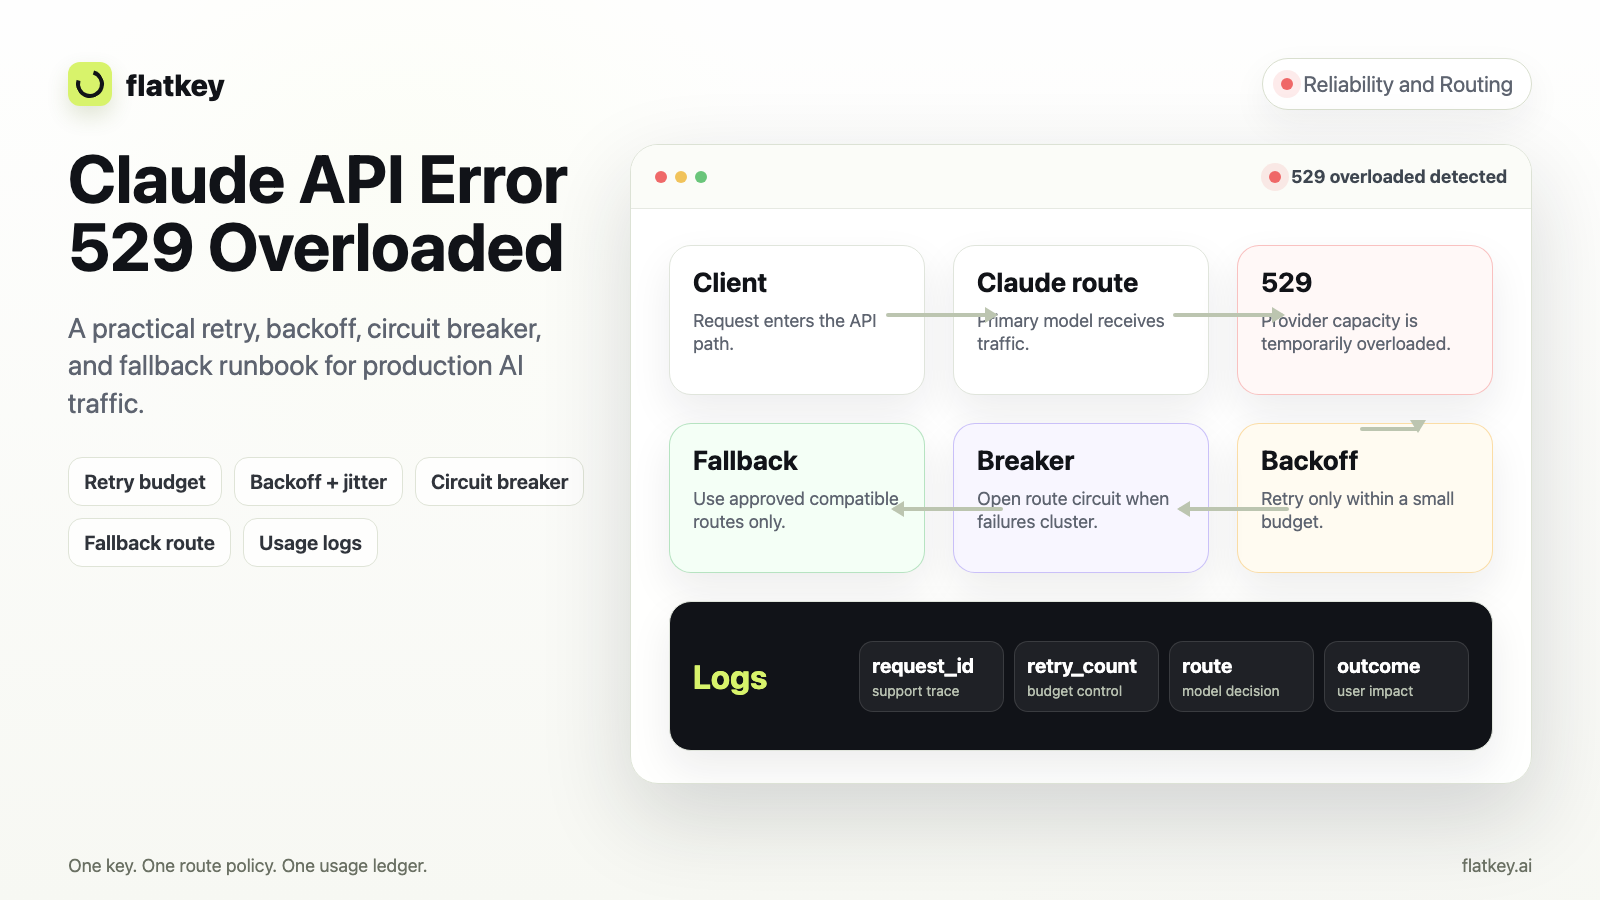
| Pemetaan error | Kondisi 400, 401, 403, 429, 5xx, timeout, dan provider-overloaded dipetakan ke perilaku aplikasi yang dapat ditindaklanjuti. |
| Kebijakan fallback | Aplikasi mengetahui kapan harus retry rute yang sama, beralih provider, mengantre, atau fail closed. |
| Log biaya | Setiap request mencatat model, jumlah token, penggunaan cache, mode batch, latensi, status, dan biaya. |
| Validator output | Produk memiliki validator untuk JSON, panggilan tool, sitasi, atau kebenaran khusus tugas. |
quickstart Flatkey menunjukkan pola SDK OpenAI: pertahankan SDK dan ubah base_url menjadi https://router.flatkey.ai/v1. Ikhtisar Flatkey REST API mendokumentasikan base URL yang kompatibel dengan OpenAI yang sama, dan indeks dokumentasi Flatkey menjelaskan satu key, satu saldo bersama, satu katalog model, dan dokumentasi untuk GPT, Claude, Gemini, DeepSeek, serta model lainnya. Setelah request pertama, quickstart Flatkey memberi tahu pengguna untuk memeriksa Usage Logs untuk model, jumlah token, latensi, dan biaya.
Itu membuat Flatkey berguna dalam rollout routing: Anda dapat menjaga format request aplikasi tetap stabil, membandingkan perilaku rute Gemini dan Claude di usage logs, dan mempromosikan fallback yang telah diuji tanpa menyebarkan kunci provider ke seluruh layanan.
Untuk pola perencanaan rute yang berdekatan, bandingkan alur kerja ini dengan checklist Gemini API untuk agen dari Flatkey dan artikel pemeriksaan routing API DeepSeek vs Qwen.
Scorecard routing yang praktis
Gunakan scorecard ini untuk keputusan akhir. Beri setiap baris skor 1-5 untuk Gemini dan Claude, lalu beri bobot berdasarkan workload.
| Kriteria | Bobot | Skor Gemini | Skor Claude | Catatan |
|---|---|---|---|---|
| Biaya output yang diterima | 25% | Termasuk retry, cache, batch, dan overhead tool. | ||
| Validitas schema | 15% | Hitung kegagalan parser dan nilai enum yang tidak valid. | ||
| Presisi panggilan tool | 15% | Hitung tool yang salah, field yang hilang, dan penggunaan tool yang tidak perlu. | ||
| Keandalan konteks | 15% | Uji pada ukuran prompt p50, p90, dan skenario terburuk. | ||
| Latensi | 10% | Ukur latensi streaming dan respons penuh. | ||
| Cadangan batas rate-limit | 10% | Periksa batas project/account sebelum peluncuran. | ||
| Pemulihan kegagalan | 10% | Verifikasi jalur retry, fallback, dan review manusia. |
Misalnya:
- Pipeline ringkasan latar belakang mungkin memberi bobot tertinggi pada biaya output yang diterima dan dukungan batch.
- Agen coding mungkin memberi bobot tertinggi pada presisi panggilan tool, latensi, dan keandalan konteks.
- Workflow dukungan pelanggan mungkin memberi bobot tertinggi pada validitas schema, perilaku eskalasi, dan biaya review.
Output dari Routing API Gemini vs Claude seharusnya berupa file kebijakan, bukan notulen rapat.
routes:
  support_triage:
    primary: gemini-or-claude-route-that-wins-scorecard
    fallback: second-provider-route
    validator: support_ticket_schema_v3
    retry_limit: 1
    fail_closed_when:
      - missing_required_field
      - unsafe_escalation_label
  code_review_agent:
    primary: route-that-wins-tool-and-context-tests
    fallback: route-with-best-safe-summary
    validator: diff_comment_schema_v2
    retry_limit: 0
    fail_closed_when:
      - tool_argument_invalid
      - repository_path_not_in_context
Cara menjalankan perbandingan Flatkey yang aman
Flatkey bukan pengganti evaluasi. Ini adalah control plane yang memudahkan evaluasi dan peluncuran.
- Pilih satu beban kerja, seperti triase dukungan, komentar code review, ringkasan laporan, atau ekstraksi.
- Buat set beku berisi 50-200 prompt nyata dengan aturan output yang diharapkan.
- Pilih satu rute Gemini dan satu rute Claude dari katalog model saat ini.
- Kirim keduanya melalui format request yang kompatibel dengan OpenAI jika memungkinkan.
- Catat jumlah token, latensi, status, penyedia, model, biaya, dan hasil validator.
- Bandingkan biaya per output yang diterima, bukan harga per satu juta token.
- Rilis pemenang sebagai primary dan simpan yang lain sebagai fallback yang dimonitor.
- Jalankan ulang pengujian setelah harga penyedia, ID model, batas konteks, atau kesehatan rute berubah.
Di sinilah gateway membuktikan nilainya. Jika aplikasi sudah menggunakan klien yang kompatibel dengan OpenAI, Flatkey dapat membuat pengujian pertama sesederhana perubahan base_url plus perubahan pemilihan model. Jika rute gagal, Anda melakukan rollback pada kebijakan rute alih-alih menulis ulang kode aplikasi.
Kesalahan umum dalam Routing API Gemini vs Claude
Kesalahan 1: Membandingkan hanya model flagship.
Sebagian besar alur kerja produksi tidak membutuhkan model paling mahal untuk setiap permintaan. Bandingkan kelas route: cepat, murah, konteks panjang, berat penalaran, batch, dan fallback.
Kesalahan 2: Mengabaikan skema tool.
Prompt agen sering menyertakan definisi tool yang besar. Ukur token tersebut dan validasi argumen tool.
Kesalahan 3: Menganggap jendela konteks sebagai kualitas jawaban.
Jendela konteks yang lebih besar hanya berguna jika model secara andal menggunakan bagian yang tepat dari konteks tersebut.
Kesalahan 4: Lupa semantik fallback.
Model fallback bisa lebih buruk daripada tanpa fallback jika mengubah bentuk output, melewati tool yang diwajibkan, atau melanggar kebijakan produk.
Kesalahan 5: Menerbitkan route tanpa tinjauan log penggunaan.
Log Anda harus menampilkan model aktual, jumlah token, latensi, status, biaya, dan alasan fallback. Jika bidang-bidang itu tidak ada, Anda tidak dapat men-debug route saat beban tinggi.
FAQ
Apakah Gemini lebih murah daripada Claude?
Terkadang, tetapi tidak selalu setelah validasi. Gemini sering memiliki tarif yang tercantum menarik untuk workload gaya Flash, sementara Claude bisa menang ketika tingkat penerimaan yang lebih tinggi, retry yang lebih sedikit, perilaku tool yang lebih baik, atau biaya peninjauan yang lebih rendah mengimbangi tarif token yang lebih tinggi. Gunakan halaman harga penyedia dan hitung biaya per output yang diterima.
Apakah Claude lebih baik daripada Gemini untuk tool calling?
Tidak secara universal. Claude memiliki dokumentasi penggunaan tool yang kuat dan pola berorientasi agen, sementara Gemini mendukung function calling dan structured outputs. Jawaban yang tepat bergantung pada skema tool Anda, penanganan error, kebutuhan streaming, dan hasil validator.
Haruskah saya merutekan setiap permintaan melalui satu penyedia terlebih dahulu?
Biasanya tidak. Pisahkan traffic berdasarkan kelas workload. Route batch yang murah, route chat real-time, route konteks panjang, dan route fallback mungkin semuanya menggunakan model yang berbeda.
Apakah API batch membuat route real-time lebih murah?
Tidak. Diskon batch membantu workload yang tertunda. Diskon tersebut tidak membantu pengguna yang menunggu respons chat, support, atau coding-agent.
Mengapa menggunakan Flatkey untuk Routing API Gemini vs Claude?
Gunakan Flatkey ketika Anda menginginkan satu control plane yang kompatibel dengan OpenAI untuk pemilihan model, log penggunaan, peninjauan biaya, dan rollout fallback. Ini sangat berguna ketika sebuah aplikasi sudah menggunakan SDK bergaya OpenAI dan perlu membandingkan Gemini dan Claude tanpa menyebarkan kunci penyedia dan tampilan penagihan ke berbagai layanan.
Kesimpulan
Routing API Gemini vs Claude: Biaya, Konteks, Tools, dan Pemeriksaan Keandalan bukanlah perbandingan vendor sekali jalan. Ini adalah workflow operasional. Mulailah dengan harga resmi dan dokumentasi model, uji perilaku konteks dan tool pada prompt nyata, nilai biaya per output yang diterima, dan siapkan kebijakan fallback sebelum traffic produksi berpindah.
Jika tim Anda ingin membandingkan Gemini dan Claude melalui satu gateway yang kompatibel dengan OpenAI, mulailah dengan quickstart Flatkey, pilih kandidat route dari katalog model saat ini, dan verifikasi panggilan pertama di Usage Logs sebelum memperluas traffic.