Если вы сравниваете Gemini и Claude для API-воркфлоу, не останавливайтесь на вопросе «какая модель лучше». В продакшене более важный вопрос: какой маршрут должен получать этот класс запросов, что должно происходить при сбое и как вы докажете стоимость и качество результата после вызова?
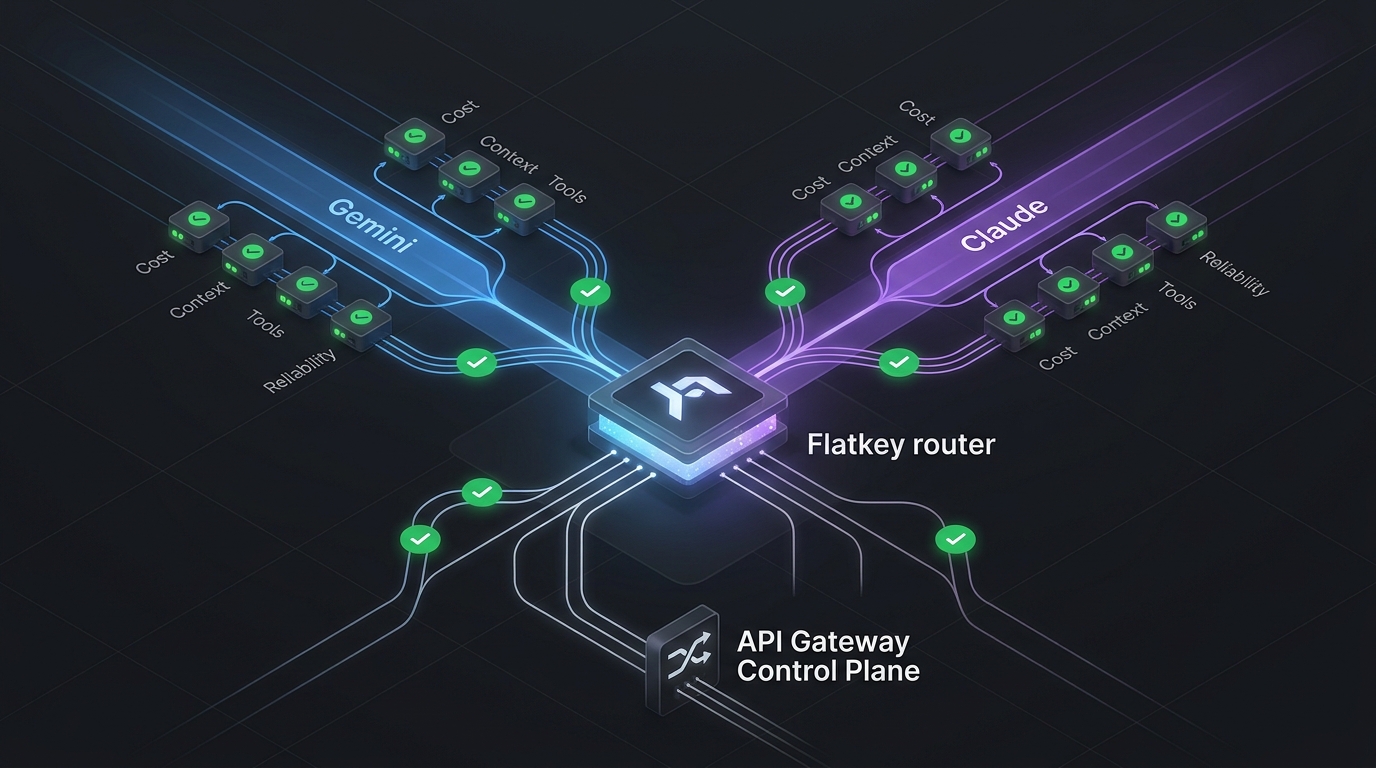
Именно в этом и заключается практическая задача маршрутизации API Gemini vs Claude: стоимость, контекст, инструменты и проверки надежности. Gemini и Claude оба поддерживают серьезные прикладные нагрузки, но предлагают разные компромиссы по ценовым единицам, окнам контекста, вызову инструментов, структурированному выводу, пакетной обработке, кэшированию, ограничениям по скорости запросов и операционной проверке. Политика маршрутизации должна явно учитывать эти компромиссы до того, как трафик будет перенаправлен.
Это руководство дает командам основанный на источниках чек-лист для принятия решения, когда маршрутизировать запросы в Gemini, когда — в Claude, а когда — ставить обе модели за OpenAI-совместимым шлюзом, таким как Flatkey. Используйте его перед миграцией, запуском агента, проверкой стоимости промптов или развертыванием fallback-сценария.
Если вы все еще выбираете сам шаблон шлюза, сочетайте эту статью с руководствами Flatkey по использованию единого AI API и использованию альтернативы OpenAI API. Если главный вопрос — измерение, начните сначала с фреймворка метрик API маршрутизации ИИ.
Краткий ответ для маршрутизации API Gemini vs Claude
Используйте Gemini как первый маршрут, когда нагрузка чувствительна к цене, требует большого контекста, мультимодальна или хорошо подходит для пакетной обработки, и когда ваш набор оценок подтверждает приемлемое качество вывода. Используйте Claude как первый маршрут, когда нагрузке нужны сильные возможности длинного рассуждения, аккуратное следование инструкциям, надежное использование инструментов или специфичные для Anthropic функции агентов. Используйте маршрут через шлюз, когда приложению нужно переключать модели без переписывания SDK-кода, сравнивать журналы использования в одном месте или держать готовый протестированный fallback.
| Вопрос маршрутизации | Маршрут Gemini обычно привлекателен, когда... | Маршрут Claude обычно привлекателен, когда... | Проверьте перед запуском в производство |
|---|---|---|---|
| Стоимость | Задача может использовать модели в стиле Flash / Flash-Lite, скидки за пакетную обработку или более дешёвые единицы мультимодального ввода. | Задача оправдывает более высокие ставки за токен за счёт лучшего процента принятия, меньшего числа повторных попыток или более низкой стоимости проверки. | Нормализуйте до стоимости на принятый результат, а не к указанной цене ввода. |
| Контекст | Вам нужен широкий контекст для документов, кодовых баз, транскриптов или пакетов для поиска. | Вам нужно рассуждение на длинном контексте с текущей линейкой моделей Claude и ограничениями на выход. | Проверьте запоминание, дисциплину цитирования, задержку и режим отказа на реальных размерах контекста. |
| Инструменты | Вам нужны вызовы функций плюс варианты экосистемы инструментов Google-native. | Вам нужны шаблоны использования инструментов Claude для агентов, клиентских инструментов, серверных инструментов и структурированных вызовов инструментов. | Запустите ту же схему инструментов и проверьте аргументы, повторы и недопустимые вызовы. |
| Структурированный вывод | Вам требуется соблюдение JSON Schema для типизированных потоков приложения. | Вам нужны средства управления JSON-выводом или строгие шаблоны использования инструментов для соответствия схеме. | Проверяйте разобранный вывод по вашей схеме, а не только визуальную корректность. |
| Надёжность | Вы можете компенсировать вариативность ограничений по скорости у провайдера с помощью очередей или резервного варианта. | Вы можете компенсировать лимиты Anthropic и накладные расходы на токены инструментов с помощью контроля развёртывания. | Логируйте провайдера, модель, количество токенов, задержку, статус и причину перехода на резервный вариант. |
Короче говоря: победитель редко бывает «Gemini» или «Claude» в глобальном смысле. Побеждает тот маршрут, который проходит ваши проверки, специфичные для рабочей нагрузки, с наименьшей стоимостью за принятый результат и с наименьшим операционным сюрпризом.
Нормализуйте стоимость перед сравнением цен моделей
Самая сложная часть маршрутизации API Gemini vs Claude заключается в том, что страницы с ценами оформлены не одинаково. Google указывает цены Gemini по модели, модальности, единице ввода/вывода, режиму пакетной обработки и иногда по уровню контекста. Anthropic указывает цены Claude по семейству моделей, токенам ввода/вывода, кэшированию промптов, пакетной обработке и накладным расходам токенов, связанным с конкретными функциями.
Начните с таблицы расчёта стоимости вместо спора:
| Поле стоимости | Почему это важно |
|---|---|
| Токены входа | Длинные промпты, извлечённые документы, схемы инструментов и системные инструкции могут определять основную часть стоимости запроса. |
| Токены выхода | Планы агента, диффы кода, JSON-нагрузки и сводки могут смещать стоимость в сторону токенов завершения. |
| Запись в кэш и чтение из кэша | Кэширование промптов Claude может менять экономику для повторяющегося контекста; кэширование контекста Gemini следует проверять, когда повторяющийся контекст имеет существенное значение. |
| Скидка за batch | И Google, и Anthropic документируют скидки за пакетную обработку, но batch помогает только тогда, когда допустима задержка ответов. |
| Накладные расходы на инструменты | Определения инструментов, схемы и промежуточные вызовы инструментов добавляют токены. Anthropic явно документирует стоимость токенов при использовании инструментов; для полезных нагрузок инструментов Gemini также нужен измеряемый учёт токенов. |
| Частота повторных попыток | Более дешёвая модель может оказаться дорогой, если валидация отклоняет больше выходных данных. |
| Стоимость ручной проверки | Для поддержки, юридических, финансовых или workflow проверки кода доля принятых результатов может быть важнее, чем цена токена сама по себе. |
Для Gemini держите страницу ценообразования Gemini API открытой во время составления таблицы. На момент этой проверки источника Google указывает разные цены для Gemini Flash, Flash-Lite, Pro, batch и случаев с поуровневым контекстом, включая более новые строки Gemini 3.x и Gemini 2.5. Для Claude используйте страницу Anthropic ценообразование Claude и учитывайте уровни моделей, кэширование промптов, поведение при длинном контексте и пакетную обработку.
Для более глубокой работы с ценами используйте руководство Flatkey по ценообразованию Gemini API и руководство по ценообразованию Claude API как дополнение, а затем верните финальные цифры в эту таблицу маршрутизации.
Метрика маршрутизации должна быть такой:
accepted_output_cost =
  (input_cost + output_cost + cache_write_cost + cache_read_cost + tool_overhead_cost + retry_cost)
  / accepted_outputs
Эта формула предотвращает распространённую ошибку: выбирать более низкую указанную цену входа, игнорируя более длинные выходы, невалидный JSON, повторные попытки инструментов или ручную очистку.
Проверяйте окна контекста на реальных полезных нагрузках
Заявления об окне контекста полезны, но это не то же самое, что доступный контекст. Модель может принять большой контекст и всё же пропустить скрытую инструкцию, потерять нить сущности, замедлиться сверх вашего SLA или выдать ответ, который нельзя валидировать.
Страница Google моделей Gemini документирует варианты моделей с длинным контекстом, включая Gemini 2.5 Flash с окном контекста в 1M токенов. Обзор моделей Anthropic Claude models overview документирует текущие лимиты контекста и вывода моделей Claude, включая контекст в 1M токенов для нескольких текущих моделей и меньшее окно для маршрутов класса Haiku. Эти числа важны, но решение о маршрутизации должно приниматься на основе тестов.
Прогоняйте один и тот же пакет контекста через кандидатов-маршруты:
- Короткий запрос без извлечённого контекста.
- Средний запрос с типичным пакетом извлечённых данных.
- Запрос p90 с реальным контекстом клиента или кодовой базы.
- Худший сценарий запроса почти на пределе лимита.
- Деградировавший запрос с нерелевантными извлечёнными фрагментами.
Для каждого прогона фиксируйте:
| Метрика контекста | Что фиксировать |
|---|---|
| Доля принятых ответов | Прошёл ли ответ ваш рубрикатор или downstream-валидатор? |
| Задержка на p50 / p90 / p99 | Уложился ли длинный запрос в SLA продукта? |
| Сбои lost-in-context | Игнорировала ли модель факты с низкой позиции, ограничения инструментов или финальные инструкции? |
| Отклонение длины вывода | Привёл ли длинный контекст к ненужной многословности или обрезанному выводу? |
| Стоимость на принятый вывод | Окупился ли более крупный запрос? |
Если Gemini обрабатывает весь контекст дёшево, но требует больше повторных попыток, направляйте туда более узкие задачи и оставьте Claude для высокорискового рассуждения. Если Claude показывает более высокий уровень принятия на том же наборе длинного контекста, его более высокая номинальная цена за токен всё равно может оказаться ниже после учёта затрат на проверку и повторные попытки.
Сравнивайте вызов инструментов и структурированные ответы напрямую
Нагрузки агентных систем обычно ломаются из-за скучных вещей: некорректного аргумента, выдуманного enum, лишнего ключа в JSON, вызова инструмента не в то время или ответа, который выглядит хорошо, но не может быть распарсен. Именно поэтому маршрутизация API Gemini vs Claude требует проверок инструментов и схем, а не только результатов бенчмарков.
Google документирует function calling для подключения моделей Gemini к инструментам и возврата параметров, а также structured output для ответов на основе JSON Schema. Anthropic документирует Claude tool use для клиентских и серверных инструментов и structured outputs для ответов, ориентированных на схему.
Используйте один общий тестовый harness:
| Тест | Проходящее поведение |
|---|---|
| Обязательный вызов инструмента | Модель вызывает правильный инструмент и не отвечает напрямую. |
| Случай без инструмента | Модель отказывается вызывать инструмент, когда уже достаточно информации. |
| Поле enum | Модель возвращает только разрешённые значения enum. |
| Вложенный объект | Модель заполняет обязательные вложенные поля, не добавляя неподдерживаемые поля. |
| Ошибка инструмента | Модель повторяет попытку, запрашивает недостающие данные или корректно завершает работу согласно политике. |
| Стриминг | Частичный вывод не ломает ваш парсер или пользовательский опыт. |
| Попытка инъекции | Модель следует системной политике и политике инструмента вместо враждебного извлечённого текста. |
Не оценивайте сначала ответ на естественном языке. Сначала распарсите вывод, проверьте JSON, изучите аргументы инструмента, затем оценивайте ответ. Маршрут, который даёт самый привлекательный текст, всё равно может оказаться неверным маршрутом для агента, если он приводит к большему числу недопустимых действий.
Используйте batch и caching только там, где это позволяет рабочий процесс
Оба провайдера документируют механики экономии, которые могут изменить решение о маршрутизации.
Batch API от Google предназначен для асинхронных запросов большого объема и указывает целевой показатель стандартной стоимости на уровне 50% для подходящих пакетных нагрузок. Документация Anthropic по Message Batches также описывает снижение стоимости пакетной обработки на 50%, при этом большинство пакетов завершаются менее чем за один час и есть документированные ограничения на размер запросов.
Batch хорошо подходит для:
- Офлайн-классификации.
- Дозаполнения исторических данных.
- Разметки датасетов.
- Крупных прогонов оценивания.
- Еженедельной генерации отчетов.
- Не срочного суммирования.
Batch плохо подходит для:
- Чатов.
- Поддержки в реальном времени.
- Внутренних циклов кодирующего агента.
- Повторных попыток для пользовательского интерфейса.
- Любого рабочего процесса, где устаревший вывод дорого обходится.
Кэширование устроено иначе. Если ваши промпты многократно повторяют крупную политику, карту кодовой базы, каталог продуктов или шаблон контракта, чтение из кэша может сделать маршрут более высокого качества экономически оправданным. Если промпты в основном уникальны, кэширование может не помочь. Для Claude на странице цен Anthropic указаны множители записи и чтения кэша промптов; для Gemini проверьте актуальную документацию по кэшированию контекста и строку с ценами, прежде чем считать, что экономия применима к вашей нагрузке.
Правило маршрутизации должно быть простым:
route_policy:
  realtime_user_request:
    primary: low_latency_model_that_passes_schema_tests
    fallback: safest_validated_model
    batch: false
  offline_backfill:
    primary: lowest_accepted_output_cost
    fallback: retry_later_or_second_provider
    batch: true
  repeated_context_agent:
    primary: best_cache_adjusted_acceptance_rate
    fallback: model_with_shorter_context_pack
    batch: false
Проверки надежности перед запуском маршрута Gemini или Claude
Статус провайдера и опубликованные лимиты — это только отправные точки. Google документирует rate limits Gemini по таким параметрам, как запросы в минуту, токены ввода в минуту, запросы в день и лимиты, зависящие от расходов; при этом лимиты применяются на уровне проекта, а фактическая доступная мощность не гарантируется. В документации Anthropic описаны ограничения на цену модели, контекст, инструменты, кэширование и batch-обработку, которые влияют на то, сколько вызовов ваш рабочий процесс может безопасно отправлять.
Перед переносом production-трафика запустите чек-лист маршрута:
| Проверка | Что проверить |
|---|---|
| Аутентификация | Прямой ключ провайдера или ключ шлюза привязан к нужной среде. |
| Model ID | Точный идентификатор модели актуален и поддерживается маршрутом аккаунта. |
| Структура запроса | Поля сообщений, инструментов, JSON-схемы, потоковой передачи и модальности соответствуют маршруту. |
| Ограничения по скорости | Класс трафика остается в пределах ограничений RPM, TPM, дневных лимитов и бюджета. |
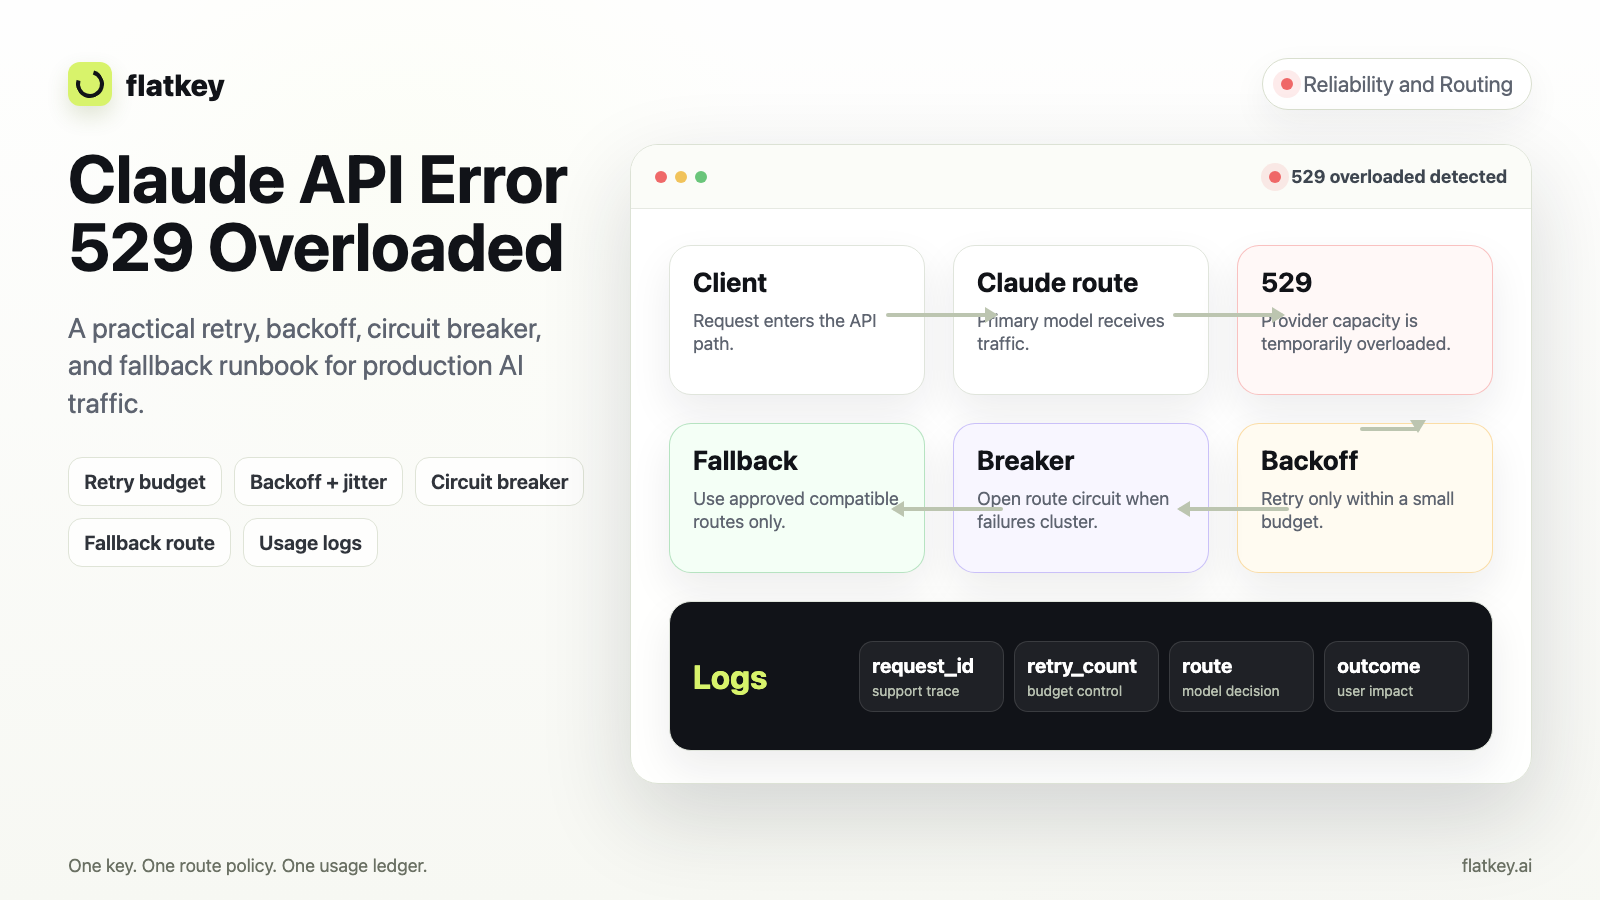
| Сопоставление ошибок | Случаи 400, 401, 403, 429, 5xx, таймаута и перегрузки провайдера сопоставляются с действиями приложения. |
| Политика fallback | Приложение знает, когда повторить запрос по тому же маршруту, переключить провайдера, поставить в очередь или завершить с закрытой ошибкой. |
| Журнал затрат | Каждый запрос записывает модель, количество токенов, использование кэша, batch-режим, задержку, статус и стоимость. |
| Валидатор результата | У продукта есть валидатор для JSON, вызовов инструментов, цитат или проверки корректности для конкретной задачи. |
В quickstart Flatkey показан шаблон SDK OpenAI: оставьте SDK и измените base_url на https://router.flatkey.ai/v1. В обзоре REST API Flatkey описан тот же совместимый с OpenAI базовый URL, а индекс документации Flatkey описывает один ключ, единый общий баланс, единый каталог моделей и документацию для GPT, Claude, Gemini, DeepSeek и других моделей. После первого запроса quickstart Flatkey предлагает пользователям проверять Usage Logs на наличие модели, количества токенов, задержки и стоимости.
Это делает Flatkey полезным при внедрении маршрутизации: можно сохранить стабильный формат запросов приложения, сравнивать поведение маршрутов Gemini и Claude в журналах использования и подключать протестированный fallback без разброса ключей провайдеров по сервисам.
Для смежных шаблонов планирования маршрутов сравните этот рабочий процесс с чек-листом Flatkey по Gemini API для агентов и статьей проверки маршрутизации API DeepSeek vs Qwen.
Практическая оценочная карта маршрутизации
Используйте эту оценочную карту для окончательного решения. Поставьте каждой строке оценку от 1 до 5 для Gemini и Claude, затем взвесьте по рабочей нагрузке.
| Критерий | Вес | Оценка Gemini | Оценка Claude | Примечания |
|---|---|---|---|---|
| Стоимость принятого вывода | 25% | Учитывайте повторы, кэш, batch и накладные расходы инструментов. | ||
| Корректность схемы | 15% | Подсчитывайте ошибки парсера и недопустимые значения enum. | ||
| Точность вызова инструментов | 15% | Подсчитывайте неверный инструмент, отсутствующее поле и ненужное использование инструмента. | ||
| Надежность контекста | 15% | Тестируйте при размерах запросов p50, p90 и в худшем случае. | ||
| Задержка | 10% | Измеряйте задержку потоковой передачи и полного ответа. | ||
| Запас по лимитам rate limit | 10% | Проверьте лимиты проекта/аккаунта до запуска. | ||
| Восстановление после сбоев | 10% | Проверьте пути повторной попытки, резервного перехода и ручной проверки. |
Например:
- В фоновом конвейере суммаризации можно сильнее всего взвесить стоимость принятого вывода и поддержку batch.
- В кодирующем агенте можно сильнее всего взвесить точность вызова инструментов, задержку и надежность контекста.
- В рабочем процессе поддержки клиентов можно сильнее всего взвесить корректность схемы, поведение при эскалации и стоимость проверки.
Результатом Gemini vs Claude API Routing должна быть policy-файл, а не протокол встречи.
routes:
  support_triage:
    primary: gemini-or-claude-route-that-wins-scorecard
    fallback: second-provider-route
    validator: support_ticket_schema_v3
    retry_limit: 1
    fail_closed_when:
      - missing_required_field
      - unsafe_escalation_label
  code_review_agent:
    primary: route-that-wins-tool-and-context-tests
    fallback: route-with-best-safe-summary
    validator: diff_comment_schema_v2
    retry_limit: 0
    fail_closed_when:
      - tool_argument_invalid
      - repository_path_not_in_context
Как провести безопасное сравнение Flatkey
Flatkey — не замена оценке. Это control plane, который упрощает оценку и внедрение.
- Выберите одну рабочую нагрузку, например triage обращений в поддержку, комментарии к code review, суммаризацию отчетов или извлечение данных.
- Соберите зафиксированный набор из 50–200 реальных запросов с правилами ожидаемого вывода.
- Выберите один маршрут Gemini и один маршрут Claude из текущего каталога моделей.
- По возможности отправляйте оба через один и тот же OpenAI-compatible формат запроса.
- Логируйте количество токенов, задержку, статус, провайдера, модель, стоимость и результат валидатора.
- Сравнивайте стоимость за принятый вывод, а не цену за миллион токенов.
- Выпустите победителя как primary и сохраните другой как отслеживаемый fallback.
- Повторяйте тест после изменений цен у провайдера, идентификаторов моделей, лимитов контекста или здоровья маршрута.
Именно здесь gateway оправдывает себя. Если приложение уже использует OpenAI-compatible клиент, Flatkey может сделать первый тест таким же маленьким, как изменение base_url плюс изменение выбора модели. Если маршрут не проходит, вы откатываете policy маршрута вместо переписывания кода приложения.
Распространенные ошибки в Gemini vs Claude API Routing
Ошибка 1: сравнение только флагманских моделей.
Большинству production-процессов не нужна самая дорогая модель для каждого запроса. Сравнивайте классы маршрутов: быстрый, дешёвый, с длинным контекстом, с упором на reasoning, пакетный и резервный.
Ошибка 2: игнорирование схем инструментов.
Промпты агентов часто включают большие определения инструментов. Измеряйте эти токены и валидируйте аргументы инструментов.
Ошибка 3: воспринимать размер окна контекста как качество ответа.
Большее окно контекста полезно только тогда, когда модель надёжно использует нужные его части.
Ошибка 4: забывать о семантике fallback.
Резервная модель может быть хуже, чем отсутствие fallback, если она меняет форму вывода, пропускает обязательные инструменты или нарушает политику продукта.
Ошибка 5: публиковать маршрут без проверки логов использования.
В ваших логах должны быть фактическая модель, количество токенов, задержка, статус, стоимость и причина fallback. Если этих полей нет, вы не сможете отладить маршрут под нагрузкой.
FAQ
Gemini дешевле, чем Claude?
Иногда, но не всегда после валидации. У Gemini часто привлекательные указанные тарифы для нагрузок в стиле Flash, тогда как Claude может выигрывать, если более высокий процент принятия, меньше повторных попыток, лучшее поведение с инструментами или более низкая стоимость проверки компенсируют более высокую цену за токены. Используйте страницы с ценами провайдера и рассчитывайте стоимость на один принятый результат.
Claude лучше, чем Gemini, для вызова инструментов?
Не во всех случаях. У Claude сильная документация по использованию инструментов и agent-oriented паттерны, тогда как Gemini поддерживает function calling и структурированные ответы. Правильный ответ зависит от вашей схемы инструментов, обработки ошибок, потребностей в streaming и результатов валидатора.
Стоит ли пропускать каждый запрос сначала через одного провайдера?
Обычно нет. Разделяйте трафик по классу нагрузки. Дешёвый batch-роут, роут для чата в реальном времени, роут для длинного контекста и резервный роут могут использовать разные модели.
Сделают ли batch API маршруты для реального времени дешевле?
Нет. Скидки batch помогают отложенным задачам. Они не помогают пользователю, который ждёт ответ чата, поддержки или coding-agent.
Зачем использовать Flatkey для маршрутизации API Gemini vs Claude?
Используйте Flatkey, когда вам нужна одна OpenAI-compatible control plane для выбора модели, логов использования, проверки стоимости и rollout fallback. Это особенно полезно, когда приложение уже использует SDK в стиле OpenAI и нужно сравнивать Gemini и Claude, не распыляя ключи провайдеров и представления биллинга по разным сервисам.
Заключение
Маршрутизация API Gemini vs Claude: стоимость, контекст, инструменты и проверки надежности — это не разовое сравнение поставщиков. Это операционный процесс. Начните с официальных страниц цен и документации моделей, протестируйте контекст и поведение инструментов на реальных промптах, оцените стоимость на один принятый результат и подготовьте политику fallback до того, как production-трафик будет перенесён.
Если вашей команде нужно сравнить Gemini и Claude через один OpenAI-compatible gateway, начните с Flatkey quickstart, выберите кандидатов маршрутов из текущего каталога моделей и проверьте первые вызовы в Usage Logs, прежде чем расширять трафик.