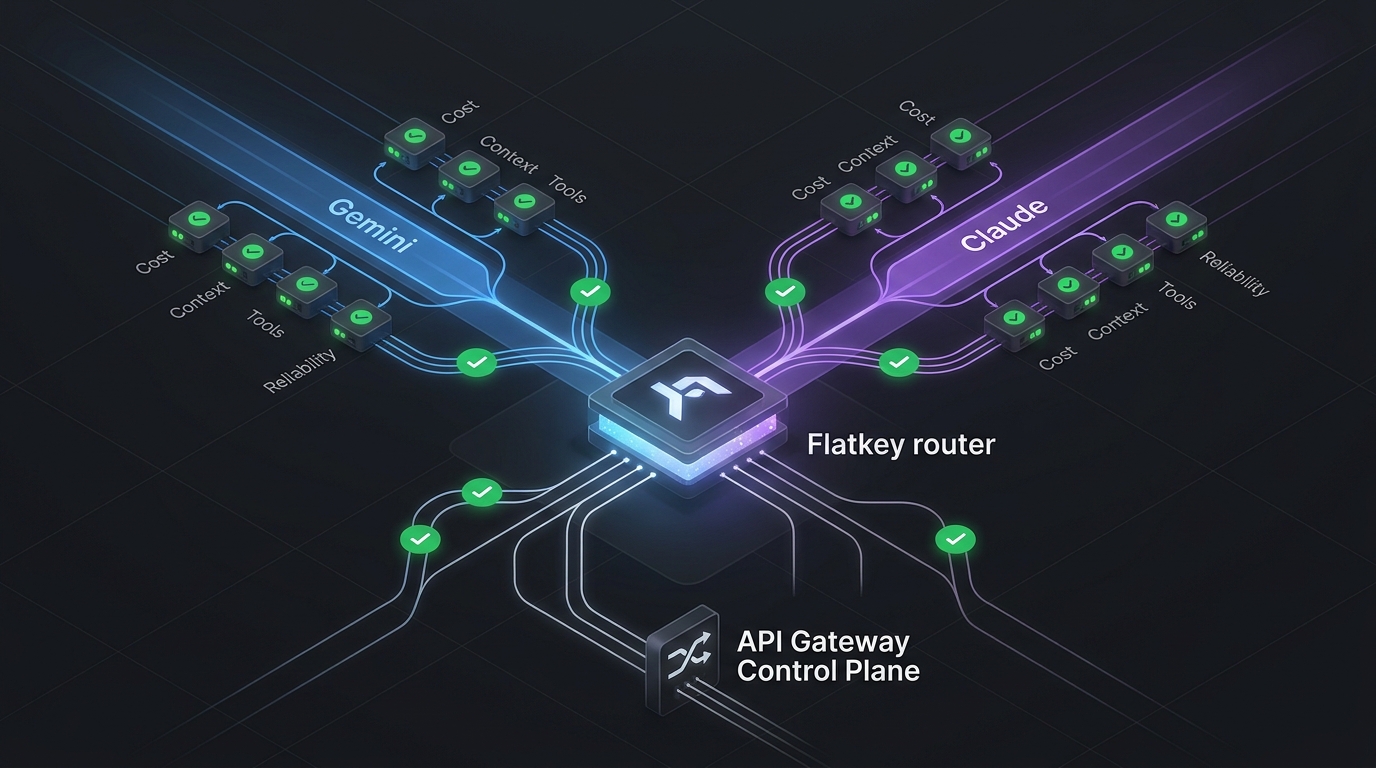
Si está comparando Gemini y Claude para un flujo de trabajo de API, no se detenga en «qué modelo es mejor». En producción, la mejor pregunta es: ¿qué ruta debe recibir esta clase de solicitud, qué debe ocurrir cuando falle y cómo demostrará el costo y la calidad del resultado después de la llamada?
Ese es el trabajo práctico de Routing de API Gemini vs Claude: costo, contexto, herramientas y comprobaciones de fiabilidad. Gemini y Claude ambos admiten cargas de trabajo de aplicaciones serias, pero hacen diferentes concesiones en unidades de precio, ventanas de contexto, llamada a herramientas, salida estructurada, procesamiento por lotes, caché, límites de velocidad y verificación operativa. Una política de ruta debería hacer explícitas esas concesiones antes de mover el tráfico.
Esta guía ofrece a los equipos una lista de verificación respaldada por fuentes para decidir cuándo enrutar a Gemini, cuándo enrutar a Claude y cuándo poner ambos detrás de una pasarela compatible con OpenAI, como Flatkey. Úsela antes de una migración, un lanzamiento de agente, una revisión del costo de prompts o un despliegue de fallback.
Si todavía está eligiendo el propio patrón de pasarela, combine este artículo con las guías de Flatkey sobre cómo usar una API unificada de IA y cómo usar una alternativa a la API de OpenAI. Si la pregunta principal es la medición, empiece primero con el marco de métricas de API de routing de IA.
La respuesta rápida para el routing de API Gemini vs Claude
Use Gemini as the first route when the workload is price-sensitive, large-context, multimodal, or batch-friendly and your evaluation set confirms acceptable output quality. Use Claude as the first route when the workload needs strong long-form reasoning, careful instruction following, high-confidence tool use, or Anthropic-specific agent features. Use a gateway route when the application should switch models without rewriting SDK code, compare usage logs in one place, or keep a tested fallback ready.
| Pregunta de enrutamiento | La ruta Gemini suele ser atractiva cuando... | La ruta Claude suele ser atractiva cuando... | Verificar antes de producción |
|---|---|---|---|
| Costo | La tarea puede usar modelos estilo Flash / Flash-Lite, descuentos por lotes o unidades de entrada multimodal más baratas. | La tarea justifica tarifas por token más altas gracias a una mejor tasa de aceptación, menos reintentos o menor costo de revisión. | Normalice al costo por salida aceptada, no al precio de entrada publicado. |
| Contexto | Necesita un contexto amplio para documentos, bases de código, transcripciones o paquetes de recuperación. | Necesita razonamiento de contexto largo con la línea de modelos actual de Claude y límites de salida. | Pruebe la recuperación, la disciplina de citación, la latencia y el modo de fallo en tamaños de contexto reales. |
| Herramientas | Necesita llamadas a funciones además de opciones del ecosistema de herramientas nativas de Google. | Necesita patrones de uso de herramientas de Claude para agentes, herramientas del cliente, herramientas del servidor y llamadas estructuradas a herramientas. | Ejecute el mismo esquema de herramientas y verifique argumentos, reintentos y llamadas inválidas. |
| Salida estructurada | Necesita cumplimiento de JSON Schema para flujos de aplicación tipados. | Necesita controles de salida JSON o patrones estrictos de uso de herramientas para cumplir con el esquema. | Valide la salida analizada frente a su esquema, no solo la corrección visual. |
| Fiabilidad | Puede absorber la variabilidad de los límites de tasa del proveedor con colas o fallback. | Puede absorber los límites de Anthropic y el sobrecoste de tokens de herramientas con controles de despliegue. | Registre proveedor, modelo, recuentos de tokens, latencia, estado y motivo del fallback. |
En resumen: el ganador rara vez es "Gemini" o "Claude" a nivel global. El ganador es la ruta que supera las comprobaciones específicas de su carga de trabajo con el menor costo por salida aceptada y la menor sorpresa operativa.
Normalice el costo antes de comparar precios de modelos
La parte más difícil del enrutamiento de API Gemini vs Claude es que las páginas de precios no tienen la misma estructura. Google enumera los precios de Gemini por modelo, modalidad, unidad de entrada/salida, modo batch y, a veces, nivel de contexto. Anthropic enumera los precios de Claude por familia de modelos, tokens de entrada/salida, caché de prompts, procesamiento por lotes y sobrecoste de tokens específico de la función.
Comience con una hoja de cálculo de costos en lugar de un debate:
| Campo de costo | Por qué importa |
|---|---|
| Tokens de entrada | Los prompts largos, los documentos recuperados, los esquemas de herramientas y las instrucciones del sistema pueden dominar el costo de la solicitud. |
| Tokens de salida | Los planes del agente, los diffs de código, los payloads JSON y los resúmenes pueden desplazar el costo hacia los tokens de finalización. |
| Escritura de caché y lectura de caché | El caché de prompts de Claude puede cambiar la economía para contextos repetidos; se debe revisar el caché de contexto de Gemini cuando el contexto repetido sea relevante. |
| Descuento por lote | Google y Anthropic documentan descuentos por procesamiento por lotes, pero el lote solo ayuda cuando las respuestas demoradas son aceptables. |
| Sobrecoste de herramientas | Las definiciones de herramientas, los esquemas y las llamadas intermedias a herramientas añaden tokens. Anthropic documenta explícitamente los costos de tokens en torno al uso de herramientas; los payloads de herramientas de Gemini también necesitan una contabilidad de tokens medida. |
| Tasa de reintentos | Un modelo más barato puede volverse caro si la validación rechaza más salidas. |
| Costo de revisión humana | Para flujos de trabajo de soporte, legales, financieros o de revisión de código, la tasa de aceptación puede importar más que el precio bruto por token. |
Para Gemini, mantén abierta la página de precios de la API de Gemini mientras construyes la hoja de trabajo. A partir de esta revisión de la fuente, Google enumera precios diferentes para Gemini Flash, Flash-Lite, Pro, batch y casos con niveles de contexto, incluidas las filas más nuevas de Gemini 3.x y Gemini 2.5. Para Claude, usa la página de precios de Claude de Anthropic y ten en cuenta los niveles de modelo, el caché de prompts, el comportamiento de contexto largo y el procesamiento por lotes.
Para un trabajo de precios más profundo, usa las guías de Flatkey sobre precios de la API de Gemini y precios de la API de Claude como complementos, y luego vuelve a traer las cifras finales a esta hoja de trabajo de routing.
La métrica de routing debería ser:
accepted_output_cost =
  (input_cost + output_cost + cache_write_cost + cache_read_cost + tool_overhead_cost + retry_cost)
  / accepted_outputs
Esa fórmula evita un error común: elegir el precio de entrada listado más bajo e ignorar salidas más largas, JSON inválido, reintentos de herramientas o limpieza manual.
Verifica las ventanas de contexto con payloads reales
Las afirmaciones sobre la ventana de contexto son útiles, pero no son lo mismo que contexto utilizable. Un modelo puede aceptar un contexto grande y aun así pasar por alto una instrucción enterrada, perder el rastro de una entidad, ralentizarse más allá de tu SLA o producir una respuesta que no pueda validarse.
La página de modelos de Gemini de Google documenta opciones de modelos de contexto largo, incluido Gemini 2.5 Flash con una ventana de contexto de 1M tokens. La descripción general de modelos de Claude de Anthropic documenta los límites actuales de contexto y salida de los modelos Claude, incluido un contexto de 1M tokens para varios modelos actuales y una ventana más pequeña para las rutas de clase Haiku. Estas cifras importan, pero la decisión de routing debería venir de pruebas.
Ejecuta el mismo paquete de contexto a través de las rutas candidatas:
- Un prompt corto sin contexto recuperado.
- Un prompt mediano con el paquete de recuperación típico.
- Un prompt p90 con contexto real de cliente o de base de código.
- Un prompt de peor caso cerca de tu límite.
- Un prompt degradado con fragmentos recuperados irrelevantes.
Para cada ejecución, registra:
| Métrica de contexto | Qué capturar |
|---|---|
| Tasa de respuesta aceptada | ¿La respuesta pasó tu rúbrica o validador posterior? |
| Latencia en p50 / p90 / p99 | ¿El prompt largo se mantuvo dentro del SLA del producto? |
| Fallos de pérdida de contexto | ¿El modelo ignoró hechos en posiciones bajas, restricciones de herramientas o instrucciones finales? |
| Deriva de longitud de salida | ¿El contexto largo provocó verbosidad innecesaria o salida truncada? |
| Costo por salida aceptada | ¿El prompt más grande valió la pena? |
Si Gemini maneja todo el contexto de forma económica pero necesita más reintentos, enruta allí las tareas más acotadas y reserva Claude para el razonamiento de alto riesgo. Si Claude produce una mayor aceptación con el mismo paquete de contexto largo, su precio bruto por token más alto puede seguir siendo más barato después de los costos de revisión y reintento.
Compara directamente las llamadas a herramientas y las salidas estructuradas
Las cargas de trabajo de agentes suelen fallar de formas aburridas: un argumento mal formado, un enum inventado, una clave extra en JSON, una llamada a una herramienta hecha en el momento equivocado, o una respuesta que parece buena pero no se puede analizar. Por eso el Routing de API Gemini vs Claude necesita comprobaciones de herramientas y de esquema, no solo puntuaciones de benchmark.
Google documenta function calling para conectar modelos Gemini con herramientas y devolver parámetros, y structured output para respuestas basadas en JSON Schema. Anthropic documenta Claude tool use para herramientas de cliente y servidor y structured outputs para respuestas orientadas a esquemas.
Usa un único banco de pruebas compartido:
| Prueba | Comportamiento de aprobación |
|---|---|
| Llamada a herramienta requerida | El modelo llama a la herramienta correcta y no responde directamente. |
| Caso sin herramienta | El modelo se niega a llamar a una herramienta cuando ya hay suficiente información presente. |
| Campo enum | El modelo devuelve solo los valores enum permitidos. |
| Objeto anidado | El modelo completa los campos anidados obligatorios sin añadir campos no admitidos. |
| Error de herramienta | El modelo reintenta, pide los datos faltantes o falla con elegancia según la política. |
| Streaming | La salida parcial no rompe tu analizador ni la experiencia de usuario. |
| Intento de inyección | El modelo sigue la política del sistema y de la herramienta en lugar del texto recuperado hostil. |
No califiques primero la respuesta en lenguaje natural. Analiza la salida, valida el JSON, inspecciona los argumentos de la herramienta y luego califica la respuesta. La ruta que produce la prosa más atractiva aún puede ser la ruta incorrecta para un agente si provoca más acciones inválidas.
Usa batch y caching solo donde el flujo de trabajo lo permita
Ambos proveedores documentan mecanismos de ahorro de costos que pueden cambiar una decisión de enrutamiento.
La Batch API de Google está diseñada para solicitudes asíncronas de gran volumen y documenta un objetivo de costo estándar del 50% para cargas de trabajo por lotes elegibles. La documentación de Message Batches de Anthropic también describe una reducción del 50% en el costo del procesamiento por lotes, con la mayoría de los lotes completándose en menos de una hora y límites de tamaño de solicitud documentados.
Batch es una buena opción para:
- Clasificación offline.
- Rellenos de datos históricos.
- Etiquetado de conjuntos de datos.
- Ejecuciones de evaluación a gran escala.
- Generación de informes semanales.
- Resumido no urgente.
Batch es una mala opción para:
- Turnos de chat.
- Soporte en tiempo real.
- Bucle interno de agentes de codificación.
- Reintentos orientados al usuario.
- Cualquier flujo de trabajo en el que una salida desactualizada resulte costosa.
El almacenamiento en caché tiene una forma distinta. Si tus prompts repiten una política extensa, un mapa de la base de código, un catálogo de productos o una plantilla de contrato, las lecturas desde caché pueden hacer económicamente razonable una ruta de mayor calidad. Si los prompts son en su mayoría únicos, es posible que la caché no ayude. Para Claude, la página de precios de Anthropic incluye multiplicadores de escritura y lectura de caché de prompt; para Gemini, revisa la documentación actual de almacenamiento en caché de contexto y la fila de precios antes de asumir que los ahorros se aplican a tu carga de trabajo.
La regla de enrutamiento debe ser simple:
route_policy:
  realtime_user_request:
    primary: low_latency_model_that_passes_schema_tests
    fallback: safest_validated_model
    batch: false
  offline_backfill:
    primary: lowest_accepted_output_cost
    fallback: retry_later_or_second_provider
    batch: true
  repeated_context_agent:
    primary: best_cache_adjusted_acceptance_rate
    fallback: model_with_shorter_context_pack
    batch: false
Comprobaciones de fiabilidad antes de que una ruta de Gemini o Claude entre en producción
El estado del proveedor y los límites publicados son solo puntos de partida. Google documenta los límites de tasa de Gemini por dimensiones como solicitudes por minuto, tokens de entrada por minuto, solicitudes por día y límites basados en gasto, con límites aplicados por proyecto y capacidad real no garantizada. La documentación de Anthropic describe restricciones de precios del modelo, contexto, herramientas, almacenamiento en caché y batch que afectan cuántas llamadas puede enviar con seguridad tu flujo de trabajo.
Antes de que el tráfico de producción cambie, ejecuta una lista de verificación de ruta:
| Comprobación | Qué verificar |
|---|---|
| Autenticación | La clave directa del proveedor o la clave de gateway están asignadas al entorno correcto. |
| ID del modelo | El ID exacto del modelo está actualizado y es compatible con la ruta de la cuenta. |
| Forma de la solicitud | Los mensajes, herramientas, esquema JSON, streaming y campos de modalidad coinciden con la ruta. |
| Límites de tasa | La clase de tráfico se mantiene dentro de las restricciones de RPM, TPM, diarias y de gasto. |
| Mapeo de errores | Los casos de 400, 401, 403, 429, 5xx, timeout y proveedor sobrecargado se traducen en un comportamiento de la aplicación accionable. |
| Política de fallback | La aplicación sabe cuándo reintentar la misma ruta, cambiar de proveedor, encolar o fallar de forma cerrada. |
| Registro de costos | Cada solicitud registra el modelo, los recuentos de tokens, el uso de caché, el modo batch, la latencia, el estado y el costo. |
| Validador de salida | El producto tiene un validador para JSON, llamadas a herramientas, citas o corrección específica de la tarea. |
El inicio rápido de Flatkey muestra el patrón del SDK de OpenAI: conserva el SDK y cambia la base_url a https://router.flatkey.ai/v1. La visión general de la API REST de Flatkey documenta la misma base URL compatible con OpenAI, y el índice de documentación de Flatkey describe una clave, un saldo compartido, un catálogo de modelos y documentación para GPT, Claude, Gemini, DeepSeek y otros modelos. Después de la primera solicitud, el inicio rápido de Flatkey indica a los usuarios que consulten Usage Logs para ver el modelo, el recuento de tokens, la latencia y el costo.
Eso hace que Flatkey sea útil en un despliegue de routing: puedes mantener estable el formato de solicitud de la aplicación, comparar el comportamiento de las rutas de Gemini y Claude en los registros de uso, y promover un fallback probado sin dispersar las claves de proveedor entre servicios.
Para patrones adyacentes de planificación de rutas, compara este flujo de trabajo con la lista de comprobación de Gemini API para agentes de Flatkey y el artículo comprobaciones de routing de API DeepSeek vs Qwen.
Una tarjeta de puntuación práctica para routing
Usa esta tarjeta de puntuación para la decisión final. Asigna a cada fila una puntuación de 1 a 5 para Gemini y Claude, y luego pondera según la carga de trabajo.
| Criterio | Peso | Puntuación de Gemini | Puntuación de Claude | Notas |
|---|---|---|---|---|
| Costo por salida aceptada | 25% | Incluye reintentos, caché, lote y sobrecarga de herramientas. | ||
| Validez del esquema | 15% | Cuenta fallos del parser y valores enum inválidos. | ||
| Precisión de llamadas a herramientas | 15% | Cuenta herramienta incorrecta, campo faltante y uso innecesario de herramientas. | ||
| Fiabilidad del contexto | 15% | Prueba en tamaños de prompt p50, p90 y en el peor caso. | ||
| Latencia | 10% | Mide la latencia de streaming y de respuesta completa. | ||
| Margen de límite de tasa | 10% | Verifica los límites de proyecto/cuenta antes del lanzamiento. | ||
| Recuperación ante fallos | 10% | Verifica las rutas de reintento, fallback y revisión humana. |
Por ejemplo:
- Un pipeline de resumido en segundo plano podría ponderar más el costo por salida aceptada y la compatibilidad con lotes.
- Un agente de programación podría ponderar más la precisión de llamadas a herramientas, la latencia y la fiabilidad del contexto.
- Un flujo de trabajo de atención al cliente podría ponderar más la validez del esquema, el comportamiento de escalado y el costo de revisión.
El resultado de Gemini vs Claude API Routing debería ser un archivo de política, no una nota de reunión.
routes:
  support_triage:
    primary: gemini-or-claude-route-that-wins-scorecard
    fallback: second-provider-route
    validator: support_ticket_schema_v3
    retry_limit: 1
    fail_closed_when:
      - missing_required_field
      - unsafe_escalation_label
  code_review_agent:
    primary: route-that-wins-tool-and-context-tests
    fallback: route-with-best-safe-summary
    validator: diff_comment_schema_v2
    retry_limit: 0
    fail_closed_when:
      - tool_argument_invalid
      - repository_path_not_in_context
Cómo ejecutar una comparación segura de Flatkey
Flatkey no sustituye la evaluación. Es el plano de control que facilita la evaluación y el despliegue.
- Elige una carga de trabajo, como triage de soporte, comentarios de revisión de código, resumido de informes o extracción.
- Construye un conjunto congelado de 50-200 prompts reales con reglas de salida esperadas.
- Elige una ruta de Gemini y una ruta de Claude del catálogo de modelos actual.
- Envía ambas a través del mismo formato de solicitud compatible con OpenAI, cuando sea posible.
- Registra los conteos de tokens, la latencia, el estado, el proveedor, el modelo, el costo y el resultado del validador.
- Compara el costo por salida aceptada, no el precio por millón de tokens.
- Despliega el ganador como principal y mantén el otro como fallback supervisado.
- Vuelve a ejecutar la prueba después de cambios en los precios del proveedor, IDs de modelo, límites de contexto o estado de la ruta.
Aquí es donde un gateway gana su lugar. Si la aplicación ya usa un cliente compatible con OpenAI, Flatkey puede hacer que la primera prueba sea tan pequeña como un cambio en base_url más un cambio en la selección del modelo. Si la ruta falla, reviertes la política de rutas en lugar de reescribir el código de la aplicación.
Errores comunes en Gemini vs Claude API Routing
Error 1: Comparar solo los modelos insignia.
La mayoría de los flujos de trabajo de producción no necesita el modelo más caro para cada solicitud. Compara clases de rutas: rápida, económica, de contexto largo, con mucho razonamiento, por lotes y de reserva.
Error 2: Ignorar los esquemas de herramientas.
Los prompts de agentes a menudo incluyen definiciones grandes de herramientas. Mide esos tokens y valida los argumentos de las herramientas.
Error 3: Tratar la ventana de contexto como calidad de respuesta.
Una ventana de contexto más grande solo es útil cuando el modelo usa de forma fiable las partes correctas de ella.
Error 4: Olvidar la semántica de fallback.
Un modelo de fallback puede ser peor que no tener fallback si cambia la forma de salida, omite herramientas obligatorias o viola una política del producto.
Error 5: Publicar una ruta sin revisar los registros de uso.
Tus registros deberían mostrar el modelo real, los recuentos de tokens, la latencia, el estado, el coste y el motivo del fallback. Si esos campos faltan, no puedes depurar la ruta bajo carga.
FAQ
¿Gemini es más barato que Claude?
A veces, pero no siempre después de la validación. Gemini a menudo tiene tarifas publicadas atractivas para cargas de trabajo al estilo Flash, mientras que Claude puede ganar cuando una mayor tasa de aceptación, menos reintentos, un mejor comportamiento con herramientas o un menor coste de revisión compensan tarifas de tokens más altas. Usa las páginas de precios de los proveedores y calcula el coste por salida aceptada.
¿Claude es mejor que Gemini para llamadas a herramientas?
No de forma universal. Claude tiene una documentación sólida sobre el uso de herramientas y patrones orientados a agentes, mientras que Gemini admite llamadas a funciones y salidas estructuradas. La respuesta correcta depende de tu esquema de herramientas, el manejo de errores, las necesidades de streaming y los resultados del validador.
¿Debería enrutar cada solicitud a través de un solo proveedor primero?
Por lo general, no. Divide el tráfico por clase de carga de trabajo. Una ruta por lotes económica, una ruta de chat en tiempo real, una ruta de contexto largo y una ruta de fallback pueden usar modelos diferentes.
¿Las APIs por lotes hacen que las rutas en tiempo real sean más baratas?
No. Los descuentos por lotes ayudan a las cargas de trabajo con demora. No ayudan a un usuario que espera una respuesta de chat, soporte o de un agente de programación.
¿Por qué usar Flatkey para el enrutamiento de API Gemini vs Claude?
Usa Flatkey cuando quieras un plano de control compatible con OpenAI para la selección de modelos, los registros de uso, la revisión de costes y el despliegue de fallbacks. Es especialmente útil cuando una app ya usa un SDK al estilo OpenAI y necesita comparar Gemini y Claude sin dispersar las claves de proveedor y las vistas de facturación entre servicios.
Conclusión
Routing de API Gemini vs Claude: costo, contexto, herramientas y comprobaciones de fiabilidad no es una comparación puntual de proveedores. Es un flujo de trabajo operativo. Empieza con los precios y la documentación oficiales de los modelos, prueba el contexto y el comportamiento de las herramientas con prompts reales, puntúa el coste por salida aceptada y mantén lista una política de fallback antes de que el tráfico de producción aumente.
Si tu equipo quiere comparar Gemini y Claude detrás de una única pasarela compatible con OpenAI, empieza con el inicio rápido de Flatkey, elige los candidatos de ruta del catálogo actual de modelos y verifica las primeras llamadas en los registros de uso antes de ampliar el tráfico.