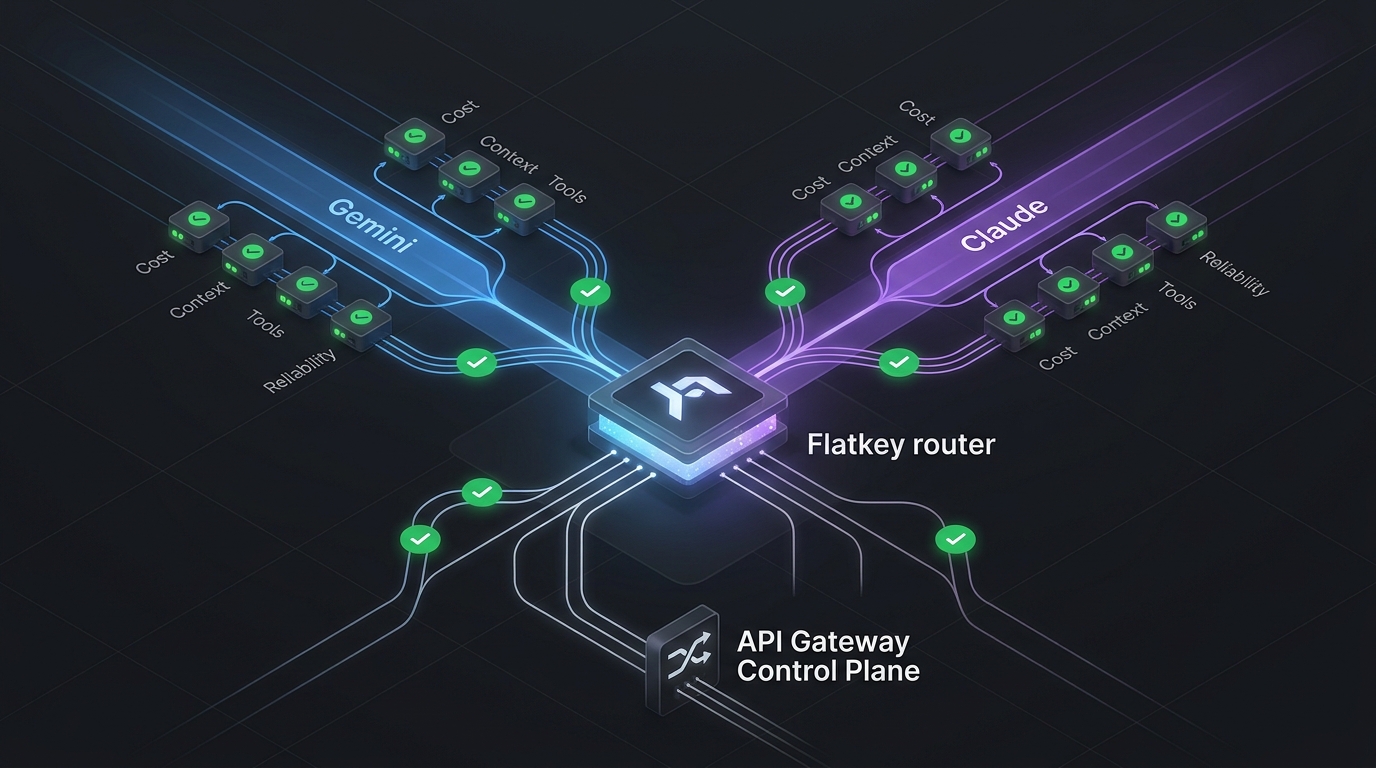
API ワークフローで Gemini と Claude を比較する場合、「どちらのモデルが優れているか」で止まらないでください。本番環境で本当に問うべきなのは、どのリクエスト種別をどの経路に振り分けるべきか、失敗したときに何を起こすべきか、そして呼び出し後にコストと結果品質をどう証明するかです。
それこそが、Gemini vs Claude API ルーティング:コスト、コンテキスト、ツール、信頼性チェック の実務です。Gemini と Claude はどちらも本格的なアプリケーションワークロードをサポートしますが、価格単位、コンテキストウィンドウ、ツール呼び出し、構造化出力、バッチ処理、キャッシュ、レート制限、運用検証において異なるトレードオフがあります。ルーティングポリシーは、トラフィックを移す前にそれらのトレードオフを明確にしておくべきです。
このガイドでは、いつ Gemini にルーティングするか、いつ Claude にルーティングするか、そしていつ Flatkey のような OpenAI 互換ゲートウェイの背後に両方を置くかを判断するための、出典に基づくチェックリストをチームに提供します。移行、エージェントの立ち上げ、プロンプトコストの見直し、またはフォールバック展開の前に使ってください。
まだゲートウェイパターン自体を選んでいるなら、この記事を Flatkey の 統合 AI API の使い方 と OpenAI API 代替の使い方 のガイドと組み合わせてください。主な関心事が計測であれば、まず AI ルーティング API 指標 のフレームワークから始めてください。
Gemini vs Claude API ルーティングの簡潔な答え
ワークロードが価格に敏感、長いコンテキストを扱う、マルチモーダル、またはバッチ向きであり、評価セットで許容できる出力品質が確認できている場合は、Gemini を最初のルートとして使います。ワークロードが強力な長文推論、注意深い指示遵守、高い確度のツール使用、または Anthropic 固有のエージェント機能を必要とする場合は、Claude を最初のルートとして使います。アプリケーションが SDK コードを書き換えずにモデルを切り替える必要がある場合、使用ログを一箇所で比較したい場合、または検証済みのフォールバックを用意しておきたい場合は、ゲートウェイルートを使います。
| ルーティングの質問 | Gemini ルートが通常魅力的なのは... | Claude ルートが通常魅力的なのは... | 本番前に確認すること |
|---|---|---|---|
| コスト | タスクで Flash / Flash-Lite 系モデル、バッチ割引、またはより安価なマルチモーダル入力単位を使える場合。 | より高いトークン単価でも、より高い受理率、再試行の削減、またはレビューコストの低減によって正当化できる場合。 | 掲載されている入力価格ではなく、受理済み出力あたりのコストに正規化する。 |
| コンテキスト | ドキュメント、コードベース、トランスクリプト、または検索パック向けに広いコンテキストが必要な場合。 | Claude の現在のモデルラインアップと出力上限で長文コンテキスト推論が必要な場合。 | 実際のコンテキストサイズで、想起率、引用の厳密さ、レイテンシ、失敗モードをテストする。 |
| ツール | 関数呼び出しと Google ネイティブのツールエコシステムのオプションが必要な場合。 | エージェント、クライアントツール、サーバーツール、構造化ツール呼び出しのための Claude のツール使用パターンが必要な場合。 | 同じツールスキーマを実行し、引数、再試行、無効な呼び出しを検証する。 |
| 構造化出力 | 型付きアプリフローのために JSON Schema への準拠が必要な場合。 | スキーマ準拠のために JSON 出力制御または厳密なツール使用パターンが必要な場合。 | 見た目の正しさだけでなく、解析済み出力をスキーマに対して検証する。 |
| 信頼性 | キューイングまたはフォールバックで、プロバイダーのレート制限変動を吸収できる場合。 | Anthropic の制限とツールトークンのオーバーヘッドをリリース制御で吸収できる場合。 | プロバイダー、モデル、トークン数、レイテンシ、ステータス、フォールバック理由を記録する。 |
要するに、勝者は全体として「Gemini」や「Claude」であることはめったにありません。勝つのは、ワークロード固有のチェックを通過し、受理済み出力あたりのコストが最も低く、運用上の予想外が最も少ないルートです。
モデル価格を比較する前にコストを正規化する
Gemini vs Claude API ルーティングで最も難しいのは、価格ページの形が同じではないことです。Google は Gemini の価格を、モデル、モダリティ、入力/出力単位、バッチモード、場合によってはコンテキスト階層ごとに示します。Anthropic は Claude の価格を、モデルファミリー、入力/出力トークン、プロンプトキャッシュ、バッチ処理、機能固有のトークンオーバーヘッドごとに示します。
まずは議論ではなく、コストワークシートから始めてください:
| コスト項目 | なぜ重要か |
|---|---|
| 入力トークン | 長いプロンプト、取得したドキュメント、ツールスキーマ、システム指示は、リクエストコストの大半を占めることがあります。 |
| 出力トークン | エージェントの計画、コード差分、JSONペイロード、要約は、コストを完了トークン側へ移すことがあります。 |
| キャッシュ書き込みとキャッシュ読み取り | Claude のプロンプトキャッシュは、繰り返し使うコンテキストの経済性を変えることがあります。繰り返しコンテキストが重要な場合は、Gemini のコンテキストキャッシュも確認すべきです。 |
| バッチ割引 | Google と Anthropic の両方がバッチ処理の割引を文書化していますが、バッチが有効なのは遅延応答を許容できる場合だけです。 |
| ツールのオーバーヘッド | ツール定義、スキーマ、途中のツール呼び出しはトークンを追加します。Anthropic はツール利用に伴うトークンコストを明示的に文書化しており、Gemini のツールペイロードについても計測されたトークン管理が必要です。 |
| 再試行率 | より安価なモデルでも、検証でより多くの出力が却下されるなら高くつく可能性があります。 |
| 人手レビューコスト | サポート、法務、財務、コードレビューのワークフローでは、生のトークン単価よりも承認率の方が重要になることがあります。 |
Gemini については、ワークシートを作成しながら Gemini API の料金 ページを開いたままにしてください。このソース確認時点では、Google は Gemini Flash、Flash-Lite、Pro、batch、およびコンテキスト階層化されたケースに対して異なる価格を掲載しており、より新しい Gemini 3.x と Gemini 2.5 の行も含まれています。Claude については、Anthropic の Claude の料金 ページを使用し、モデル階層、プロンプトキャッシュ、長文コンテキストの挙動、バッチ処理を考慮してください。
より深い料金検討には、Flatkey の Gemini API の料金 ガイドと Claude API の料金解説 ガイドを併用し、最終的な数値をこのルーティング用ワークシートに戻してください。
ルーティング指標は次の式にすべきです:
accepted_output_cost =
  (input_cost + output_cost + cache_write_cost + cache_read_cost + tool_overhead_cost + retry_cost)
  / accepted_outputs
この式は、より低い入力単価だけを見て、長い出力、無効な JSON、ツールの再試行、手作業でのクリーンアップを無視するという、よくあるミスを防ぎます。
実際のペイロードでコンテキストウィンドウを確認する
コンテキストウィンドウの主張は有用ですが、使えるコンテキストと同じではありません。モデルは大きなコンテキストを受け入れられても、埋もれた指示を見落としたり、エンティティの追跡を失ったり、SLA を超えて遅くなったり、検証できない応答を生成したりすることがあります。
Google の Gemini モデル ページには、Gemini 2.5 Flash の 1M トークンのコンテキストウィンドウを含む、長文コンテキスト対応モデルの विकल्पが記載されています。Anthropic の Claude モデル概要 には、現在の Claude モデルのコンテキストと出力制限が記載されており、いくつかの現在のモデルでは 1M トークンのコンテキストが利用可能で、Haiku クラスのルートではより小さいウィンドウが設定されています。これらの数値は重要ですが、ルーティング判断はテストから得るべきです。
同じコンテキストパックを候補ルートに通してください:
- 取得されたコンテキストがない短いプロンプト。
- 典型的なリトリーバルパックを含む中程度のプロンプト。
- 実際の顧客またはコードベースのコンテキストを含む p90 プロンプト。
- 上限に近い最悪ケースのプロンプト。
- 無関係な取得チャンクを含む劣化したプロンプト。
各実行ごとに、以下を記録します。
| コンテキスト指標 | 収集する内容 |
|---|---|
| 受理された回答率 | 回答はルーブリックまたは下流のバリデータを通過したか? |
| p50 / p90 / p99 のレイテンシ | 長いプロンプトは製品の SLA 内に収まったか? |
| コンテキスト内での見落とし失敗 | モデルは低位置の事実、ツール制約、または最終指示を無視したか? |
| 出力長のずれ | 長いコンテキストが不要な冗長化や出力の途中切れを引き起こしたか? |
| 受理された出力あたりのコスト | より大きなプロンプトは見合った価値を生んだか? |
Gemini がフルコンテキストを低コストで処理できるが、リトライが多く必要なら、より狭いタスクをそちらに振り分け、高リスクな推論には Claude を使い続けます。同じ長文コンテキストパックで Claude の受理率が高いなら、元のトークン単価が高くても、レビューとリトライのコストを含めると結果的に安くなる可能性があります。
ツール呼び出しと構造化出力を直接比較する
エージェントのワークロードは、たいてい地味な失敗でつまずきます。たとえば、引数の形式不備、作り話の enum、JSON 内の余分なキー、間違ったタイミングでのツール呼び出し、見た目は良いが解析できない応答などです。だからこそ、Gemini vs Claude API ルーティングには、ベンチマークスコアだけでなくツールとスキーマのチェックが必要です。
Google は、Gemini モデルをツールに接続してパラメータを返すための function calling と、JSON Schema ベースの応答のための structured output を公開しています。Anthropic は、クライアントおよびサーバーツール向けの Claude tool use と、スキーマ指向の応答のための structured outputs を公開しています。
1 つの共通テストハーネスを使います。
| テスト | 合格時の挙動 |
|---|---|
| 必須のツール呼び出し | モデルは正しいツールを呼び出し、直接回答しない。 |
| ツール不要ケース | 十分な情報がすでにある場合、モデルはツール呼び出しを行わない。 |
| enum フィールド | モデルは許可された enum 値のみを返す。 |
| ネストされたオブジェクト | モデルは未対応のフィールドを追加せずに、必須のネストされたフィールドを埋める。 |
| ツールエラー | モデルはポリシーに従って再試行し、欠落データを要求するか、または適切に失敗する。 |
| ストリーミング | 部分出力がパーサーやユーザー体験を壊さない。 |
| 注入試行 | モデルは敵対的な取得テキストではなく、システムおよびツールのポリシーに従う。 |
まず自然言語の回答を評価しないでください。出力をパースし、JSON を検証し、ツール引数を確認してから、回答を評価します。見た目の良い文章を返すルートでも、より多くの無効なアクションを引き起こすなら、エージェントにとっては誤ったルートである可能性があります。
ワークフローが許す場合にのみバッチ処理とキャッシュを使う
両社は、ルーティング判断を左右しうるコスト削減の仕組みを公開しています。
Google の Batch API は、非同期の大容量リクエスト向けに設計されており、対象となるバッチワークロードに対して標準コストの 50% を目標とすることが文書化されています。Anthropic の Message Batches のドキュメントでも、バッチ処理で 50% のコスト削減が説明されており、多くのバッチが 1 時間未満で完了し、リクエストサイズの制限も明記されています。
Batch が特に適しているのは次の用途です:
- オフライン分類。
- バックフィル。
- データセットのラベリング。
- 大規模な評価実行。
- 週次レポート生成。
- 緊急性の低い要約。
Batch があまり適していないのは次の用途です:
- チャットのターン。
- リアルタイムサポート。
- コーディングエージェントの内側ループ。
- ユーザー向けの再試行。
- 古い出力がコスト高になるあらゆるワークフロー。
キャッシュは別の性質を持ちます。プロンプトが大きなポリシー、コードベースのマップ、製品カタログ、契約テンプレートを繰り返し含む場合、キャッシュ読み取りによって、より高品質なルートを経済的に合理的にできることがあります。プロンプトの大半が一意であれば、キャッシュは役に立たないかもしれません。Claude については、Anthropic の料金ページにプロンプトキャッシュの書き込み・読み取り倍率が掲載されています。Gemini については、節約が自分のワークロードに適用されると決めつける前に、現在のコンテキストキャッシュのドキュメントと料金表を確認してください。
ルーティングルールはシンプルにすべきです:
route_policy:
  realtime_user_request:
    primary: schema_tests を通過する低レイテンシーモデル
    fallback: 最も安全性を検証済みのモデル
    batch: false
  offline_backfill:
    primary: 許容可能な出力コストが最も低いもの
    fallback: 後で再試行するか第2プロバイダーを使う
    batch: true
  repeated_context_agent:
    primary: キャッシュ調整後の受け入れ率が最も高いもの
    fallback: コンテキストパックが短いモデル
    batch: false
Gemini または Claude のルートを本番公開する前の信頼性チェック
プロバイダーのステータスと公開されている制限は、あくまで出発点にすぎません。Google は Gemini の レート制限 を、1 分あたりのリクエスト数、1 分あたりの入力トークン数、1 日あたりのリクエスト数、支出ベースの制限などの次元で文書化しており、制限はプロジェクトごとに適用され、実際の容量が保証されるわけではありません。Anthropic のドキュメントでは、モデルの価格、コンテキスト、ツール、キャッシュ、バッチの制約が説明されており、ワークフローが安全に送信できる呼び出し数に影響します。
本番トラフィックを移す前に、ルートのチェックリストを実行してください:
| チェック | 確認すべき内容 |
|---|---|
| 認証 | 直接のプロバイダーキーまたはゲートウェイキーが、適切な環境にスコープされている。 |
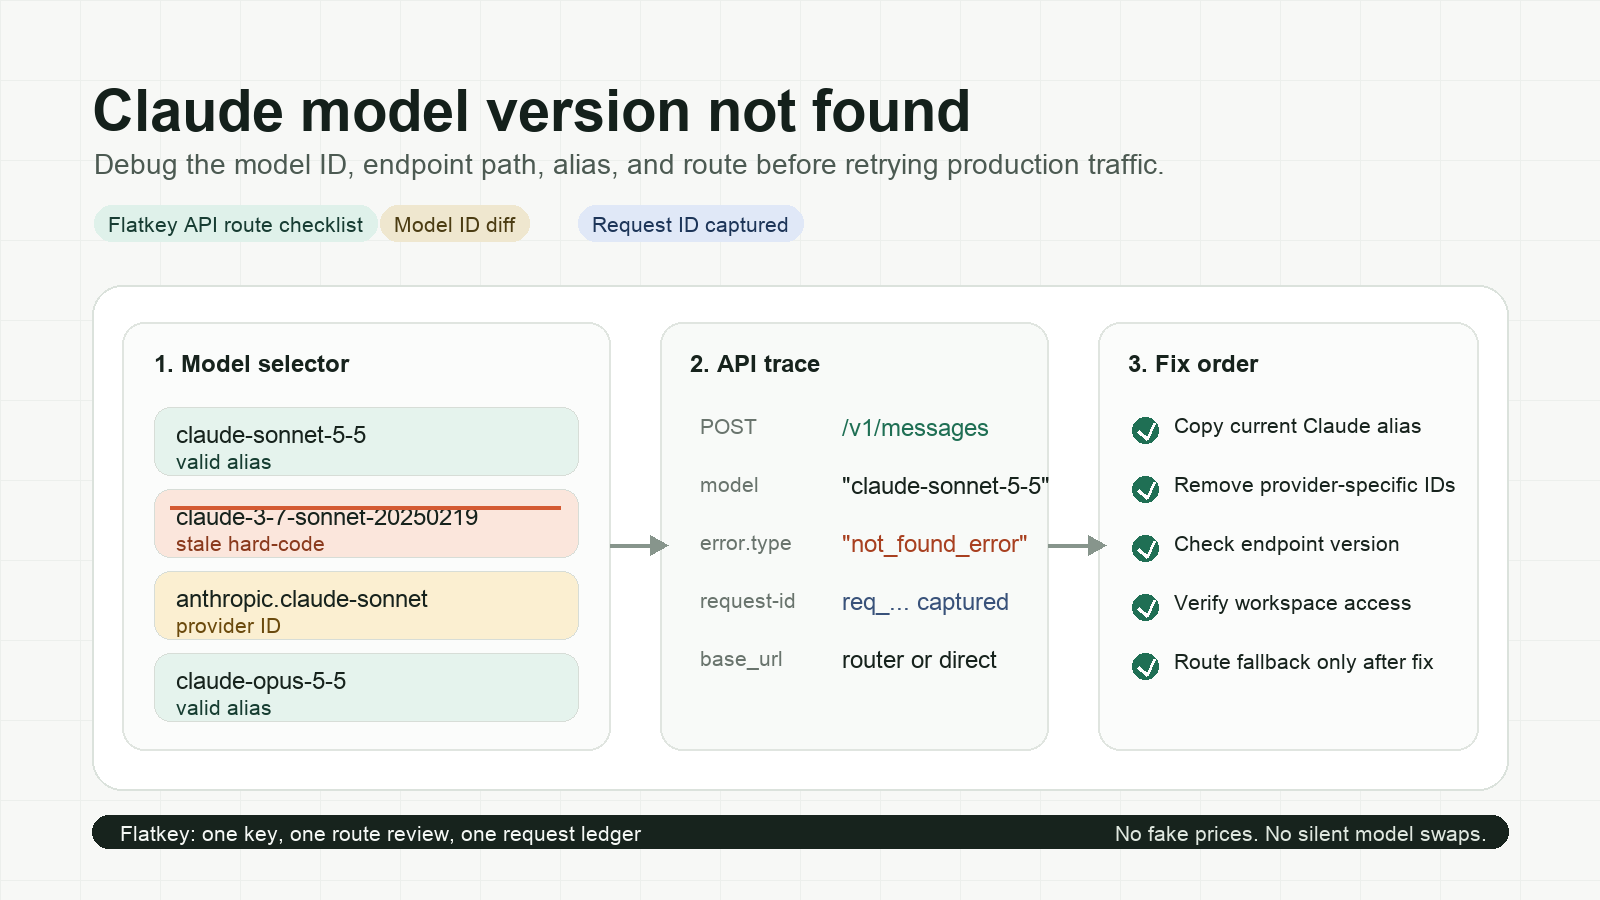
| モデルID | 正確なモデルIDが現在有効であり、アカウントルートでサポートされている。 |
| リクエスト形式 | メッセージ、ツール、JSONスキーマ、ストリーミング、モダリティの各フィールドがルートと一致している。 |
| レート制限 | トラフィッククラスがRPM、TPM、日次、支出の制約内に収まっている。 |
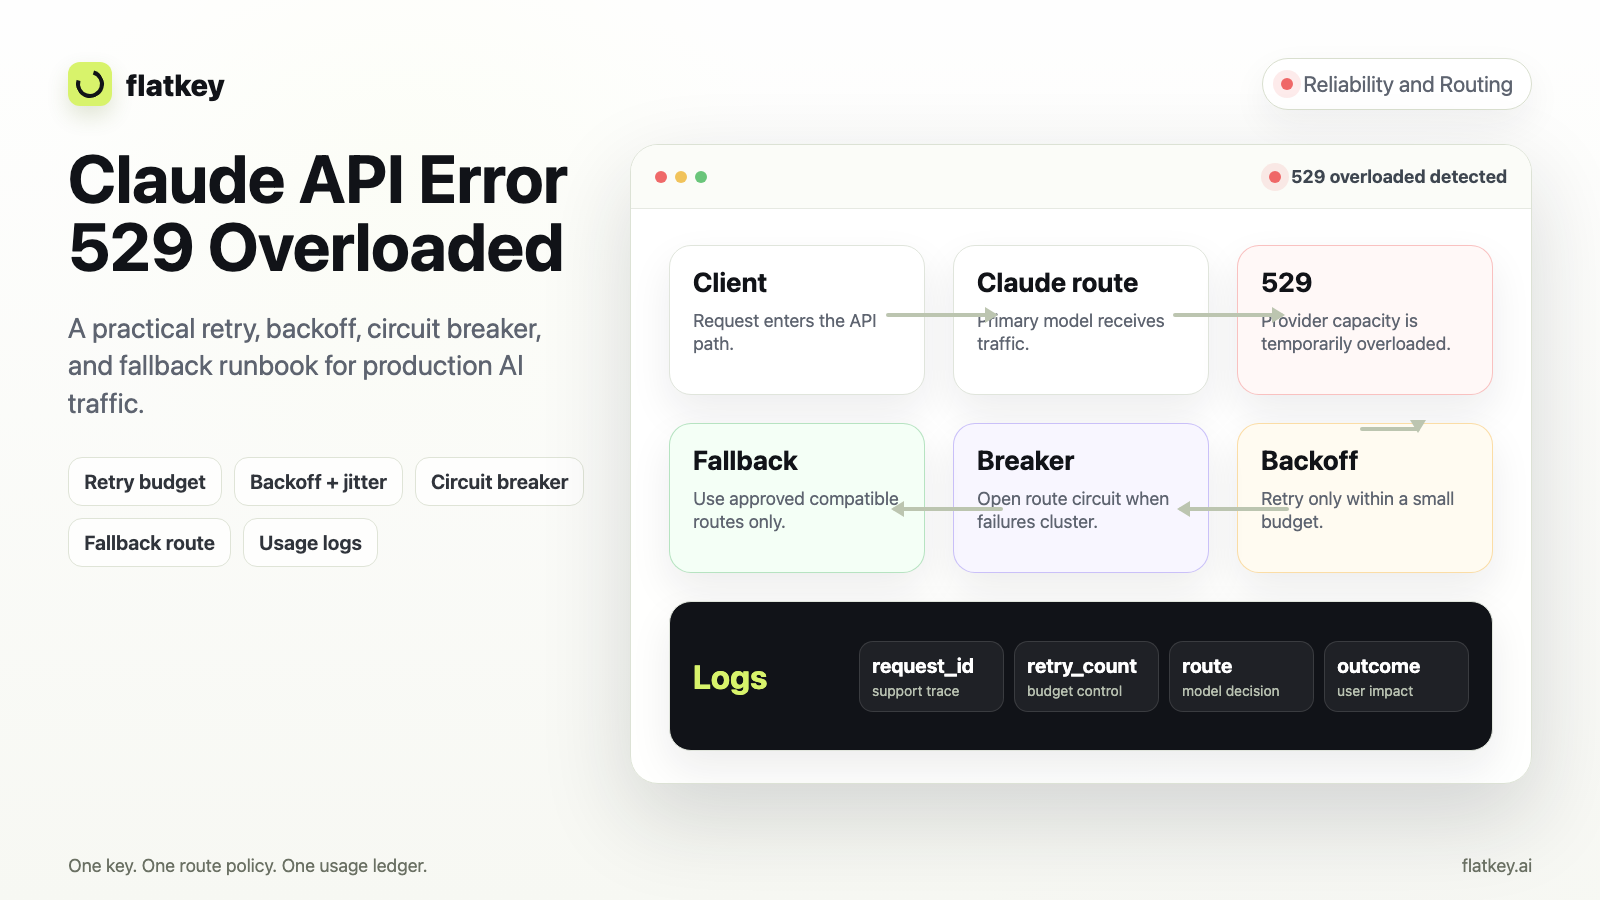
| エラーマッピング | 400、401、403、429、5xx、タイムアウト、プロバイダー過負荷の各ケースが、実行可能なアプリの動作にマップされている。 |
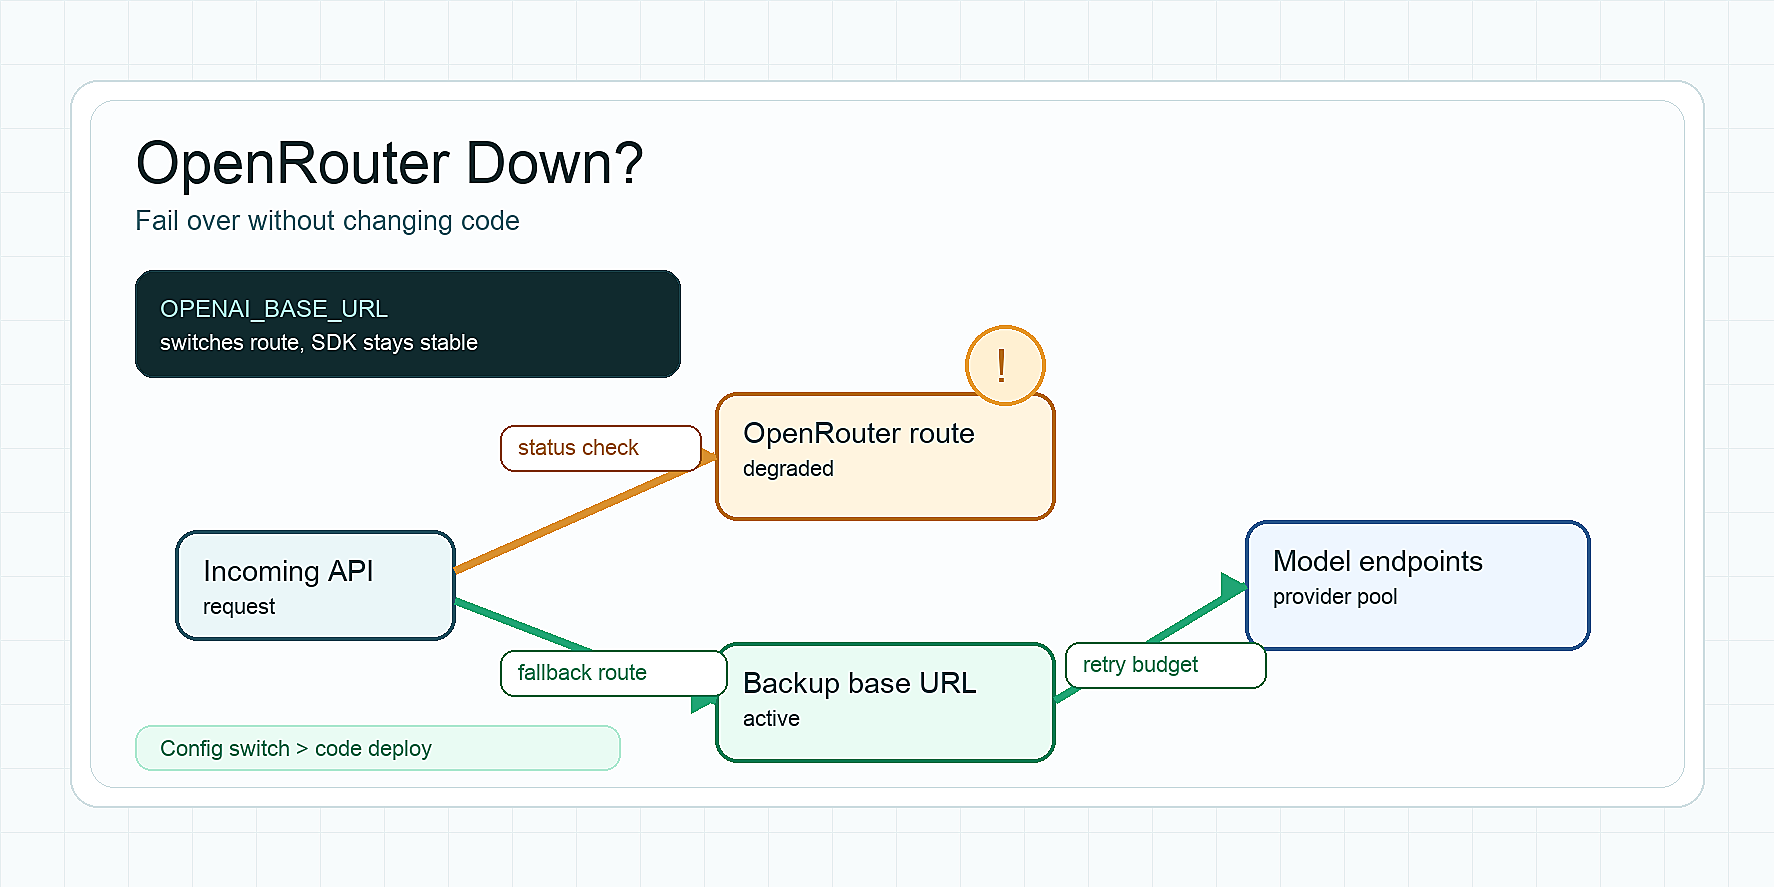
| フォールバックポリシー | アプリが、同じルートで再試行するか、プロバイダーを切り替えるか、キューに入れるか、失敗時にクローズするかの判断基準を把握している。 |
| コストログ | すべてのリクエストで、モデル、トークン数、キャッシュ使用量、バッチモード、レイテンシ、ステータス、コストが記録される。 |
| 出力バリデータ | 製品に、JSON、ツール呼び出し、引用、またはタスク固有の正確性のためのバリデータがある。 |
FlatkeyのクイックスタートはOpenAI SDKのパターンを示しています。SDKはそのままにして、base_urlをhttps://router.flatkey.ai/v1に変更します。Flatkey REST APIの概要では同じOpenAI互換のベースURLがドキュメント化されており、Flatkeyドキュメント索引では1つのキー、1つの共有残高、1つのモデルカタログ、そしてGPT、Claude、Gemini、DeepSeek、その他のモデル向けドキュメントが説明されています。最初のリクエスト後、Flatkeyのクイックスタートでは、モデル、トークン数、レイテンシ、コストについてUsage Logsを確認するよう案内しています。
そのため、Flatkeyはルーティング導入に役立ちます。アプリのリクエスト形式を安定させたまま、Usage LogsでGeminiとClaudeのルート動作を比較し、検証済みのフォールバックをサービス全体にプロバイダーキーを散在させずに昇格できます。
隣接するルート計画パターンについては、このワークフローをFlatkeyのエージェント向けGemini APIチェックリストやDeepSeek vs Qwen APIルーティングのチェック記事と比較してください。
実践的なルーティングスコアカード
最終判断にはこのスコアカードを使ってください。各行に対してGeminiとClaudeを1〜5で採点し、その後ワークロードに応じて重み付けします。
| 基準 | 重み | Gemini スコア | Claude スコア | 注記 |
|---|---|---|---|---|
| 承認済み出力コスト | 25% | 再試行、キャッシュ、バッチ、ツールのオーバーヘッドを含めます。 | ||
| スキーマ妥当性 | 15% | パーサーの失敗と無効な enum 値をカウントします。 | ||
| ツール呼び出しの精度 | 15% | 誤ったツール、欠落フィールド、不要なツール使用をカウントします。 | ||
| コンテキストの信頼性 | 15% | p50、p90、最悪ケースのプロンプトサイズでテストします。 | ||
| レイテンシ | 10% | ストリーミングとフルレスポンスのレイテンシを測定します。 | ||
| レート制限の余裕 | 10% | 起動前にプロジェクト/アカウントの制限を確認します。 | ||
| 障害復旧 | 10% | 再試行、フォールバック、有人レビューの経路を検証します。 |
たとえば:
- バックグラウンドの要約パイプラインでは、承認済み出力コストとバッチ対応を最重視するかもしれません。
- コーディングエージェントでは、ツール呼び出しの精度、レイテンシ、コンテキストの信頼性を最重視するかもしれません。
- カスタマーサポートのワークフローでは、スキーマ妥当性、エスカレーションの挙動、レビューコストを最重視するかもしれません。
Gemini vs Claude API Routing の出力は、会議メモではなくポリシーファイルであるべきです。
routes:
  support_triage:
    primary: gemini-or-claude-route-that-wins-scorecard
    fallback: second-provider-route
    validator: support_ticket_schema_v3
    retry_limit: 1
    fail_closed_when:
      - missing_required_field
      - unsafe_escalation_label
  code_review_agent:
    primary: route-that-wins-tool-and-context-tests
    fallback: route-with-best-safe-summary
    validator: diff_comment_schema_v2
    retry_limit: 0
    fail_closed_when:
      - tool_argument_invalid
      - repository_path_not_in_context
安全な Flatkey 比較の実行方法
Flatkey は評価の代替ではありません。評価とロールアウトを容易にする制御プレーンです。
- サポートトリアージ、コードレビューコメント、レポート要約、抽出など、1つのワークロードを選びます。
- 期待される出力ルールを備えた、50〜200件の実データのプロンプトを固定セットとして用意します。
- 現在のモデルカタログから Gemini のルートを1つ、Claude のルートを1つ選びます。
- 可能な限り、両方を同じ OpenAI 互換のリクエスト形式で送信します。
- トークン数、レイテンシ、ステータス、プロバイダー、モデル、コスト、バリデーター結果を記録します。
- 100万トークンあたりの価格ではなく、承認済み出力あたりのコストを比較します。
- 勝者を本番の primary として出し、もう一方は監視付きフォールバックとして保持します。
- プロバイダーの価格、モデル ID、コンテキスト制限、またはルートの健全性が変わったら、テストを再実行します。
ここでゲートウェイの価値が発揮されます。アプリケーションがすでに OpenAI 互換クライアントを使用しているなら、Flatkey では最初のテストを base_url の変更とモデル選択の変更だけで済ませられる場合があります。ルートが失敗した場合、アプリケーションコードを書き換えるのではなく、ルートポリシーをロールバックします。
Gemini vs Claude API Routing における一般的なミス
ミス1: フラッグシップモデルだけを比較する。
本番のワークフローの多くは、すべてのリクエストに最も高価なモデルを必要としません。ルートのクラスを比較しましょう。高速、低コスト、長文脈、推論重視、バッチ、フォールバックです。
ミス2: ツールスキーマを無視する。
エージェントのプロンプトには、大きなツール定義が含まれることがよくあります。それらのトークンを計測し、ツール引数を検証してください。
ミス3: コンテキストウィンドウを回答品質とみなす。
より大きなコンテキストウィンドウが役立つのは、モデルがその中の適切な部分を確実に使える場合だけです。
ミス4: フォールバックのセマンティクスを忘れる。
フォールバックモデルは、出力形式を変えたり、必要なツールをスキップしたり、製品ポリシーに違反したりするなら、フォールバックなしより悪くなることがあります。
ミス5: उपयोगログのレビューなしにルートを公開する。
ログには、実際のモデル、トークン数、レイテンシ、ステータス、コスト、フォールバック理由が表示されるべきです。これらの項目が欠けていると、負荷時にルートをデバッグできません。
FAQ
Gemini は Claude より安いですか?
場合によりますが、検証後も常にそうとは限りません。Gemini は Flash 系のワークロードで魅力的な公表料金を持つことが多く、一方で Claude は、より高い受理率、少ない再試行、より良いツール挙動、または低いレビューコストが高いトークン単価を相殺する場合に優位になることがあります。各プロバイダーの料金ページを使い、受理された出力あたりのコストを計算してください。
ツール呼び出しでは Claude のほうが Gemini より優れていますか?
一概には言えません。Claude には強力なツール使用ドキュメントとエージェント指向のパターンがありますが、Gemini は関数呼び出しと構造化出力をサポートしています。正解は、ツールスキーマ、エラー処理、ストリーミング要件、検証結果によって変わります。
すべてのリクエストを最初に 1 つのプロバイダーへルーティングすべきですか?
通常はいいえです。トラフィックをワークロードクラスごとに分けてください。低コストのバッチルート、リアルタイムチャットルート、長文脈ルート、フォールバックルートは、それぞれ異なるモデルを使う場合があります。
バッチ API はリアルタイムルートを安くしますか?
いいえ。バッチ割引は遅延してよいワークロードには有効ですが、チャット、サポート、コーディングエージェントの応答を待つユーザーには役立ちません。
Gemini vs Claude API ルーティングで Flatkey を使う理由は?
モデル選択、使用ログ、コストレビュー、フォールバック展開のために、1 つの OpenAI 互換コントロールプレーンが欲しい場合は Flatkey を使ってください。特に、アプリがすでに OpenAI スタイルの SDK を使っていて、プロバイダーのキーや請求ビューをサービス全体に分散させずに Gemini と Claude を比較したい場合に有用です。
結論
Gemini vs Claude API ルーティング:コスト、コンテキスト、ツール、信頼性チェック は、一度きりのベンダー比較ではありません。運用ワークフローです。公式の料金とモデルドキュメントから始め、実際のプロンプトでコンテキストとツールの挙動をテストし、受理された出力あたりのコストをスコア化し、本番トラフィックが移る前にフォールバックポリシーを準備しておきましょう。
チームが 1 つの OpenAI 互換ゲートウェイの背後で Gemini と Claude を比較したいなら、Flatkey クイックスタートから始め、現在のモデルカタログからルート候補を選び、トラフィックを拡大する前に Usage Logs で最初の呼び出しを確認してください。