如果您正在为 API 工作流比较 Gemini 和 Claude,不要只停留在“哪个模型更好”。在生产环境中,更好的问题是:哪条路由应该接收这类请求,失败时应该发生什么,以及在调用之后如何证明成本和结果质量?
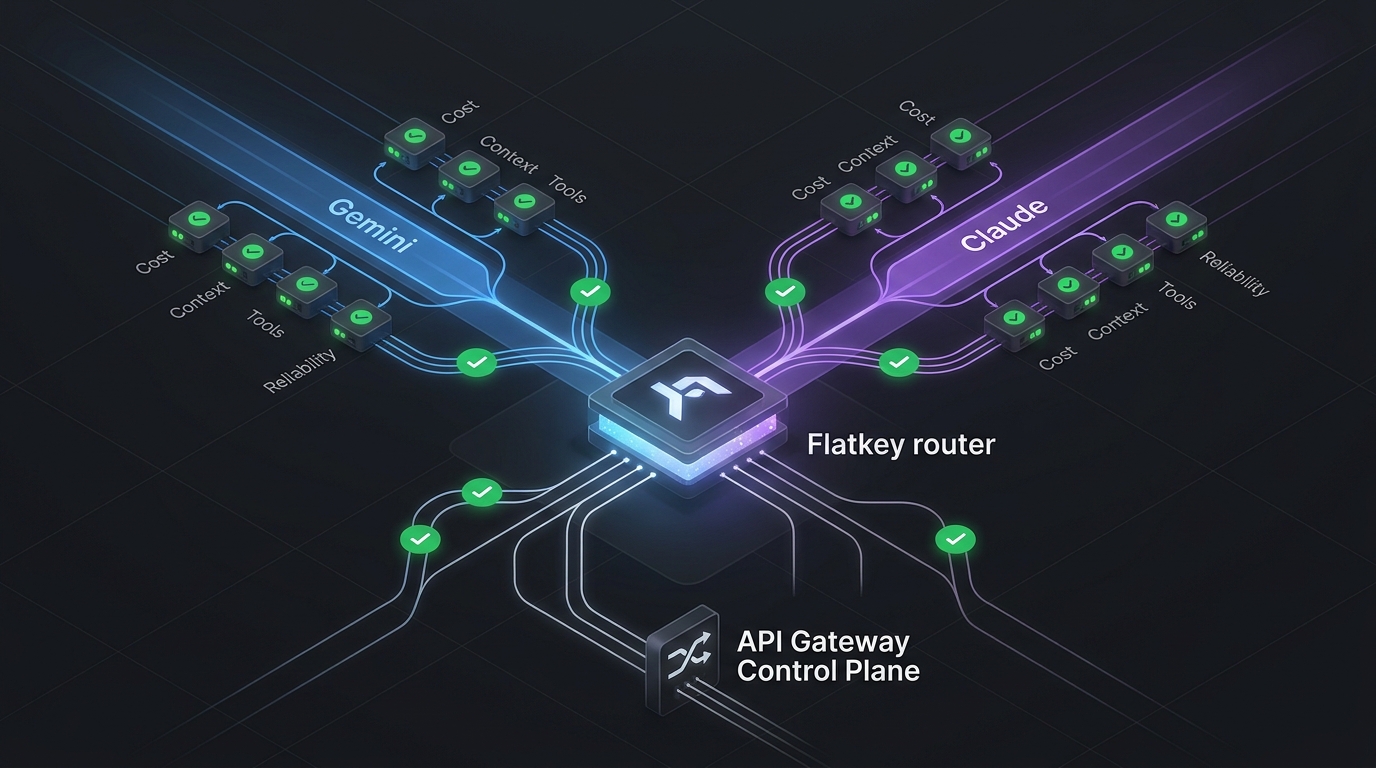
这正是Gemini 与 Claude API 路由:成本、上下文、工具和可靠性检查的实际工作。Gemini 和 Claude 都支持严肃的应用级工作负载,但它们在价格单位、上下文窗口、工具调用、结构化输出、批处理、缓存、速率限制和运行验证方面做出了不同取舍。路由策略应在流量切换之前把这些取舍明确化。
本指南为团队提供了一份有来源依据的检查清单,用于决定何时路由到 Gemini,何时路由到 Claude,以及何时通过 Flatkey 这类与 OpenAI 兼容的网关同时接入两者。请在迁移、智能体上线、提示词成本审查或回退方案部署之前使用它。
如果您仍在选择网关模式本身,请将本文与 Flatkey 关于使用统一 AI API和使用 OpenAI API 替代方案的指南搭配阅读。如果主要问题是衡量指标,请先从 AI 路由 API 指标框架开始。
Gemini 与 Claude API 路由的快速结论
当工作负载对成本敏感、上下文很大、多模态,或适合批处理,并且您的评估集确认输出质量可接受时,优先使用Gemini作为第一路由。当工作负载需要强长文本推理、谨慎遵循指令、高置信度的工具使用,或 Anthropic 特有的智能体功能时,优先使用Claude作为第一路由。当应用应在无需重写 SDK 代码的情况下切换模型、在一个位置比较使用日志,或保留经过测试的回退方案时,使用网关路由。
| 路由问题 | 当 Gemini 路由通常更有吸引力时... | 当 Claude 路由通常更有吸引力时... | 上线前检查 |
|---|---|---|---|
| 成本 | 任务可以使用 Flash / Flash-Lite 风格模型、批处理折扣,或更便宜的多模态输入单元。 | 任务通过更高的接受率、更少的重试或更低的审核成本,证明更高的按 token 费率是合理的。 | 按已接受输出的成本来标准化,而不是按列出的输入价格。 |
| 上下文 | 你需要为文档、代码库、转录内容或检索包提供广泛上下文。 | 你需要借助 Claude 当前的模型阵容和输出限制进行长上下文推理。 | 在真实上下文大小下测试召回、引用规范、延迟和失败模式。 |
| 工具 | 你需要函数调用以及 Google 原生工具生态系统选项。 | 你需要用于代理、客户端工具、服务端工具和结构化工具调用的 Claude 工具使用模式。 | 运行相同的工具 schema,并验证参数、重试和无效调用。 |
| 结构化输出 | 你需要用于类型化应用流程的 JSON Schema 遵从性。 | 你需要 JSON 输出控制或严格的工具使用模式来满足 schema 合规性。 | 根据你的 schema 验证解析后的输出,而不只是视觉上的正确性。 |
| 可靠性 | 你可以通过排队或回退来吸收提供商速率限制的波动。 | 你可以通过发布控制来吸收 Anthropic 的限制和工具 token 开销。 | 记录提供商、模型、token 数、延迟、状态和回退原因。 |
简而言之:最终胜出的很少是全局范围内的“Gemini”或“Claude”。胜出的是在你的工作负载特定检查中通过率最高、已接受输出成本最低且运营意外最少的路由。
在比较模型价格之前先标准化成本
Gemini vs Claude API Routing 最难的部分在于定价页面的结构并不相同。Google 按模型、模态、输入/输出单元、批处理模式,有时还按上下文层级列出 Gemini 价格。Anthropic 则按 Claude 的模型家族、输入/输出 token、提示缓存、批处理,以及特定功能带来的 token 开销来列出价格。
先从成本工作表开始,而不是争论:
| 成本项 | 为何重要 |
|---|---|
| 输入 token | 长提示词、检索到的文档、工具 schema 和系统指令都可能主导请求成本。 |
| 输出 token | Agent 计划、代码 diff、JSON 负载和摘要会将成本转向 completion token。 |
| 缓存写入和缓存读取 | Claude 提示词缓存会改变重复上下文的经济性;当重复上下文很重要时,应检查 Gemini 上下文缓存。 |
| 批处理折扣 | Google 和 Anthropic 都记录了批处理折扣,但只有在可接受延迟响应时,批处理才有帮助。 |
| 工具开销 | 工具定义、schema 和中间工具调用都会增加 token。Anthropic 明确记录了工具使用周围的 token 成本;Gemini 工具负载也需要进行测量性的 token 统计。 |
| 重试率 | 如果验证拒绝更多输出,更便宜的模型也可能变得昂贵。 |
| 人工审核成本 | 对于支持、法律、财务或代码审查工作流,接受率可能比原始 token 价格更重要。 |
对于 Gemini,在构建工作表时请保持 Gemini API pricing 页面开启。根据此次来源检查,Google 列出了 Gemini Flash、Flash-Lite、Pro、batch 以及按上下文分层的不同价格,其中包括较新的 Gemini 3.x 和 Gemini 2.5 行。对于 Claude,请使用 Anthropic 的 Claude pricing 页面,并将模型层级、提示词缓存、长上下文行为和批处理纳入考虑。
对于更深入的定价工作,可将 Flatkey 的 Gemini API pricing 指南和 Claude API pricing 指南作为配套材料,然后把最终数字带回此路由工作表。
路由指标应为:
accepted_output_cost =
  (input_cost + output_cost + cache_write_cost + cache_read_cost + tool_overhead_cost + retry_cost)
  / accepted_outputs
该公式可避免一个常见错误:只选择较低的标价输入价格,却忽略更长的输出、无效 JSON、工具重试或人工清理。
使用真实负载检查上下文窗口
上下文窗口的说法很有用,但它并不等同于可用上下文。一个模型可以接受很大的上下文,却仍然遗漏埋藏的指令、丢失实体跟踪、在超过 SLA 后明显变慢,或者生成无法验证的响应。
Google 的 Gemini models 页面记录了长上下文模型选项,包括具有 1M token 上下文窗口的 Gemini 2.5 Flash。Anthropic 的 Claude models overview 记录了当前 Claude 模型的上下文和输出限制,包括多个当前模型的 1M-token 上下文,以及 Haiku 级路由更小的窗口。这些数字很重要,但路由决策应来自测试。
将相同的上下文包通过候选路由运行:
- 一个不带检索上下文的简短提示。
- 一个带有典型检索包的中等提示。
- 一个带有真实客户或代码库上下文的 p90 提示。
- 一个接近你限制的最坏情况提示。
- 一个包含无关检索片段的降级提示。
对于每次运行,记录:
| 上下文指标 | 要捕获的内容 |
|---|---|
| 可接受答案率 | 答案是否通过了你的评分标准或下游验证器? |
| p50 / p90 / p99 延迟 | 长提示是否仍然保持在产品 SLA 内? |
| 上下文丢失失败 | 模型是否忽略了低位置事实、工具约束或最终指令? |
| 输出长度漂移 | 长上下文是否导致不必要的冗长或输出被截断? |
| 每个可接受输出的成本 | 更大的提示是否物有所值? |
如果 Gemini 能以较低成本处理完整上下文,但需要更多重试,那么就把更窄的任务路由到它,并将 Claude 保留给高风险推理。如果 Claude 在相同的长上下文包上产生更高的可接受率,那么它更高的原始 token 价格在加上审查和重试成本后,可能仍然更便宜。
直接比较工具调用和结构化输出
Agent 工作负载通常会以平淡无奇的方式失败:参数格式错误、虚构的枚举值、JSON 中多出一个键、在错误时间发起的工具调用,或者看起来很好但无法解析的响应。这就是为什么 Gemini 与 Claude API 路由需要工具和 schema 检查,而不仅仅是基准分数。
Google 文档中说明了用于将 Gemini 模型连接到工具并返回参数的 function calling,以及用于基于 JSON Schema 的响应的 structured output。Anthropic 文档中说明了用于客户端和服务端工具的 Claude tool use,以及用于面向 schema 的响应的 structured outputs。
使用一个共享测试框架:
| 测试 | 通过行为 |
|---|---|
| 必需工具调用 | 模型调用正确的工具,而不是直接回答。 |
| 无需工具的情况 | 当已有足够信息时,模型不会调用工具。 |
| 枚举字段 | 模型只返回允许的枚举值。 |
| 嵌套对象 | 模型填写必需的嵌套字段,而不添加不受支持的字段。 |
| 工具错误 | 模型会重试、请求缺失数据,或按策略优雅失败。 |
| 流式传输 | 部分输出不会破坏你的解析器或用户体验。 |
| 注入尝试 | 模型遵循系统和工具策略,而不是受恶意检索文本影响。 |
不要先给自然语言答案打分。先解析输出,验证 JSON,检查工具参数,然后再给答案评分。即使某条路由生成了最吸引人的文案,如果它导致更多无效操作,对 agent 来说它仍然可能是错误的路由。
仅在工作流允许的地方使用批处理和缓存
两家提供商都文档化了可改变路由决策的降本机制。
Google 的 Batch API 适用于异步的大批量请求,并为符合条件的批处理工作负载提供 50% 的标准成本目标。Anthropic 的 Message Batches 文档同样描述了批处理可降低 50% 成本,并提到大多数批次会在一小时以内完成,同时也给出了已文档化的请求大小限制。
Batch 适合:
- 离线分类。
- 回填。
- 数据集标注。
- 大规模评估运行。
- 每周报告生成。
- 非紧急摘要。
Batch 不适合:
- 聊天轮次。
- 实时支持。
- 编码代理的内部循环。
- 面向用户的重试。
- 任何输出过时会造成高成本的工作流。
缓存的形态不同。如果你的提示会重复一大段策略、代码库映射、产品目录或合同模板,那么缓存读取可能会让更高质量的路由在经济上变得合理。如果提示大多是唯一的,缓存可能帮不上忙。对于 Claude,Anthropic 的定价页面包含 prompt cache 的写入和读取乘数;对于 Gemini,在假定节省适用于你的工作负载之前,请先查看当前的上下文缓存文档和定价项。
路由规则应该尽量简单:
route_policy:
  realtime_user_request:
    primary: low_latency_model_that_passes_schema_tests
    fallback: safest_validated_model
    batch: false
  offline_backfill:
    primary: lowest_accepted_output_cost
    fallback: retry_later_or_second_provider
    batch: true
  repeated_context_agent:
    primary: best_cache_adjusted_acceptance_rate
    fallback: model_with_shorter_context_pack
    batch: false
Gemini 或 Claude 路由上线前的可靠性检查
提供商状态和已发布的限制只是起点。Google 按请求每分钟数、输入 token 每分钟数、每日请求数以及基于支出的限制等维度为 Gemini 文档化了 速率限制,这些限制按项目应用,且不保证实际容量。Anthropic 的文档描述了模型定价、上下文、工具、缓存和批处理约束,这些都会影响你的工作流可以安全发出的调用数量。
在生产流量切换之前,请运行一份路由检查清单:
| 检查项 | 需要验证的内容 |
|---|---|
| 身份验证 | 直接提供商密钥或网关密钥是否限定在正确的环境中。 |
| 模型 ID | 确切的模型 ID 是否是最新的,并且受该账户路由支持。 |
| 请求结构 | 消息、工具、JSON 模式、流式传输和模态字段是否与路由匹配。 |
| 速率限制 | 流量类别是否保持在 RPM、TPM、每日和支出限制之内。 |
| 错误映射 | 400、401、403、429、5xx、超时以及提供商过载等情况是否映射为可操作的应用行为。 |
| 回退策略 | 应用是否知道何时重试同一路由、切换提供商、排队或在失败时关闭。 |
| 成本日志 | 每个请求是否记录模型、token 数、缓存使用、批处理模式、延迟、状态和成本。 |
| 输出校验器 | 产品是否具备用于 JSON、工具调用、引用或特定任务正确性的校验器。 |
Flatkey 的 快速入门展示了 OpenAI SDK 模式:保留 SDK,只将 base_url 改为 https://router.flatkey.ai/v1。Flatkey REST API 概览记录了同样的 OpenAI 兼容 base URL,而 Flatkey 文档索引描述了一个密钥、一个共享余额、一个模型目录,以及 GPT、Claude、Gemini、DeepSeek 和其他模型的文档。首次请求后,Flatkey 的快速入门会提示用户在 Usage Logs 中查看模型、token 数、延迟和成本。
这使 Flatkey 在路由推广过程中非常有用:你可以保持应用的请求格式稳定,在 Usage Logs 中比较 Gemini 和 Claude 的路由行为,并在不把提供商密钥分散到各个服务中的情况下推广经过测试的回退方案。
对于相邻的路由规划模式,请将此工作流与 Flatkey 的 Gemini API for agents 清单以及 DeepSeek vs Qwen API routing checks 文章进行比较。
实用路由评分表
将此评分表用于最终决策。为 Gemini 和 Claude 的每一行分别给出 1-5 分,然后按工作负载加权。
| 标准 | 权重 | Gemini 分数 | Claude 分数 | 说明 |
|---|---|---|---|---|
| 已接受输出成本 | 25% | 包括重试、缓存、批处理和工具开销。 | ||
| Schema 有效性 | 15% | 统计解析器失败和无效的枚举值。 | ||
| 工具调用精度 | 15% | 统计调用错误工具、缺失字段以及不必要的工具使用。 | ||
| 上下文可靠性 | 15% | 在 p50、p90 和最坏情况的提示词大小下进行测试。 | ||
| 延迟 | 10% | 测量流式输出和完整响应延迟。 | ||
| 限流余量 | 10% | 在上线前检查项目/账户限制。 | ||
| 故障恢复 | 10% | 验证重试、降级和人工复核路径。 |
例如:
- 后台摘要流水线可能会将已接受输出成本和批处理支持的权重设为最高。
- 编码代理可能会将工具调用精度、延迟和上下文可靠性的权重设为最高。
- 客户支持工作流可能会将 Schema 有效性、升级处理行为和审核成本的权重设为最高。
Gemini 与 Claude API 路由的输出应该是一个策略文件,而不是会议记录。
routes:
  support_triage:
    primary: gemini-or-claude-route-that-wins-scorecard
    fallback: second-provider-route
    validator: support_ticket_schema_v3
    retry_limit: 1
    fail_closed_when:
      - missing_required_field
      - unsafe_escalation_label
  code_review_agent:
    primary: route-that-wins-tool-and-context-tests
    fallback: route-with-best-safe-summary
    validator: diff_comment_schema_v2
    retry_limit: 0
    fail_closed_when:
      - tool_argument_invalid
      - repository_path_not_in_context
如何运行一个安全的 Flatkey 比较
Flatkey 不能替代评估。它是让评估和发布更容易的控制平面。
- 选择一个工作负载,例如支持分流、代码审查评论、报告摘要或抽取。
- 构建一组冻结的 50-200 条真实提示词,并附上预期输出规则。
- 从当前模型目录中选择一条 Gemini 路由和一条 Claude 路由。
- 在可能的情况下,通过相同的 OpenAI 兼容请求格式发送二者。
- 记录 token 数、延迟、状态、提供方、模型、成本和验证器结果。
- 比较每个已接受输出的成本,而不是每百万 token 的价格。
- 将胜出者作为主路由上线,并保留另一个作为受监控的后备方案。
- 在提供方定价、模型 ID、上下文限制或路由健康状况发生变化后重新运行测试。
这正是网关发挥作用的地方。如果应用已经在使用 OpenAI 兼容客户端,Flatkey 可以把第一次测试缩小到仅需更改 base_url 加上模型选择的变更。如果路由失败,你回滚的是路由策略,而不是重写应用代码。
Gemini 与 Claude API 路由中的常见错误
错误 1:只比较旗舰模型。
大多数生产工作流并不需要每次请求都使用最昂贵的模型。请比较路由类别:快速、低成本、长上下文、重推理、批处理和回退。
错误 2:忽略工具 schema。
Agent 提示词通常包含较大的工具定义。请测量这些 token,并验证工具参数。
错误 3:把上下文窗口当成回答质量。
更大的上下文窗口只有在模型能够可靠地使用其中正确部分时才有用。
错误 4:忘记回退语义。
如果回退模型会改变输出结构、跳过必需工具,或者违反产品策略,那么它可能比没有回退更糟。
错误 5:在未审查使用日志的情况下发布路由。
你的日志应显示实际模型、token 数、延迟、状态、成本和回退原因。如果这些字段缺失,就无法在负载下调试路由。
常见问题
Gemini 比 Claude 更便宜吗?
有时是,但在验证之后并不总是如此。对于 Flash 风格的工作负载,Gemini 的标价通常更有吸引力;而当更高的接受率、更少的重试、更好的工具行为或更低的审查成本能够抵消更高的 token 费率时,Claude 可能更胜一筹。请使用提供商的定价页面,并计算每个已接受输出的成本。
Claude 在工具调用方面比 Gemini 更好吗?
并非普遍如此。Claude 具有强大的工具使用文档和面向 agent 的模式,而 Gemini 支持 function calling 和结构化输出。正确答案取决于你的工具 schema、错误处理、流式需求以及验证器结果。
我应该先把每个请求都通过一个提供商路由吗?
通常不应该。应按工作负载类别拆分流量。低成本批处理路由、实时聊天路由、长上下文路由和回退路由可能都使用不同的模型。
批处理 API 会让实时路由更便宜吗?
不会。批处理折扣只对延迟可接受的工作负载有帮助。它们对正在等待聊天、支持或编码 agent 响应的用户没有帮助。
为什么在 Gemini 与 Claude API 路由中使用 Flatkey?
当你想要一个 OpenAI 兼容的统一控制平面来进行模型选择、使用日志、成本审查和回退部署时,请使用 Flatkey。尤其是在应用已经使用 OpenAI 风格 SDK,并且需要比较 Gemini 和 Claude,同时又不想将提供商密钥和计费视图分散到各个服务中时,它特别有用。
结论
Gemini 与 Claude API 路由:成本、上下文、工具和可靠性检查并不是一次性的供应商比较,而是一套运行工作流。请从官方定价和模型文档开始,在真实提示词上测试上下文和工具行为,按每个已接受输出计算成本,并在生产流量迁移之前准备好回退策略。
如果你的团队希望在一个 OpenAI 兼容网关后面比较 Gemini 和 Claude,请从 Flatkey 快速入门开始,从当前模型目录中选择路由候选项,并在扩大流量之前先在使用日志中验证首次调用。