Nếu bạn đang so sánh Gemini và Claude cho một quy trình API, đừng dừng lại ở câu hỏi "mô hình nào tốt hơn." Trong môi trường sản xuất, câu hỏi đúng hơn là: yêu cầu này nên được chuyển đến tuyến nào, điều gì sẽ xảy ra khi nó thất bại, và làm thế nào bạn chứng minh được chi phí cũng như chất lượng kết quả sau cuộc gọi?
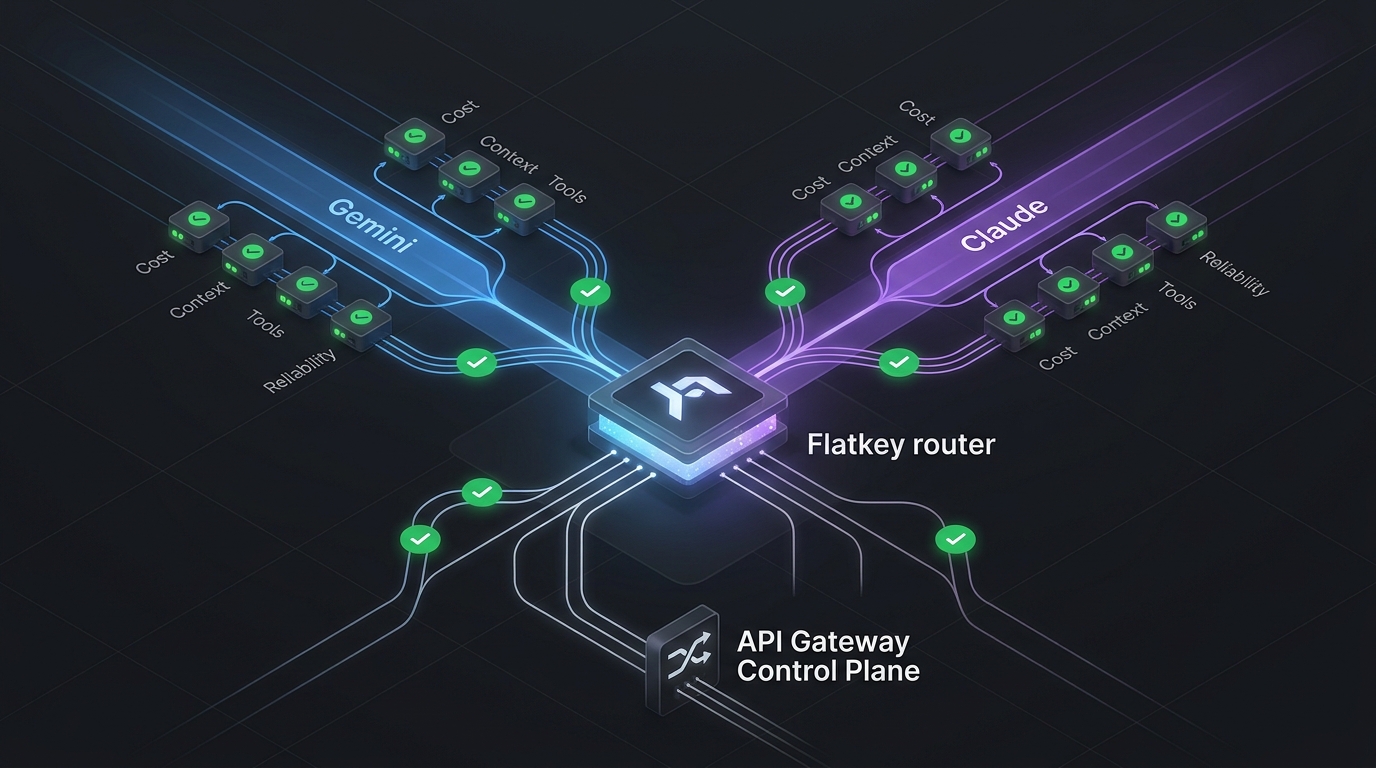
Đó là công việc thực tế của Định tuyến API Gemini vs Claude: Chi phí, ngữ cảnh, công cụ và kiểm tra độ tin cậy. Gemini và Claude đều hỗ trợ các khối lượng công việc ứng dụng nghiêm túc, nhưng chúng có những đánh đổi khác nhau về đơn vị giá, cửa sổ ngữ cảnh, gọi công cụ, đầu ra có cấu trúc, xử lý theo lô, bộ nhớ đệm, giới hạn tốc độ và xác minh vận hành. Chính sách định tuyến nên làm rõ những đánh đổi đó trước khi lưu lượng được chuyển đi.
Hướng dẫn này cung cấp cho các nhóm một danh sách kiểm tra dựa trên nguồn để quyết định khi nào định tuyến sang Gemini, khi nào định tuyến sang Claude, và khi nào nên đặt cả hai sau một cổng tương thích OpenAI như Flatkey. Hãy dùng nó trước khi di chuyển hệ thống, ra mắt tác nhân, rà soát chi phí prompt, hoặc triển khai phương án dự phòng.
Nếu bạn vẫn đang chọn mẫu cổng trung gian, hãy kết hợp bài viết này với các hướng dẫn của Flatkey về cách sử dụng một API AI hợp nhất và cách sử dụng một lựa chọn thay thế cho API OpenAI. Nếu câu hỏi chính là đo lường, hãy bắt đầu trước bằng khung các chỉ số API định tuyến AI.
Câu trả lời nhanh cho Định tuyến API Gemini vs Claude
Hãy dùng Gemini làm tuyến đầu tiên khi khối lượng công việc nhạy cảm về chi phí, có ngữ cảnh lớn, đa phương thức hoặc phù hợp xử lý theo lô và bộ đánh giá của bạn xác nhận chất lượng đầu ra chấp nhận được. Hãy dùng Claude làm tuyến đầu tiên khi khối lượng công việc cần suy luận dài nhiều bước, tuân thủ hướng dẫn cẩn thận, sử dụng công cụ với độ tin cậy cao, hoặc các tính năng tác nhân đặc thù của Anthropic. Hãy dùng tuyến qua cổng trung gian khi ứng dụng nên chuyển đổi mô hình mà không cần viết lại mã SDK, so sánh nhật ký sử dụng ở một nơi, hoặc giữ sẵn một phương án dự phòng đã được kiểm thử.
| Câu hỏi định tuyến | Định tuyến Gemini thường hấp dẫn khi... | Định tuyến Claude thường hấp dẫn khi... | Kiểm tra trước khi đưa vào production |
|---|---|---|---|
| Chi phí | Nhiệm vụ có thể dùng các mô hình kiểu Flash / Flash-Lite, chiết khấu theo batch, hoặc đơn vị đầu vào đa phương thức rẻ hơn. | Nhiệm vụ biện minh cho mức giá cao hơn trên mỗi token nhờ tỷ lệ chấp nhận tốt hơn, ít lần thử lại hơn, hoặc chi phí rà soát thấp hơn. | Chuẩn hóa theo chi phí trên mỗi đầu ra được chấp nhận, không phải giá đầu vào niêm yết. |
| Ngữ cảnh | Bạn cần ngữ cảnh rộng cho tài liệu, codebase, bản ghi chép, hoặc gói truy xuất. | Bạn cần suy luận ngữ cảnh dài với danh mục mô hình hiện tại của Claude và giới hạn đầu ra. | Kiểm thử khả năng ghi nhớ, tính kỷ luật khi trích dẫn, độ trễ và chế độ lỗi ở kích thước ngữ cảnh thực tế. |
| Công cụ | Bạn cần function calling cùng các tùy chọn hệ sinh thái công cụ gốc của Google. | Bạn cần các mẫu sử dụng công cụ của Claude cho agent, công cụ client, công cụ server và các lời gọi công cụ có cấu trúc. | Chạy cùng một lược đồ công cụ và xác minh tham số, lần thử lại và các lời gọi không hợp lệ. |
| Đầu ra có cấu trúc | Bạn cần tuân thủ JSON Schema cho các luồng ứng dụng có kiểu dữ liệu. | Bạn cần kiểm soát đầu ra JSON hoặc các mẫu dùng công cụ nghiêm ngặt để tuân thủ schema. | Xác thực đầu ra đã phân tích cú pháp theo schema của bạn, không chỉ kiểm tra tính đúng về mặt hiển thị. |
| Độ tin cậy | Bạn có thể hấp thụ sự biến động về giới hạn tốc độ của nhà cung cấp bằng hàng đợi hoặc phương án dự phòng. | Bạn có thể hấp thụ các giới hạn của Anthropic và phần overhead token của công cụ bằng các kiểm soát triển khai. | Ghi log nhà cung cấp, mô hình, số lượng token, độ trễ, trạng thái và lý do dự phòng. |
Tóm lại: bên thắng hiếm khi là "Gemini" hay "Claude" trên phạm vi toàn cục. Bên thắng là tuyến đường vượt qua các kiểm tra đặc thù của khối lượng công việc với chi phí trên mỗi đầu ra được chấp nhận thấp nhất và ít bất ngờ vận hành nhất.
Chuẩn hóa chi phí trước khi so sánh giá mô hình
Phần khó nhất của định tuyến API Gemini vs Claude là các trang giá không được trình bày theo cùng một cách. Google liệt kê giá Gemini theo mô hình, phương thức, đơn vị đầu vào/đầu ra, chế độ batch và đôi khi theo bậc ngữ cảnh. Anthropic liệt kê giá Claude theo họ mô hình, token đầu vào/đầu ra, prompt caching, xử lý batch và phần overhead token theo từng tính năng.
Bắt đầu bằng một bảng tính chi phí thay vì tranh luận:
| Trường chi phí | Vì sao nó quan trọng |
|---|---|
| Token đầu vào | Các prompt dài, tài liệu được truy xuất, lược đồ công cụ và chỉ dẫn hệ thống có thể chiếm phần lớn chi phí của request. |
| Token đầu ra | Kế hoạch của agent, diff mã, payload JSON và bản tóm tắt có thể chuyển chi phí sang token hoàn thành. |
| Ghi cache và đọc cache | Prompt caching của Claude có thể thay đổi kinh tế cho ngữ cảnh lặp lại; context caching của Gemini nên được kiểm tra khi ngữ cảnh lặp lại là đáng kể. |
| Chiết khấu batch | Cả Google và Anthropic đều có tài liệu về chiết khấu xử lý batch, nhưng batch chỉ hữu ích khi có thể chấp nhận phản hồi bị trễ. |
| Chi phí công cụ | Định nghĩa công cụ, lược đồ và các lệnh gọi công cụ trung gian làm tăng token. Anthropic ghi rõ chi phí token quanh việc sử dụng công cụ; payload công cụ của Gemini cũng cần được tính token một cách đo đạc. |
| Tỷ lệ thử lại | Một mô hình rẻ hơn có thể trở nên đắt nếu xác thực từ chối nhiều đầu ra hơn. |
| Chi phí xem xét của con người | Với quy trình hỗ trợ, pháp lý, tài chính hoặc rà soát mã, tỷ lệ chấp nhận có thể quan trọng hơn giá token thô. |
Với Gemini, hãy giữ trang giá Gemini API mở trong khi xây dựng bảng tính. Tính đến thời điểm kiểm tra nguồn này, Google liệt kê các mức giá khác nhau cho Gemini Flash, Flash-Lite, Pro, batch và các trường hợp theo tầng ngữ cảnh, bao gồm cả các dòng Gemini 3.x và Gemini 2.5 mới hơn. Với Claude, hãy dùng trang giá Claude của Anthropic và tính đến các tầng mô hình, prompt caching, hành vi ngữ cảnh dài và xử lý batch.
Đối với công việc định giá sâu hơn, hãy dùng hướng dẫn giá Gemini API và giá Claude API của Flatkey như tài liệu bổ trợ, rồi đưa các con số cuối cùng trở lại bảng tính định tuyến này.
Chỉ số định tuyến nên là:
accepted_output_cost =
  (input_cost + output_cost + cache_write_cost + cache_read_cost + tool_overhead_cost + retry_cost)
  / accepted_outputs
Công thức đó ngăn một sai lầm phổ biến: chọn mức giá đầu vào niêm yết thấp hơn trong khi bỏ qua đầu ra dài hơn, JSON không hợp lệ, thử lại công cụ hoặc dọn dẹp thủ công.
Kiểm tra cửa sổ ngữ cảnh bằng payload thực tế
Các tuyên bố về cửa sổ ngữ cảnh rất hữu ích, nhưng chúng không giống với ngữ cảnh có thể sử dụng. Một mô hình có thể chấp nhận ngữ cảnh lớn nhưng vẫn bỏ sót một chỉ dẫn bị chôn sâu, mất dấu một thực thể, chậm hơn quá SLA của bạn, hoặc tạo ra phản hồi không thể xác thực.
Trang mô hình Gemini của Google ghi tài liệu các tùy chọn mô hình ngữ cảnh dài, bao gồm Gemini 2.5 Flash với cửa sổ ngữ cảnh 1M token. Tổng quan mô hình Claude của Anthropic ghi tài liệu ngữ cảnh và giới hạn đầu ra hiện tại của các mô hình Claude, bao gồm ngữ cảnh 1M token cho một số mô hình hiện hành và một cửa sổ nhỏ hơn cho các tuyến Haiku-class. Những con số này quan trọng, nhưng quyết định định tuyến nên đến từ các bài kiểm tra.
Hãy chạy cùng một gói ngữ cảnh qua các tuyến ứng viên:
- Một prompt ngắn không có ngữ cảnh được truy xuất.
- Một prompt trung bình với gói truy xuất điển hình.
- Một prompt p90 với ngữ cảnh khách hàng thực tế hoặc từ codebase.
- Một prompt trường hợp xấu nhất gần giới hạn của bạn.
- Một prompt bị suy giảm với các đoạn truy xuất không liên quan.
Với mỗi lần chạy, hãy ghi lại:
| Chỉ số ngữ cảnh | Cần thu thập gì |
|---|---|
| Tỷ lệ câu trả lời được chấp nhận | Câu trả lời có vượt qua rubric hoặc bộ kiểm tra downstream của bạn không? |
| Độ trễ tại p50 / p90 / p99 | Prompt dài có vẫn nằm trong SLA của sản phẩm không? |
| Lỗi mất ngữ cảnh | Mô hình có bỏ qua các факт ở vị trí thấp, ràng buộc của công cụ, hay hướng dẫn cuối cùng không? |
| Độ lệch độ dài đầu ra | Ngữ cảnh dài có gây ra sự dài dòng không cần thiết hoặc đầu ra bị cắt cụt không? |
| Chi phí trên mỗi đầu ra được chấp nhận | Prompt lớn hơn có xứng đáng với chi phí bỏ ra không? |
Nếu Gemini xử lý toàn bộ ngữ cảnh với chi phí thấp nhưng cần nhiều lần thử lại hơn, hãy định tuyến các tác vụ hẹp hơn sang đó và giữ Claude cho suy luận rủi ro cao. Nếu Claude tạo ra tỷ lệ được chấp nhận cao hơn trên cùng gói ngữ cảnh dài, giá token thô cao hơn của nó vẫn có thể rẻ hơn sau khi tính chi phí review và thử lại.
So sánh trực tiếp gọi công cụ và đầu ra có cấu trúc
Khối lượng công việc agent thường thất bại theo những cách rất tầm thường: một đối số bị định dạng sai, một enum do mô hình tự bịa ra, một key thừa trong JSON, một lần gọi công cụ vào sai thời điểm, hoặc một phản hồi nhìn có vẻ ổn nhưng không thể phân tích được. Đó là lý do vì sao Định tuyến API Gemini vs Claude cần kiểm tra công cụ và schema, chứ không chỉ điểm benchmark.
Google tài liệu hóa function calling để kết nối các mô hình Gemini với công cụ và trả về tham số, và structured output cho các phản hồi dựa trên JSON Schema. Anthropic tài liệu hóa Claude tool use cho công cụ phía client và server, cùng structured outputs cho các phản hồi định hướng theo schema.
Hãy dùng một bộ kiểm thử chung:
| Bài kiểm tra | Hành vi đạt |
|---|---|
| Lệnh gọi công cụ bắt buộc | Mô hình gọi đúng công cụ và không trả lời trực tiếp. |
| Trường hợp không cần công cụ | Mô hình từ chối gọi công cụ khi đã có đủ thông tin. |
| Trường enum | Mô hình chỉ trả về các giá trị enum được phép. |
| Đối tượng lồng nhau | Mô hình điền các trường lồng nhau bắt buộc mà không thêm các trường không được hỗ trợ. |
| Lỗi công cụ | Mô hình thử lại, hỏi dữ liệu còn thiếu, hoặc thất bại một cách an toàn theo chính sách. |
| Streaming | Đầu ra một phần không làm hỏng bộ phân tích hay trải nghiệm người dùng. |
| Nỗ lực chèn lệnh | Mô hình tuân theo chính sách của hệ thống và công cụ thay vì văn bản được truy xuất mang tính độc hại. |
Đừng chấm câu trả lời ngôn ngữ tự nhiên trước. Hãy phân tích đầu ra, xác thực JSON, kiểm tra đối số công cụ, rồi mới chấm câu trả lời. Tuyến đường tạo ra văn xuôi hấp dẫn nhất vẫn có thể là tuyến sai cho một agent nếu nó gây ra nhiều hành động không hợp lệ hơn.
Chỉ dùng batch và caching ở những nơi quy trình cho phép
Cả hai nhà cung cấp đều công bố các cơ chế tiết kiệm chi phí có thể làm thay đổi quyết định định tuyến.
Batch API của Google được thiết kế cho các yêu cầu không đồng bộ, khối lượng lớn và tài liệu nêu mục tiêu chi phí chuẩn giảm 50% cho các workload batch đủ điều kiện. Tài liệu Message Batches của Anthropic cũng mô tả mức giảm chi phí 50% cho xử lý batch, với phần lớn batch hoàn tất trong vòng chưa đến một giờ và có các giới hạn kích thước yêu cầu được ghi nhận.
Batch phù hợp mạnh với:
- Phân loại ngoại tuyến.
- Backfill.
- Gán nhãn bộ dữ liệu.
- Các đợt đánh giá quy mô lớn.
- Tạo báo cáo hằng tuần.
- Tóm tắt không khẩn cấp.
Batch phù hợp kém với:
- Các lượt chat.
- Hỗ trợ thời gian thực.
- Vòng lặp bên trong của tác tử lập trình.
- Các lần thử lại hướng tới người dùng.
- Bất kỳ quy trình nào mà đầu ra lỗi thời gây tốn kém.
Cache có hình thái khác. Nếu prompt của bạn lặp lại một chính sách lớn, bản đồ codebase, danh mục sản phẩm hoặc mẫu hợp đồng, các lần đọc cache có thể khiến một lộ trình chất lượng cao hơn trở nên hợp lý về mặt kinh tế. Nếu prompt chủ yếu là duy nhất, cache có thể không giúp ích. Với Claude, trang giá của Anthropic bao gồm các hệ số nhân cho ghi và đọc prompt cache; với Gemini, hãy kiểm tra tài liệu context caching và dòng giá hiện tại trước khi cho rằng mức tiết kiệm đó áp dụng cho workload của bạn.
Quy tắc định tuyến nên đơn giản:
route_policy:
  realtime_user_request:
    primary: low_latency_model_that_passes_schema_tests
    fallback: safest_validated_model
    batch: false
  offline_backfill:
    primary: lowest_accepted_output_cost
    fallback: retry_later_or_second_provider
    batch: true
  repeated_context_agent:
    primary: best_cache_adjusted_acceptance_rate
    fallback: model_with_shorter_context_pack
    batch: false
Kiểm tra độ tin cậy trước khi một tuyến Gemini hoặc Claude đi vào hoạt động
Trạng thái của nhà cung cấp và các giới hạn đã công bố chỉ là điểm khởi đầu. Google tài liệu hóa các giới hạn tốc độ của Gemini theo các chiều như số yêu cầu mỗi phút, số token đầu vào mỗi phút, số yêu cầu mỗi ngày và các giới hạn dựa trên chi tiêu, với giới hạn được áp dụng theo dự án và không đảm bảo năng lực thực tế. Tài liệu của Anthropic mô tả giá mô hình, ngữ cảnh, công cụ, cache và các ràng buộc batch ảnh hưởng đến số lượng cuộc gọi mà quy trình của bạn có thể đẩy một cách an toàn.
Trước khi lưu lượng sản xuất được chuyển sang, hãy chạy một checklist tuyến:
| Kiểm tra | Cần xác minh gì |
|---|---|
| Xác thực | Khóa của nhà cung cấp trực tiếp hoặc khóa gateway được giới hạn đúng theo môi trường. |
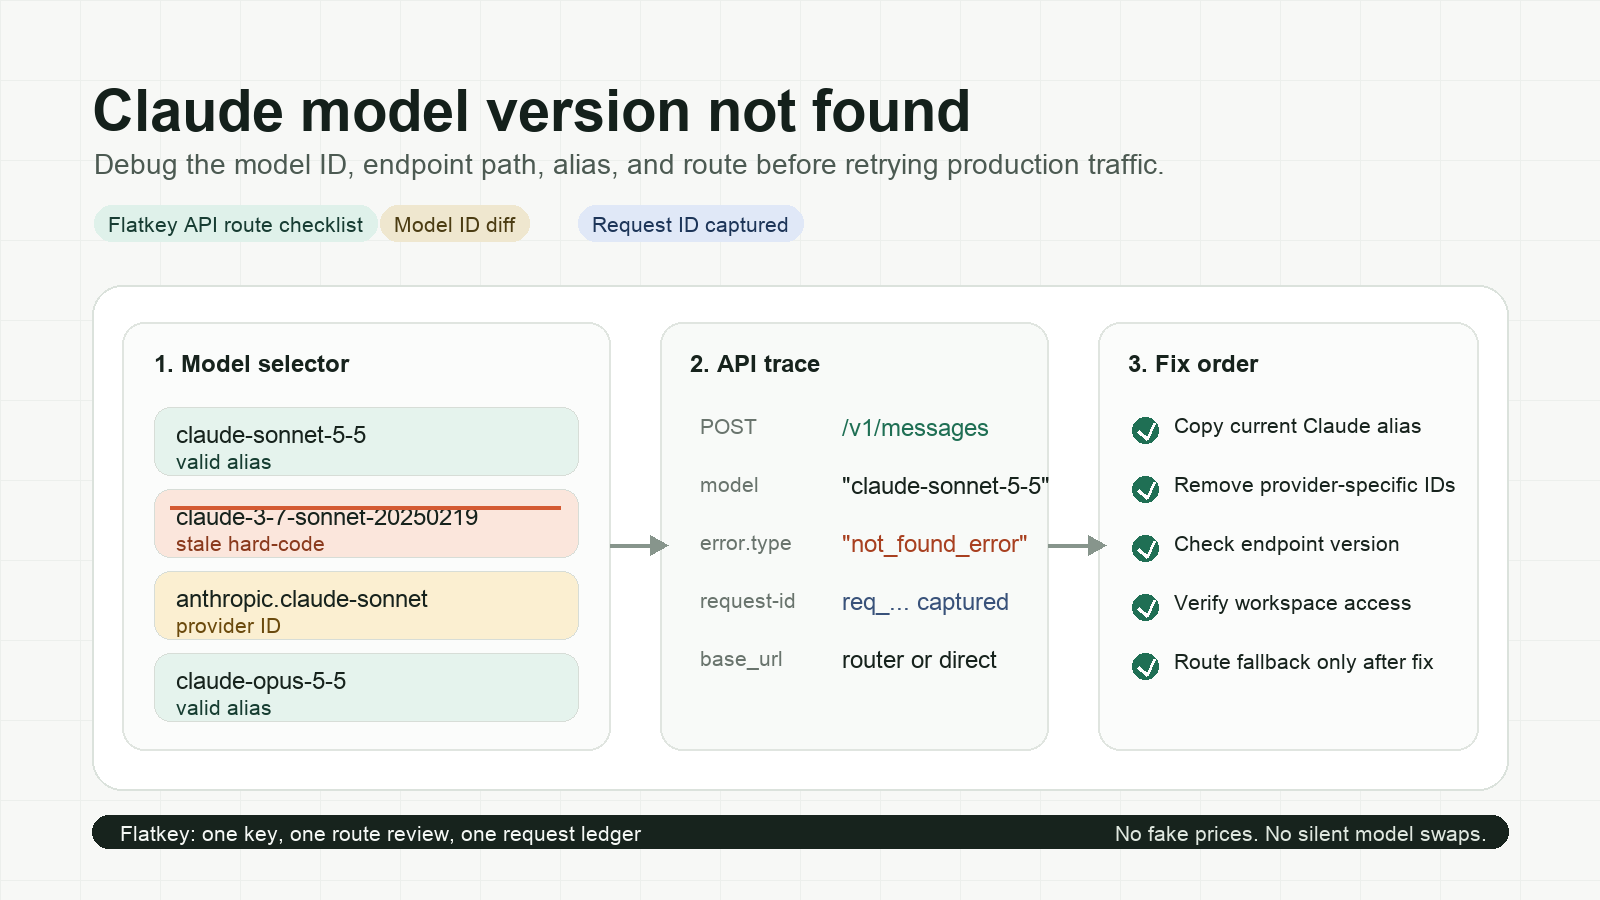
| ID mô hình | ID mô hình chính xác là hiện tại và được lộ trình tài khoản hỗ trợ. |
| Cấu trúc yêu cầu | Trường messages, tools, JSON schema, streaming và modality khớp với lộ trình. |
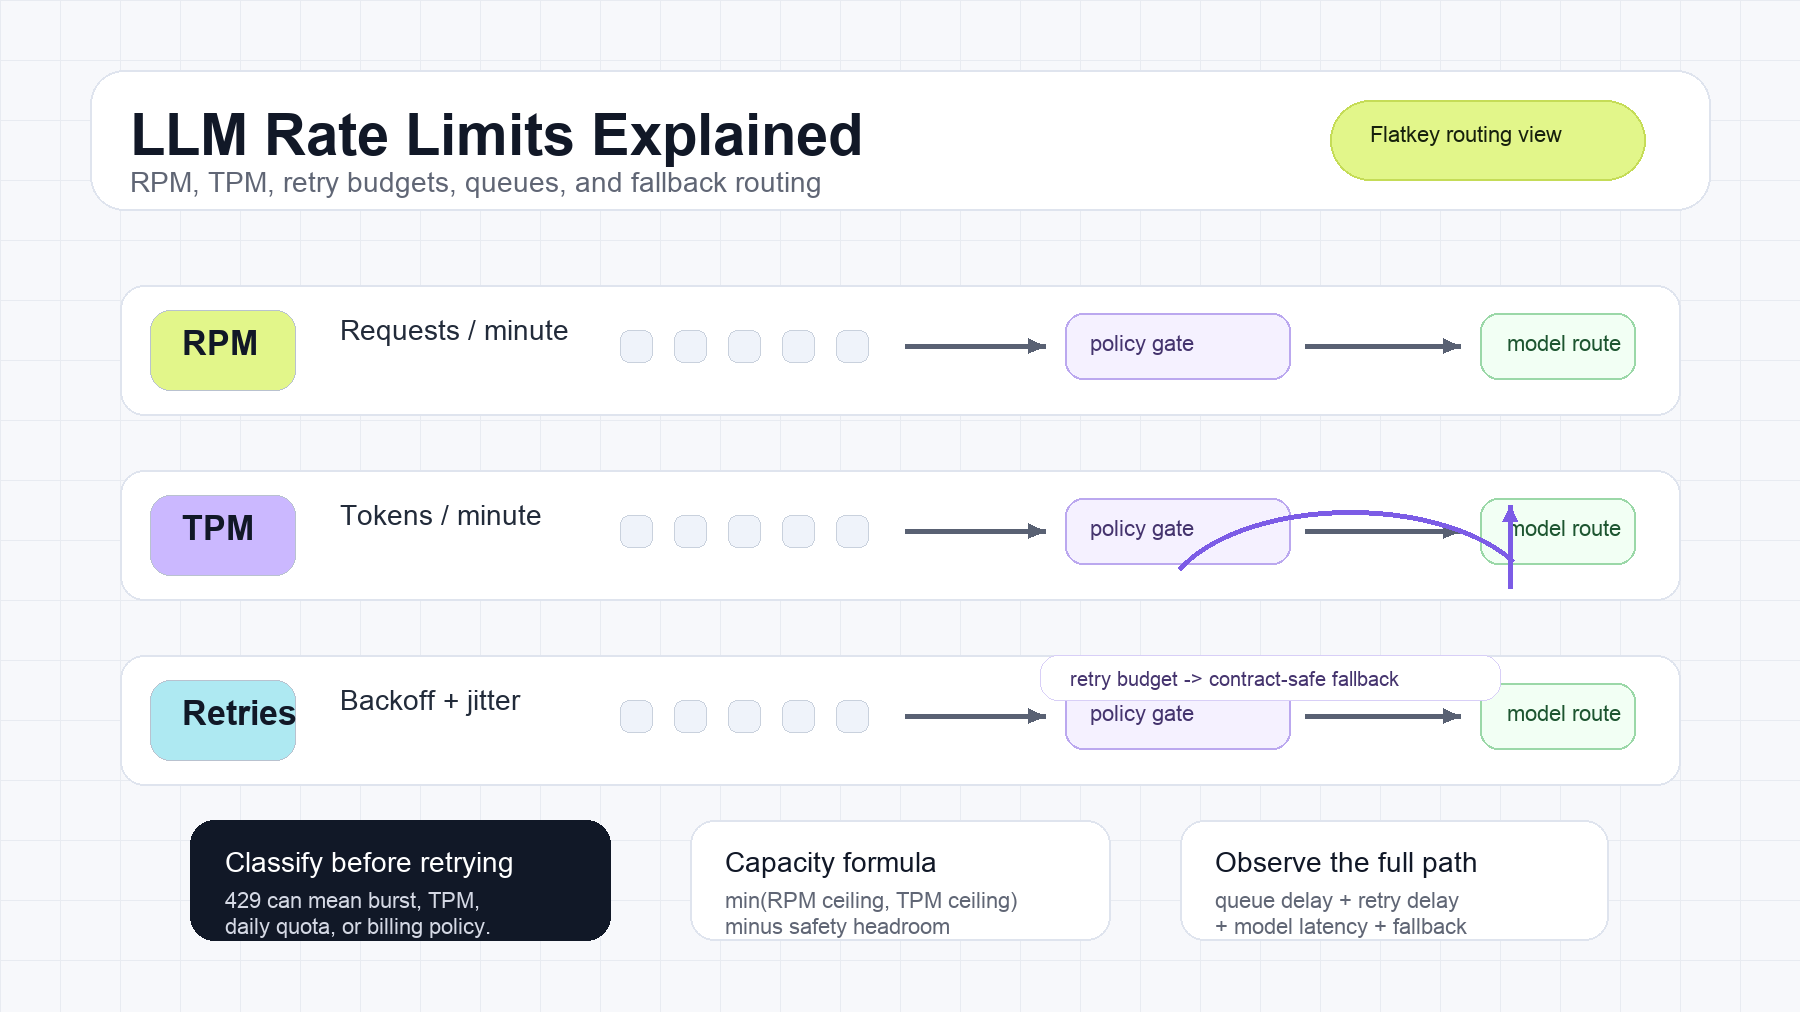
| Giới hạn tốc độ | Nhóm lưu lượng nằm trong giới hạn RPM, TPM, theo ngày và chi tiêu. |
| Ánh xạ lỗi | Các trường hợp 400, 401, 403, 429, 5xx, timeout và nhà cung cấp quá tải được ánh xạ thành hành vi ứng dụng có thể xử lý. |
| Chính sách dự phòng | Ứng dụng biết khi nào nên thử lại cùng lộ trình, chuyển nhà cung cấp, đưa vào hàng đợi hoặc thất bại đóng. |
| Nhật ký chi phí | Mỗi yêu cầu ghi lại mô hình, số lượng token, mức sử dụng cache, chế độ batch, độ trễ, trạng thái và chi phí. |
| Trình xác thực đầu ra | Sản phẩm có trình xác thực cho JSON, lời gọi công cụ, trích dẫn hoặc độ chính xác theo tác vụ cụ thể. |
Bắt đầu nhanh của Flatkey cho thấy mẫu SDK của OpenAI: giữ nguyên SDK và thay đổi base_url thành https://router.flatkey.ai/v1. Tổng quan Flatkey REST API mô tả cùng base URL tương thích với OpenAI, và mục lục tài liệu Flatkey mô tả một khóa, một số dư dùng chung, một danh mục mô hình, cùng tài liệu cho GPT, Claude, Gemini, DeepSeek và các mô hình khác. Sau yêu cầu đầu tiên, phần bắt đầu nhanh của Flatkey hướng dẫn người dùng kiểm tra Usage Logs để xem mô hình, số token, độ trễ và chi phí.
Điều đó khiến Flatkey hữu ích trong một đợt triển khai định tuyến: bạn có thể giữ nguyên định dạng yêu cầu của ứng dụng, so sánh hành vi lộ trình Gemini và Claude trong nhật ký sử dụng, và đưa một cơ chế dự phòng đã được kiểm thử vào vận hành mà không làm phân tán khóa nhà cung cấp trên các dịch vụ.
Đối với các mẫu lập kế hoạch lộ trình liên quan, hãy so sánh quy trình này với danh sách kiểm tra Gemini API cho tác tử của Flatkey và bài viết kiểm tra định tuyến API DeepSeek vs Qwen.
Thẻ điểm định tuyến thực tiễn
Sử dụng thẻ điểm này cho quyết định cuối cùng. Cho mỗi hàng điểm từ 1-5 cho Gemini và Claude, sau đó nhân trọng số theo khối lượng công việc.
| Tiêu chí | Trọng số | Điểm Gemini | Điểm Claude | Ghi chú |
|---|---|---|---|---|
| Chi phí đầu ra được chấp nhận | 25% | Tính cả chi phí retry, cache, batch và công cụ. | ||
| Tính hợp lệ của schema | 15% | Đếm lỗi parser và các giá trị enum không hợp lệ. | ||
| Độ chính xác khi gọi công cụ | 15% | Đếm trường hợp dùng sai công cụ, thiếu trường và dùng công cụ không cần thiết. | ||
| Độ tin cậy của ngữ cảnh | 15% | Kiểm tra ở kích thước prompt p50, p90 và trường hợp xấu nhất. | ||
| Độ trễ | 10% | Đo độ trễ luồng và độ trễ phản hồi đầy đủ. | ||
| Dư địa giới hạn tốc độ | 10% | Kiểm tra giới hạn của dự án/tài khoản trước khi triển khai. | ||
| Khôi phục sau lỗi | 10% | Xác minh các luồng retry, fallback và review bởi con người. |
Ví dụ:
- Một pipeline tóm tắt chạy nền có thể ưu tiên cao nhất cho chi phí đầu ra được chấp nhận và hỗ trợ batch.
- Một agent lập trình có thể ưu tiên cao nhất cho độ chính xác khi gọi công cụ, độ trễ và độ tin cậy của ngữ cảnh.
- Một quy trình hỗ trợ khách hàng có thể ưu tiên cao nhất cho tính hợp lệ của schema, hành vi leo thang và chi phí review.
Đầu ra của Gemini vs Claude API Routing nên là một file chính sách, không phải biên bản cuộc họp.
routes:
  support_triage:
    primary: gemini-or-claude-route-that-wins-scorecard
    fallback: second-provider-route
    validator: support_ticket_schema_v3
    retry_limit: 1
    fail_closed_when:
      - missing_required_field
      - unsafe_escalation_label
  code_review_agent:
    primary: route-that-wins-tool-and-context-tests
    fallback: route-with-best-safe-summary
    validator: diff_comment_schema_v2
    retry_limit: 0
    fail_closed_when:
      - tool_argument_invalid
      - repository_path_not_in_context
Cách chạy so sánh Flatkey an toàn
Flatkey không phải là sự thay thế cho đánh giá. Nó là lớp điều khiển giúp việc đánh giá và triển khai dễ dàng hơn.
- Chọn một workload, chẳng hạn như phân loại hỗ trợ, bình luận review mã, tóm tắt báo cáo hoặc trích xuất.
- Xây dựng một bộ cố định gồm 50-200 prompt thực tế với các quy tắc đầu ra kỳ vọng.
- Chọn một route Gemini và một route Claude từ danh mục model hiện tại.
- Gửi cả hai qua cùng một định dạng request tương thích OpenAI khi có thể.
- Ghi lại số lượng token, độ trễ, trạng thái, nhà cung cấp, model, chi phí và kết quả validator.
- So sánh chi phí trên mỗi đầu ra được chấp nhận, không phải giá trên mỗi triệu token.
- Triển khai lựa chọn thắng cuộc làm primary và giữ lựa chọn còn lại làm fallback được giám sát.
- Chạy lại bài kiểm tra sau khi giá của nhà cung cấp, ID model, giới hạn ngữ cảnh hoặc tình trạng route thay đổi.
Đây là lúc một gateway chứng minh giá trị của nó. Nếu ứng dụng đã dùng một client tương thích OpenAI, Flatkey có thể biến bài kiểm tra đầu tiên chỉ còn là thay đổi base_url cộng với thay đổi lựa chọn model. Nếu route thất bại, bạn rollback chính sách route thay vì viết lại mã ứng dụng.
Các sai lầm phổ biến trong định tuyến API Gemini vs Claude
Sai lầm 1: Chỉ so sánh các mô hình chủ lực.
Hầu hết quy trình làm việc trong sản xuất không cần mô hình đắt nhất cho mọi yêu cầu. Hãy so sánh các lớp định tuyến: nhanh, rẻ, ngữ cảnh dài, nặng về suy luận, batch và dự phòng.
Sai lầm 2: Bỏ qua lược đồ công cụ.
Lời nhắc của tác tử thường bao gồm các định nghĩa công cụ lớn. Hãy đo các token đó và xác thực các đối số của công cụ.
Sai lầm 3: Xem cửa sổ ngữ cảnh như chất lượng câu trả lời.
Cửa sổ ngữ cảnh lớn hơn chỉ hữu ích khi mô hình sử dụng đúng những phần phù hợp của nó một cách đáng tin cậy.
Sai lầm 4: Quên ngữ nghĩa dự phòng.
Mô hình dự phòng có thể tệ hơn là không có dự phòng nếu nó làm thay đổi hình dạng đầu ra, bỏ qua các công cụ bắt buộc, hoặc vi phạm chính sách sản phẩm.
Sai lầm 5: Triển khai một tuyến mà không xem lại nhật ký sử dụng.
Nhật ký của bạn nên cho thấy mô hình thực tế, số token, độ trễ, trạng thái, chi phí và lý do dự phòng. Nếu các trường đó bị thiếu, bạn không thể gỡ lỗi tuyến khi chịu tải.
FAQ
Gemini có rẻ hơn Claude không?
Đôi khi có, nhưng không phải lúc nào cũng vậy sau khi xác thực. Gemini thường có mức giá niêm yết hấp dẫn cho các khối lượng công việc kiểu Flash, trong khi Claude có thể thắng khi tỷ lệ chấp nhận cao hơn, ít lần thử lại hơn, hành vi công cụ tốt hơn, hoặc chi phí rà soát thấp hơn bù cho mức giá token cao hơn. Hãy dùng các trang giá của nhà cung cấp và tính chi phí trên mỗi đầu ra được chấp nhận.
Claude có tốt hơn Gemini cho gọi công cụ không?
Không phải lúc nào cũng vậy. Claude có tài liệu sử dụng công cụ mạnh và các mẫu hướng tới tác tử, trong khi Gemini hỗ trợ function calling và đầu ra có cấu trúc. Câu trả lời đúng phụ thuộc vào lược đồ công cụ, xử lý lỗi, nhu cầu streaming và kết quả của bộ xác thực.
Tôi có nên định tuyến mọi yêu cầu qua một nhà cung cấp trước không?
Thường là không. Hãy chia lưu lượng theo lớp khối lượng công việc. Một tuyến batch rẻ, một tuyến chat thời gian thực, một tuyến ngữ cảnh dài và một tuyến dự phòng có thể đều dùng các mô hình khác nhau.
API batch có làm các tuyến realtime rẻ hơn không?
Không. Chiết khấu batch giúp ích cho khối lượng công việc có thể trì hoãn. Nó không giúp người dùng đang chờ phản hồi cho chat, hỗ trợ hoặc tác tử lập trình.
Tại sao nên dùng Flatkey cho định tuyến API Gemini vs Claude?
Hãy dùng Flatkey khi bạn muốn một control plane tương thích OpenAI cho việc chọn mô hình, nhật ký sử dụng, rà soát chi phí và triển khai dự phòng. Nó đặc biệt hữu ích khi ứng dụng đã dùng SDK kiểu OpenAI và cần so sánh Gemini và Claude mà không phải phân tán khóa nhà cung cấp và các chế độ xem thanh toán trên nhiều dịch vụ.
Kết luận
Định tuyến API Gemini vs Claude: Chi phí, ngữ cảnh, công cụ và kiểm tra độ tin cậy không phải là một phép so sánh nhà cung cấp chỉ làm một lần. Đó là một quy trình vận hành. Hãy bắt đầu với giá và tài liệu mô hình chính thức, kiểm thử ngữ cảnh và hành vi công cụ trên các prompt thực, chấm điểm chi phí trên mỗi đầu ra được chấp nhận, và chuẩn bị sẵn chính sách dự phòng trước khi lưu lượng sản xuất được chuyển sang.
Nếu đội của bạn muốn so sánh Gemini và Claude thông qua một cổng tương thích OpenAI duy nhất, hãy bắt đầu với Flatkey quickstart, chọn các ứng viên tuyến từ danh mục mô hình hiện tại, và xác minh các cuộc gọi đầu tiên trong Usage Logs trước khi mở rộng lưu lượng.