
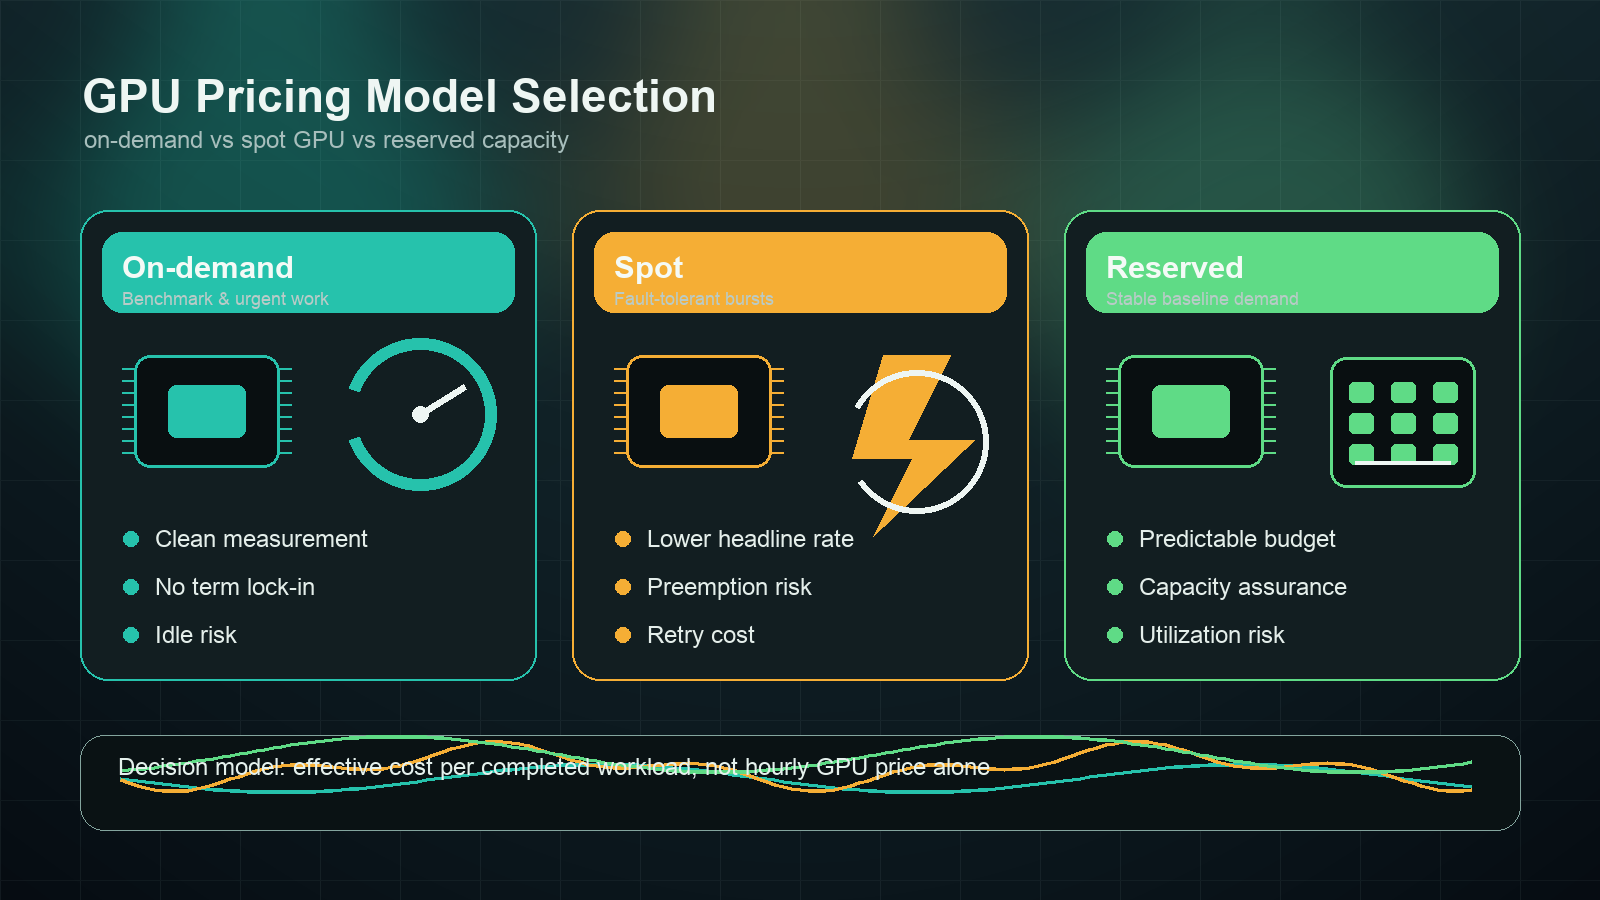
Die Wahl zwischen On-Demand- und Spot-GPU-Kapazität ist nicht nur eine Frage der Preisliste. Der günstigere Stundenpreis kann am Ende teurer sein, wenn Jobs neu gestartet werden, Checkpoints schwach sind, Daten erneut geladen werden müssen oder Ingenieure Tage damit verbringen, unterbrechbare Maschinen am Laufen zu halten. Reservierte GPU-Kapazität kann ebenfalls günstiger aussehen, bis sich die Nachfrage nach dem Modell verschiebt und das Team an unausgelastete Hardware gebunden ist.
Dieser Leitfaden vergleicht On-Demand-, Spot- und reservierte GPU-Preise für Einkäufer von KI-Infrastruktur, FinOps-Teams und Plattformingenieure, die ein praxisnahes Entscheidungsmodell für Workloads benötigen. Die kurze Antwort: Verwenden Sie On-Demand-GPUs für erste Messungen und dringende Aufgaben, Spot-GPUs für fehlertolerante Batch-Workloads und reservierte GPU-Kapazität erst dann, wenn Sie eine Basisauslastung nachweisen können.
Wenn Sie noch entscheiden, ob Sie überhaupt GPUs mieten sollten, beginnen Sie mit den umfassenderen Leitfäden zu GPU-Mietpreisen und GPU-Cloud vs. Model API. Dieser Artikel konzentriert sich auf die Wahl des Preismodells, nachdem Sie bereits wissen, dass GPU-Kapazität in den Plan gehört.
Die kurze Antwort: On-Demand vs. Spot-GPU vs. reserviert
Für die meisten Teams sollte der erste Blick folgendermaßen aussehen:
| Preismodell | Am besten geeignet für | Hauptrisiko | Zu beobachtende Kennzahl |
|---|---|---|---|
| On-Demand-GPU | Benchmarks, dringende Experimente, Demos, frühe Produktion, unbekannte Auslastung | Leerlaufzeit und höherer offizieller Stundenpreis | Nützliche GPU-Aktivminuten / abrechenbare Minuten |
| Spot-GPU | Batch-Inferenz, Offline-Auswertungen, checkpoint-basiertes Training, Medien-Queues, Worker mit Wiederholungsversuchen | Verdrängung, Warteschlangenverzögerung, Neustartverluste, doppelte Arbeit | Abgeschlossene Jobs nach Unterbrechungskosten |
| Reservierte GPU | Stabile Produktions-Inferenz, geplantes Training, Startfenster, dedizierte Cluster | Unterauslastung, Hardware-Lock-in, Vertragsinkongruenz | Basisauslastung im Verhältnis zum Break-even der Verpflichtung |
Die robuste Regel für Entscheidungen zwischen On-Demand und Spot-GPU ist einfach: Vergleichen Sie die effektiven Kosten pro abgeschlossenem Workload, nicht die beworbene GPU-Stunde.
effektive Kosten pro abgeschlossenem Workload =
  (Compute + Speicher + Bandbreite + Leerlaufzeit + Neustartverluste + Support + Engineering-Overhead)
  / akzeptierte Jobs, trainierte Tokens, Inferenz-Tokens, Bilder, Clips oder Benchmark-Durchläufe
Diese Formel ist wichtig, weil jedes Modell das Risiko an einen anderen Ort verlagert. On-Demand verlagert das Risiko in die Leerlaufzeit. Spot verlagert das Risiko in Unterbrechungen und Orchestrierung. Reservierte Kapazität verlagert das Risiko in die Prognosegenauigkeit.
Was On-Demand-GPU-Preise bedeuten
On-Demand-GPU-Preise sind die sauberste Ausgangsbasis. Sie zahlen, solange die Instanz, der Pod oder der Server läuft, ohne langfristige Verpflichtung. AWS beschreibt On-Demand-Instances als Pay-as-you-go-Kapazität ohne langfristige Verpflichtungen. Spezialisierte GPU-Clouds verwenden eine ähnliche Sprache für Pods, Instanzen oder stündliche GPU-Server, auch wenn sich die Abrechnungseinheit und der enthaltene Speicher unterscheiden.
Nutzen Sie On-Demand zuerst, wenn der Workload noch unbekannt ist:
| Anwendungsfall | Warum On-Demand passt |
|---|---|
| Erster Benchmark eines Modells oder Serving-Stacks | Sie benötigen sauberes Timing ohne Unterbrechungsvariablen. |
| Validierung von Treiber, CUDA, Container oder Framework | Debugging sollte nicht mit dem Risiko einer Spot-Verdrängung vermischt werden. |
| Kundendemo oder QA-Umgebung | Vorhersehbarkeit ist wichtiger als der niedrigste Tarif. |
| Früher Produktions-Endpunkt | Sie brauchen Verfügbarkeit, bevor Sie stabile Auslastungsdaten haben. |
| Kurzer dringender Trainings- oder Fine-Tuning-Lauf | Warteschlangenverzögerung kann mehr kosten als Stundenersparnisse. |
Die Falle ist die Leerlaufzeit. Wenn ein Notebook, Pod oder Inferenzserver 100 abrechenbare Stunden läuft, die GPU aber nur 28 nützliche Stunden aktiv ist, sind die tatsächlichen Kosten nicht der angegebene Stundenpreis des Anbieters. Der reale Satz wird durch Leerlaufverluste aufgebläht.
effektiver On-Demand-Stundenpreis =
  angegebener On-Demand-Stundenpreis / nützlicher Auslastungsanteil
Bei 35 % Auslastung verhält sich eine $4/Stunde-GPU vor Speicher, Bandbreite oder Engineering-Overhead wie eine Ressource von $11.43/nützliche Stunde. Für Entscheidungen zwischen On-Demand und Spot-GPU gilt: Beheben Sie Leerlauf-Abschaltungen und Queue-Packaging, bevor Sie einen besseren Stundenpreis verhandeln.
Was Spot-GPU-Preise bedeuten
Spot-GPU-Preise nutzen überschüssige oder unterbrechbare Kapazität. AWS sagt, dass EC2 Spot Instances ungenutzte EC2-Kapazität verwenden und Rabatte von bis zu 90 % gegenüber On-Demand-Preisen bieten können. Google Cloud Spot VMs und Azure Spot Virtual Machines folgen dem gleichen Grundmuster: günstiger verfügbare Kapazität, die vorzeitig beendet oder verdrängt werden kann, wenn die Cloud sie zurück benötigt.
Spot-GPUs sind für KI-Workloads attraktiv, weil Training, Auswertung, Bilderzeugung und Batch-Inferenz oft große, wiederholbar verarbeitbare Teile haben. Aber „wiederholbar“ passiert nicht automatisch. Sie brauchen Checkpointing, idempotente Jobs, Datenlokalität, Monitoring und einen Scheduler, der ohne Ergebnisbeschädigung neu starten kann.
Spot ist normalerweise ein starker Kandidat, wenn:
- Trainingsjobs häufig Checkpoints erstellen und sauber fortgesetzt werden können.
- Batch-Inferenz ohne für den Nutzer sichtbaren Fehler erneut versucht werden kann.
- Offline-Auswertungen über viele Worker laufen können.
- Mediengenerierungsjobs hinter einer Queue stehen.
- Ein ausgefallener Worker den gesamten Multi-Node-Job nicht ungültig macht.
- Das Team bereits Orchestrierung für Verdrängungen und doppelte Vermeidung hat.
Spot ist normalerweise ein schwacher Kandidat, wenn:
- Ein einzelner mehrtägiger Trainingslauf startet von einem alten Checkpoint neu.
- Die Startzeit wird hauptsächlich durch das Herunterladen von Modellen, Images oder Datensätzen bestimmt.
- Die Latenz für kundennahe Dienste hängt davon ab, dass die Maschine eingeschaltet bleibt.
- Multi-Node-Training schlägt fehl, wenn ein Worker verschwindet.
- Ingenieure müssen Neustarts manuell betreuen.
Für die Vor- und Nachteile von Spot- gegenüber On-Demand-GPU-Instanzen sollte die Rechnung Verschwendungsanteile durch Unterbrechungen einschließen:
effektiver Stundenpreis von Spot =
  stündlicher Spot-Preis / (1 - Anteil der Verschwendung durch Unterbrechungen)
Wenn Spot 60 % günstiger ist, aber Unterbrechungen, erneutes Laden von Daten, fehlgeschlagene Schritte und Wartezeiten in der Queue 35 % der verstrichenen Arbeit verschwenden, ist der tatsächliche Rabatt deutlich kleiner als der angegebene Preis. Wenn der Neustartverlust in die gleiche Größenordnung wie der Rabatt kommt, ist On-Demand-Kapazität oft die sauberere Wahl.
Was reservierte GPU-Preisgestaltung bedeutet
Reservierte GPU-Preisgestaltung ist ein Commitment-Modell. Es kann als Reserved Instances, Savings Plans, Committed-Use-Discounts, reservierte Cluster, private Kapazität, Kapazitätsblöcke oder dedizierte GPU-Verträge auftreten. Die Bezeichnungen unterscheiden sich je nach Anbieter, aber der Kompromiss ist derselbe: Sie tauschen Flexibilität gegen vorhersehbare Kapazität oder einen niedrigeren effektiven Satz ein.
Reservierte GPU-Kapazität ist sinnvoll, wenn:
| Signal | Was es bedeutet |
|---|---|
| Stabiles grundlegendes Inferenz-Volumen | Sie können GPUs über die meisten Stunden des Monats ausgelastet halten. |
| Wiederkehrender Trainingsplan | Sie wissen, wann Kapazität benötigt wird und für wie lange. |
| Anforderung an Startkapazität | Sie können sich nicht auf Best-Effort-Spot-Verfügbarkeit verlassen. |
| Anforderung an Multi-Node-Topologie | Netzwerkplatzierung, Fabric und Speicher-Nähe spielen eine Rolle. |
| Beschaffung benötigt festen Aufwand | Ein bekannter monatlicher Commit ist leichter zu genehmigen als schwankender Verbrauch. |
Die zentrale Frage bei reservierter Kapazität ist der Break-even bei der Auslastung:
Break-even-Auslastung der Reservierung =
  monatlicher Reserve-Commit
  / (On-Demand-Stundensatz * Stunden im Monat)
Wenn der reservierte Commit den Break-even bei 62 % Auslastung erreicht und Ihre tatsächliche Grundauslastung 25 % beträgt, ist reservierte Kapazität kein Rabatt. Es ist ein Abonnement für ungenutzte Kapazität. Für GPU-Cluster kombinieren Sie dies mit dem Modell für die GPU-Cluster-TCO, damit Netzwerk, Storage, Support, Remote Hands und Betrieb berücksichtigt werden.
Entscheidungsmatrix nach Workload
Das beste Preismodell hängt mehr von Fehlertoleranz und Auslastung ab als allein von der Modellgröße.
| Workload | Besserer Ausgangspunkt | Warum |
|---|---|---|
| Erster Modell-Benchmark | On-Demand-GPU | Sie benötigen eine saubere Basis für Durchsatz, Latenz, Speicher und Fehlermodi. |
| Bewertung eines neuen Serving-Stacks | On-Demand-GPU | Validieren Sie vLLM, SGLang, TensorRT-LLM, Treiber, Images und das Laden des Modells, bevor Sie den Preis optimieren. |
| Offline-Eval-Suite | Spot-GPU | Ergebnisse können erneut versucht, aufgeteilt und auf doppelte Arbeit geprüft werden. |
| Batch-Embedding oder Batch-Inferenz | Spot-GPU, mit On-Demand-Fallback | Jobs sind warteschlangenfähig, wenn Idempotenz- und Retry-Kontrollen vorhanden sind. |
| Kundennahe Inferenz-Basislast | Reserviert plus On-Demand-Burst | Stabile Nachfrage kann ein Commitment rechtfertigen; Burst bleibt flexibel. |
| Einmaliger Launch oder kurze Kampagne | On-Demand oder Kapazitätsblock | Kapazitätssicherheit kann wichtiger sein als ein langfristiger Rabatt. |
| Verteiltes Multi-Node-Training | Reserviertes oder dediziertes Cluster | Platzierung, Netzwerk-Fabric und Fehlerdomänen dominieren den Stundenpreis. |
| AI-Produktfunktion mit geringem Volumen | Modell-API oder Gateway | Ungenutzte GPU-Kapazität kann mehr kosten als verwaltete, nutzungsbasierte Inferenz. |
Für die Auswahl des GPU-Modells innerhalb jeder Zeile kombinieren Sie diesen Artikel mit dem Leitfaden zur Auswahl von AI-GPUs, der besten GPU für LLM-Inferenz und dem vLLM-Deployment-Leitfaden.
On-Demand- vs. Spot-GPU-Ökonomie: ein einfaches Beispiel
Angenommen, ein Inferenz-Batch kann auf derselben GPU-Klasse entweder im On-Demand- oder im Spot-Modus ausgeführt werden.
| Feld | On-Demand | Spot |
|---|---|---|
| Ausgewiesener Stundenpreis | $4.00 |
$1.80 |
| Nutzbare Auslastung | 70% |
70% |
| Verschwendung durch Neustarts und Evictions | 0% |
22% |
| Effektive Kosten pro nutzbarer Stunde | $5.71 |
$3.30 |
Spot gewinnt in diesem Beispiel immer noch, weil der Rabatt größer ist als die Verschwendung. Ändern Sie nun die Neustart-Verschwendung auf 55 %, weil der Job wiederholt Gewichte neu lädt und teilweise Batches verliert.
| Feld | On-Demand | Spot |
|---|---|---|
| Ausgewiesener Stundenpreis | $4.00 |
$1.80 |
| Nutzbare Auslastung | 70% |
70% |
| Verschwendung durch Neustarts und Evictions | 0% |
55% |
| Effektive Kosten pro nutzbarer Stunde | $5.71 |
$5.71 |
An diesem Punkt verschwindet der scheinbare Spot-Rabatt. Deshalb sollte ein Vergleich von On-Demand- und Spot-GPUs auch den betrieblichen Aufwand berücksichtigen und nicht nur den Spot-Prozentsatz des Anbieters.
Reserved-GPU-Ökonomie: der Auslastungstest
Reservierte Kapazität braucht einen anderen Test. Angenommen, eine On-Demand-GPU kostet $4/hour, und eine monatliche Reservierung für vergleichbare Kapazität kostet $1,900/month.
monatliche On-Demand-Kosten bei 100 % Auslastung =
  $4 * 730 hours = $2,920

Break-even-Auslastung für Reservierung =
  $1,900 / $2,920 = 65%
Diese Reservierung ist nur attraktiv, wenn die Workload die GPU mehr als etwa zwei Drittel des Monats beschäftigt halten kann. Wenn Ihr Produktions-Endpunkt die GPU während der Geschäftszeiten stark nutzt, nachts und am Wochenende aber im Leerlauf ist, kann die reale Baseline unter dem Break-even-Punkt liegen.
Die Beschaffungsvariante der Frage lautet:
- Was ist die gemessene Baseline und nicht der prognostizierte Peak?
- Welche Workloads dürfen ungenutzte reservierte Kapazität auslasten?
- Was passiert, wenn das Modell von H100 auf H200, B200, L40S oder eine verwaltete API wechselt?
- Sind Storage, Support, Netzwerke und Egress innerhalb oder außerhalb der Verpflichtung enthalten?
- Kann der Vertrag reduziert werden, den GPU-Typ konvertieren oder die Region wechseln?
Reservieren Sie nicht auf Hoffnung hin. Reservieren Sie auf Basis gemessener Auslastung.
Anbieterseitige Quellen-Checkliste
GPU-Preisseiten ändern sich häufig, und Marketplace-Preise können sich schneller ändern als ein Beschaffungszyklus. Verwenden Sie dies als Quellen-Checkliste und nicht als eingefrorene Preisliste. Prüfen Sie sie erneut an dem Tag, an dem Sie Ausgaben freigeben.
| Anbieterkategorie | Zu prüfende offizielle Quelle | Was zu erfassen ist |
|---|---|---|
| AWS | Amazon EC2 pricing, EC2 Spot Instances, EC2 Capacity Blocks for ML | Region, GPU-Instance-Familie, On-Demand, Spot, Savings Plans oder Reserved Instances, Timing der Capacity Blocks, EBS, Datenübertragung, Support. |
| Google Cloud | Compute Engine GPU pricing, Spot VMs, Committed use discounts | GPU-Typ, Maschinenfamilie, Region, Spot-VM-Status, Laufzeit der Verpflichtung, Reservierungsbedarf, Persistent Disk, Netzwerk-Egress. |
| Microsoft Azure | Azure Spot Virtual Machines, Reserved VM Instances | GPU-VM-SKU, Region, Eviction-Richtlinie, Einstellung des Maximalpreises, Reservierungslaufzeit, verwaltete Festplatte, Bandbreite, Support. |
| RunPod | RunPod pricing und Produktdokumentation | Secure Cloud vs. Community Cloud, Pod-Preise, Serverless-Preise, persistenter Speicher, Netzwerk-Volume, Cold-Start-Verhalten. |
| Vast.ai | Vast.ai pricing und Vast.ai docs | Host-Zuverlässigkeit, Rechenzentrum-/Community-Status, Interruptible-Flag, Festplatte, Bandbreite, verifizierter Host, Bedarf an öffentlicher IP. |
| Lambda | Lambda Cloud GPU pricing | Instanztyp, GPU-Anzahl, Region, Verfügbarkeit nach Bedarf, Bedingungen des Reserved-Cluster-Angebots, Annahmen zu Storage und Netzwerken. |
Fügen Sie Ihrer Tabelle eine Zeile mit dem Prüfdatum hinzu. Für diesen Artikel wurde die Quellen-Checkliste am 13. Oktober 2026 überprüft.
Beschaffungsfragen, bevor Sie sich entscheiden
Bevor Sie sich für On-Demand- vs. Spot-GPU-Kapazität entscheiden oder einen Reserved-GPU-Vertrag unterschreiben, stellen Sie diese Fragen:
| Frage | Warum das wichtig ist |
|---|---|
| Kann der Job Checkpoints erstellen und ohne manuelle Reparatur fortgesetzt werden? | Bestimmt, ob das Risiko einer Spot-Unterbrechung akzeptabel ist. |
| Wie lange dauert der Start, bevor nützliche GPU-Arbeit beginnt? | Langsames Laden von Modell und Daten reduziert Spot-Einsparungen und verschlechtert die On-Demand-Effizienz. |
| Wie hoch ist die gemessene Leerlaufzeit? | Leerlaufzeit ist die größte Kostenfalle bei On-Demand. |
| Was ist die Baseline und nicht der Peak? | Reservierte Preise funktionieren nur, wenn die Baseline-Nachfrage real ist. |
| Benötigt die Workload eine bestimmte Region oder ein bestimmtes Netzwerk-Fabric? | Eine knappe Topologie kann allgemeine Spot-/On-Demand-Tarife irrelevant machen. |
| Sind Storage, Snapshots, Bandbreite und Support enthalten? | GPU-Stunden sind nur eine Position auf der tatsächlichen Rechnung. |
| Wie sieht der Ausstiegsweg aus, wenn sich die Modellwahl ändert? | Hardware-Lock-in ist teuer, wenn sich die Modellarchitektur verschiebt. |
| Kann stattdessen eine verwaltete Modell-API die Anforderung erfüllen? | Workloads mit geringer Auslastung oder mehreren Modellen rechtfertigen den GPU-Betrieb möglicherweise nicht. |
Für Entscheidungen zu Multi-Node- und privater Kapazität vergleichen Sie dies mit GPU cluster rental und private GPU cloud.
Wann eine Modell-API alle drei GPU-Preismodelle schlägt
On-Demand-, Spot- und reservierte GPUs setzen alle voraus, dass das Mieten und Betreiben von Hardware die richtige Abstraktionsebene ist. Das ist nicht immer der Fall.
Eine verwaltete Model-API kann der wirtschaftlich bessere Ausgangspunkt sein, wenn:
- die Auslastung gering, unregelmäßig oder unbekannt ist.
- das Produkt viele Modelle statt eines selbst gehosteten Modells benötigt.
- Zuverlässigkeit, Upgrades und Skalierung vom Produkt-Roadmap ablenken würden.
- das Team Nutzungsprotokolle, Budgets und Rechnungen mehr braucht als Hardwarekontrolle.
- die Workload produktive Inferenz statt Modelltraining oder Forschung an benutzerdefiniertem Serving ist.
Flatkey sitzt auf dieser API-Seite der Entscheidung. Es gibt KI-Teams einen API-Schlüssel, ein Guthaben, eine Rechnung, Transparenz über die Nutzung und Zugriff auf offizielle Modellrouten über Anbieter hinweg. Wenn das On-Demand-vs.-Spot-GPU-Arbeitsblatt zeigt, dass die Hardwareauslastung noch nicht hoch genug ist, vergleichen Sie die Kosten pro akzeptiertem Ergebnis einer verwalteten API, bevor Sie GPU-Kapazität kaufen oder reservieren. Der nächste Schritt sind die Leitfäden AI model pricing comparison und AI gateway pricing.
Abschließende Empfehlung
Verwenden Sie diese Reihenfolge:
- Beginnen Sie mit On-Demand-GPU-Kapazität, bis die Benchmark- und Auslastungszahlen verlässlich sind.
- Verschieben Sie wiederholbar ausführbare Jobs erst dann auf Spot-GPUs, wenn Checkpointing, Idempotenz und Restart-Automatisierung nachgewiesen sind.
- Reservieren Sie GPU-Kapazität nur für gemessenen Grundbedarf, verbindliche Startfenster oder Cluster, die von der Topologie abhängen.
- Halten Sie einen Modell-API-Pfad offen, wenn die Auslastung gering ist, sich die Modellauswahl häufig ändert oder die Finanzabteilung eine sauberere Zuordnung der Nutzung benötigt.
Die beste On-Demand-vs.-Spot-GPU-Entscheidung ist nicht die mit dem niedrigsten angegebenen Stundenpreis. Es ist die On-Demand-vs.-Spot-GPU-Entscheidung, die die Kosten pro abgeschlossenem Workload minimiert und das Zuverlässigkeitsrisiko dort belässt, wo Ihr Team es tatsächlich managen kann.


