
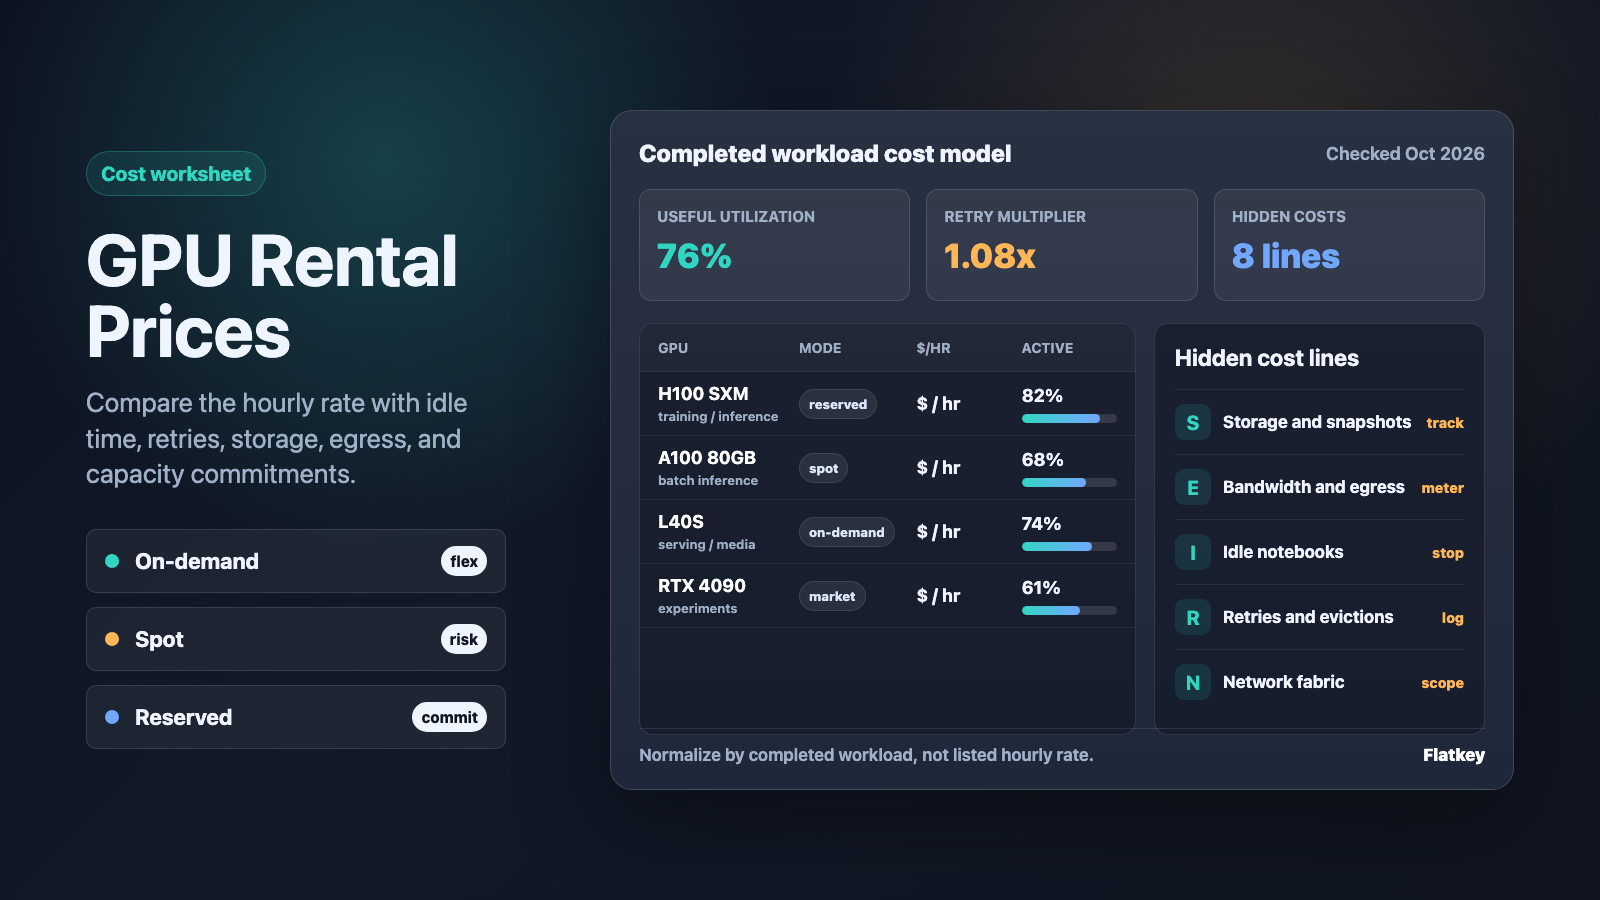
Цены на аренду GPU: on-demand, spot, reserved и скрытые расходы
Цены на аренду GPU кажутся простыми, пока вы не попытаетесь спрогнозировать реальный обучающий запуск, вывод в продакшн или пакетную генерацию изображений. Заявленная почасовая ставка — это лишь одна статья расходов. Итоговый счёт также зависит от того, является ли GPU on-demand, spot или interruptible, reserved, serverless или dedicated; как долго машина простаивает без работы; где находится хранилище; какой объём данных покидает регион; и сколько работы по обеспечению надёжности должна взять на себя ваша команда.
Это руководство даёт разработчикам, основателям AI-компаний, platform-командам и специалистам по закупкам практичный способ сравнивать цены на аренду GPU, не попадаясь в ловушку одной привлекательной почасовой цифры.
Коротко: сравнивайте стоимость за завершённый час рабочей нагрузки, а не только цену GPU за час.
Быстрая схема сравнения цен на аренду GPU
Начинайте любое сравнение цен на аренду GPU с одной нормализованной формулы:
effective GPU cost per completed workload =
  (GPU compute + storage + snapshots + bandwidth + idle time + retries + support + engineering overhead)
  / completed training, inference, batch, or media job units
Затем разделите решение на четыре вопроса:
| Вопрос | Почему это меняет цены на аренду GPU |
|---|---|
| Какой класс GPU вам нужен? | Машины классов H100, H200, B200, A100, L40S, RTX 4090 и RTX 6000 отличаются по памяти, сети, доступности и ценовым кривым. |
| Насколько предсказуема рабочая нагрузка? | Стабильный production inference может оправдать reserved или committed capacity; эксперименты и всплесковые задачи часто лучше подходят для on-demand или spot. |
| Насколько задача допускает прерывание? | Spot и ёмкость на community-marketplace могут быть дешевле, но именно повторные попытки и checkpointing решают, действительно ли это дешевле. |
| Что находится за пределами GPU-часа? | Хранилище, snapshots, egress, неиспользуемые ноутбуки, загрузка контейнеров, планы поддержки и кластерные сети могут изменить реальную стоимость. |
Для большинства команд правильный ответ — не «найти самый дешёвый GPU». Правильный ответ — «арендовать самую дешёвую надёжную мощность, которая завершит задачу с приемлемым временем ожидания в очереди, риском перезапуска и операционными накладными расходами».
Таблица текущих источников цен
Цены на аренду GPU часто меняются, а страницы маркетплейсов могут обновляться быстрее, чем проходят процедуры закупок. Рассматривайте таблицу ниже как список источников, а не как зафиксированный прайс-лист. Фиксируйте дату проверки, модель GPU, регион, объём памяти, единицу тарификации и то, является ли цена on-demand, spot, reserved, community, secure cloud, serverless или dedicated.
| Провайдер или рынок | Официальный источник цен для проверки | Что фиксировать | Примечания для сравнения |
|---|---|---|---|
| Vast.ai | Цены Vast.ai и FAQ Vast.ai | Модель GPU, надёжность хоста, статус interruptible, хранилище, bandwidth, уровень верификации, дата-центр или community host | Цены на аренду GPU в Vast.ai зависят от рынка, поэтому два предложения с RTX 4090 или H100 могут различаться по локации, хосту, надёжности, хранилищу и сети. |
| RunPod | Цены RunPod и документация RunPod по storage и network volume | Secure Cloud vs Community Cloud, модель GPU, хранилище pod, network volume, цены serverless worker, время простоя | Цены на аренду GPU в RunPod зависят от типа облака и режима продукта. Сравнивайте pods, serverless и хранилище отдельно. |
| Massed Compute | Цены Massed Compute | Почасовая ставка GPU on-demand, долгосрочное reservation или предложение по кластеру, память GPU, регион, объём поддержки | Цены на аренду GPU в Massed Compute полезны для бенчмарка выделенной AI cloud capacity, но для частных или reserved-кластеров может потребоваться коммерческое предложение. |
| Lambda Cloud | Цены Lambda Cloud | GPU-инстанс on-demand, количество GPU, локальное хранилище, доступность региона, условия reserved cluster | Lambda публикует простые почасовые ставки для GPU cloud на распространённых инстансах NVIDIA; перед планированием срочного запуска проверьте текущую доступность. |
| AWS EC2 | Цены Amazon EC2 и EC2 Spot Instances | Семейство инстансов, регион, On-Demand, Spot, Savings Plans, Reserved Instances, EBS, передача данных, поддержка | AWS часто служит эталонной моделью для экономики on-demand, spot и committed-use, но важны семейства GPU-инстансов и доступность по регионам. |
| Google Cloud | Цены на GPU в Compute Engine и Spot VMs | Тип GPU, семейство машин, регион, статус Spot VM, committed use discount, persistent disk, network egress | Google Cloud разделяет механику оплаты за GPU, машину, диск, сеть и скидки. Нормализуйте всё это перед сравнением со специализированными GPU-cloud. |
Добавьте одну строку ко всем строкам источников: проверено 12 октября 2026. Если вы будете использовать эту таблицу позже, обновите дату проверки перед повторным использованием любого числа.
Цены на аренду GPU on-demand
Цены на аренду GPU по модели on-demand — самый понятный старт: вы платите за вычислительную мощность GPU, пока экземпляр, pod или сервер работает, обычно без долгосрочных обязательств. Это режим, который большинству команд стоит использовать для первых бенчмарков, потому что он упрощает инженерные переменные.
On-demand обычно является правильным вариантом по умолчанию, когда:
- Вы тестируете новую модель, фреймворк, датасет или prompt-пайплайн.
- Задача срочная и не может ждать доступности spot-емкости.
- Вам нужен стабильный endpoint для демо, QA или раннего клиентского трафика.
- Вы пока недостаточно хорошо знаете уровень загрузки, чтобы резервировать мощность.
- Вам важнее поддержка провайдера и предсказуемая сеть, чем самая низкая почасовая ставка.
Риск — простои. Ноутбук на GPU, который стоит меньше в час, всё равно может оказаться дорогим, если он работает все выходные без привязанных задач. Для on-demand измеряйте оплачиваемое время работы относительно полезного времени вычислений.
коэффициент потерь on-demand =
  1 - полезные минуты работы GPU / оплачиваемые минуты работы инстанса
Если коэффициент потерь высок, не пытайтесь сначала торговаться о цене GPU. Исправьте автоматику выключения, планирование очереди, autoscaling и упаковку задач.
Цены на GPU в spot-, interruptible- и marketplace-режимах
Spot-ценообразование на GPU использует неиспользуемую емкость и может дать заметные скидки по сравнению с on-demand, но эта емкость может исчезнуть. AWS описывает EC2 Spot Instances как избыточную емкость EC2, доступную со скидками до 90% по сравнению с ценами On-Demand. Google Cloud Spot VM тоже продаются со скидкой, но могут быть прерваны. Community-маркетплейсы, такие как Vast.ai, добавляют ещё один вариант: цена определяется спросом и предложением хоста, а профиль надежности не такой, как у on-demand-инстанса гиперскейлера.
Spot или interruptible-цены на аренду GPU могут быть выигрышными, когда:
- Обучающие задачи часто сохраняют checkpoints.
- Batch-инференс может повторяться без видимого для пользователя сбоя.
- Очереди генерации изображений или видео допускают задержки.
- Вы можете разделить работу между многими воркерами.
- У вас есть оркестрация, которая замечает eviction, перезапускает задачи и избегает двойного биллинга.
Spot может проигрывать, когда:
- Один многодневный прогон обучения перезапускается со старого checkpoint.
- Загрузка данных занимает достаточно много времени, и каждое прерывание теряет часы.
- Модели нужна многонодовая сеть, и потеря одного воркера убивает задачу.
- Инженеры тратят дни на поддержку логики повторов и checkpoint.
- Вы обещаете клиентам latency на емкости, которой не управляете.
Для spot рассчитывайте эффективную ставку с учетом потерь на перезапуски:
эффективная почасовая ставка spot =
  почасовая ставка spot / (1 - доля потерь из-за прерываний)
Если spot H100 на 45% дешевле, но прерывания съедают 35% прошедшего времени задачи, реальное преимущество намного меньше, чем заявленная скидка.
Резервированная, committed и выделенная GPU-емкость
Резервирование емкости меняет гибкость на предсказуемость. Вы берете обязательство на срок, уровень расходов или выделенный кластер, чтобы провайдер мог выделить оборудование, а вы — снизить эффективную почасовую ставку или закрепить дефицитные GPU.
Резервированные цены на аренду GPU имеют смысл, когда:
- Production-инференс имеет стабильную базовую загрузку.
- Графики обучения предсказуемы на месяцы вперед.
- Закупкам нужен известный месячный бюджет.
- Вам нужна гарантированная мощность на период запуска.
- Частью требования являются многонодовая сеть, локальность хранилища и поддержка.
Резервирование может обернуться против вас, когда:
- Выбор модели меняется до окончания срока.
- Спрос скачкообразный, а базовая загрузка остаётся низкой.
- Новый класс GPU меняет кривую производительность-цена.
- Контракт не включает уровень storage, support или network, который вам реально нужен.
Перед резервированием рассчитайте точку безубыточности по загрузке:
безубыточная загрузка reserved =
  monthly cost reserved / (почасовая ставка on-demand * часов в месяце)
Если точка безубыточности — 58% загрузки, а ваша реальная базовая загрузка — 30%, резервируйте меньше емкости, а остальное добирайте на on-demand или spot.
Цены на аренду GPU в Vast.ai
Люди ищут цены на аренду GPU в Vast.ai, потому что Vast — это marketplace, а не единая фиксированная тарифная сетка облака. В этом и привлекательность, и риск. Вы можете найти агрессивные предложения на RTX 4090, A100 или H100, но каждое объявление нужно проверять по качеству.
Сравнивая цены на аренду GPU в Vast.ai, фиксируйте:
- Модель GPU и объем VRAM.
- Количество GPU в машине.
- Надежность хоста и статус верификации.
- Контекст datacenter-host vs community-host.
- Статус interruptible или non-interruptible.
- Размер локального диска и пропускную способность диска.
- Пропускную способность upload/download и потребность в public IP.
- Время запуска container image.
- Может ли ваша задача сохранять checkpoint и продолжаться.
Для vast.ai gpu rental prices rtx 4090 не сравнивайте только почасовую ставку RTX 4090. Сравнивайте также VRAM, историю хоста, размер диска, стоимость хранилища и то, идет ли задача на обучение, inference, ComfyUI, разметку данных или разовые эксперименты. Очень дешевая RTX 4090 может быть правильным выбором для коротких экспериментов и неправильным — для production-инференса.
Цены на аренду GPU в RunPod
При сравнении цен на аренду GPU в RunPod нужно разделять режимы продукта. RunPod pod — это не та же экономическая единица, что и serverless endpoint, а Secure Cloud — не тот же профиль риска, что и Community Cloud.
При сравнении цен на аренду GPU в RunPod фиксируйте:
- Secure Cloud или Community Cloud.
- Почасовая ставка Pod GPU.
- Тарифы на serverless worker, если вы используете endpoints вместо pods.
- Стоимость persistent volume и network volume.
- Поведение при cold start и минимальное число workers.
- Поведение idle pod.
- Локальность данных и то, повторно ли рабочая нагрузка загружает большие модели.
RunPod может быть экономически выгодным для команд, создающих AI-приложения и нуждающихся в быстром доступе к GPU без эксплуатации полноценного кластера. Проверка скрытых затрат здесь связана со startup и storage: если каждый worker повторно скачивает крупные веса или оставляет volumes подключенными после экспериментов, почасовая строка GPU будет занижать итоговый счет.
Цены на аренду GPU в Massed Compute
Цены на аренду GPU в Massed Compute — полезная отправная точка для покупателей, сравнивающих специализированных облачных провайдеров GPU, особенно когда речь уже идет не об одном dev pod, а о выделенной AI-мощности. Для простого эксперимента сравните опубликованную почасовую ставку. Для production inference или многонодового обучения уточните, что входит в цену кластера.
Уточните:
- Модель GPU и объем памяти.
- Почасовую цену on-demand по сравнению с ценой по reservation.
- Минимальные обязательства.
- Сетевую фабрику.
- Тарифный уровень хранения.
- Условия поддержки и SLA.
- Регион и требования по compliance.
- Включены ли в смету настройка, миграция или managed services.
Именно здесь важен закупочный язык. "Reserved GPU cluster" может означать более низкую ставку, гарантированное оборудование, частную сеть, доступ к поддержке или все перечисленное. Просите отдельно разбить каждую статью.
Цены на аренду GPU со временем
Цены на аренду GPU со временем не движутся по прямой. Обычно на них одновременно влияют три силы:
| Фактор | Влияние на цену |
|---|---|
| Появление нового оборудования | Старые GPU могут дешеветь, когда становятся доступны H200, B200, B300 или более новые классы. |
| Всплески спроса на AI | Мощности класса H100/H200 могут оставаться дорогими или дефицитными во время запусков моделей, обучения или резкого роста inference. |
| Рост эффективности | Лучшая квантизация, batching, serving engines и маршрутизация моделей могут снизить стоимость одной задачи даже при неизменной почасовой цене GPU. |
Не полагайтесь на один сценарий вроде "цены на GPU падают" или "цены на GPU растут". Отслеживайте точное семейство GPU, которое вы используете, регион, условия обязательств и эффективность вашей нагрузки. Ваша стоимость за токен, изображение, fine-tune или обучающий пример может улучшаться даже тогда, когда почасовые цены аренды GPU остаются прежними.
Скрытые расходы при аренде GPU в облаке
Скрытые расходы не всегда являются чем-то злонамеренным. Часто это обычные облачные примитивы, которые становятся значительными, потому что GPU-нагрузки перемещают большие файлы и простаивают во время отладки.
| Скрытая статья расходов | Как проявляется | Как контролировать |
|---|---|---|
| Простой | Запущенные pods, notebooks или instances без активной задачи | Автоматически останавливайте простаивающие ресурсы; помечайте эксперименты тегами; настройте оповещения о долго работающих GPU. |
| Постоянное хранилище | Volumes, диски, snapshots, model caches, datasets | Разделяйте переиспользуемые веса моделей и временные результаты; очищайте заброшенные volumes. |
| Сетевой egress | Перемещение наборов данных, checkpoints, результатов или model artifacts между регионами или в интернет | По возможности храните данные, GPU и object storage в одном регионе. |
| Cold start | Загрузка контейнеров и весов модели до начала полезной работы | Собирайте образы заранее; используйте локальные кэши; измеряйте время запуска как оплачиваемое время. |
| Повторы и неудачные задания | Ошибки out-of-memory, evictions, плохие драйверы, нестабильные hosts | Запускайте небольшие canary; делайте checkpoint; закрепляйте заведомо рабочие образы; фиксируйте стоимость сбоев. |
| Сетевое взаимодействие между несколькими узлами | Премии за InfiniBand, RoCE, размещение или cluster fabric | Резервируйте только тогда, когда нагрузке действительно нужно распределенное обучение. |
| Поддержка и compliance | Платные планы поддержки, частные кластеры, требования аудита, managed services | Определите, какие нагрузки нуждаются в enterprise-условиях, а какие могут оставаться экспериментальными. |
| Инженерные накладные расходы | Время на поддержку скриптов, schedulers и облачной специфичной настройки | Включайте часы на настройку и инциденты в worksheet TCO. |
Для цен на аренду GPU storage и idle time — два скрытых расхода, которые с наибольшей вероятностью удивят небольшие команды. Для более крупных команд большими бюджетными рисками обычно становятся support, networking и недоиспользованная reserved capacity.
Рабочий лист по цене аренды GPU
Используйте этот worksheet, прежде чем одобрить провайдера, зарезервировать кластер или мигрировать рабочую нагрузку.
| Поле | Пример | Почему это важно |
|---|---|---|
| Провайдер | RunPod, Vast.ai, Massed Compute, AWS, Google Cloud, Lambda | Позволяет отделить экономику маркетплейсов, специализированных облаков и hyperscaler. |
| Режим продукта | On-demand pod, spot instance, reserved cluster, serverless endpoint | Единица тарификации и профиль надежности меняются в зависимости от режима. |
| Модель GPU | H100 SXM, H100 PCIe, A100 80GB, L40S, RTX 4090 | Часто память и межсоединение важнее названия бренда. |
| Регион или хост | US-East, EU, community host, datacenter host | Доступность, правила работы с данными, задержка и пропускная способность различаются в зависимости от локации. |
| Почасовая цена GPU | $x.xx/hour |
Только отправная точка. |
| Минимальная единица тарификации | second, minute, hour, month | Короткие задачи чувствительны к округлению и cold start. |
| Стоимость хранения | volume, disk, snapshot, object storage | Весы модели и контрольные точки могут превратиться в постоянные ежемесячные расходы. |
| Трафик или egress | inbound, outbound, public IP, cross-region | Большие датасеты и сгенерированные медиа меняют общую стоимость. |
| Процент простоя | 22% |
Прямой показатель впустую потраченного времени аренды. |
| Коэффициент отказов/повторов | 1.08x |
Учитывает eviction, OOM, плохие образы и перезапуски. |
| Полезная единица результата | trained epoch, accepted image, 1M tokens, completed job | Преобразует почасовую цену в бизнес-ценность. |
| Поддержка и операции | self-managed, managed, SLA, private cluster | Затраты на закупку и надежность должны учитываться в одной модели. |
Для более глубокой калькуляции затрат на уровне модели после того, как рабочая нагрузка обслуживается через API, сравните это с сравнением цен на AI-модели и как сравнивать цены на AI-модели.
Когда API модели дешевле, чем аренда GPU
Аренда GPU не всегда автоматически дешевле, чем использование API модели. Аренда GPU выигрывает, когда у вас высокая загрузка, четкая необходимость владения моделью, собственные inference-стэки, ограничения по конфиденциальности или обучающие задачи, которые нельзя делегировать API.
API модели может быть дешевле, когда:
- Загрузка низкая или скачкообразная.
- Команда часто меняет модели.
- Надежность, масштабирование и обновления отвлекали бы от продуктовой работы.
- Рабочая нагрузка требует много семейств моделей, а не одну self-hosted модель.
- Финансам нужен журнал использования, а не проект по эксплуатации кластера.
Flatkey находится на стороне API в этом решении. Он дает командам один API-ключ, один баланс, один счет и журнал использования для многих официальных моделей и инструментов. Если ваш расчет показывает, что self-hosted GPU пока не являются узким местом, начните с multi-provider API и сравните стоимость одного принятого результата, прежде чем переходить к эксплуатации кластера. Для слоя управления API см. цены AI gateway, управление расходами на AI API и управление квотами AI API.
Руководство по выбору: on-demand, spot, reserved или API
| Нагрузка | Лучший стартовый вариант | Почему |
|---|---|---|
| Первый бенчмарк модели | On-demand GPU | Самое чистое измерение, меньше переменных из-за прерываний. |
| Разовый workflow в ComfyUI или для изображений | On-demand или marketplace GPU | Быстрая настройка; мощности уровня RTX 4090 может быть достаточно. |
| Пакетный inference с повторами | Spot или interruptible GPU | Скидки могут выиграть, если логика повторов хорошо настроена. |
| Базовый production inference | Reserved или committed GPU | Стабильная загрузка может оправдать обязательство. |
| Многоузловое обучение | Выделенный кластер или зарезервированная мощность | Сеть и размещение важны не меньше, чем почасовая ставка. |
| AI-фича с низким объемом использования | API модели через gateway | Избегает простоя GPU и накладных расходов на операции. |
| Workflow агентa с несколькими моделями | API модели через Flatkey | Один ключ и журнал могут быть лучше, чем эксплуатация многих GPU-эндпоинтов. |
Распространенные ошибки в ценообразовании аренды GPU
| Ошибка | Что делать вместо этого |
|---|---|
| Сравнивать только указанную почасовую цену GPU | Сравнивайте стоимость завершенной нагрузки с учетом хранения, трафика, простоя и повторов. |
| Считать скидки spot гарантированной экономией | Добавьте потери из-за прерываний и накладные расходы на контрольные точки. |
| Резервировать мощность до измерения загрузки | Используйте on-demand достаточно долго, чтобы понять базовый спрос. |
| Игнорировать очистку хранилища | Настройте оповещения о не подключенных томах, snapshot и старых контрольных точках. |
| Смешивать RTX 4090, L40S, A100, H100 и H200 так, будто они взаимозаменяемы | Подбирайте VRAM, производительность tensor, interconnect и software stack под нагрузку. |
| Забывать о data gravity | Размещайте датасеты, object storage и GPU рядом друг с другом. |
| Использовать аренду GPU для каждой AI-нагрузки | Сравнивайте с API моделей, когда накладные расходы на операции доминируют. |
FAQ
Как лучше всего сравнивать цены на аренду GPU?
Лучший способ сравнивать цены на аренду GPU — считать стоимость на выполненную рабочую нагрузку. Учитывайте почасовую ставку GPU, хранилище, исходящий трафик, простои, повторные попытки, неудачные задания, поддержку и инженерные накладные расходы. Более низкая почасовая ставка может оказаться невыгодной, если она приводит к большему числу перезапусков или простоев.
Цены на аренду GPU у Vast.ai дешевле, чем у облачных провайдеров?
Цены на аренду GPU у Vast.ai могут быть ниже для некоторых GPU, потому что это маркетплейс, но сравнение зависит от надежности хоста, возможности прерывания, диска, пропускной способности, уровня верификации и допустимости для вашей нагрузки. Рассматривайте каждое объявление как конкретное предложение, а не как универсальную цену.
Цены на аренду GPU у RunPod — это on-demand или spot?
Цены на аренду GPU у RunPod зависят от выбранного продукта и типа облака. Сравнивайте Secure Cloud, Community Cloud, pods, serverless endpoints, хранилище, сетевые volumes и поведение при простое отдельно.
Когда следует использовать зарезервированную GPU-мощность?
Используйте зарезервированную GPU-мощность, когда загрузка предсказуема, тип GPU будет оставаться полезным в течение срока обязательства и гарантированная емкость имеет значение. Если базовый уровень загрузки низкий, резервируйте только базовую нагрузку, а остальное покрывайте через on-demand или spot.
Почему цены на аренду GPU со временем так сильно меняются?
Цены на аренду GPU со временем меняются, потому что одновременно меняются предложение оборудования, спрос на ИИ, региональная емкость, конкуренция между провайдерами и эффективность обслуживания. Отслеживайте конкретное семейство GPU и эффективность вашей нагрузки, а не только средние значения по рынку.
Какие скрытые расходы наиболее важны в GPU-cloud сервисах?
Наиболее важные скрытые расходы — это простои, постоянное хранилище, снимки, исходящий трафик, холодные старты, повторные попытки, неудачные задания, сетевая фабрика, поддержка и инженерные накладные расходы. Небольшие команды обычно в первую очередь ощущают простои и хранилище; более крупные команды обычно — сеть, поддержку и недоиспользованную зарезервированную мощность.
Итоговый чеклист
Прежде чем выбрать провайдера аренды GPU, убедитесь, что:
- Модель GPU, объем памяти, регион и единица тарификации зафиксированы.
- Модель ценообразования — on-demand, spot, reserved, serverless, marketplace или dedicated.
- Хранилище, пропускная способность, snapshots и время простоя включены.
- Прерывания spot и потери из-за повторных попыток смоделированы.
- У зарезервированной мощности есть порог окупаемости по использованию.
- К каждому ценовому значению приложены исходный URL и дата проверки.
- Итоговое решение основано на стоимости выполненной рабочей нагрузки, а не только на почасовых ценах аренды GPU.
Это практический способ оценивать цены на аренду GPU: актуальные исходные страницы, таблица, составленная под вашу нагрузку, и четкое решение о том, когда аренда оборудования оправдана с учетом операционной сложности.


