
Precios de alquiler de GPU explicados: bajo demanda, spot, reservado y costes ocultos
Los precios de alquiler de GPU parecen simples hasta que intentas prever una ejecución de entrenamiento real, un lanzamiento de inferencia o un lote de generación de imágenes. La tarifa por hora que aparece en primer lugar es solo una partida. Tu factura final también depende de si la GPU es bajo demanda, spot o interrumpible, reservada, serverless o dedicada; de cuánto tiempo la máquina permanece inactiva; de dónde reside el almacenamiento; de cuántos datos salen de la región; y de cuánto trabajo de fiabilidad tiene que asumir tu equipo.
Esta guía ofrece a desarrolladores, fundadores de IA, equipos de plataforma y revisores de compras una forma práctica de comparar precios de alquiler de GPU sin quedar atrapados por un único número horario atractivo.
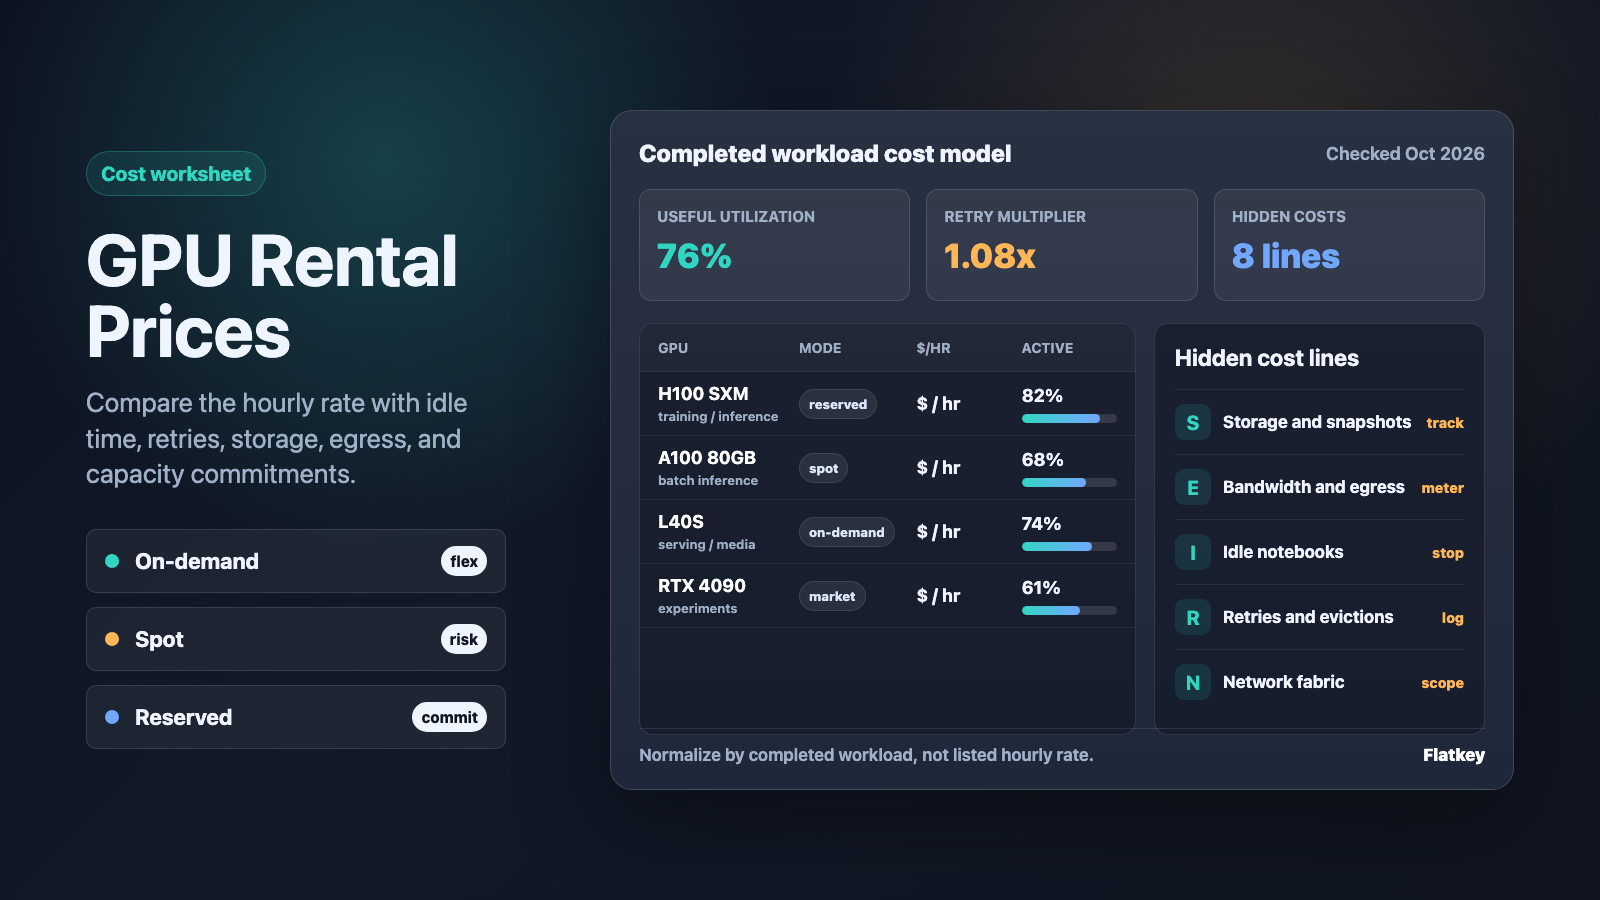
La versión corta: compara el coste por hora de carga de trabajo completada, no solo el precio de la GPU por hora de reloj.
El marco rápido de precios de alquiler de GPU
Comienza cada comparación de precios de alquiler de GPU con una fórmula normalizada:
coste efectivo de GPU por carga de trabajo completada =
  (cómputo de GPU + almacenamiento + instantáneas + ancho de banda + tiempo inactivo + reintentos + soporte + sobrecarga de ingeniería)
  / unidades de trabajo completadas de entrenamiento, inferencia, lotes o medios
Después, divide la decisión en cuatro preguntas:
| Pregunta | Por qué cambia los precios de alquiler de GPU |
|---|---|
| ¿Qué clase de GPU necesitas? | Las máquinas de clase H100, H200, B200, A100, L40S, RTX 4090 y RTX 6000 tienen curvas diferentes de memoria, red, suministro y precio. |
| ¿Qué tan predecible es la carga de trabajo? | La inferencia de producción estable puede justificar capacidad reservada o comprometida; los experimentos y los trabajos con picos suelen encajar mejor en bajo demanda o spot. |
| ¿Qué tan interrumpible es el trabajo? | La capacidad spot y del mercado comunitario puede ser más barata, pero los reintentos y los puntos de control determinan si realmente lo es. |
| ¿Qué queda fuera de la hora de GPU? | El almacenamiento, las instantáneas, la salida de datos, los cuadernos inactivos, las descargas de contenedores, los planes de soporte y la red del clúster pueden cambiar el coste real. |
Para la mayoría de los equipos, la respuesta correcta no es "encontrar la GPU más barata". La respuesta correcta es "alquilar la capacidad fiable más barata que termine el trabajo con un tiempo de cola aceptable, riesgo de reinicio y sobrecarga operativa aceptables".
Tabla actual de fuentes de precios
Los precios de alquiler de GPU cambian con frecuencia y las páginas de mercado pueden moverse más rápido que las revisiones de compras. Trata la tabla siguiente como una lista de verificación de fuentes, no como una tarifa fija. Registra la fecha de comprobación, el modelo de GPU, la región, el tamaño de memoria, la unidad de facturación y si el precio es bajo demanda, spot, reservado, comunitario, nube segura, serverless o dedicado.
| Proveedor o mercado | Fuente oficial de precios a consultar | Qué capturar | Notas para la comparación |
|---|---|---|---|
| Vast.ai | Precios de Vast.ai y Preguntas frecuentes de Vast.ai | Modelo de GPU, fiabilidad del host, estado interrumpible, almacenamiento, ancho de banda, nivel de verificación, centro de datos o host comunitario | Los precios de alquiler de GPU de Vast.ai están impulsados por el mercado, por lo que dos ofertas de RTX 4090 o H100 pueden diferir por ubicación, host, fiabilidad, almacenamiento y red. |
| RunPod | Precios de RunPod y documentación de almacenamiento y volúmenes de red de RunPod | Nube segura frente a nube comunitaria, modelo de GPU, almacenamiento del pod, volumen de red, precios de trabajadores serverless, tiempo inactivo | Los precios de alquiler de GPU de RunPod varían según el tipo de nube y el modo del producto. Compara pods, serverless y almacenamiento por separado. |
| Massed Compute | Precios de Massed Compute | Tarifa horaria de GPU bajo demanda, reserva a largo plazo o presupuesto de clúster, memoria de GPU, región, alcance del soporte | Los precios de alquiler de GPU de Massed Compute son útiles para comparar capacidad de nube de IA dedicada, pero los clústeres privados o reservados pueden requerir un presupuesto. |
| Lambda Cloud | Precios de Lambda Cloud | Instancia de GPU bajo demanda, número de GPU, almacenamiento local, disponibilidad por región, términos de clúster reservado | Lambda publica tarifas horarias sencillas de nube GPU para instancias NVIDIA comunes; confirma la disponibilidad actual antes de planificar una ejecución sensible al tiempo. |
| AWS EC2 | Precios de Amazon EC2 y instancias EC2 Spot | Familia de instancias, región, bajo demanda, spot, Savings Plans, Reserved Instances, EBS, transferencia de datos, soporte | AWS suele ser el modelo de referencia para la economía de bajo demanda, spot y uso comprometido, pero importan las familias de instancias GPU y la disponibilidad regional. |
| Google Cloud | Precios de GPU de Compute Engine y VMs Spot | Tipo de GPU, familia de máquinas, región, estado de VM Spot, descuento por uso comprometido, disco persistente, salida de red | Google Cloud separa la GPU, la máquina, el disco, la red y la mecánica de descuentos. Normaliza todo eso antes de compararlo con nubes especializadas de GPU. |
Añade una línea a cada fila de la fuente: comprobado el 12 de octubre de 2026. Si reutilizas la hoja de cálculo más adelante, actualiza la fecha de comprobación antes de reutilizar cualquier número.
Precios de alquiler de GPU bajo demanda
Los precios de alquiler de GPU bajo demanda son el punto de partida más limpio: pagas por la capacidad de la GPU mientras la instancia, pod o servidor está en ejecución, normalmente sin compromiso a largo plazo. Este es el modo que la mayoría de los equipos debería usar para los primeros benchmarks porque mantiene simples las variables de ingeniería.
El modo bajo demanda suele ser la opción predeterminada correcta cuando:
- Estás probando un nuevo modelo, framework, conjunto de datos o pipeline de prompts.
- El trabajo es urgente y no puede esperar a capacidad spot.
- Necesitas un endpoint estable para demos, QA o tráfico inicial de clientes.
- Aún no conoces lo suficiente la utilización como para reservar capacidad.
- Necesitas soporte del proveedor y una red predecible más que la tarifa horaria más baja.
El riesgo es el tiempo ocioso. Un notebook de GPU que cuesta menos por hora puede seguir siendo caro si funciona todo el fin de semana sin jobs asociados. En el caso de bajo demanda, mide el tiempo de ejecución facturable frente al tiempo útil de cómputo.
tasa de desperdicio bajo demanda =
  1 - minutos útiles de GPU activa / minutos facturables de la instancia
Si la tasa de desperdicio es alta, no negocies primero la tarifa de la GPU. Corrige la automatización de apagado, la programación de colas, el autoscaling y el empaquetado de trabajos.
Precios de GPU spot, interruptible y de marketplace
Los precios spot de GPU usan capacidad no utilizada y pueden ofrecer descuentos significativos en comparación con bajo demanda, pero la capacidad puede desaparecer. AWS describe las EC2 Spot Instances como capacidad EC2 sobrante disponible con descuentos de hasta el 90% en comparación con los precios bajo demanda. Las Google Cloud Spot VMs también tienen descuento, pero pueden ser desalojadas. Los marketplaces comunitarios como Vast.ai añaden otra variación: el precio lo fijan la oferta y la demanda del host, y el perfil de fiabilidad no es el mismo que el de una instancia bajo demanda de un hyperscaler.
Los precios de alquiler de GPU spot o interruptible pueden ganar cuando:
- Los trabajos de entrenamiento guardan checkpoints con frecuencia.
- La inferencia por lotes puede reintentarse sin fallo visible para el usuario.
- Las colas de generación de imágenes o vídeo toleran retrasos.
- Puedes dividir el trabajo entre muchos workers.
- Tienes una orquestación que detecta la expulsión, reinicia los jobs y evita la facturación duplicada.
Spot puede perder cuando:
- Un único entrenamiento de varios días se reinicia desde un checkpoint antiguo.
- La carga de datos tarda lo suficiente como para que cada interrupción desperdicie horas.
- El modelo necesita red multinodo y un worker perdido mata el trabajo.
- Los ingenieros pasan días manteniendo la lógica de reintentos y checkpoints.
- Prometes latencia cara al cliente sobre capacidad que no controlas.
Para spot, calcula la tarifa efectiva con desperdicio por reinicios:
tarifa horaria efectiva spot =
  tarifa horaria spot / (1 - porcentaje de desperdicio por interrupciones)
Si una H100 spot es un 45% más barata pero las interrupciones desperdician un 35% del tiempo transcurrido del trabajo, la ventaja real es mucho menor que el descuento destacado.
Capacidad de GPU reservada, comprometida y dedicada
La capacidad reservada intercambia flexibilidad por previsibilidad. Te comprometes a un plazo, nivel de gasto o clúster dedicado para que el proveedor pueda asignar hardware y tú puedas reducir la tarifa horaria efectiva o asegurar GPUs escasas.
Los precios de alquiler de GPU reservadas tienen sentido cuando:
- La inferencia en producción tiene una utilización base estable.
- Los calendarios de entrenamiento son predecibles durante meses.
- Compras necesita un presupuesto mensual conocido.
- Necesitas capacidad garantizada para una ventana de lanzamiento.
- La red multinodo, la proximidad del almacenamiento y el soporte forman parte del requisito.
La capacidad reservada puede salir mal cuando:
- La elección del modelo cambia antes de que termine el plazo.
- La demanda tiene picos y la utilización base se mantiene baja.
- Una clase de GPU más nueva cambia la curva de rendimiento por dólar.
- El contrato excluye el nivel de almacenamiento, soporte o red que realmente necesitas.
Antes de reservar, calcula el punto de equilibrio de utilización:
punto de equilibrio de utilización reservada =
  coste mensual reservado / (tarifa horaria bajo demanda * horas del mes)
Si el punto de equilibrio es una utilización del 58% y tu base real es del 30%, reserva menos capacidad y absorbe el resto en bajo demanda o spot.
Precios de alquiler de GPU de Vast.ai
La gente busca precios de alquiler de GPU de Vast.ai porque Vast es un marketplace, no una única tarifa fija de nube. Esa es la atracción y el riesgo. Puedes encontrar ofertas agresivas de RTX 4090, A100 o H100, pero cada anuncio necesita una comprobación de calidad.
Al comparar los precios de alquiler de GPU de Vast.ai, captura:
- Modelo de GPU y VRAM.
- Número de GPU en la máquina.
- Fiabilidad del host y estado de verificación.
- Contexto de centro de datos frente a host comunitario.
- Estado interruptible o no interruptible.
- Tamaño del disco local y ancho de banda del disco.
- Ancho de banda de subida/bajada y necesidades de IP pública.
- Tiempo de arranque de la imagen del contenedor.
- Si tu trabajo puede guardar checkpoints y reanudarse.
Para vast.ai gpu rental prices rtx 4090, no compares solo la tarifa horaria de la RTX 4090. Compara también la VRAM, el historial del host, el tamaño del disco, el coste de almacenamiento y si el trabajo es entrenamiento, inferencia, ComfyUI, etiquetado de datos o experimentación puntual. Una RTX 4090 muy barata puede ser la opción correcta para experimentos cortos y la incorrecta para inferencia en producción.
Precios de alquiler de GPU de RunPod
Los precios de alquiler de GPU de RunPod requieren una separación por modos de producto. Un pod de RunPod no es la misma unidad económica que un endpoint serverless, y Secure Cloud no tiene el mismo perfil de riesgo que Community Cloud.
Al comparar los precios de alquiler de GPU de RunPod, captura:
- Cloud seguro o Cloud comunitaria.
- Tarifa por hora de GPU de Pod.
- Precios de workers serverless si está utilizando endpoints en lugar de pods.
- Costo de volumen persistente y volumen de red.
- Comportamiento de arranque en frío y workers mínimos.
- Comportamiento de pod inactivo.
- Ubicación de los datos y si la carga de trabajo descarga modelos grandes repetidamente.
RunPod puede ser rentable para equipos de aplicaciones de IA que quieren acceso rápido a GPU sin operar un clúster completo. La comprobación de costes ocultos está en el arranque y el almacenamiento: si cada worker descarga repetidamente pesos grandes o deja volúmenes adjuntos después de las pruebas, la línea de GPU por hora subestimará la factura.
Precios de alquiler de GPU de Massed Compute
Los precios de alquiler de GPU de Massed Compute son una referencia útil para compradores que comparan proveedores especializados de cloud GPU, especialmente cuando la cuestión ya no es un único pod de desarrollo y empieza a implicar capacidad de IA dedicada. Para una prueba sencilla, compare la tarifa horaria publicada. Para inferencia en producción o entrenamiento multinodo, pregunte qué incluye el precio del clúster.
Capture:
- Modelo de GPU y memoria.
- Precio horario bajo demanda frente a presupuesto de reserva.
- Compromiso mínimo.
- Infraestructura de red.
- Nivel de almacenamiento.
- Términos de soporte y SLA.
- Región y requisitos de cumplimiento.
- Si el presupuesto incluye configuración, migración o servicios gestionados.
Aquí es donde importa el lenguaje de compras. "Clúster de GPU reservado" puede significar una tarifa más baja, hardware garantizado, red privada, acceso al soporte o todo lo anterior. Pida cada partida por separado.
Precios de alquiler de GPU a lo largo del tiempo
Los precios de alquiler de GPU a lo largo del tiempo no se mueven en línea recta. Normalmente, tres fuerzas tiran en direcciones distintas:
| Fuerza | Efecto en el precio |
|---|---|
| Nuevo suministro de hardware | Las GPU más antiguas pueden abaratarse cuando H200, B200, B300 o clases más nuevas pasan a estar disponibles. |
| Picos de demanda de IA | La capacidad de clase H100/H200 puede seguir siendo cara o escasa durante lanzamientos de modelos, entrenamiento o picos de inferencia. |
| Mejoras de eficiencia | Una mejor cuantización, batching, motores de serving y enrutamiento de modelos pueden reducir el coste por tarea incluso cuando el precio horario de la GPU permanece plano. |
No confíe en una sola historia de "los precios de GPU están bajando" o "los precios de GPU están subiendo". Haga seguimiento de la familia exacta de GPU que utiliza, la región, los términos comprometidos y la eficiencia de su carga de trabajo. Su coste por token, imagen, fine-tune o muestra de entrenamiento puede mejorar aunque los precios horarios de alquiler de GPU se mantengan iguales.
Costes ocultos en el alquiler de GPU en la nube
Los costes ocultos no siempre son maliciosos. A menudo son primitivas normales de la nube que se vuelven grandes porque las cargas de trabajo de GPU mueven archivos grandes y permanecen inactivas durante la depuración.
| Coste oculto | Cómo aparece | Cómo controlarlo |
|---|---|---|
| Tiempo de inactividad | Pods, notebooks o instancias en ejecución sin trabajo activo | Detenga automáticamente los recursos inactivos; etiquete experimentos; configure alertas sobre GPU en ejecución durante mucho tiempo. |
| Almacenamiento persistente | Volúmenes, discos, snapshots, cachés de modelos, datasets | Separe los pesos de modelos reutilizables de los resultados temporales; limpie volúmenes abandonados. |
| Salida de red | Movimiento de datasets, checkpoints, salidas o artefactos de modelos entre regiones o hacia internet | Mantenga los datos, la GPU y el almacenamiento de objetos en la misma región cuando sea posible. |
| Arranques en frío | Descarga de contenedores y pesos del modelo antes de que comience el trabajo útil | Preconstruya imágenes; use cachés locales; mida el tiempo de arranque como tiempo facturable. |
| Reintentos y trabajos fallidos | Fallos por falta de memoria, expulsiones, controladores defectuosos, hosts inestables | Ejecute canarios pequeños; haga checkpoint; fije imágenes conocidas y buenas; registre el coste del fallo. |
| Red multinodo | InfiniBand, RoCE, placement o primas de infraestructura de clúster | Reserve solo cuando la carga de trabajo realmente necesite entrenamiento distribuido. |
| Soporte y cumplimiento | Planes de soporte de pago, clústeres privados, necesidades de auditoría, servicios gestionados | Decida qué cargas de trabajo necesitan términos empresariales y cuáles pueden seguir siendo experimentales. |
| Sobrecarga de ingeniería | Tiempo dedicado a mantener scripts, programadores y configuración específica de la nube | Incluya las horas de configuración e incidencias en la hoja de cálculo de TCO. |
Para los precios de alquiler de GPU, el almacenamiento y el tiempo de inactividad son los dos costes ocultos con más probabilidades de sorprender a los equipos pequeños. Para equipos grandes, el soporte, la red y la capacidad reservada infrautilizada suelen convertirse en los mayores riesgos presupuestarios.
Hoja de cálculo del precio de alquiler de GPU
Utilice esta hoja de cálculo antes de aprobar un proveedor, reservar un clúster o migrar una carga de trabajo.
| Campo | Ejemplo | Por qué importa |
|---|---|---|
| Proveedor | RunPod, Vast.ai, Massed Compute, AWS, Google Cloud, Lambda | Mantiene separadas las economías de marketplace, nube especializada e hiperescaladores. |
| Modo de producto | Pod bajo demanda, instancia spot, clúster reservado, endpoint sin servidor | La unidad de facturación y el perfil de fiabilidad cambian según el modo. |
| Modelo de GPU | H100 SXM, H100 PCIe, A100 80GB, L40S, RTX 4090 | La memoria y la interconexión suelen importar más que el nombre de la marca. |
| Región o host | US-East, EU, host comunitario, host de centro de datos | La disponibilidad, las normas de datos, la latencia y el ancho de banda difieren según la ubicación. |
| Precio horario de la GPU | $x.xx/hour |
Solo punto de partida. |
| Unidad mínima de facturación | segundo, minuto, hora, mes | Los trabajos cortos son sensibles al redondeo y a los arranques en frío. |
| Coste de almacenamiento | volumen, disco, snapshot, almacenamiento de objetos | Los pesos del modelo y los checkpoints pueden convertirse en costes mensuales permanentes. |
| Ancho de banda o egress | entrada, salida, IP pública, entre regiones | Los grandes conjuntos de datos y los medios generados cambian el coste total. |
| Porcentaje de inactividad | 22% |
Medida directa del tiempo de alquiler desperdiciado. |
| Tasa de fallos/reintentos | 1.08x |
Recoge expulsiones, OOMs, imágenes defectuosas y reinicios. |
| Unidad de salida útil | epoch entrenado, imagen aceptada, 1M tokens, trabajo completado | Convierte el precio horario en valor empresarial. |
| Soporte y operaciones | autogestionado, gestionado, SLA, clúster privado | Los costes de aprovisionamiento y fiabilidad deben incluirse en el mismo modelo. |
Para una hoja de cálculo más profunda del coste a nivel de modelo después de que la carga de trabajo se sirva a través de APIs, compara esto con comparación de precios de modelos de IA y cómo comparar los precios de los modelos de IA.
Cuándo una API de modelo es más barata que alquilar GPUs
Alquilar GPUs no es automáticamente más barato que usar una API de modelo. El alquiler de GPU gana cuando tienes una alta utilización, necesidades claras de propiedad del modelo, stacks de inferencia personalizados, restricciones de privacidad o cargas de trabajo de entrenamiento que no pueden delegarse a una API.
Una API de modelo puede ser más barata cuando:
- La utilización es baja o presenta picos.
- El equipo cambia de modelos con frecuencia.
- La fiabilidad, el escalado y las actualizaciones distraerían del trabajo del producto.
- La carga de trabajo necesita muchas familias de modelos en lugar de un único modelo autoalojado.
- Finanzas necesita un registro de uso más que un proyecto de operaciones de clúster.
Flatkey se sitúa en el lado de la API de esa decisión. Ofrece a los equipos una clave de API, un saldo, una factura y un registro de uso únicos para muchos modelos y herramientas oficiales. Si tu hoja de cálculo muestra que las GPUs autoalojadas aún no son el verdadero cuello de botella, empieza con una API multiproveedor y compara el coste por resultado aceptado antes de comprometerte con las operaciones de clúster. Para la capa de gobernanza de API, consulta precios de gateway de IA, gestión del gasto en API de IA y controles de cuota de API de IA.
Guía de decisión: bajo demanda, spot, reservado o API
| Carga de trabajo | Mejor punto de partida | Por qué |
|---|---|---|
| Primer benchmark del modelo | GPU bajo demanda | La medición más limpia, con menos variables de interrupción. |
| Flujo de trabajo puntual de ComfyUI o de imágenes | GPU bajo demanda o de marketplace | Configuración rápida; la capacidad de clase RTX 4090 puede ser suficiente. |
| Inferencia por lotes con reintentos | GPU spot o interrumpible | Los descuentos pueden compensar si la lógica de reintentos es sólida. |
| Línea base de inferencia en producción | GPU reservada o comprometida | Una utilización estable puede justificar el compromiso. |
| Entrenamiento multinodo | Clúster dedicado o capacidad reservada | La red y la ubicación importan tanto como la tarifa por hora. |
| Funcionalidad de IA de bajo volumen | API de modelo a través de un gateway | Evita la capacidad de GPU inactiva y la sobrecarga operativa. |
| Flujo de trabajo de agente multimodelo | API de modelo a través de Flatkey | Una sola clave y un solo registro pueden superar la operación de muchos endpoints de GPU. |
Errores comunes de precio en el alquiler de GPU
| Error | Qué hacer en su lugar |
|---|---|
| Comparar solo el precio horario de GPU listado | Compara el coste del trabajo completado después de almacenamiento, ancho de banda, tiempo de inactividad y reintentos. |
| Tratar los descuentos spot como ahorro garantizado | Añade el desperdicio por interrupciones y la sobrecarga de checkpoints. |
| Reservar capacidad antes de medir la utilización | Ejecuta bajo demanda el tiempo suficiente para conocer la demanda base. |
| Ignorar la limpieza del almacenamiento | Configura alertas sobre volúmenes no adjuntos, snapshots y checkpoints antiguos. |
| Mezclar RTX 4090, L40S, A100, H100 y H200 como si fueran intercambiables | Alinea VRAM, rendimiento tensorial, interconexión y stack de software con la carga de trabajo. |
| Olvidar la gravedad de los datos | Coloca conjuntos de datos, almacenamiento de objetos y GPUs cerca unos de otros. |
| Usar el alquiler de GPU para toda carga de trabajo de IA | Compáralo con las APIs de modelos cuando la sobrecarga operativa domine. |
FAQ
¿Cuál es la mejor manera de comparar los precios de alquiler de GPU?
La mejor manera de comparar los precios de alquiler de GPU es calcular el coste por carga de trabajo completada. Incluye la tarifa horaria de la GPU, almacenamiento, egreso, tiempo de inactividad, reintentos, trabajos fallidos, soporte y sobrecarga de ingeniería. Una tarifa horaria más baja puede salir peor si provoca más reinicios o tiempo de inactividad.
¿Son más baratos los precios de alquiler de GPU de Vast.ai que los de los proveedores de nube?
Los precios de alquiler de GPU de Vast.ai pueden ser más bajos para algunas GPU porque es un mercado, pero la comparación depende de la fiabilidad del host, la interruptibilidad, el disco, el ancho de banda, el nivel de verificación y la tolerancia de la carga de trabajo. Trata cada anuncio como una oferta específica, no como un precio universal.
¿Los precios de alquiler de GPU de RunPod son bajo demanda o spot?
Los precios de alquiler de GPU de RunPod dependen del producto y del tipo de nube que elijas. Compara Secure Cloud, Community Cloud, pods, endpoints serverless, almacenamiento, volúmenes de red y comportamiento en estado inactivo por separado.
¿Cuándo debería usar capacidad de GPU reservada?
Usa capacidad de GPU reservada cuando la utilización sea predecible, el tipo de GPU siga siendo útil durante el periodo de compromiso y la capacidad garantizada sea importante. Si tu utilización base es baja, reserva solo la base y cubre el resto mediante bajo demanda o spot.
¿Por qué cambian tanto los precios de alquiler de GPU con el tiempo?
Los precios de alquiler de GPU cambian con el tiempo porque la oferta de hardware, la demanda de IA, la capacidad regional, la competencia entre proveedores y la eficiencia de servicio se mueven al mismo tiempo. Sigue la familia exacta de GPU y la eficiencia de tu carga de trabajo, no solo los promedios del mercado.
¿Qué costes ocultos importan más en los servicios de nube de GPU?
Los costes ocultos que más importan son el tiempo de inactividad, el almacenamiento persistente, las instantáneas, el egreso, los arranques en frío, los reintentos, los trabajos fallidos, la infraestructura de red, el soporte y la sobrecarga de ingeniería. Los equipos pequeños suelen notar primero el tiempo de inactividad y el almacenamiento; los equipos más grandes suelen notar la red, el soporte y la capacidad reservada infrautilizada.
Lista de verificación final
Antes de elegir un proveedor de alquiler de GPU, confirma:
- El modelo de GPU, el tamaño de memoria, la región y la unidad de facturación están registrados.
- El modo de precios es bajo demanda, spot, reservado, serverless, marketplace o dedicado.
- Se incluyen el almacenamiento, el ancho de banda, las instantáneas y el tiempo de inactividad.
- Se modelan la interrupción spot y el desperdicio por reintentos.
- La capacidad reservada tiene un punto de equilibrio de utilización.
- La URL de origen y la fecha de verificación se adjuntan a cada precio.
- La decisión final se basa en el coste de la carga de trabajo completada, no solo en los precios horarios de alquiler de GPU.
Esta es la forma práctica de evaluar los precios de alquiler de GPU: páginas de origen actuales, una hoja de cálculo adaptada a la carga de trabajo y una decisión clara sobre cuándo alquilar hardware compensa la complejidad operativa.


