
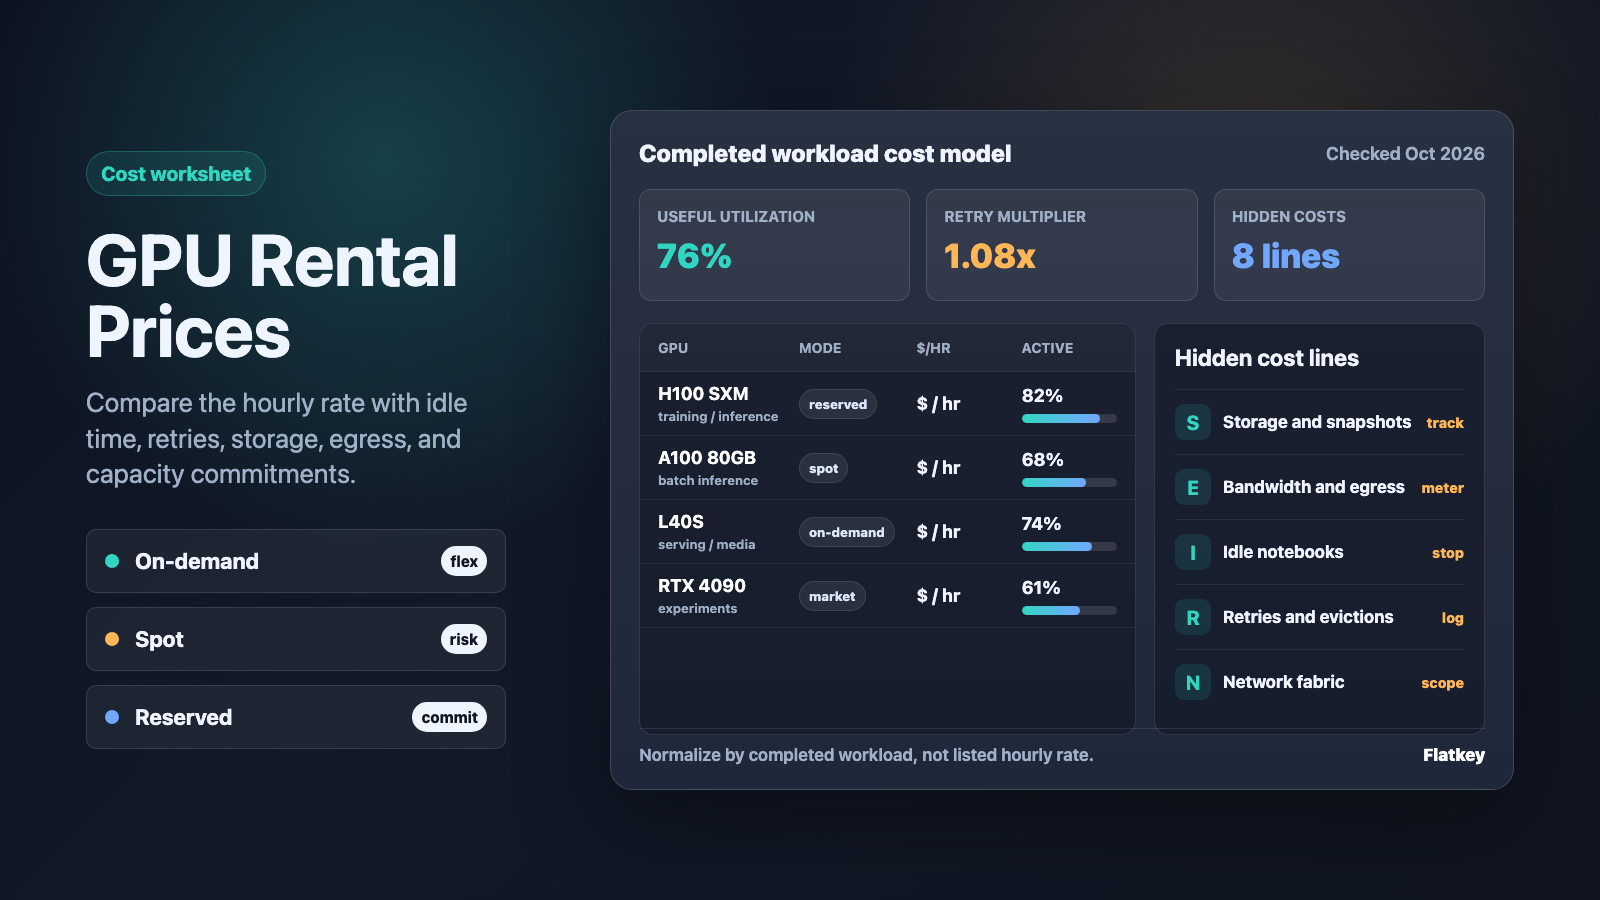
Explication des prix de location de GPU : à la demande, spot, réservé et coûts cachés
Les prix de location de GPU semblent simples jusqu’à ce que vous essayiez de prévoir un véritable entraînement, le lancement d’une inférence ou un lot de génération d’images. Le tarif horaire affiché n’est qu’un poste de coût parmi d’autres. Votre facture finale dépend aussi du fait que le GPU soit à la demande, spot ou interruptible, réservé, serverless ou dédié ; du temps pendant lequel la machine reste inactive ; de l’emplacement du stockage ; de la quantité de données qui quittent la région ; et de l’effort de fiabilité que votre équipe doit absorber.
Ce guide offre aux développeurs, fondateurs d’IA, équipes plateforme et réviseurs achats une manière pratique de comparer les prix de location de GPU sans se laisser piéger par un seul chiffre horaire attrayant.
La version courte : comparez le coût par heure de charge de travail achevée, pas seulement le prix du GPU par heure d’horloge.
Le cadre rapide des prix de location de GPU
Commencez chaque comparaison de prix de location de GPU avec une formule normalisée :
coût GPU effectif par charge de travail achevée =
  (calcul GPU + stockage + instantanés + bande passante + temps d'inactivité + nouvelles tentatives + support + surcharge d'ingénierie)
  / unités d'entraînement, d'inférence, de traitement par lots ou de tâche média achevées
Puis décomposez la décision en quatre questions :
| Question | Pourquoi cela change les prix de location de GPU |
|---|---|
| De quelle classe de GPU avez-vous besoin ? | Les machines de classe H100, H200, B200, A100, L40S, RTX 4090 et RTX 6000 ont des courbes différentes en matière de mémoire, de réseau, d’offre et de prix. |
| Quelle est la prévisibilité de la charge de travail ? | Une inférence de production stable peut justifier une capacité réservée ou engagée ; les expérimentations et les tâches par à-coups conviennent souvent mieux à la demande ou au spot. |
| Quelle est la tolérance aux interruptions de la tâche ? | La capacité spot et celle du marché communautaire peuvent être moins chères, mais ce sont les nouvelles tentatives et les points de contrôle qui déterminent si elles le sont réellement. |
| Qu’est-ce qui se situe en dehors de l’heure GPU ? | Le stockage, les instantanés, l’egress, les notebooks inactifs, les téléchargements de conteneurs, les plans de support et le réseau du cluster peuvent modifier le coût réel. |
Pour la plupart des équipes, la bonne réponse n’est pas « trouver le GPU le moins cher ». La bonne réponse est « louer la capacité fiable la moins chère qui termine la tâche avec un délai de file d’attente, un risque de redémarrage et une surcharge opérationnelle acceptables ».
Tableau actuel des sources de tarification
Les prix de location de GPU changent fréquemment et les pages des places de marché peuvent évoluer plus vite que les revues achats. Considérez le tableau ci-dessous comme une liste de contrôle des sources, et non comme une grille tarifaire figée. Notez la date de vérification, le modèle de GPU, la région, la taille de la mémoire, l’unité de facturation et si le prix est à la demande, spot, réservé, communautaire, cloud sécurisé, serverless ou dédié.
| Fournisseur ou marché | Source officielle de tarification à consulter | Éléments à relever | Remarques pour la comparaison |
|---|---|---|---|
| Vast.ai | Tarification Vast.ai et FAQ Vast.ai | Modèle de GPU, fiabilité de l’hôte, statut interruptible, stockage, bande passante, niveau de vérification, datacenter ou hôte communautaire | Les prix de location de GPU Vast.ai sont déterminés par le marché ; deux offres RTX 4090 ou H100 peuvent donc différer selon l’emplacement, l’hôte, la fiabilité, le stockage et le réseau. |
| RunPod | Tarification RunPod et documentation RunPod sur le stockage et les volumes réseau | Secure Cloud vs Community Cloud, modèle de GPU, stockage du pod, volume réseau, tarification des workers serverless, temps d’inactivité | Les prix de location de GPU RunPod varient selon le type de cloud et le mode de produit. Comparez séparément les pods, le serverless et le stockage. |
| Massed Compute | Tarification Massed Compute | Taux horaire GPU à la demande, réservation à long terme ou devis de cluster, mémoire GPU, région, périmètre du support | Les prix de location de GPU Massed Compute sont utiles pour établir une référence de la capacité cloud IA dédiée, mais les clusters privés ou réservés peuvent nécessiter un devis. |
| Lambda Cloud | Tarification Lambda Cloud | Instance GPU à la demande, nombre de GPU, stockage local, disponibilité régionale, conditions du cluster réservé | Lambda publie des tarifs horaires simples pour le cloud GPU sur des instances NVIDIA courantes ; vérifiez la disponibilité actuelle avant de planifier une exécution sensible au temps. |
| AWS EC2 | Tarification Amazon EC2 et instances EC2 Spot | Famille d’instances, région, On-Demand, Spot, Savings Plans, Reserved Instances, EBS, transfert de données, support | AWS sert souvent de modèle de référence pour l’économie de l’on-demand, du spot et de l’usage engagé, mais les familles d’instances GPU et la disponibilité régionale comptent. |
| Google Cloud | Tarification des GPU Compute Engine et VM Spot | Type de GPU, famille de machine, région, statut de VM Spot, remise pour engagement d’utilisation, disque persistant, egress réseau | Google Cloud sépare la mécanique du GPU, de la machine, du disque, du réseau et des remises. Normalisez tous ces éléments avant de comparer avec des clouds GPU spécialisés. |
Ajoutez une ligne à chaque source : vérifié le 12 octobre 2026. Si vous réutilisez la feuille de calcul plus tard, mettez à jour la date de vérification avant de réutiliser un quelconque chiffre.
Prix de location de GPU à la demande
Les prix de location de GPU à la demande constituent le point de départ le plus simple : vous payez la capacité GPU pendant que l’instance, le pod ou le serveur fonctionne, généralement sans engagement à long terme. C’est le mode que la plupart des équipes devraient utiliser pour les premiers benchmarks, car il simplifie les variables d’ingénierie.
La location à la demande est généralement le bon choix par défaut lorsque :
- Vous testez un nouveau modèle, framework, jeu de données ou pipeline de prompt.
- Le travail est urgent et ne peut pas attendre une capacité spot.
- Vous avez besoin d’un point de terminaison stable pour des démos, l’assurance qualité ou un trafic client précoce.
- Vous ne connaissez pas encore suffisamment bien l’utilisation pour réserver de la capacité.
- Vous avez besoin du support du fournisseur et d’un réseau prévisible plus que du tarif horaire le plus bas.
Le risque, c’est le temps d’inactivité. Un notebook GPU qui coûte moins cher à l’heure peut tout de même être onéreux s’il tourne tout le week-end sans aucun travail associé. Pour la location à la demande, mesurez le temps d’exécution facturable par rapport au temps de calcul utile.
taux de gaspillage à la demande =
  1 - minutes utiles d’activité GPU / minutes facturables de l’instance
Si le taux de gaspillage est élevé, ne négociez pas d’abord le tarif GPU. Corrigez l’automatisation de l’arrêt, la planification des files d’attente, l’autoscaling et le groupage des tâches.
Tarification GPU spot, interruptible et sur les places de marché
La tarification GPU spot utilise la capacité inutilisée et peut offrir des remises significatives par rapport à la location à la demande, mais la capacité peut disparaître. AWS décrit les instances EC2 Spot comme de la capacité EC2 excédentaire disponible avec des remises allant jusqu’à 90 % par rapport aux tarifs à la demande. Les VM Spot de Google Cloud bénéficient également de remises, mais peuvent être préemptées. Les places de marché communautaires comme Vast.ai ajoutent une autre variante : le prix est fixé par l’offre et la demande des hôtes, et le profil de fiabilité n’est pas le même que celui d’une instance à la demande d’un hyperscaler.
Les prix de location GPU spot ou interruptible peuvent être avantageux lorsque :
- Les travaux d’entraînement enregistrent fréquemment des checkpoints.
- L’inférence batch peut être relancée sans échec visible pour l’utilisateur.
- Les files de génération d’images ou de vidéo tolèrent des délais.
- Vous pouvez répartir le travail sur de nombreux workers.
- Vous disposez d’une orchestration qui détecte l’éviction, redémarre les tâches et évite la double facturation.
Le spot peut être désavantageux lorsque :
- Un seul entraînement de plusieurs jours redémarre à partir d’un ancien checkpoint.
- Le chargement des données prend suffisamment de temps pour que chaque interruption fasse perdre des heures.
- Le modèle nécessite un réseau multi-nœuds et qu’un seul worker perdu fait échouer la tâche.
- Les ingénieurs passent des jours à maintenir la logique de reprise et de checkpoint.
- Vous promettez une latence côté client sur une capacité que vous ne contrôlez pas.
Pour le spot, calculez le taux effectif avec le gaspillage lié aux redémarrages :
taux horaire effectif spot =
  taux horaire spot / (1 - part de gaspillage due aux interruptions)
Si un H100 spot est 45 % moins cher mais que les interruptions gaspillent 35 % du temps écoulé du travail, l’avantage réel est bien plus faible que la remise mise en avant.
Capacité GPU réservée, engagée et dédiée
La capacité réservée échange la flexibilité contre la prévisibilité. Vous vous engagez sur une durée, un niveau de dépense ou un cluster dédié afin que le fournisseur puisse allouer le matériel et que vous puissiez réduire le coût horaire effectif ou sécuriser des GPU rares.
Les prix de location GPU réservés ont du sens lorsque :
- L’inférence en production présente une utilisation de base stable.
- Les plannings d’entraînement sont prévisibles sur plusieurs mois.
- Les achats ont besoin d’un budget mensuel connu.
- Vous avez besoin d’une capacité garantie pour une fenêtre de lancement.
- Le réseau multi-nœuds, la proximité du stockage et le support font partie des exigences.
La capacité réservée peut se retourner contre vous lorsque :
- Le choix du modèle change avant la fin du contrat.
- La demande est par à-coups et l’utilisation de base reste faible.
- Une nouvelle génération de GPU modifie la courbe performance par dollar.
- Le contrat exclut le niveau de stockage, de support ou de réseau dont vous avez réellement besoin.
Avant de réserver, calculez le seuil de rentabilité d’utilisation :
seuil de rentabilité de la capacité réservée =
  coût mensuel réservé / (taux horaire à la demande * heures dans le mois)
Si le seuil de rentabilité est de 58 % d’utilisation et que votre base réelle est de 30 %, réservez moins de capacité et faites tout le reste en burst à la demande ou en spot.
Prix de location de GPU Vast.ai
Les gens recherchent les prix de location de GPU Vast.ai parce que Vast est une place de marché, et non un simple barème cloud fixe. C’est à la fois l’attrait et le risque. Vous pouvez trouver des offres agressives de RTX 4090, A100 ou H100, mais chaque annonce nécessite un contrôle de qualité.
Lorsque vous comparez les prix de location de GPU Vast.ai, relevez :
- Le modèle de GPU et la VRAM.
- Le nombre de GPU dans la machine.
- La fiabilité de l’hôte et son statut de vérification.
- Le contexte hôte : centre de données ou communauté.
- Le statut interruptible ou non interruptible.
- La taille du disque local et la bande passante du disque.
- La bande passante d’envoi/téléchargement et le besoin d’une IP publique.
- Le temps de démarrage de l’image conteneur.
- La capacité de votre tâche à enregistrer un checkpoint et à reprendre.
Pour vast.ai gpu rental prices rtx 4090, ne comparez pas seulement le tarif horaire de la RTX 4090. Comparez aussi la VRAM, l’historique de l’hôte, la taille du disque, le coût du stockage et le fait que la tâche soit de l’entraînement, de l’inférence, ComfyUI, de l’annotation de données ou une expérimentation ponctuelle. Une RTX 4090 très bon marché peut être le bon choix pour de courtes expériences et le mauvais pour de l’inférence en production.
Prix de location de GPU RunPod
Les prix de location de GPU RunPod doivent être distingués selon les modes de produit. Un pod RunPod n’est pas la même unité économique qu’un point de terminaison serverless, et Secure Cloud n’a pas le même profil de risque que Community Cloud.
Lorsque vous comparez les prix de location de GPU RunPod, relevez :
- Cloud sécurisée ou cloud communautaire.
- Tarif horaire du GPU du pod.
- Tarification des workers serverless si vous utilisez des endpoints au lieu de pods.
- Coût du volume persistant et du volume réseau.
- Comportement de cold start et nombre minimal de workers.
- Comportement des pods inactifs.
- Localité des données et savoir si la charge de travail récupère à plusieurs reprises de grands modèles.
RunPod peut être rentable pour les équipes d’applications IA qui veulent un accès rapide au GPU sans exploiter un cluster complet. Le point à vérifier en matière de coûts cachés est le démarrage et le stockage : si chaque worker télécharge à plusieurs reprises de gros poids ou laisse des volumes attachés après les expérimentations, la ligne horaire du GPU sous-estimera la facture.
Tarifs de location de GPU chez Massed Compute
Les tarifs de location de GPU chez Massed Compute sont une référence utile pour les acheteurs qui comparent des fournisseurs cloud GPU spécialisés, surtout lorsque la question ne concerne plus un simple pod de développement et commence à impliquer une capacité IA dédiée. Pour une expérience simple, comparez le tarif horaire publié. Pour l’inférence en production ou l’entraînement multinœud, demandez ce qui est inclus dans le prix du cluster.
À relever :
- Modèle de GPU et mémoire.
- Prix horaire à la demande par rapport au devis de réservation.
- Engagement minimum.
- Réseau fabric.
- Niveau de stockage.
- Support et conditions de SLA.
- Région et exigences de conformité.
- Si le devis inclut l’installation, la migration ou des services managés.
C’est ici que le langage des achats prend de l’importance. « Cluster GPU réservé » peut signifier un tarif plus bas, du matériel garanti, un réseau privé, un accès au support, ou tout cela à la fois. Demandez chaque poste séparément.
Évolution des prix de location de GPU dans le temps
Les prix de location de GPU dans le temps ne suivent pas une trajectoire linéaire. Trois forces tirent généralement dans des directions différentes :
| Force | Effet sur le prix |
|---|---|
| Nouvelle offre matérielle | Les GPU plus anciens peuvent devenir moins chers lorsque les classes H200, B200, B300 ou plus récentes deviennent disponibles. |
| Pics de demande IA | La capacité de classe H100/H200 peut rester coûteuse ou rare pendant les pics de lancement de modèles, d’entraînement ou d’inférence. |
| Gains d’efficacité | Une meilleure quantification, le batching, les moteurs de serving et le routage des modèles peuvent réduire le coût par tâche même lorsque le prix horaire du GPU reste stable. |
Ne vous fiez pas à une seule histoire du type « les prix des GPU baissent » ou « les prix des GPU augmentent ». Suivez la famille exacte de GPU que vous utilisez, la région, les conditions engagées et l’efficacité de votre charge de travail. Votre coût par token, image, fine-tuning ou échantillon d’entraînement peut s’améliorer même si les prix horaires de location de GPU restent identiques.
Coûts cachés dans la location de GPU cloud
Les coûts cachés ne sont pas toujours malveillants. Il s’agit souvent de primitives cloud normales qui deviennent importantes parce que les charges de travail GPU déplacent de gros fichiers et restent inactives pendant le débogage.
| Coût caché | Comment il se manifeste | Comment le maîtriser |
|---|---|---|
| Temps d’inactivité | Pods, notebooks ou instances en cours d’exécution sans tâche active | Arrêter automatiquement les ressources inactives ; étiqueter les expériences ; déclencher des alertes sur les GPU de longue durée. |
| Stockage persistant | Volumes, disques, snapshots, caches de modèles, ensembles de données | Séparer les poids de modèles réutilisables des sorties temporaires ; nettoyer les volumes abandonnés. |
| Sortie réseau | Déplacement d’ensembles de données, de checkpoints, de sorties ou d’artefacts de modèle entre régions ou vers Internet | Conserver les données, le GPU et le stockage d’objets dans la même région lorsque c’est possible. |
| Cold starts | Téléchargement des conteneurs et des poids de modèle avant le début du travail utile | Préconstruire les images ; utiliser des caches locaux ; mesurer le temps de démarrage comme du temps facturable. |
| Retries et jobs échoués | Échecs de mémoire insuffisante, évictions, mauvais pilotes, hôtes instables | Exécuter de petits canaries ; faire des checkpoints ; figer des images connues comme fiables ; consigner le coût des échecs. |
| Réseau multinœud | Primes pour InfiniBand, RoCE, placement ou fabric de cluster | Réserver uniquement lorsque la charge de travail nécessite réellement un entraînement distribué. |
| Support et conformité | Plans de support payants, clusters privés, besoins d’audit, services managés | Décider quelles charges de travail nécessitent des conditions entreprise et lesquelles peuvent rester expérimentales. |
| Charge d’ingénierie | Temps consacré à la maintenance des scripts, des ordonnanceurs et de la configuration spécifique au cloud | Inclure les heures de mise en place et d’incident dans le tableau TCO. |
Pour les prix de location de GPU, le stockage et le temps d’inactivité sont les deux coûts cachés les plus susceptibles de surprendre les petites équipes. Pour les équipes plus importantes, le support, le réseau et la capacité réservée sous-utilisée deviennent généralement les principaux risques budgétaires.
Feuille de calcul du prix de location de GPU
Utilisez cette feuille de calcul avant d’approuver un fournisseur, de réserver un cluster ou de migrer une charge de travail.
| Champ | Exemple | Pourquoi c’est important |
|---|---|---|
| Fournisseur | RunPod, Vast.ai, Massed Compute, AWS, Google Cloud, Lambda | Permet de distinguer l’économie des places de marché, des clouds spécialisés et des hyperscalers. |
| Mode de produit | pod à la demande, instance spot, cluster réservé, endpoint serverless | L’unité de facturation et le niveau de fiabilité changent selon le mode. |
| Modèle de GPU | H100 SXM, H100 PCIe, A100 80GB, L40S, RTX 4090 | La mémoire et l’interconnexion comptent souvent plus que le nom de la marque. |
| Région ou hôte | US-East, EU, hôte communautaire, hôte de datacenter | La disponibilité, les règles relatives aux données, la latence et la bande passante diffèrent selon l’emplacement. |
| Prix horaire du GPU | $x.xx/hour |
Point de départ uniquement. |
| Unité de facturation minimale | seconde, minute, heure, mois | Les tâches courtes sont sensibles à l’arrondi et aux démarrages à froid. |
| Coût de stockage | volume, disque, instantané, stockage d’objets | Les poids du modèle et les checkpoints peuvent devenir des coûts mensuels durables. |
| Bande passante ou egress | entrant, sortant, IP publique, inter-région | Les grands jeux de données et les médias générés modifient le coût total. |
| Pourcentage d’inactivité | 22% |
Mesure directe du temps de location gaspillé. |
| Taux d’échec/de relance | 1.08x |
Prend en compte les évictions, les OOM, les mauvaises images et les redémarrages. |
| Unité de sortie utile | époque entraînée, image acceptée, 1M tokens, tâche terminée | Convertit le prix horaire en valeur commerciale. |
| Support et opérations | auto-géré, géré, SLA, cluster privé | Les coûts d’approvisionnement et de fiabilité doivent être intégrés dans le même modèle. |
Pour un calcul de coûts plus approfondi au niveau du modèle après que la charge de travail est servie via des API, comparez cela avec comparaison des prix des modèles IA et comment comparer les prix des modèles IA.
Quand une API de modèle est moins chère que la location de GPU
Louer des GPU n’est pas automatiquement moins cher que d’utiliser une API de modèle. La location de GPU est avantageuse lorsque vous avez une forte utilisation, des besoins clairs de propriété du modèle, des stacks d’inférence personnalisés, des contraintes de confidentialité ou des charges de travail d’entraînement qui ne peuvent pas être déléguées à une API.
Une API de modèle peut être moins chère lorsque :
- L’utilisation est faible ou irrégulière.
- L’équipe change fréquemment de modèle.
- La fiabilité, la mise à l’échelle et les mises à niveau détourneraient l’attention du travail produit.
- La charge de travail nécessite de nombreuses familles de modèles plutôt qu’un seul modèle auto-hébergé.
- La finance a davantage besoin d’un registre d’utilisation que d’un projet d’exploitation de cluster.
Flatkey se situe du côté API de cette décision. Il offre aux équipes une clé API, un solde, une facture et un registre d’utilisation uniques sur de nombreux modèles et outils officiels. Si votre feuille de calcul montre que les GPU auto-hébergés ne constituent pas encore le vrai goulot d’étranglement, commencez avec une API multi-fournisseurs et comparez le coût par résultat accepté avant de vous engager dans l’exploitation d’un cluster. Pour la couche de gouvernance API, voir tarification des passerelles IA, gestion des dépenses des API IA et contrôles de quota des API IA.
Guide de décision : à la demande, spot, réservé ou API
| Charge de travail | Meilleur point de départ | Pourquoi |
|---|---|---|
| Premier benchmark de modèle | GPU à la demande | Mesure la plus propre, moins de variables d’interruption. |
| Workflow ComfyUI ou image ponctuel | GPU à la demande ou de place de marché | Configuration rapide ; une capacité de classe RTX 4090 peut suffire. |
| Inférence par lot avec relances | GPU spot ou interruptible | Les remises peuvent l’emporter si la logique de relance est solide. |
| Base d’inférence en production | GPU réservé ou engagé | Une utilisation stable peut justifier l’engagement. |
| Entraînement multi-nœuds | Cluster dédié ou capacité réservée | Le réseau et le placement comptent autant que le tarif horaire. |
| Fonction IA à faible volume | API de modèle via une passerelle | Évite la capacité GPU inactive et les frais d’exploitation. |
| Workflow agentique multi-modèle | API de modèle via Flatkey | Une clé et un registre peuvent être meilleurs que l’exploitation de nombreux endpoints GPU. |
Erreurs courantes dans la tarification de la location de GPU
| Erreur | Que faire à la place |
|---|---|
| Comparer uniquement le prix horaire GPU affiché | Comparer le coût de la charge de travail terminée après stockage, bande passante, temps d’inactivité et relances. |
| Considérer les remises spot comme des économies garanties | Ajouter le gaspillage lié aux interruptions et la surcharge des checkpoints. |
| Réserver de la capacité avant de mesurer l’utilisation | Exécuter en mode à la demande assez longtemps pour connaître la demande de base. |
| Ignorer le nettoyage du stockage | Mettre en alerte les volumes non attachés, les instantanés et les anciens checkpoints. |
| Mélanger RTX 4090, L40S, A100, H100 et H200 comme s’ils étaient interchangeables | Faire correspondre la VRAM, les performances tensorielles, l’interconnexion et la pile logicielle à la charge de travail. |
| Oublier la gravité des données | Placer les jeux de données, le stockage d’objets et les GPU près les uns des autres. |
| Utiliser la location de GPU pour chaque charge de travail IA | Comparer avec les API de modèle lorsque les frais d’exploitation dominent. |
FAQ
Quelle est la meilleure façon de comparer les prix de location de GPU ?
La meilleure façon de comparer les prix de location de GPU est de calculer le coût par charge de travail terminée. Incluez le tarif horaire du GPU, le stockage, les frais de sortie de données, le temps d’inactivité, les nouvelles tentatives, les tâches échouées, le support et la charge de travail d’ingénierie. Un tarif horaire plus bas peut être désavantageux s’il entraîne davantage de redémarrages ou de temps d’inactivité.
Les prix de location de GPU de Vast.ai sont-ils moins chers que ceux des fournisseurs cloud ?
Les prix de location de GPU de Vast.ai peuvent être plus bas pour certains GPU parce qu’il s’agit d’une place de marché, mais la comparaison dépend de la fiabilité de l’hôte, de l’interruptibilité, du disque, de la bande passante, du niveau de vérification et de la tolérance de la charge de travail. Considérez chaque annonce comme une offre spécifique, pas comme un prix universel.
Les prix de location de GPU de RunPod sont-ils à la demande ou spot ?
Les prix de location de GPU de RunPod dépendent du produit et du type de cloud que vous choisissez. Comparez séparément Secure Cloud, Community Cloud, les pods, les endpoints serverless, le stockage, les volumes réseau et le comportement en cas d’inactivité.
Quand devrais-je utiliser une capacité GPU réservée ?
Utilisez une capacité GPU réservée lorsque l’utilisation est prévisible, que le type de GPU restera utile pendant la période d’engagement et qu’une capacité garantie est importante. Si votre utilisation de base est faible, réservez uniquement la base et faites varier le reste via le mode à la demande ou spot.
Pourquoi les prix de location de GPU évoluent-ils autant au fil du temps ?
Les prix de location de GPU évoluent parce que l’offre de matériel, la demande en IA, la capacité régionale, la concurrence entre fournisseurs et l’efficacité de service bougent tous en même temps. Suivez la famille exacte de GPU et l’efficacité de votre charge de travail, pas seulement les moyennes du marché.
Quels coûts cachés comptent le plus dans les services cloud GPU ?
Les coûts cachés qui comptent le plus sont le temps d’inactivité, le stockage persistant, les snapshots, les frais de sortie de données, les démarrages à froid, les nouvelles tentatives, les tâches échouées, le réseau, le support et la charge de travail d’ingénierie. Les petites équipes ressentent généralement d’abord l’inactivité et le stockage ; les équipes plus grandes ressentent généralement le réseau, le support et la capacité réservée sous-utilisée.
Liste de contrôle finale
Avant de choisir un fournisseur de location de GPU, vérifiez :
- Le modèle de GPU, la taille de la mémoire, la région et l’unité de facturation sont enregistrés.
- Le mode de tarification est à la demande, spot, réservé, serverless, marketplace ou dédié.
- Le stockage, la bande passante, les snapshots et le temps d’inactivité sont inclus.
- L’interruption en mode spot et le gaspillage dû aux nouvelles tentatives sont modélisés.
- La capacité réservée a un seuil de rentabilité en matière d’utilisation.
- L’URL source et la date de vérification sont attachées à chaque prix.
- La décision finale est basée sur le coût de la charge de travail terminée, et pas seulement sur les prix horaires de location de GPU.
C’est la méthode pratique pour évaluer les prix de location de GPU : des pages sources à jour, une feuille de calcul adaptée à la charge de travail, et une décision claire sur le moment où la location de matériel vaut la complexité opérationnelle.


