
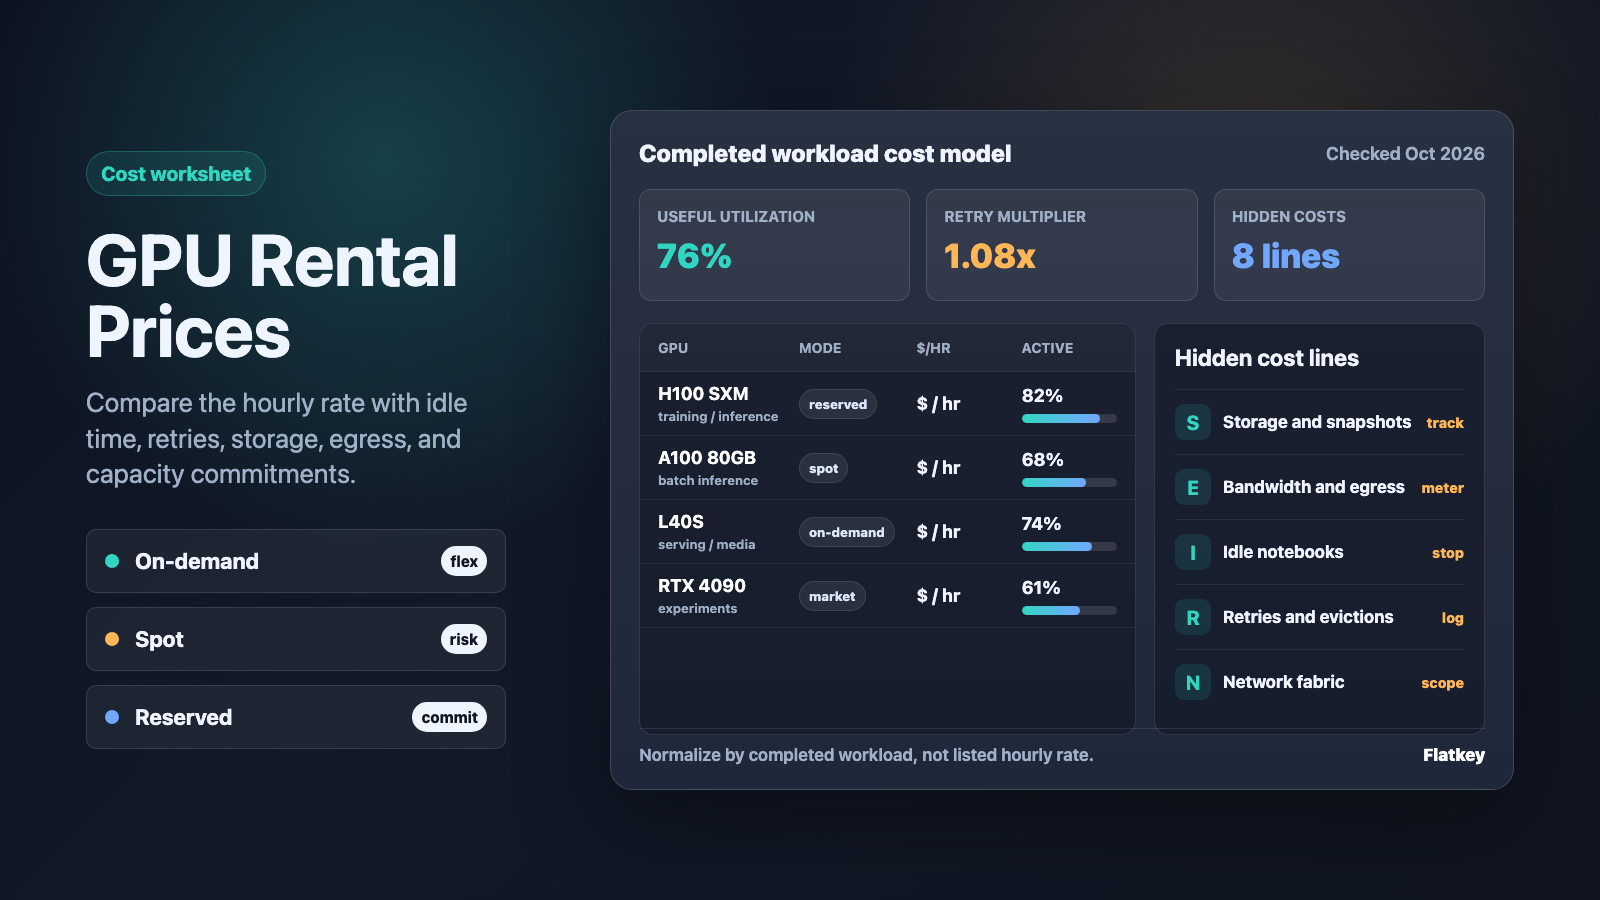
Preços de Aluguel de GPU Explicados: On-Demand, Spot, Reserved e Custos Ocultos
Os preços de aluguel de GPU parecem simples até você tentar prever uma execução real de treinamento, um lançamento de inferência ou um lote de geração de imagens. A tarifa horária em destaque é apenas uma linha do custo. Sua fatura final também depende de a GPU ser on-demand, spot ou interruptível, reserved, serverless ou dedicada; de quanto tempo a máquina fica ociosa; de onde o armazenamento fica; de quanto dado sai da região; e de quanto trabalho de confiabilidade sua equipe precisa absorver.
Este guia oferece a desenvolvedores, fundadores de IA, equipes de plataforma e revisores de compras uma forma prática de comparar preços de aluguel de GPU sem ficar preso a um único número horário atraente.
A versão curta: compare custo por hora de workload concluído, e não apenas o preço da GPU por hora de relógio.
O framework rápido de preços de aluguel de GPU
Comece toda comparação de preços de aluguel de GPU com uma fórmula normalizada:
custo efetivo de GPU por workload concluído =
  (computação da GPU + armazenamento + snapshots + largura de banda + tempo ocioso + tentativas repetidas + suporte + overhead de engenharia)
  / unidades concluídas de treinamento, inferência, batch ou job de mídia
Depois, divida a decisão em quatro perguntas:
| Pergunta | Por que ela muda os preços de aluguel de GPU |
|---|---|
| Qual classe de GPU você precisa? | Máquinas das classes H100, H200, B200, A100, L40S, RTX 4090 e RTX 6000 têm curvas diferentes de memória, rede, oferta e preço. |
| Quão previsível é o workload? | Inferência de produção estável pode justificar capacidade reserved ou comprometida; experimentos e jobs em rajadas muitas vezes se encaixam melhor em on-demand ou spot. |
| Quão interrompível é o job? | Capacidade spot e de marketplace comunitário pode ser mais barata, mas as tentativas repetidas e o checkpointing determinam se ela é realmente mais barata. |
| O que está fora da hora da GPU? | Armazenamento, snapshots, egress, notebooks ociosos, pulls de contêiner, planos de suporte e rede do cluster podem alterar o custo real. |
Para a maioria das equipes, a resposta certa não é "encontrar a GPU mais barata". A resposta certa é "alugar a capacidade confiável mais barata que conclua o trabalho com tempo de fila aceitável, risco de reinício aceitável e overhead operacional aceitável".
Tabela atual de fontes de preços
Os preços de aluguel de GPU mudam com frequência e as páginas de marketplace podem mudar mais rápido do que as revisões de compras. Trate a tabela abaixo como uma checklist de fontes, não como uma tabela de preços fixa. Registre a data verificada, o modelo da GPU, a região, o tamanho da memória, a unidade de cobrança e se o preço é on-demand, spot, reserved, comunitário, cloud seguro, serverless ou dedicado.
| Fornecedor ou mercado | Fonte oficial de preços para verificar | O que capturar | Observações para comparação |
|---|---|---|---|
| Vast.ai | Preços da Vast.ai e FAQ da Vast.ai | Modelo da GPU, confiabilidade do host, status interruptível, armazenamento, largura de banda, nível de verificação, datacenter ou host comunitário | Os preços de aluguel de GPU da Vast.ai são orientados pelo marketplace, então duas ofertas de RTX 4090 ou H100 podem diferir por localização, host, confiabilidade, armazenamento e rede. |
| RunPod | Preços da RunPod e docs de armazenamento e volume de rede da RunPod | Secure Cloud vs Community Cloud, modelo da GPU, armazenamento do pod, volume de rede, preços de worker serverless, tempo ocioso | Os preços de aluguel de GPU da RunPod variam por tipo de cloud e modo de produto. Compare pods, serverless e armazenamento separadamente. |
| Massed Compute | Preços da Massed Compute | Tarifa horária on-demand da GPU, reserva de longo prazo ou cotação de cluster, memória da GPU, região, escopo de suporte | Os preços de aluguel de GPU da Massed Compute são úteis para benchmark de capacidade dedicada de cloud de IA, mas clusters privados ou reserved podem exigir uma cotação. |
| Lambda Cloud | Preços da Lambda Cloud | Instância de GPU on-demand, quantidade de GPUs, armazenamento local, disponibilidade regional, termos de cluster reserved | A Lambda publica tarifas horárias simples de cloud de GPU para instâncias NVIDIA comuns; confirme a disponibilidade atual antes de planejar uma execução sensível ao tempo. |
| AWS EC2 | Preços do Amazon EC2 e EC2 Spot Instances | Família da instância, região, On-Demand, Spot, Savings Plans, Reserved Instances, EBS, transferência de dados, suporte | A AWS costuma ser o modelo de referência para a economia de on-demand, spot e uso comprometido, mas as famílias de instâncias GPU e a disponibilidade regional importam. |
| Google Cloud | Preços de GPU do Compute Engine e Spot VMs | Tipo de GPU, família da máquina, região, status da Spot VM, desconto por uso comprometido, disco persistente, egress de rede | O Google Cloud separa os mecanismos de GPU, máquina, disco, rede e desconto. Normalize todos eles antes de comparar com clouds especializadas em GPU. |
Adicione uma linha a cada linha de origem: verificado em 12 de outubro de 2026. Se você reutilizar a planilha mais tarde, atualize a data de verificação antes de reutilizar qualquer número.
Preços de aluguel de GPU on-demand
Os preços de aluguel de GPU on-demand são o ponto de partida mais limpo: você paga pela capacidade da GPU enquanto a instância, pod ou servidor estiver em execução, geralmente sem compromisso de longo prazo. Este é o modo que a maioria das equipes deve usar para os primeiros benchmarks, porque mantém as variáveis de engenharia simples.
On-demand costuma ser a escolha padrão certa quando:
- Você está testando um novo modelo, framework, dataset ou pipeline de prompts.
- O trabalho é urgente e não pode esperar por capacidade spot.
- Você precisa de um endpoint estável para demos, QA ou tráfego inicial de clientes.
- Você ainda não conhece bem a utilização para reservar capacidade.
- Você precisa de suporte do provedor e rede previsível mais do que da menor taxa por hora.
O risco é o tempo ocioso. Um notebook de GPU que custa menos por hora ainda pode sair caro se ficar rodando o fim de semana inteiro sem jobs anexados. Para on-demand, meça tempo de execução faturável contra tempo de computação útil.
taxa de desperdício on-demand =
  1 - minutos úteis com GPU ativa / minutos faturáveis da instância
Se a taxa de desperdício for alta, não negocie primeiro a tarifa da GPU. Corrija a automação de desligamento, o agendamento de filas, o autoscaling e o empacotamento de jobs.
Preços de GPU spot, interruptíveis e de marketplace
O preço spot de GPU usa capacidade não utilizada e pode oferecer descontos significativos em comparação com on-demand, mas a capacidade pode desaparecer. A AWS descreve as EC2 Spot Instances como capacidade EC2 excedente disponível com descontos de até 90% em comparação com o preço On-Demand. As Google Cloud Spot VMs também têm desconto, mas podem ser preemptadas. Marketplaces comunitários como o Vast.ai acrescentam outra variação: o preço é definido pela oferta e demanda do host, e o perfil de confiabilidade não é o mesmo de uma instância on-demand de um hyperscaler.
Os preços de aluguel de GPU spot ou interruptível podem valer a pena quando:
- Os jobs de treinamento fazem checkpoint com frequência.
- A inferência em lote pode ser repetida sem falha visível ao usuário.
- Filas de geração de imagens ou vídeo toleram atrasos.
- Você pode dividir o trabalho entre muitos workers.
- Você tem orquestração que detecta expulsão, reinicia jobs e evita cobrança duplicada.
O spot pode sair perdendo quando:
- Uma única execução de treinamento de vários dias reinicia a partir de um checkpoint antigo.
- O carregamento de dados leva tempo suficiente para que cada interrupção desperdice horas.
- O modelo precisa de rede multinó e a perda de um worker derruba o job.
- Os engenheiros passam dias mantendo a lógica de retry e checkpoint.
- Você promete latência voltada ao cliente em capacidade que não controla.
Para spot, calcule a taxa efetiva com desperdício por reinício:
taxa horária efetiva spot =
  taxa horária spot / (1 - parcela de desperdício por interrupção)
Se um H100 spot é 45% mais barato, mas as interrupções desperdiçam 35% do tempo decorrido do job, a vantagem real é muito menor do que o desconto anunciado.
Capacidade de GPU reservada, comprometida e dedicada
Capacidade reservada troca flexibilidade por previsibilidade. Você se compromete com um prazo, nível de gasto ou cluster dedicado para que o provedor possa alocar hardware e você possa reduzir a taxa horária efetiva ou garantir GPUs escassas.
Os preços de aluguel de GPU reservada fazem sentido quando:
- A inferência em produção tem utilização de base estável.
- Os cronogramas de treinamento são previsíveis por meses.
- A área de compras precisa de um orçamento mensal conhecido.
- Você precisa de capacidade garantida para uma janela de lançamento.
- Rede multinó, localidade de armazenamento e suporte fazem parte do requisito.
A capacidade reservada pode sair pela culatra quando:
- A escolha do modelo muda antes do fim do prazo.
- A demanda é irregular e a utilização de base permanece baixa.
- Uma classe de GPU mais nova muda a curva de desempenho por dólar.
- O contrato exclui o nível de armazenamento, suporte ou rede de que você realmente precisa.
Antes de reservar, calcule o ponto de equilíbrio da utilização:
utilização de equilíbrio da reserva =
  custo mensal reservado / (taxa horária on-demand * horas no mês)
Se o ponto de equilíbrio for 58% de utilização e sua base real for 30%, reserve menos capacidade e faça o restante em burst com on-demand ou spot.
Preços de aluguel de GPU da Vast.ai
As pessoas procuram preços de aluguel de GPU da Vast.ai porque a Vast é um marketplace, não uma única tabela fixa de preços de cloud. Isso é ao mesmo tempo o atrativo e o risco. Você pode encontrar ofertas agressivas de RTX 4090, A100 ou H100, mas cada anúncio precisa de uma checagem de qualidade.
Ao comparar os preços de aluguel de GPU da Vast.ai, capture:
- Modelo da GPU e VRAM.
- Número de GPUs na máquina.
- Confiabilidade do host e status de verificação.
- Contexto de datacenter vs host da comunidade.
- Status interruptível ou não interruptível.
- Tamanho do disco local e largura de banda do disco.
- Largura de banda de upload/download e necessidades de IP público.
- Tempo de inicialização da imagem do container.
- Se seu job pode fazer checkpoint e retomar.
Para vast.ai gpu rental prices rtx 4090, não compare apenas a taxa horária da RTX 4090. Compare também VRAM, histórico do host, tamanho do disco, custo de armazenamento e se o job é treinamento, inferência, ComfyUI, rotulagem de dados ou experimentação pontual. Uma RTX 4090 muito barata pode ser a escolha certa para experimentos curtos e a escolha errada para inferência em produção.
Preços de aluguel de GPU da RunPod
Os preços de aluguel de GPU da RunPod precisam de uma separação entre modos de produto. Um pod da RunPod não é a mesma unidade econômica que um endpoint serverless, e o Secure Cloud não tem o mesmo perfil de risco que o Community Cloud.
Ao comparar os preços de aluguel de GPU da RunPod, capture:
- Cloud seguro ou Cloud comunitária.
- Tarifa horária da GPU do pod.
- Preços do worker serverless se você estiver usando endpoints em vez de pods.
- Custo do volume persistente e do volume de rede.
- Comportamento de cold start e workers mínimos.
- Comportamento do pod inativo.
- Localidade dos dados e se a carga de trabalho baixa modelos grandes repetidamente.
RunPod pode ser econômico para equipes de apps de IA que querem acesso rápido à GPU sem operar um cluster completo. A verificação de custo oculto é a inicialização e o armazenamento: se cada worker baixa repetidamente pesos grandes ou deixa volumes anexados após os experimentos, a linha horária de GPU subestimará a conta.
Preços de aluguel de GPU da Massed Compute
Os preços de aluguel de GPU da Massed Compute são uma referência útil para compradores que comparam provedores especializados de cloud GPU, especialmente quando a questão deixa de ser um único pod de desenvolvimento e passa a envolver capacidade dedicada de IA. Para um experimento simples, compare a tarifa horária publicada. Para inferência em produção ou treinamento multinó, pergunte o que está incluído no preço do cluster.
Registre:
- Modelo de GPU e memória.
- Preço on-demand por hora versus cotação de reserva.
- Compromisso mínimo.
- Tecido de rede.
- Camada de armazenamento.
- Suporte e termos de SLA.
- Região e requisitos de conformidade.
- Se a cotação inclui configuração, migração ou serviços gerenciados.
É aqui que a linguagem de procurement importa. "Reserved GPU cluster" pode significar uma tarifa menor, hardware garantido, rede privada, acesso a suporte ou tudo isso. Peça cada item separadamente.
Preços de aluguel de GPU ao longo do tempo
Os preços de aluguel de GPU ao longo do tempo não se movem em linha reta. Normalmente, três forças puxam em direções diferentes:
| Força | Efeito no preço |
|---|---|
| Nova oferta de hardware | GPUs mais antigas podem ficar mais baratas quando H200, B200, B300 ou classes mais novas se tornam disponíveis. |
| Picos de demanda por IA | Capacidade da classe H100/H200 pode continuar cara ou escassa durante aumentos de lançamento de modelos, treinamento ou inferência. |
| Ganhos de eficiência | Melhor quantização, batching, mecanismos de serving e roteamento de modelos podem reduzir o custo por tarefa mesmo quando o preço horário da GPU permanece estável. |
Não confie em uma única narrativa de "os preços de GPU estão caindo" ou "os preços de GPU estão subindo". Acompanhe a família exata de GPU que você usa, a região, os termos contratados e a eficiência da sua carga de trabalho. Seu custo por token, imagem, fine-tune ou amostra de treinamento pode melhorar mesmo se os preços de aluguel horário de GPU permanecerem os mesmos.
Custos ocultos em aluguéis de GPU na nuvem
Os custos ocultos nem sempre são maliciosos. Eles geralmente são primitivas normais da cloud que se tornam grandes porque cargas de trabalho de GPU movem arquivos grandes e ficam ociosas durante a depuração.
| Custo oculto | Como aparece | Como controlá-lo |
|---|---|---|
| Tempo ocioso | Pods, notebooks ou instâncias em execução sem job ativo | Pare automaticamente recursos ociosos; marque experimentos; dispare alertas para GPUs de longa duração. |
| Armazenamento persistente | Volumes, discos, snapshots, caches de modelos, datasets | Separe pesos de modelos reutilizáveis de saídas temporárias; limpe volumes abandonados. |
| Saída de rede | Movimentação de datasets, checkpoints, saídas ou artefatos de modelo entre regiões ou para a internet | Mantenha dados, GPU e armazenamento de objetos na mesma região quando possível. |
| Cold starts | Baixar contêineres e pesos de modelo antes de o trabalho útil começar | Pré-construa imagens; use caches locais; meça o tempo de inicialização como tempo faturável. |
| Retries e jobs com falha | Falhas por falta de memória, expulsões, drivers ruins, hosts instáveis | Execute canários pequenos; faça checkpoint; fixe imagens conhecidas como boas; registre o custo da falha. |
| Rede multinó | InfiniBand, RoCE, placement ou prêmios de tecido de cluster | Reserve apenas quando a carga de trabalho realmente precisar de treinamento distribuído. |
| Suporte e conformidade | Planos de suporte pagos, clusters privados, necessidades de auditoria, serviços gerenciados | Decida quais cargas de trabalho precisam de termos enterprise e quais podem permanecer experimentais. |
| Overhead de engenharia | Tempo gasto mantendo scripts, schedulers e configuração específica da cloud | Inclua horas de configuração e incidentes na planilha de TCO. |
Para preços de aluguel de GPU, armazenamento e tempo ocioso são os dois custos ocultos com maior probabilidade de surpreender equipes pequenas. Para equipes maiores, suporte, rede e capacidade reservada subutilizada normalmente se tornam os maiores riscos orçamentários.
Planilha de preço de aluguel de GPU
Use esta planilha antes de aprovar um provedor, reservar um cluster ou migrar uma carga de trabalho.
| Campo | Exemplo | Por que isso importa |
|---|---|---|
| Provedor | RunPod, Vast.ai, Massed Compute, AWS, Google Cloud, Lambda | Mantém separadas as economias de marketplace, cloud especializada e hyperscaler. |
| Modo do produto | Pod on-demand, instância spot, cluster reservado, endpoint serverless | A unidade de cobrança e o perfil de confiabilidade mudam conforme o modo. |
| Modelo de GPU | H100 SXM, H100 PCIe, A100 80GB, L40S, RTX 4090 | Memória e interconexão geralmente importam mais do que o nome da marca. |
| Região ou host | US-East, EU, community host, datacenter host | Disponibilidade, regras de dados, latência e largura de banda diferem por localidade. |
| Preço horário da GPU | $x.xx/hour |
Apenas um ponto de partida. |
| Unidade mínima de cobrança | segundo, minuto, hora, mês | Jobs curtos são sensíveis ao arredondamento e a cold starts. |
| Custo de armazenamento | volume, disco, snapshot, armazenamento de objetos | Pesos do modelo e checkpoints podem se tornar custos mensais duráveis. |
| Largura de banda ou egress | entrada, saída, IP público, entre regiões | Conjuntos de dados grandes e mídia gerada alteram o custo total. |
| Percentual ocioso | 22% |
Mede diretamente o tempo de aluguel desperdiçado. |
| Taxa de falha/retry | 1.08x |
Captura expulsões, OOMs, imagens inválidas e reinícios. |
| Unidade de saída útil | época treinada, imagem aceita, 1M tokens, job concluído | Converte o preço horário em valor de negócio. |
| Suporte e operações | autogerenciado, gerenciado, SLA, cluster privado | Custos de aquisição e confiabilidade pertencem ao mesmo modelo. |
Para uma planilha de custo mais aprofundada em nível de modelo depois que a carga de trabalho for atendida por APIs, compare isto com comparação de preços de modelos de IA e como comparar preços de modelos de IA.
Quando uma API de modelo é mais barata do que alugar GPUs
Alugar GPUs não é automaticamente mais barato do que usar uma API de modelo. O aluguel de GPU vence quando você tem alta utilização, necessidade clara de propriedade do modelo, stacks de inferência personalizados, restrições de privacidade ou cargas de trabalho de treinamento que não podem ser delegadas a uma API.
Uma API de modelo pode ser mais barata quando:
- A utilização é baixa ou irregular.
- A equipe troca de modelos com frequência.
- Confiabilidade, escala e upgrades distrairiam do trabalho de produto.
- A carga de trabalho precisa de muitas famílias de modelos, e não de um único modelo auto-hospedado.
- O financeiro precisa mais de um livro-razão de uso do que de um projeto de operações de cluster.
A Flatkey fica do lado da API dessa decisão. Ela oferece às equipes uma chave de API, um saldo, uma fatura e um livro-razão de uso em muitos modelos e ferramentas oficiais. Se a sua planilha mostrar que GPUs auto-hospedadas ainda não são o verdadeiro gargalo, comece com uma API multi-provider e compare o custo por resultado aceito antes de se comprometer com operações de cluster. Para a camada de governança de API, veja preços de gateway de IA, gestão de gastos com API de IA e controles de cota de API de IA.
Guia de decisão: on-demand, spot, reservado ou API
| Carga de trabalho | Melhor ponto de partida | Por quê |
|---|---|---|
| Primeiro benchmark de modelo | GPU on-demand | Medição mais limpa, menos variáveis de interrupção. |
| Workflow único no ComfyUI ou de imagem | GPU on-demand ou de marketplace | Configuração rápida; capacidade da classe RTX 4090 pode ser suficiente. |
| Inferência em lote com retries | GPU spot ou interrompível | Descontos podem valer a pena se a lógica de retry for forte. |
| Base de inferência em produção | GPU reservada ou comprometida | Utilização estável pode justificar o compromisso. |
| Treinamento multi-node | Cluster dedicado ou capacidade reservada | Rede e posicionamento importam tanto quanto a taxa horária. |
| Recurso de IA de baixo volume | API de modelo por meio de um gateway | Evita capacidade ociosa de GPU e overhead operacional. |
| Workflow de agente multi-modelo | API de modelo por meio da Flatkey | Uma chave e um livro-razão podem superar operar muitos endpoints de GPU. |
Erros comuns de precificação no aluguel de GPU
| Erro | O que fazer em vez disso |
|---|---|
| Comparar apenas o preço horário listado da GPU | Compare o custo da carga de trabalho concluída após armazenamento, largura de banda, tempo ocioso e retries. |
| Tratar descontos de spot como economia garantida | Some o desperdício por interrupção e o overhead de checkpoints. |
| Reservar capacidade antes de medir a utilização | Rode on-demand por tempo suficiente para conhecer a demanda de base. |
| Ignorar a limpeza de armazenamento | Configure alertas para volumes não anexados, snapshots e checkpoints antigos. |
| Tratar RTX 4090, L40S, A100, H100 e H200 como intercambiáveis | Combine VRAM, desempenho de tensor, interconexão e stack de software com a carga de trabalho. |
| Esquecer a gravidade dos dados | Coloque conjuntos de dados, armazenamento de objetos e GPUs próximos uns dos outros. |
| Usar aluguel de GPU para todas as cargas de trabalho de IA | Compare com APIs de modelo quando o overhead operacional for dominante. |
FAQ
Qual é a melhor forma de comparar preços de aluguel de GPU?
A melhor forma de comparar preços de aluguel de GPU é calcular o custo por carga de trabalho concluída. Inclua a taxa horária da GPU, armazenamento, egress, tempo ocioso, novas tentativas, tarefas com falha, suporte e sobrecarga de engenharia. Uma taxa horária mais baixa pode sair perdendo se causar mais reinicializações ou tempo ocioso.
Os preços de aluguel de GPU da Vast.ai são mais baratos do que os dos provedores de nuvem?
Os preços de aluguel de GPU da Vast.ai podem ser mais baixos para algumas GPUs porque é um marketplace, mas a comparação depende da confiabilidade do host, da interrupção, do disco, da largura de banda, do nível de verificação e da tolerância da carga de trabalho. Trate cada anúncio como uma oferta específica, não como um preço universal.
Os preços de aluguel de GPU da RunPod são on-demand ou spot?
Os preços de aluguel de GPU da RunPod dependem do produto e do tipo de nuvem que você escolher. Compare separadamente Secure Cloud, Community Cloud, pods, endpoints serverless, armazenamento, volumes de rede e comportamento ocioso.
Quando devo usar capacidade de GPU reservada?
Use capacidade de GPU reservada quando a utilização for previsível, o tipo de GPU continuar útil durante o período do compromisso e a capacidade garantida for importante. Se sua utilização base for baixa, reserve apenas a base e faça o burst do restante por meio de on-demand ou spot.
Por que os preços de aluguel de GPU ao longo do tempo mudam tanto?
Os preços de aluguel de GPU ao longo do tempo mudam porque a oferta de hardware, a demanda por IA, a capacidade regional, a concorrência entre provedores e a eficiência de entrega mudam ao mesmo tempo. Acompanhe a família exata de GPU e a eficiência da sua carga de trabalho, não apenas as médias de mercado.
Quais custos ocultos mais importam em serviços de nuvem de GPU?
Os custos ocultos que mais importam são tempo ocioso, armazenamento persistente, snapshots, egress, inicializações a frio, novas tentativas, tarefas com falha, infraestrutura de rede, suporte e sobrecarga de engenharia. Equipes pequenas geralmente sentem primeiro o tempo ocioso e o armazenamento; equipes maiores geralmente sentem rede, suporte e capacidade reservada subutilizada.
Lista de verificação final
Antes de escolher um provedor de aluguel de GPU, confirme:
- O modelo da GPU, o tamanho da memória, a região e a unidade de cobrança estão registrados.
- O modo de precificação é on-demand, spot, reservado, serverless, marketplace ou dedicado.
- Armazenamento, largura de banda, snapshots e tempo ocioso estão incluídos.
- A interrupção spot e o desperdício por novas tentativas estão modelados.
- A capacidade reservada tem um ponto de equilíbrio de utilização.
- O URL de origem e a data da verificação estão anexados a cada preço.
- A decisão final é baseada no custo da carga de trabalho concluída, não apenas nos preços horários de aluguel de GPU.
Essa é a forma prática de avaliar preços de aluguel de GPU: páginas-fonte atuais, uma planilha moldada pela carga de trabalho e uma decisão clara sobre quando alugar hardware compensa a complexidade operacional.


