
GPUレンタル料金の解説:オンデマンド、スポット、予約、そして隠れたコスト
GPUレンタル料金は、実際の学習 रन、推論の本番展開、または画像生成バッチを見積もろうとするまでは単純に見えます。見出しの時間単価は、あくまで費目の一つにすぎません。最終的な請求額は、GPUがオンデマンドか、スポットか中断可能か、予約済みか、サーバーレスか、専有かにも左右されます。また、マシンがアイドルのままどれだけ置かれるか、ストレージがどこにあるか、どれだけのデータがリージョン外へ出るか、そしてチームがどれだけの信頼性向上作業を負担する必要があるかにも影響されます。
このガイドは、開発者、AI創業者、プラットフォームチーム、購買レビュー担当者が、魅力的な時間単価ひとつに惑わされずにGPUレンタル料金を実用的に比較するための方法を示します。
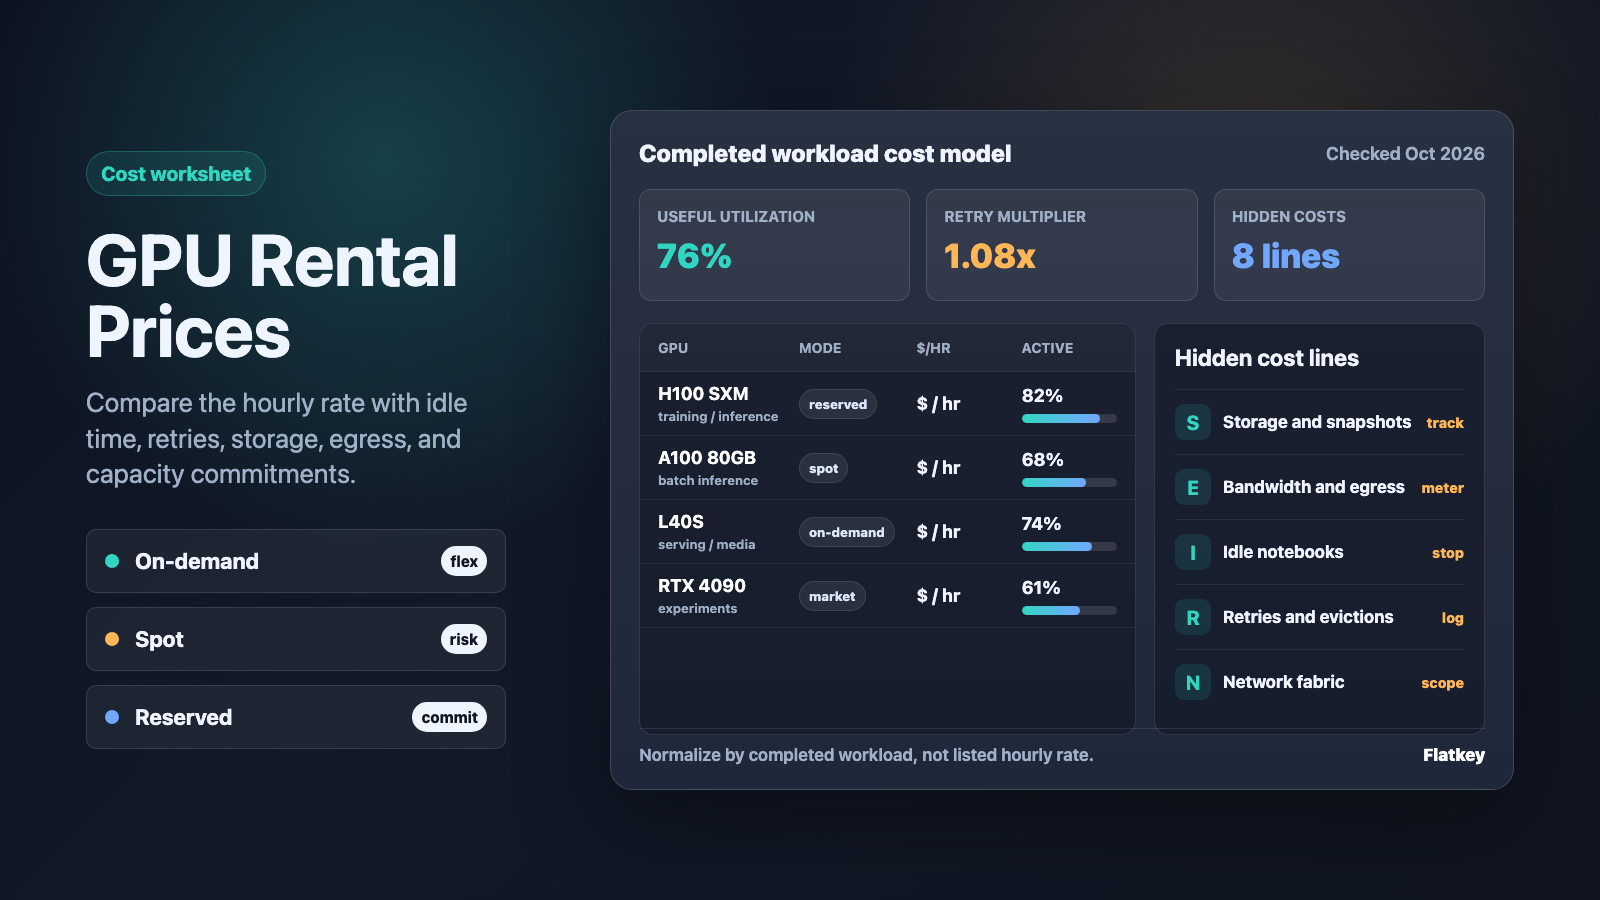
要するに、比較すべきなのは完了したワークロード時間あたりのコストであり、GPUの1時間あたり料金だけではありません。
GPUレンタル料金の簡易フレームワーク
GPUレンタル料金の比較は、毎回まず次の標準化された式から始めます。
完了したワークロード1件あたりの実効GPUコスト =
  (GPU計算 + ストレージ + スナップショット + 帯域幅 + アイドル時間 + リトライ + サポート + エンジニアリングオーバーヘッド)
  / 完了した学習、推論、バッチ、またはメディアジョブの単位数
次に、判断を4つの問いに分けます。
| 質問 | GPUレンタル料金が変わる理由 |
|---|---|
| どのGPUクラスが必要ですか? | H100、H200、B200、A100、L40S、RTX 4090、RTX 6000クラスのマシンでは、メモリ、ネットワーキング、供給、価格曲線が異なります。 |
| ワークロードの予測可能性はどの程度ですか? | 安定した本番推論なら予約済みまたは確約済みキャパシティが正当化されますが、実験や断続的なジョブはオンデマンドやスポットのほうが適することがよくあります。 |
| ジョブはどの程度中断可能ですか? | スポットやコミュニティのマーケットプレイス容量は安くなることがありますが、再試行とチェックポイント保存の有無が、本当に安いかどうかを決めます。 |
| GPU時間の外側に何がありますか? | ストレージ、スナップショット、エグレス、アイドル状態のノートブック、コンテナのプル、サポートプラン、クラスターネットワーキングが実コストを変えることがあります。 |
多くのチームにとって正しい答えは、「最も安いGPUを探す」ことではありません。正しい答えは、「許容できるキュー時間、再起動リスク、運用オーバーヘッドでジョブを完了できる、最も安価な信頼性の高いキャパシティを借りる」ことです。
現在の価格ソース表
GPUレンタル料金は頻繁に変動し、マーケットプレイスのページは購買レビューよりも速く更新されることがあります。以下の表は固定レートカードではなく、ソース確認用のチェックリストとして扱ってください。確認日、GPUモデル、リージョン、メモリ容量、課金単位、そして価格がオンデマンド、スポット、予約、コミュニティ、セキュアクラウド、サーバーレス、または専有のいずれかを記録します。
| プロバイダーまたは市場 | 確認すべき公式価格ソース | 記録する内容 | 比較時の注意点 |
|---|---|---|---|
| Vast.ai | Vast.ai pricing と Vast.ai FAQ | GPUモデル、ホストの信頼性、中断可能状態、ストレージ、帯域幅、検証ティア、データセンターまたはコミュニティホスト | Vast.ai のGPUレンタル料金はマーケットプレイス主導のため、同じRTX 4090やH100のオファーでも、場所、ホスト、信頼性、ストレージ、ネットワークで異なる場合があります。 |
| RunPod | RunPod pricing と RunPod storage and network volume docs | Secure Cloud と Community Cloud、GPUモデル、podストレージ、ネットワークボリューム、サーバーレスワーカー料金、アイドル時間 | RunPod のGPUレンタル料金は、クラウド種別と製品モードによって異なります。pod、サーバーレス、ストレージを個別に比較してください。 |
| Massed Compute | Massed Compute pricing | オンデマンドの時間単価GPU料金、長期予約またはクラスタ見積もり、GPUメモリ、リージョン、サポート範囲 | Massed Compute のGPUレンタル料金は、専用AIクラウド容量のベンチマークに有用ですが、プライベートまたは予約済みクラスタでは見積もりが必要になることがあります。 |
| Lambda Cloud | Lambda Cloud pricing | オンデマンドGPUインスタンス、GPU数、ローカルストレージ、リージョン可用性、予約済みクラスタの条件 | Lambda は一般的なNVIDIAインスタンス向けにシンプルな時間単価のGPUクラウド料金を公開しています。時間に敏感な実行を計画する前に、現在の可用性を確認してください。 |
| AWS EC2 | Amazon EC2 pricing と EC2 Spot Instances | インスタンスファミリー、リージョン、オンデマンド、スポット、Savings Plans、Reserved Instances、EBS、データ転送、サポート | AWSはオンデマンド、スポット、確約利用の経済性における参照モデルとして扱われることが多いですが、GPUインスタンスファミリーとリージョン可用性が重要です。 |
| Google Cloud | Compute Engine GPU pricing と Spot VMs | GPUタイプ、マシンファミリー、リージョン、Spot VMステータス、確約利用割引、永続ディスク、ネットワークエグレス | Google Cloud はGPU、マシン、ディスク、ネットワーク、割引の仕組みを分けています。専門GPUクラウドと比較する前に、それらすべてを正規化してください。 |
各ソース行に1行追加してください: checked on October 12, 2026. このワークシートを後で再利用する場合は、数値を再利用する前に確認日を更新してください。
オンデマンドGPUレンタル料金
オンデマンドのGPUレンタル料金は、最も分かりやすい出発点です。インスタンス、ポッド、またはサーバーが稼働している間のGPU क्षमताに対して支払い、通常は長期契約の拘束はありません。ほとんどのチームが最初のベンチマークでこのモードを使うべきなのは、エンジニアリング変数をシンプルに保てるからです。
次のような場合、通常はオンデマンドが適切なデフォルトです。
- 新しいモデル、フレームワーク、データセット、またはプロンプトパイプラインをテストしている。
- ジョブが緊急で、スポット容量を待てない。
- デモ、QA、または初期の顧客トラフィック向けに安定したエンドポイントが必要である。
- まだ利用率を十分に把握していないため、容量を予約できない。
- 最安の時間単価よりも、ベンダーのサポートと予測可能なネットワークが必要である。
リスクはアイドル時間です。1時間あたりの単価が低いGPUノートブックでも、仕事が付かないまま週末ずっと稼働していれば高くつくことがあります。オンデマンドでは、課金対象の稼働時間と有効な計算時間を比較してください。
on-demand waste rate =
  1 - useful GPU-active minutes / billable instance minutes
無駄率が高い場合、最初にGPU料金を交渉してはいけません。シャットダウン自動化、キューのスケジューリング、自動スケーリング、ジョブの詰め込みを改善してください。
スポット、インタラプタブル、そしてマーケットプレイスのGPU価格
スポットのGPU料金は未使用容量を活用するため、オンデマンドと比べて大幅な割引を提供できることがありますが、容量は消える可能性があります。AWSはEC2 Spot Instancesを、On-Demand料金と比べて最大90%割引で利用できる予備のEC2容量と説明しています。Google Cloud Spot VMsも割引がありますが、事前に停止される可能性があります。Vast.aiのようなコミュニティマーケットプレイスは別のバリエーションを追加します。価格はホスト側の需給で決まり、信頼性の特性は大規模クラウドのオンデマンドインスタンスとは同じではありません。
次のような場合、スポットまたはインタラプタブルのGPUレンタル料金が有利になることがあります。
- トレーニングジョブが頻繁にチェックポイントを保存する。
- バッチ推論が、ユーザーに見える失敗なしで再試行できる。
- 画像または動画生成のキューが遅延を許容できる。
- 作業を多くのワーカーに分散できる。
- 退避を検知し、ジョブを再起動し、重複課金を避けるオーケストレーションがある。
次のような場合、スポットは不利になることがあります。
- 複数日にわたる単一のトレーニング実行が、古いチェックポイントからやり直しになる。
- データ読み込みに時間がかかり、各中断で数時間が無駄になる。
- モデルがマルチノードネットワークを必要とし、1台のワーカー喪失でジョブが失敗する。
- 再試行とチェックポイントのロジックを維持するために、エンジニアが数日を費やす。
- 自分で制御できない容量で、顧客向けのレイテンシを約束している。
スポットでは、再起動による無駄を含めて実効レートを計算します。
spot effective hourly rate =
  spot hourly rate / (1 - interruption waste share)
スポットのH100が45%安くても、中断によって経過ジョブ時間の35%が無駄になるなら、実際の優位性は見出しの割引よりかなり小さくなります。
予約済み、コミット型、専用のGPU容量
予約済み容量は、柔軟性と引き換えに予測可能性を得るものです。期間、支出額、または専用クラスターにコミットすることで、プロバイダーはハードウェアを割り当てやすくなり、あなたは実効時間単価を下げるか、希少なGPUを確保できます。
次のような場合、予約済みGPUレンタル料金が適しています。
- 本番推論のベースライン利用率が安定している。
- トレーニングスケジュールが数か月先まで予測できる。
- 調達部門が既知の月次予算を必要としている。
- ローンチ期間に保証された容量が必要である。
- マルチノードネットワーク、ストレージの局所性、サポートが要件の一部である。
次のような場合、予約済み容量は裏目に出ることがあります。
- 契約期間が終わる前にモデル選定が変わる。
- 需要がスパイク型で、ベースライン利用率が低いまま。
- より新しいGPUクラスが、価格性能曲線を変える。
- 契約に、実際に必要なストレージ、サポート、またはネットワーク階層が含まれていない。
予約する前に、損益分岐点となる利用率を計算してください。
reserved break-even utilization =
  reserved monthly cost / (on-demand hourly rate * hours in month)
損益分岐点が58%の利用率で、実際のベースラインが30%なら、予約する容量を減らし、残りはオンデマンドまたはスポットでバーストさせてください。
Vast.aiのGPUレンタル料金
人々がVast.aiのGPUレンタル料金を検索するのは、Vastが単一の固定クラウド料金表ではなくマーケットプレイスだからです。それが魅力であり、リスクでもあります。攻めたRTX 4090、A100、H100のオファーが見つかるかもしれませんが、各掲載情報には品質チェックが必要です。
Vast.aiのGPUレンタル料金を比較する際は、次を確認してください。
- GPUモデルとVRAM。
- マシン内のGPU枚数。
- ホストの信頼性と検証ステータス。
- データセンターかコミュニティホストかという文脈。
- インタラプタブルか非インタラプタブルかの状態。
- ローカルディスク容量とディスク帯域幅。
- アップロード/ダウンロード帯域幅とパブリックIPの必要性。
- コンテナイメージの起動時間。
- ジョブをチェックポイント保存して再開できるか。
vast.ai gpu rental prices rtx 4090 については、RTX 4090の時間単価だけを比較してはいけません。VRAM、ホスト履歴、ディスク容量、ストレージコスト、そしてジョブがトレーニング、推論、ComfyUI、データラベリング、単発の実験のどれかも比較してください。非常に安いRTX 4090は、短い実験には適切でも、本番推論には不適切な場合があります。
RunPodのGPUレンタル料金
RunPodのGPUレンタル料金は、製品モードごとに分けて考える必要があります。RunPodのpodはサーバーレスエンドポイントと同じ経済単位ではなく、Secure CloudはCommunity Cloudとは異なるリスクプロファイルを持ちます。
RunPodのGPUレンタル料金を比較する際は、次を確認してください。
- Secure Cloud または Community Cloud。
- Pod の GPU 時間単価。
- pod ではなく endpoint を使用する場合の serverless worker 料金。
- 永続ボリュームおよびネットワークボリュームのコスト。
- コールドスタートの挙動と最小 worker 数。
- アイドル中の pod の挙動。
- データのローカリティと、ワークロードが大規模モデルを繰り返し取得するかどうか。
RunPod は、完全なクラスタを運用せずに高速な GPU アクセスを求める AI アプリチームにとって、費用対効果の高い選択肢になり得ます。隠れたコストのチェックポイントは、起動とストレージです。各 worker が大容量の重みを繰り返しダウンロードしたり、実験後もボリュームを接続したままにしたりすると、GPU の時間単価だけでは請求額を過小評価してしまいます。
Massed Compute の GPU レンタル料金
Massed Compute の GPU レンタル料金は、特に対象が単一の開発用 pod ではなく専用の AI 容量に及ぶようになった場合に、特化型 GPU クラウドプロバイダーを比較する買い手にとって有用な参考値です。簡単な検証では、公開されている時間単価を比較します。本番推論やマルチノード学習では、クラスタ価格に何が含まれているかを確認してください。
確認項目:
- GPU モデルとメモリ。
- 時間単位のオンデマンド価格と予約見積もりの比較。
- 最低コミット期間。
- ネットワークファブリック。
- ストレージ階層。
- サポートと SLA の条件。
- リージョンおよびコンプライアンス要件。
- 見積もりにセットアップ、移行、またはマネージドサービスが含まれるかどうか。
ここでは調達用語が重要になります。「予約済み GPU クラスタ」は、割引料金、保証されたハードウェア、プライベートネットワーク、サポートアクセス、あるいはそのすべてを意味する場合があります。各項目を個別に確認してください。
GPU レンタル料金の推移
GPU レンタル料金は一直線には変動しません。通常、3 つの要因が異なる方向に働きます。
| 要因 | 価格への影響 |
|---|---|
| 新しいハードウェアの供給 | H200、B200、B300、またはそれ以降の世代が利用可能になると、旧世代 GPU は安くなることがあります。 |
| AI 需要の急増 | モデル公開、学習、推論需要の急増時には、H100/H200 クラスの容量が高止まりしたり、希少になったりすることがあります。 |
| 効率向上 | 量子化、バッチ処理、サービングエンジン、モデルルーティングの改善により、時間単価が横ばいでもタスクあたりのコストは下げられます。 |
「GPU 価格は下がっている」あるいは「GPU 価格は上がっている」といった単純な見方に頼らないでください。利用している正確な GPU ファミリ、リージョン、契約条件、そしてワークロード効率を追跡しましょう。時間単価の GPU レンタル料金が変わらなくても、トークン、画像、ファインチューニング、学習サンプルあたりのコストは改善し得ます。
クラウド GPU レンタルにおける隠れたコスト
隠れたコストは、必ずしも悪意があるものではありません。GPU ワークロードが大きなファイルを移動させ、デバッグ中にアイドル状態になることで大きくなる、通常のクラウド要素であることが多いです。
| 隠れたコスト | どのように現れるか | 抑える方法 |
|---|---|---|
| アイドル時間 | アクティブなジョブがないまま動作する pod、ノートブック、インスタンス | アイドル状態のリソースを自動停止する。実験にタグを付ける。長時間稼働する GPU にアラートを出す。 |
| 永続ストレージ | ボリューム、ディスク、スナップショット、モデルキャッシュ、データセット | 再利用可能なモデル重みと一時的な出力を分ける。放置されたボリュームをクリーンアップする。 |
| ネットワーク転送料 | リージョン間やインターネット外部へのデータセット、チェックポイント、出力、モデルアーティファクトの移動 | 可能であれば、データ、GPU、オブジェクトストレージを同じリージョンに置く。 |
| コールドスタート | 有用な処理が始まる前にコンテナとモデル重みを取得すること | イメージを事前ビルドする。ローカルキャッシュを使う。起動時間を課金対象時間として測定する。 |
| リトライと失敗したジョブ | メモリ不足による失敗、退避、壊れたドライバー、不安定なホスト | 小さなカナリアテストを実行する。チェックポイントを保存する。正常動作が確認されたイメージを固定する。失敗コストを記録する。 |
| マルチノードネットワーキング | InfiniBand、RoCE、配置、またはクラスタファブリックの追加料金 | 分散学習が本当に必要な場合にのみ予約する。 |
| サポートとコンプライアンス | 有償サポートプラン、プライベートクラスタ、監査要件、マネージドサービス | どのワークロードにエンタープライズ条件が必要か、どれを実験用のままにできるかを決める。 |
| エンジニアリングのオーバーヘッド | スクリプト、スケジューラ、クラウド固有のセットアップの維持に費やす時間 | セットアップとインシデント対応の時間を TCO シートに含める。 |
GPU レンタル料金では、ストレージとアイドル時間が小規模チームを最も驚かせやすい 2 つの隠れたコストです。より大規模なチームでは、サポート、ネットワーキング、十分に活用されていない予約済み容量のほうが、通常は大きな予算リスクになります。
GPU レンタル料金ワークシート
プロバイダーを承認する前、クラスタを予約する前、またはワークロードを移行する前に、このワークシートを使用してください。
| 項目 | 例 | 重要な理由 |
|---|---|---|
| Provider | RunPod, Vast.ai, Massed Compute, AWS, Google Cloud, Lambda | マーケットプレイス、専門クラウド、ハイパースケーラーの経済性を分けて考えられるようにするため。 |
| Product mode | On-demand pod, spot instance, reserved cluster, serverless endpoint | 課金単位と信頼性の特性はモードによって変わる。 |
| GPU model | H100 SXM, H100 PCIe, A100 80GB, L40S, RTX 4090 | メモリと相互接続は、ブランド名よりも重要なことが多い。 |
| Region or host | US-East, EU, community host, datacenter host | 可用性、データ規則、レイテンシ、帯域幅は場所によって異なる。 |
| Hourly GPU price | $x.xx/hour |
あくまで出発点。 |
| Minimum billing unit | second, minute, hour, month | 短いジョブは端数処理やコールドスタートの影響を受けやすい。 |
| Storage cost | volume, disk, snapshot, object storage | モデルの重みやチェックポイントは、継続的な月額コストになり得る。 |
| Bandwidth or egress | inbound, outbound, public IP, cross-region | 大規模データセットや生成メディアは総コストを変える。 |
| Idle percentage | 22% |
無駄になったレンタル時間を直接示す指標。 |
| Failure/retry rate | 1.08x |
強制終了、OOM、不良イメージ、再起動を織り込む。 |
| Useful output unit | trained epoch, accepted image, 1M tokens, completed job | 時間単価をビジネス価値に変換する。 |
| Support and operations | self-managed, managed, SLA, private cluster | 調達コストと信頼性コストは同じモデルに含めるべき。 |
ワークロードをAPI経由で提供した後の、より深いモデルレベルのコストワークシートについては、AI model pricing comparison と how to compare AI model prices を比較してください。
モデルAPIがGPUレンタルより安い場合
GPUをレンタルすることが、モデルAPIを使うより自動的に安いわけではありません。GPUレンタルが有利なのは、利用率が高い、モデルの所有要件が明確、推論スタックを独自構成したい、プライバシー制約がある、あるいはAPIに委ねられない学習ワークロードがある場合です。
モデルAPIの方が安くなるのは、次のような場合です。
- 利用率が低い、またはスパikyである。
- チームが頻繁にモデルを変更する。
- 信頼性、スケーリング、アップグレードが製品開発の妨げになる。
- ワークロードが1つの自前ホストモデルではなく、多数のモデルファミリーを必要とする。
- Financeがクラスター運用プロジェクトよりも、利用台帳を必要としている。
Flatkeyは、その意思決定のAPI側に位置します。1つのAPIキー、1つの残高、1つの請求書、そして多くの公式モデルとツールにまたがる利用台帳をチームに提供します。ワークシート上で、自前運用のGPUがまだ本当のボトルネックではないと示されるなら、まずはマルチプロバイダーAPIから始め、クラスター運用に踏み切る前に受理された結果あたりのコストを比較してください。APIガバナンス層については、AI gateway pricing、AI API spend management、AI API quota controls を参照してください。
判断ガイド:オンデマンド、スポット、予約、それともAPI
| ワークロード | より適した出発点 | 理由 |
|---|---|---|
| 最初のモデルベンチマーク | オンデマンドGPU | 最もクリーンな測定ができ、中断要因が少ない。 |
| 単発のComfyUIまたは画像ワークフロー | オンデマンドまたはマーケットプレイスGPU | セットアップが速い。RTX 4090クラスの容量で十分な場合もある。 |
| 再試行ありのバッチ推論 | スポットまたは中断可能GPU | 再試行ロジックが強ければ割引が効く。 |
| 本番推論のベースライン | 予約済みまたはコミット済みGPU | 安定した利用率ならコミットを正当化できる。 |
| マルチノード学習 | 専用クラスターまたは予約容量 | ネットワークと配置は、時間単価と同じくらい重要。 |
| 低ボリュームのAI機能 | ゲートウェイ経由のモデルAPI | アイドルGPU容量と運用オーバーヘッドを回避できる。 |
| マルチモデルのエージェントワークフロー | Flatkey経由のモデルAPI | 1つのキーと台帳で、多数のGPUエンドポイントを運用するより有利な場合がある。 |
よくあるGPUレンタル料金のミス
| ミス | 代わりに行うこと |
|---|---|
| 記載された時間単価のGPU価格だけを比較する | ストレージ、帯域幅、アイドル時間、再試行を含めた完了ワークロードのコストを比較する。 |
| スポット割引を保証された節約とみなす | 中断による無駄とチェックポイントのオーバーヘッドを加える。 |
| 利用率を測る前に容量を予約する | ベースライン需要が分かるまでオンデマンドで十分に運用する。 |
| ストレージのクリーンアップを無視する | 未接続のボリューム、スナップショット、古いチェックポイントをアラートする。 |
| RTX 4090、L40S、A100、H100、H200を、まるで互換性があるかのように混同する | VRAM、Tensor性能、相互接続、ソフトウェアスタックをワークロードに合わせる。 |
| データ重力を忘れる | データセット、オブジェクトストレージ、GPUを互いに近い場所に置く。 |
| すべてのAIワークロードにGPUレンタルを使う | 運用オーバーヘッドが大きい場合は、モデルAPIと比較する。 |
FAQ
GPUレンタル料金を比較する最善の方法は何ですか?
GPUレンタル料金を比較する最善の方法は、完了したワークロードあたりのコストを算出することです。GPUの時間単価、ストレージ、egress、アイドル時間、再試行、失敗ジョブ、サポート、エンジニアリングのオーバーヘッドを含めてください。時間単価が低くても、再起動やアイドル時間が増えるなら不利になることがあります。
Vast.ai の GPUレンタル料金はクラウドプロバイダーより安いですか?
Vast.ai の GPUレンタル料金はマーケットプレイスであるため、一部のGPUではより安くなることがありますが、比較はホストの信頼性、割り込み可能性、ディスク、帯域幅、検証ティア、ワークロードの許容度に左右されます。各掲載情報は普遍的な価格ではなく、個別のオファーとして扱ってください。
RunPod の GPUレンタル料金はオンデマンドですか、それともスポットですか?
RunPod の GPUレンタル料金は、選択する製品とクラウドタイプによって異なります。Secure Cloud、Community Cloud、pods、serverless endpoints、ストレージ、ネットワークボリューム、アイドル時の挙動をそれぞれ個別に比較してください。
予約済みGPUキャパシティはいつ使うべきですか?
利用率が予測可能で、GPUの種類が契約期間中も有用であり、容量保証が重要な場合は、予約済みGPUキャパシティを使ってください。ベースラインの利用率が低いなら、ベースライン分だけを予約し、残りはオンデマンドまたはスポットで補完します。
なぜGPUレンタル料金は時間とともにこれほど変動するのですか?
GPUレンタル料金が時間とともに大きく変わるのは、ハードウェア供給、AI需要、地域ごとの容量、プロバイダー間の競争、提供効率がすべて同時に動くためです。市場平均だけでなく、正確なGPUファミリーと自分のワークロード効率を追跡してください。
GPUクラウドサービスで最も重要な隠れたコストは何ですか?
最も重要な隠れたコストは、アイドル時間、永続ストレージ、スナップショット、egress、コールドスタート、再試行、失敗ジョブ、ネットワーク基盤、サポート、エンジニアリングのオーバーヘッドです。小規模チームでは通常、まずアイドル時間とストレージの影響が大きくなり、大規模チームでは通常、ネットワーキング、サポート、十分に活用されていない予約容量の影響が大きくなります。
最終チェックリスト
GPUレンタルプロバイダーを選ぶ前に、次を確認してください:
- GPUモデル、メモリサイズ、リージョン、課金単位が記録されている。
- 料金体系がオンデマンド、スポット、予約、サーバーレス、マーケットプレイス、または専有のいずれかである。
- ストレージ、帯域幅、スナップショット、アイドル時間が含まれている。
- スポットの中断と再試行による無駄がモデル化されている。
- 予約容量に利用率の損益分岐点がある。
- 各価格にソースURLと確認日が付いている。
- 最終判断が、時間単価のGPUレンタル料金だけでなく、完了したワークロードあたりのコストに基づいている。
これがGPUレンタル料金を評価する実践的な方法です。最新のソースページ、ワークロードに合わせたワークシート、そしてハードウェアを借りる価値が運用の複雑さに見合うタイミングを明確に判断することです。


