
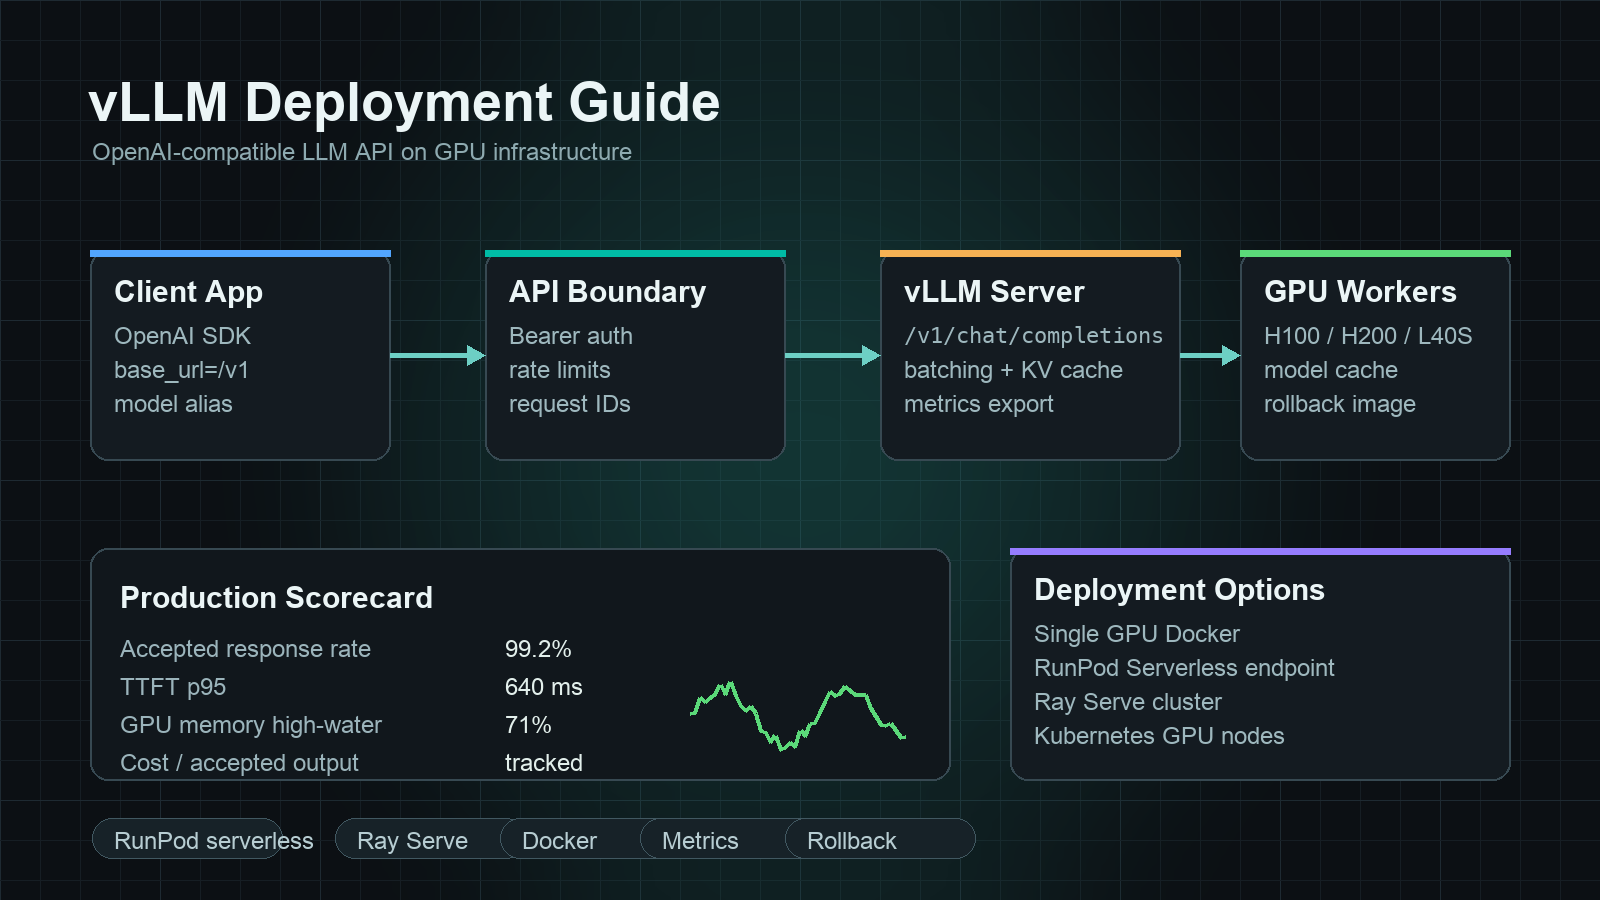
Ein vLLM-Deployment-Guide sollte eine praktische Frage beantworten: Wie verwandeln Sie GPU-Kapazität in eine OpenAI-kompatible LLM-API, die Anwendungsteams aufrufen, beobachten, zurückrollen und mit verwalteten Modell-APIs vergleichen können?
Die kurze Antwort lautet: Beginnen Sie mit einem Modell, einer GPU-Konfiguration, einer OpenAI-kompatiblen Route und einem Messplan. vLLM kann vertraute /v1/models, /v1/chat/completions und verwandte OpenAI-ähnliche Endpunkte bereitstellen, aber ein produktiver Betrieb ist mehr als der erste vllm serve-Befehl. Sie benötigen ein Container-Image, einen Modell-Cache, eine Authentifizierungsgrenze, Health Checks, Metriken, Request-Limits, einen Lasttest und eine Scorecard für Kosten pro akzeptierter Ausgabe.
Dieser vLLM-Deployment-Guide zeigt KI-Entwicklern und Plattformteams einen Bereitstellungspfad von einem einzelnen GPU-Server zu RunPod Serverless, Ray Serve und produktionsnahen Kubernetes-Mustern. Er erklärt auch, wann eine Modell-API oder ein Router wie Flatkey einfacher sein kann als der Betrieb der GPU-Serving-Schicht selbst.
Schneller vLLM-Deployment-Guide
Nutzen Sie diese Reihenfolge, bevor Sie die Orchestrierung komplexer machen.
| Schritt | Entscheidung | Praktischer Standard |
|---|---|---|
| 1. Modell auswählen | Wählen Sie ein unterstütztes Modell und eine exakte Revision | Beginnen Sie mit dem kleinsten Modell, das den API-Vertrag bestätigt, und skalieren Sie dann nach oben |
| 2. GPU auswählen | Bestätigen Sie die Speichereignung vor dem Tuning des Durchsatzes | Verwenden Sie in Tests und Produktion dieselbe GPU-Klasse |
| 3. vLLM starten | Stellen Sie eine OpenAI-kompatible API bereit | Verwenden Sie zuerst vllm serve, dann containerisieren Sie |
| 4. Request-Limits festlegen | Begrenzen Sie Kontextlänge, Parallelität und Ausgabelänge | Schützen Sie die GPU vor unbegrenzten Prompts |
| 5. Authentifizierung und Netzwerksteuerung hinzufügen | Exponieren Sie keinen rohen GPU-Worker direkt | Setzen Sie ein Gateway, Ingress oder privaten Endpunkt davor |
| 6. Akzeptierte Ausgabe messen | Verfolgen Sie erfolgreiche Antworten, Latenz, Retries und Kosten | Vergleichen Sie mit den Kosten der Modell-API pro akzeptierter Ausgabe |
| 7. Rollout-Mechanik hinzufügen | Canary, Rollback und versionierte Modell-Aliase | Halten Sie den Client-Code stabil, während sich das Serving ändert |
Das Ziel ist nicht, jede Workload selbst zu hosten. Das Ziel ist zu wissen, wann selbst gehostetes vLLM den betrieblichen Aufwand wert ist.
Was vLLM Ihnen bietet
vLLM ist eine Open-Source-Engine für Inferenz und Serving großer Sprachmodelle. Die Dokumentation behandelt OpenAI-kompatibles Serving, Docker-Bereitstellung, Metriken, Prefix-Caching, Quantisierung, speculative decoding, Parallelisierung und unterstützte Modellarchitekturen. Diese Bausteine machen vLLM zu einem starken Standard, wenn Sie Open-Weight-Modelle hinter einem vertrauten API-Vertrag bereitstellen möchten.
Die nützliche Produktionseigenschaft ist die API-Grenze. Wenn Ihre Anwendung bereits einen OpenAI-kompatiblen Client aufruft, kann ein vLLM-Endpunkt den Aufwand für eine App-Umschreibung reduzieren. Die Serving-Schicht kann sich ändern, die Modellgewichte können sich ändern, und der GPU-Host kann wechseln, während der Client-Code weiterhin Chat-Completions-Anfragen an eine einzige Basis-URL sendet.
Das nimmt die Plattformarbeit nicht weg. Es verlagert die harte Arbeit von der App-Integration auf den Inferenzbetrieb: GPU-Zuweisung, Modellladen, Batching, Observability, Rate Limits, Incident Response und Kostenmanagement.
Single-GPU-vLLM-Bereitstellung
Beginnen Sie lokal oder auf einer einzelnen Cloud-GPU, bevor Sie Serverless, Ray oder Kubernetes hinzufügen.
pip install vllm

vllm serve meta-llama/Llama-3.1-8B-Instruct \
  --host 0.0.0.0 \
  --port 8000
Testen Sie dann den OpenAI-kompatiblen Endpunkt.
curl http://localhost:8000/v1/models
Verwenden Sie eine Chat-Anfrage, die so aussieht wie die Anfrage, die Ihre Anwendung tatsächlich senden wird.
curl http://localhost:8000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "meta-llama/Llama-3.1-8B-Instruct",
    "messages": [
      {"role": "user", "content": "Write a three-bullet deployment checklist."}
    ],
    "temperature": 0.2,
    "max_tokens": 300
  }'
Diese erste Bereitstellung ist nicht produktiv. Sie beantwortet vier Fragen:
- Lädt das Modell auf der ausgewählten GPU?
- Versteht Ihr Client die Antwortstruktur?
- Funktionieren Streaming, Tool-Aufrufe oder strukturierte Ausgabe für Ihre konkrete Anfrage?
- Wie sehen die groben Werte für Time-to-first-token und End-to-End-Latenz aus?
Halten Sie den ersten Test einfach. Optimieren Sie Batching, Quantisierung oder Parallelisierung nicht, bevor der Basis-Endpunkt funktioniert.
Docker-Bereitstellung für einen reproduzierbaren GPU-Server
Für einen reproduzierbaren Server verwenden Sie den offiziellen vLLM-Docker-Pfad oder ein fest gepinntes Container-Image in Ihrer eigenen Registry. Die wichtigen Produktionskontrollen sind nicht nur das Image-Tag. Sie betreffen auch den Treiber-Stack, CUDA-Kompatibilität, Modell-Cache, Volume-Mount, Netzwerk-Port und Prozess-Flags.
Beispielaufbau:
docker run --gpus all \
  -p 8000:8000 \
  -v ~/.cache/huggingface:/root/.cache/huggingface \
  --env HUGGING_FACE_HUB_TOKEN=$HUGGING_FACE_HUB_TOKEN \
  vllm/vllm-openai:latest \
  --model meta-llama/Llama-3.1-8B-Instruct \
  --host 0.0.0.0 \
  --port 8000
Bevor Sie dieses Muster in der Produktion verwenden, pinnen Sie die Versionen:
- vLLM-Image-Tag.
- NVIDIA-Treiber und Container-Runtime.
- CUDA-Stack, falls separat verwaltet.
- Modellrevision oder Commit-Hash.
- Verhalten von Tokenizer und Chat-Template.
- Quantisierungsmodus, falls verwendet.
Ein vLLM-Deployment-Guide ist unvollständig, wenn er nur sagt: „Docker ausführen“. Das Runbook muss auch das Neustartverhalten, Logging, das Vorwärmen des Modell-Caches, Readiness-Probes und einen Rollback-Pfad zur vorherigen Image- und Modellrevision enthalten.
Machen Sie den Endpoint OpenAI-kompatibel, aber nicht unauthentifiziert
vLLM kann eine OpenAI-kompatible API sprechen, aber Ihr nackter vLLM-Worker sollte normalerweise nicht die Grenze zum öffentlichen Internet sein. Setzen Sie etwas davor:
- Ein privater VPC-Endpoint für interne Dienste.
- Ein API-Gateway mit Bearer-Token-Validierung.
- Ein Service Mesh oder Ingress-Controller mit mTLS.
- Ein schlanker Proxy auf Anwendungsebene, der Modell-Aliasse, Request-IDs und Budgets pro Team durchsetzt.
- Eine Router-Schicht, wenn Sie auf verwaltete Modell-APIs ausweichen müssen.
Verwenden Sie umgebungsspezifische Basis-URLs:
VLLM_BASE_URL_DEV=http://localhost:8000/v1
VLLM_BASE_URL_STAGING=https://staging-inference.example.com/v1
VLLM_BASE_URL_PROD=https://inference.example.com/v1
Halten Sie dann den Anwendung-Client reversibel:
from openai import OpenAI

client = OpenAI(
    api_key="not-used-by-raw-vllm",
    base_url="https://inference.example.com/v1",
)

response = client.chat.completions.create(
    model="llama-3-1-8b-instruct",
    messages=[{"role": "user", "content": "Fassen Sie den Bereitstellungsplan zusammen."}],
)
Wenn Sie später einige Anfragen an Flatkeys OpenAI-kompatible Modell-API-Schicht weiterleiten, bleibt dasselbe Client-Muster nützlich: Ändern Sie die Basis-URL, den API-Schlüssel und den Modell-Alias, während Sie den Anwendungskontrakt stabil halten.
Produktions-Einstellungen, die vor dem Traffic festzulegen sind
Die Deployment-Flags hängen von Modell, GPU und Workload ab, aber jedes Team sollte diese Steuerungen vor Produktions-Traffic festlegen:
| Steuerung | Warum sie wichtig ist |
|---|---|
| Maximale Modelllänge | Verhindert, dass einige lange Prompts den gesamten KV-Cache-Speicher belegen |
| Maximale Ausgabe-Token | Verhindert, dass ausufernde Generierungen die Dekodierkapazität blockieren |
| Parallelitätslimit | Schützt p95- und p99-Latenz bei Traffic-Spitzen |
| Request-Timeout | Verhindert, dass hängende Anfragen eine Überlastung verbergen |
| Queue-Policy | Legt fest, ob überschüssige Nachfrage wartet, schnell fehlschlägt oder auf Fallback geht |
| Modell-Alias | Ermöglicht Clients, einen stabilen Namen zu verwenden, während sich die ausgelieferte Revision ändert |
| Authentifizierungsgrenze | Verhindert, dass ein teurer GPU-Endpoint zu einem offenen Proxy wird |
| Logging-Policy | Balanciert Debugging mit Anforderungen an Datenspeicherung und Datenschutz |
| Metriken-Export | Macht Latenz, Fehler, Cache-Verhalten und Durchsatz beobachtbar |
Kopieren Sie nicht die Flags eines anderen Teams. Kopieren Sie deren Messmethode.
Metriken für vLLM-Produktions-Deployments
Verfolgen Sie Metriken auf drei Ebenen.
| Ebene | Zu verfolgende Metriken |
|---|---|
| API-Ebene | Anzahl der Requests, Rate akzeptierter Antworten, 4xx/5xx-Rate, Timeout-Rate, Retry-Rate |
| Serving-Ebene | Zeit bis zum ersten Token, Inter-Token-Latenz, End-to-End-Latenz, Queue-Wartezeit, Token pro Sekunde |
| GPU-Ebene | GPU-Auslastung, Speicherauslastung, OOM-Ereignisse, Modell-Ladezeit, Neustartanzahl |
Fügen Sie dann die Finanzkennzahl hinzu:
Kosten pro akzeptierter Ausgabe =
  (GPU-Miete + Speicher + Bandbreite + Retries + Operatorzeit)
  / akzeptierte Antworten, die Qualitätsprüfungen bestehen
Damit bleibt der vLLM-Deployment-Guide an die Produktionseconomics gekoppelt. Ein schnellerer Endpoint ist nicht günstiger, wenn er häufiger fehlschlägt, mehr manuelle Eingriffe benötigt oder den Großteil des Tages untätig bleibt.
Für einen breiteren Kostenkontext vergleichen Sie Ihren gemessenen Endpoint mit GPU-Mietpreisen, der besten GPU für LLM-Inferenz, GPU-Cloud vs. Modell-API und GPU-Cluster-TCO.
RunPod-Serverless-vLLM-Deployment-Guide
Ein RunPod-Serverless-vLLM-Deployment-Guide hat ein anderes Betriebsmodell als eine lang laufende GPU-VM. Sie paketieren einen Handler oder Container, definieren den serverlosen Endpoint und lassen die Plattform Worker rund um die Anfragen skalieren. Das kann nützlich sein, wenn der Traffic sprunghaft ist oder wenn Sie eine verwaltete GPU-Ausführungsumgebung möchten, ohne jedes Detail des VM-Lebenszyklus selbst zu verwalten.
Verwenden Sie RunPod Serverless, wenn:
- Sie GPU-Ausführung im Endpoint-Stil wollen, ohne persistente Hosts zu verwalten.
- Der Traffic so stark schwankt, dass dauerhaft aktive GPU-Kapazität weitgehend untätig wäre.
- Kaltstart- und Modellladeverhalten für den Workload akzeptabel sind.
- Ihre App das asynchrone oder endpoint-spezifische Request-Muster der Plattform tolerieren kann.
- Sie Parallelität, Queueing und Timeout-Verhalten vor dem Start testen können.
Seien Sie bei latenzsensitiven Chats mit Serverless vorsichtig. Große Modelle können ein erhebliches Kaltstart- und Ladezeitverhalten haben. Messen Sie die Latenz bis zum ersten Token nach Leerlaufphasen, nicht nur in einem warmen Benchmark.
Für einen RunPod-Serverless-Endpoint-vLLM-Deployment-Guide sollte Ihr Abnahmetest Folgendes umfassen:
| Prüfung | Warum das wichtig ist |
|---|---|
| Pull-Zeit des Container-Images | Große Images können Cold Starts dominieren |
| Download der Modellgewichte oder Volume-Mount | Wiederholte Downloads können die Einsparungen durch Serverless zunichtemachen |
| Maximale Worker-Anzahl | Verhindert überraschende Kosten während Lastspitzen |
| Queue-Timeout | Definiert das aus Nutzersicht sichtbare Fehlverhalten |
| Warm-Worker-Richtlinie | Verändert Latenz und Leerlaufkosten |
| Anfrage- und Antwortstruktur | Bestätigt, dass OpenAI-kompatible Clients sauber angepasst werden können |
Wenn Ihre genaue Suchanfrage runpod serverless endpoints vllm deployment guide lautet, behandeln Sie „endpoints“ als ein Operationsthema: Erstellen Sie den Endpoint, testen Sie aber auch Cold Starts, Worker-Skalierung, Anfragegrenzen und Rollback.
Ray Serve vLLM-Deployment-Guide
Ein Ray Serve vLLM-Deployment-Guide ist nützlich, wenn das Deployment nicht mehr nur ein Modell auf einem Worker ist. Ray Serve kann Teams dabei helfen, eine Serving-Anwendung zu erstellen, die Deployments zusammensetzt, Replikate skaliert und auf einem Ray-Cluster läuft. Das ist wertvoll, wenn Sie Python-Logik für das Serving um das Modell herum benötigen, benutzerdefiniertes Routing, Multi-Modell-Anwendungen oder einen Cluster, der bereits auf Ray standardisiert ist.
Verwenden Sie Ray Serve, wenn:
- Sie Ray bereits für ML-Infrastruktur einsetzen.
- Sie mehrere Deployments in einem Serving-Graphen benötigen.
- Sie Routing auf Anwendungsebene um ein oder mehrere vLLM-Engines herum wünschen.
- Sie einen Pfad vom lokalen Testen zu einem Ray-Cluster benötigen.
- Ihr Plattform-Team Ray betreiben kann, nicht nur vLLM.
Der Nachteil ist die operative Oberfläche. Ray bietet Orchestrierungsleistung, fügt aber auch Ray-Cluster-Betrieb, Autoscaling-Verhalten, Objekt-Store-Aspekte, Logs, Dashboards und einen weiteren Upgrade-Pfad hinzu. Für ein einzelnes Modell hinter einem Endpoint kann ein direktes vLLM-Deployment einfacher sein.
Kubernetes-Deployment-Muster
Kubernetes ist eine gute Wahl, wenn Ihr Unternehmen bereits GPU-Knoten, Ingress, Secrets, Metriken und Rollout-Richtlinien in Kubernetes betreibt. Für ein kleines Team ist es nicht automatisch das richtige erste Deployment.
Die Kubernetes-Checkliste:
| Bereich | Checkliste |
|---|---|
| GPU-Scheduling | Node-Labels, Taints, Ressourcenanforderungen, Device-Plugin und GPU-Isolierung |
| Modellspeicher | Persistentes Volume, Object-Store-Sync oder eine im Image eingebettete Strategie |
| Start | Aufwärmen des Modell-Caches und eine realistische Readiness-Probe |
| Gesundheit | Liveness-Probe, die langsame, aber gesunde Modell-Ladevorgänge nicht beendet |
| Rollout | Canary- oder Blue-Green-Deployment mit schnellem Rollback |
| Autoscaling | Skalierung nach Queue, Latenz oder GPU-Metriken, nicht nur nach CPU |
| Netzwerk | Standardmäßig nur intern; öffentlicher Ingress nur über Authentifizierungssteuerungen |
| Observability | Latenz pro Route, Fehlerrate, GPU-Speicher und Kostenzuordnung |
Wenn Ihre Plattform noch keine ausgereifte GPU-Kubernetes-Umgebung hat, beginnen Sie zuerst mit einem GPU-Host oder einem verwalteten Endpoint. Kubernetes sollte das operationelle Risiko verringern und nicht einen einfachen Endpoint in ein Cluster-Projekt verwandeln.
Lasttestplan für ein vLLM-Deployment
Führen Sie keinen Lasttest mit nur einem Prompt durch. Erstellen Sie einen repräsentativen Request-Satz.
Verwenden Sie mindestens drei Traces:
- Kurzer Chat: kurzer Prompt, kurze Ausgabe, hohe Parallelität.
- Langkontext-RAG: langer Prompt, mittlere Ausgabe, wiederholte System- und Retrieval-Vorlage.
- Agent- oder Tool-Loop: wiederholtes Schema, strukturierte Ausgabe, Abbruch, Retries und Multi-Turn-Kontext.
Erfassen Sie:
| Metrik | Ziel |
|---|---|
| Akzeptierte Requests pro Minute | Misst den nutzbaren Durchsatz |
| Zeit bis zum ersten Token p50/p95/p99 | Zeigt die interaktive Latenz |
| End-to-End-Latenz p50/p95/p99 | Zeigt die vom Nutzer sichtbare Aufgabendauer |
| Fehler- und Timeout-Rate | Zeigt die Zuverlässigkeit unter Last |
| Retry-bereinigte Latenz | Zeigt die tatsächliche Erfahrung nach Fehlern |
| GPU-Speicher-Höchststand | Zeigt den Spielraum |
| Kosten pro akzeptierter Ausgabe | Zeigt die Wirtschaftlichkeit |
Führen Sie zwei Benchmarks aus:
- Standardlauf: minimale Optimierung, damit Sie die Time-to-Production kennen.
- Getunter Lauf: angepasstes Batching, Cache, Quantisierung und Anfragegrenzen, damit Sie das Maximum kennen.
Wenn der getunte Lauf schneller, aber fragil ist, deployen Sie ihn nicht als Standard. Deployen Sie die Konfiguration, die Ihr On-Call-Team erklären kann.
Wann Sie vLLM nicht selbst deployen sollten
Self-Hosting ist wertvoll, wenn Sie Hardware-Kontrolle, benutzerdefinierte Gewichte, strikte Datenlokalität oder hohe nachhaltige Auslastung bei einem stabilen Workload benötigen. Es ist weniger attraktiv, wenn der Traffic unsicher ist, sich das Modell häufig ändert, Frontier-Proprietary-Modelle erforderlich sind oder dem Team Kapazitäten für Inference-Operations fehlen.
Wählen Sie zuerst eine verwaltete Model-API oder einen Router, wenn:
- Sie noch die Modellqualität testen.
- Sie häufige Modellwechsel benötigen.
- Der Traffic sprunghaft oder schwer vorherzusagen ist.
- Fallback über mehrere Anbieter wichtiger ist als GPU-Kontrolle.
- Sie ein Nutzungsjournal, Budgets, Rechnungen und Team-Governance benötigen, bevor Sie GPU-Tuning vornehmen.
Flatkey passt in diese Ebene, wenn API-seitige Workloads einen Schlüssel, eine Abrechnung, eine Rechnung, Nutzungsaufzeichnungen und Zugriff auf offizielle Modellrouten benötigen. Wenn sich ein Workload später als stabil genug für dediziertes GPU-Serving erweist, vergleichen Sie den selbst gehosteten vLLM-Endpunkt weiterhin mit der Vergleich der Preise von KI-Modellen, der Vergleich der KI-API-Preise und Ihren gemessenen GPU-Kosten pro akzeptierter Ausgabe.
Deployment-Runbook-Vorlage
Kopieren Sie dies vor dem Start.
Dienst:
  Verantwortlicher:
  Bereitschaftsdienst:
  Modellalias:
  Bereitgestellte Modellrevision:
  vLLM-Version:
  Container-Image:
  GPU-Typ und Anzahl:
  Basis-URL:

Anforderungsrichtlinie:
  Maximale Modelllänge:
  Maximale Ausgabe-Token:
  Maximale Parallelität:
  Warteschlangen-Timeout:
  Anfrage-Timeout:
  Authentifizierungsmethode:

Beobachtbarkeit:
  Metrik-Dashboard:
  Log-Speicherort:
  Trace-/Anfrage-ID-Feld:
  Alarmschwellen:

Rollout:
  Canary-Prozentsatz:
  Rollback-Image:
  Rollback-Modellrevision:
  Fallback-Route:

Kosten:
  Quelle der GPU-Kosten:
  Annahmen zu Speicher/Bandbreite:
  Nenner für akzeptierte Ausgaben:
  Verantwortlicher für die wöchentliche Kostenprüfung:
Diese Vorlage ist wichtiger als der perfekte erste Befehl. Ein vLLM-Deployment-Guide, der nicht an den Bereitschaftsdienst übergeben werden kann, ist immer noch ein Prototyp.
Häufig gestellte Fragen
Ist es Inhalt eines vLLM-Deployment-Guides, wenn ich einen verwalteten GPU-Endpunkt verwende?
Ja. Wenn vLLM die Serving-Engine ist und Sie entscheiden, wie Sie sie bereitstellen, skalieren, beobachten und absichern, gehört das immer noch in einen vLLM-Deployment-Guide. Die betrieblichen Details unterscheiden sich zwischen einer rohen VM, RunPod Serverless, Ray Serve und Kubernetes, aber die Abnahmetests sind ähnlich: Endpunktvertrag, Latenz, Fehler, Parallelität, Rollback und Kosten pro akzeptierter Ausgabe.
Sollte ich für vLLM RunPod Serverless oder eine persistente GPU-VM verwenden?
Verwenden Sie RunPod Serverless, wenn Burst-Verarbeitung und verwaltete Endpunkt-Operationen wichtiger sind als stets warme Latenz. Verwenden Sie eine persistente GPU-VM, wenn Sie vorhersehbare Warm-Performance, direkte Kontrolle über den Host oder einen einfacheren Debugging-Pfad benötigen. Benchmarken Sie beides, wenn Latenz und Auslastung die Entscheidung bestimmen.
Wann macht Ray Serve mit vLLM Sinn?
Ray Serve macht Sinn, wenn vLLM Teil einer größeren Serving-Anwendung ist, insbesondere wenn Sie Ray bereits betreiben. Für ein Modell hinter einem Endpunkt kann direktes vLLM-Serving einfacher zu betreiben sein.
Kann vLLM die OpenAI-API ersetzen?
vLLM kann für unterstützte selbst gehostete Modelle eine OpenAI-kompatible Schnittstelle bereitstellen, macht Open-Weight-Modelle aber nicht identisch mit proprietären Frontier-APIs. Betrachten Sie es als Endpunktvertrag und Serving-Option und validieren Sie dann Modellqualität, Latenz und Betriebskosten gegen Ihren Workload.
Was sollte ich zuerst messen?
Messen Sie die angenommene Antwortquote, die Zeit bis zum ersten Token, die p95- und p99-Latenz, die Timeout-Rate, den GPU-Speicherdruck und die Kosten pro akzeptierter Ausgabe. Rohes Tokens-pro-Sekunde ist nützlich, aber für Produktionsentscheidungen nicht ausreichend.
Wo passt Flatkey in Verbindung mit vLLM hinein?
Verwenden Sie vLLM, wenn Sie die GPU-Serving-Schicht selbst betreiben möchten. Verwenden Sie Flatkey, wenn Sie eine einzige OpenAI-kompatible Modell-API-Schicht, einheitliche Abrechnung, Nutzungsaufzeichnungen und Governance über offizielle Modellrouten und Tools hinweg möchten. Viele Teams werden beides verwenden: vLLM für stabile selbst gehostete Workloads und Flatkey für Frontier-Modelle, Fallback, Experimente und Governance auf der API-Seite.
Abschließende Checkliste
Vor dem Start sollte Ihr vLLM-Deployment-Guide diese Artefakte erzeugen:
- Eine fest angeheftete Modellrevision und Container-Version.
- Eine getestete OpenAI-kompatible Basis-URL.
- Eine Authentifizierungs- und Netzwerkgrenze.
- Anfragelimits für Kontext, Ausgabe, Timeout und Parallelität.
- Metriken für Latenz, Fehler, Warteschlangenbildung, Durchsatz und GPU-Speicher.
- Eine Rollback-Route und ein vorheriges bekannt gutes Image.
- Ein Arbeitsblatt zu den Kosten pro akzeptierter Ausgabe.
- Ein Entscheidungsprotokoll, das erklärt, warum selbst gehostetes vLLM für diesen Workload besser ist als eine verwaltete Modell-API.
Wenn diese Artefakte existieren, betreiben Sie nicht nur vLLM. Sie betreiben eine LLM-API auf GPUs.


