
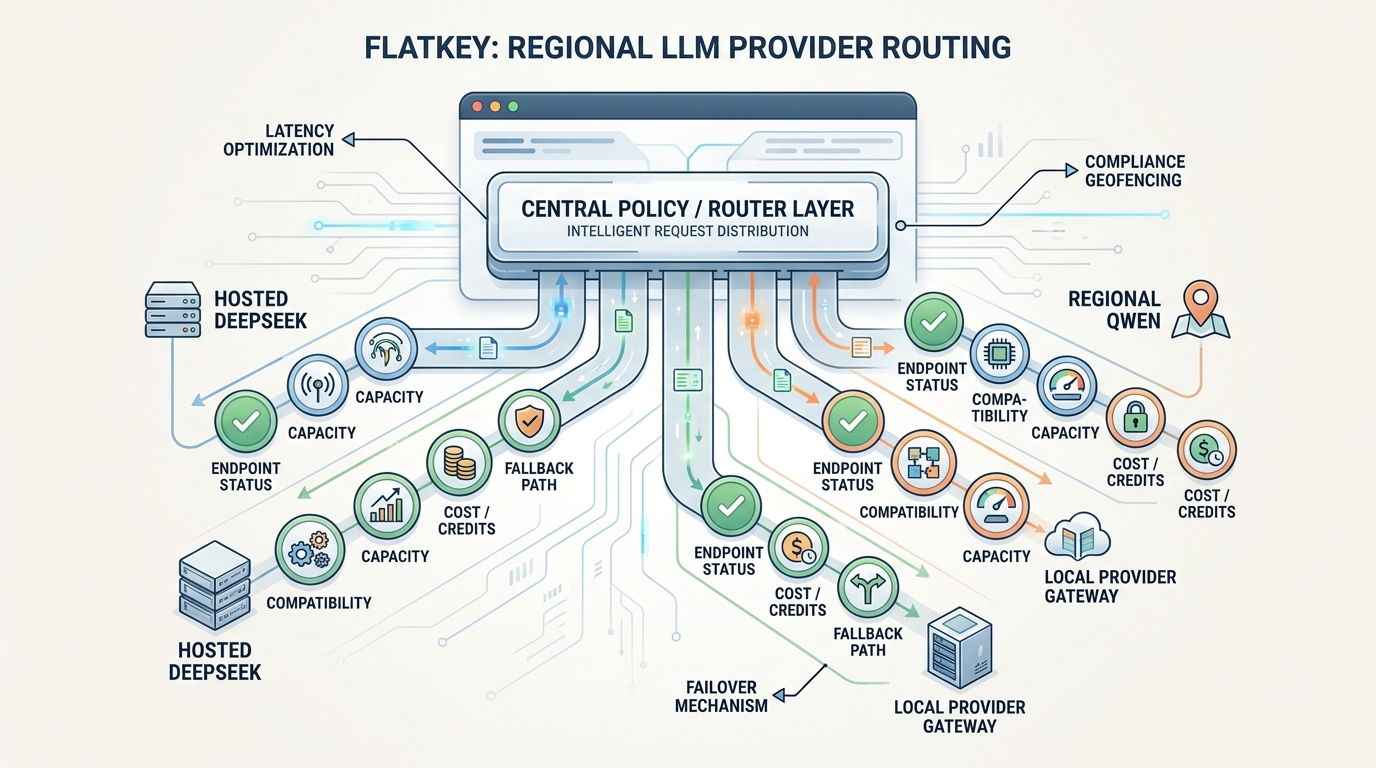
Wenn Sie regionales LLM-Provider-Routing planen, besteht der riskante Teil nicht darin, einen weiteren OpenAI-kompatiblen Endpunkt zu finden. Der riskante Teil ist zu entscheiden, wann eine DeepSeek-Route wie ein gehosteter Cloud-Provider behandelt werden kann, wann eine Qwen-Route regiongebundene Endpunktprüfungen benötigt und wann ein lokaler Provider Infrastrukturprüfungen braucht, bevor er Produktionsverkehr erhalten kann.
Deshalb sollte regionales LLM-Provider-Routing mit der Provider-Klasse beginnen, nicht mit der Sprache von Modell-Rankings. DeepSeek, Qwen und lokale Laufzeiten können auf SDK-Ebene alle vertraut wirken, aber sie teilen nicht denselben Regionsvertrag, dasselbe Lebenszyklusrisiko, dasselbe Kapazitätssignal oder dieselben Regeln für sichere Fallbacks.
Dieser Leitfaden gibt KI-Produktteams eine praktische Richtlinie für regionales LLM-Provider-Routing über DeepSeek, Qwen und lokale Provider-Gateways hinweg. Nutzen Sie ihn, bevor Sie Produktionsverkehr verschieben, Fallbacks hinzufügen oder ein gemeinsames KI-Gateway teamübergreifend standardisieren.
Die kurze Antwort
Eine sicherere Richtlinie für regionales LLM-Provider-Routing trennt Routen in drei Provider-Klassen, bevor Modellnamen verglichen werden:
| Provider-Klasse | Erste Prüfungen | Warum sie eine separate Richtlinie braucht |
|---|---|---|
| DeepSeek | API-Format, Modell-Alias, Feature-Unterstützung, Token-Preiseinheit, Parallelitätslimit | DeepSeek stellt OpenAI- und Anthropic-kompatible Pfade bereit, aber die Sicherheit der Route hängt weiterhin vom Modell-Lebenszyklus, dem Preismodell und der Kapazität auf Kontoebene ab. |
| Qwen / Alibaba Cloud Model Studio | Regionsendpunkt, Workspace-Domain, regiongebundener API-Schlüssel, OpenAI-kompatible Feature-Einschränkungen | Qwen-Routing ist per Design regional; Endpunkt, Workspace-ID und die Region des API-Schlüssels können darüber entscheiden, ob ein Aufruf funktioniert. |
| Lokales Provider-Gateway | Erreichbarkeit des Hosts, Modell-Pinning, lokale Hardware-Reserven, Kompatibilitätslücken, Isolierung von Fallbacks | Eine lokale Route schlägt fehl wie Infrastruktur, die Sie betreiben, nicht wie ein gehostetes API-Konto. |
Flatkey passt in diesen Workflow als gemeinsame Gateway-Schicht: ein Schlüssel, ein Modellkatalog, eine OpenAI-kompatible Routing-Oberfläche und eine einheitliche Nutzungsansicht für unterstützte Modelle und Tools. Aber ein Gateway sollte provider-spezifische Prüfungen nicht aufheben. Es sollte diese Prüfungen explizit, beobachtbar und leichter überprüfbar machen.
Was regionales LLM-Provider-Routing wirklich optimiert
Gutes regionales LLM-Provider-Routing fragt nicht nur, welches Modell in einem Benchmark am besten abschneidet. Es fragt, welche Provider-Klasse eine Anfrage unter der aktuellen Produkt-, Regions- und Fallback-Richtlinie sicher übernehmen kann.
In der Produktion gleicht regionales LLM-Provider-Routing normalerweise sechs Dinge gleichzeitig aus:
- Endpoint-Geografie: Einige Anbieter stellen je nach Region unterschiedliche Basis-URLs bereit, und das kann Latenz, Kontoeinrichtung, Residency-Prüfung und Failover-Design verändern.
- Kompatibilitätstiefe: OpenAI-Kompatibilität kann Chat-Completions abdecken, sich aber dennoch bei Tools, Streaming, Vision, Audio, Reasoning-Steuerungen oder Nutzungsfeldern unterscheiden.
- Lebenszyklus-Stabilität: Modell-Aliase, Preview-Modelle, eingestellte Routen und Kompatibilitäts-Shims können die Anfrage verändern, selbst wenn der SDK-Aufruf weiterhin erfolgreich ist.
- Kapazitätsmodell: Gleichzeitigkeit auf Kontoebene unterscheidet sich von Rate Limits, und beides unterscheidet sich von einem lokalen GPU- oder CPU-Engpass.
- Fallback-Sicherheit: Eine Backup-Route hilft nur, wenn sie dieselbe Region, dieselben Features, dieselben Daten und denselben Qualitätsvertrag bewahrt.
- Kostentransparenz: Teams müssen die Kosten pro akzeptierter Antwort vergleichen, nicht nur die reinen Token-Preise.
Das ist die eigentliche Aufgabe des regionalen LLM-Provider-Routings. Es ist kein universeller Endpunkt-Abstraktionslayer. Es ist eine Richtlinie zur Provider-Prüfung, die entscheidet, welche Routen für welche Workload zulässig sind.
Beginnen Sie mit dem Routing chinesischer LLM-APIs, indem Sie Provider-Klassen trennen
Der erste Fehler beim Routing chinesischer LLM-APIs besteht darin, jede China-bezogene oder in Asien gehostete Route als einen einzigen Bucket zu behandeln. Das nivelliert zu viele betriebliche Unterschiede.
DeepSeek und Qwen sind beide wichtig für das Routing chinesischer LLM-APIs, aber ihre Routing-Prüfungen sind nicht dieselben. Die öffentlichen API-Dokumente von DeepSeek betonen den OpenAI- und Anthropic-kompatiblen Zugriff mit bestimmten Modellnamen und einer Konkurrenz auf Kontoebene. Die Dokumente von Alibaba Cloud Model Studio für Qwen betonen den OpenAI-kompatiblen Zugriff über regionsspezifische Endpunkte, workspacespezifische Domains und API-Keys, die an die Region gebunden sind, in der sie erstellt wurden.
Verwenden Sie diese Aufteilung, bevor Sie Traffic routen:
| Routenfrage | DeepSeek | Qwen / Model Studio | Lokales Provider-Gateway |
|---|---|---|---|
| Ist der Endpunkt regional? | Validieren Sie die offizielle Basis-URL und gegebenenfalls die Gateway-Route. | Validieren Sie den exakten Region-Endpunkt und die workspace-spezifische Domain. | Validieren Sie Host, privates Netzwerk oder lokale Laufzeitadresse. |
| Ist der API-Schlüssel regionsgebunden? | Prüfen Sie Konto- und Modellzugriff. | Prüfen Sie, dass der API-Schlüssel in derselben Region wie der Endpunkt erstellt wurde. | Prüfen Sie lokale Authentifizierung, Netzwerkzugriff und Maschinenberechtigungen. |
| Ist die Kompatibilität vollständig genug? | Testen Sie Chat, Tools, Reasoning, Anthropic-Format, Vision und die Responses API nur, wenn Ihre Workload sie nutzt. | Testen Sie Chat, Tools, Streaming, Multimodal-Unterstützung und modellfamilienbezogene Vorbehalte anhand des ausgewählten Modells. | Behandeln Sie die Kompatibilität als teilweise, bis Ihre eigenen Smoke-Tests bestanden sind. |
| Was ist das Kapazitätssignal? | Concurrency auf Kontoebene und 429-Verhalten. | Region, Workspace, Kontingent, Endpunktgesundheit und Provider-Limits. | GPU-/CPU-/RAM-Reserve, Daemon-Gesundheit, Warteschlangentiefe und Modellladezeit. |
| Welches Fallback ist erlaubt? | Eine gehostete Route mit passender Feature- und Richtlinienklasse. | Eine andere genehmigte Route in derselben regionalen Richtlinie oder ein genehmigtes gehostetes Fallback. | Ein zweiter lokaler Knoten oder eine vorab genehmigte Cloud-Route mit expliziter Datenrichtlinienprüfung. |
Wenn Sie diese Aufteilung überspringen, wird regionales LLM-Provider-Routing zum Ratespiel. Dieselbe Workload kann zwischen drei sehr unterschiedlichen Provider-Klassen wechseln, ohne dass jemand erklären kann, welche Prüfungen angewendet wurden.
DeepSeek Benötigt Getrennte Prüfungen, Selbst Wenn Das SDK Vertraut Wirkt
Die offizielle Dokumentation von DeepSeek macht die Migration zugänglich: Die API verwendet ein mit OpenAI und Anthropic kompatibles Format, mit https://api.deepseek.com für OpenAI-Format-Aufrufe und https://api.deepseek.com/anthropic für Anthropic-Format-Aufrufe. Diese Kompatibilität ist nützlich, beseitigt aber nicht die Notwendigkeit von DeepSeek-spezifischen Prüfungen.
Für DeepSeek Qwen Routing sollte DeepSeek aus vier Gründen separat geprüft werden.
Erstens: Modell-Aliasse und Lebenszyklus-Hinweise beeinflussen die Routensicherheit. Stand 12. September 2026 führen DeepSeeks Dokumente deepseek-flash und deepseek-v4-pro als aktuelle Modellnamen auf. Die Dokumente weisen auch darauf hin, dass die alten Namen deepseek-v4-flash und deepseek-v4-flash-vision-exp weiterhin akzeptiert werden, die Anfragen jedoch vom neueren Flash-Modell bedient und zum Flash-Preis abgerechnet werden. Genau solche Lebenszyklusdetails sollte ein Router sichtbar machen, statt sie zu verbergen.
Zweitens: Feature-Unterstützung ist modellabhängig. Die Preistabelle von DeepSeek listet JSON-Ausgabe, Tool-Aufrufe, Responses API, Anthropic API, Beta-Chat-Prefix-Completion, Beta-FIM und Vision-Unterstützung nach Modell auf. Das bedeutet, dass Ihre Richtlinie für regionales LLM-Provider-Routing nur die Funktionen testen sollte, die die Workload tatsächlich nutzt, und nicht davon ausgehen darf, dass jede DeepSeek-Route austauschbar ist.
Drittens ist die Preisgestaltung provider-nativ. DeepSeek veröffentlicht Preise in Einheiten von 1 Mio. Tokens und trennt zwischen Cache-Hit-, Cache-Miss-, Output-, Peak- und Off-Peak-Tarifen. Produktteams müssen nicht jeden Preis fest in der Routing-Logik hinterlegen, aber der Router muss genug Nutzungsdaten protokollieren, um DeepSeek mit Qwen, GPT, Claude, Gemini oder lokalen Routen anhand der Kosten pro akzeptierter Antwort vergleichen zu können.
Viertens ist die Kapazität kontobasiert. Auf DeepSeeks Rate-Limit-Seite steht, dass Concurrent-Limits auf Kontoebene unabhängig vom API-Schlüssel berechnet werden und Anfragen oberhalb des Concurrent-Limits HTTP 429 zurückgeben. Health Checks für regionales LLM-Provider-Routing müssen daher auch die Concurrent-Reserve berücksichtigen, nicht nur, ob eine kleine Testanfrage 200 zurückgegeben hat.
Die Lehre ist einfach: Beginnen Sie DeepSeek-Qwen-Routing nicht mit „beide sind OpenAI-kompatibel“. Gehen Sie stattdessen von den provider-spezifischen Lifecycle-, Feature-, Preis- und Kapazitätsprüfungen aus, die entscheiden, ob eine Route für die Arbeitslast sicher ist.
Qwen benötigt separate Prüfungen, weil die Region Teil des API-Vertrags ist
Die Qwen-Dokumentation von Alibaba Cloud Model Studio ist ein starkes Beispiel dafür, warum chinesisches LLM-API-Routing regionale Prüfungen benötigt. Der OpenAI-kompatible Leitfaden sagt, dass Qwen-Modelle auf Model Studio OpenAI-kompatible Schnittstellen unterstützen und dass Teams vorhandenen OpenAI-Code migrieren können, indem sie API-Schlüssel, Base-URL und Modellnamen ändern.
Doch derselbe Leitfaden macht auch den Regionsvertrag ausdrücklich. Er listet unterschiedliche Base-URLs für Singapur, Virginia, Peking, Hongkong und Japan auf. Außerdem heißt es dort, dass Model Studio für Peking, Singapur und Hongkong workspace-spezifische Domainnamen eingeführt hat und dass {WorkspaceId} durch die tatsächliche Workspace-ID ersetzt werden soll.
Das bedeutet, dass regionales LLM-Provider-Routing für Qwen nicht nur „einen Modellnamen auswählen“ ist. Es muss prüfen:
- welchen Regions-Endpunkt die Arbeitslast aufrufen darf
- ob die workspace-spezifische Domain erforderlich ist
- ob der API-Schlüssel in derselben Region wie der Endpunkt erstellt wurde
- ob eine regionsübergreifende Abweichung einen Authentifizierungsfehler zurückgibt
- ob das ausgewählte Qwen- oder Drittanbietermodell die exakten Protokollfunktionen unterstützt, die die Arbeitslast verwendet
Der Qwen-Kompatibilitätsleitfaden sagt außerdem, dass unterstützte OpenAI-kompatible Modelle Qwen Large Language Models, Qwen-VL, Qwen-Coder, Qwen-Omni, Qwen-Math, DeepSeek, Kimi, GLM und MiniMax umfassen. Separat wird darauf hingewiesen, dass Qwen-Audio das OpenAI-kompatible Protokoll nicht unterstützt und stattdessen das DashScope-Protokoll verwenden sollte.
Diese Einschränkung ist für DeepSeek-Qwen-Routing wichtig. Eine Modellfamilie kann im selben Katalog oder in derselben Cloud-Konsole auftauchen und trotzdem einen anderen Protokollpfad benötigen. Wenn Ihr Produkt Tools, Streaming, Audio, Vision oder multimodale Eingaben verwendet, braucht Qwen-Routing Feature-Tests auf Smoke-Test-Niveau, bevor der Produktionsverkehr umgestellt wird.
Ein lokales LLM-Provider-Gateway benötigt Infrastrukturprüfungen
Der dritte Fehler beim regionalen LLM-Provider-Routing besteht darin anzunehmen, dass ein lokales Provider-Gateway sich wie ein anderer gehosteter Anbieter verhält. Das tut es nicht.
Ollamas OpenAI-Kompatibilitätsdokumentation zeigt, warum. Ollama stellt lokale OpenAI-kompatible Chat Completions über http://localhost:11434/v1 bereit, und die Dokumentation beschreibt diese Unterstützung als anfänglich und experimentell. Das ist für die lokale Entwicklung und kontrollierte interne Workflows nützlich, sollte aber nicht als dieselbe Risikoklasse wie eine gehostete Route behandelt werden.
Mit einem lokalen Provider-Gateway ändern sich Ihre Routing-Prüfungen:
- Kann der Workload von der Umgebung, in der er ausgeführt wird, den lokalen Host oder die private Netzwerkroute erreichen?
- Ist die Modellversion fest verankert, oder kann ein Entwickler- oder Paket-Update sie ändern?
- Unterstützt die lokale Route dieselben Anfragefunktionen wie die Cloud-Route?
- Gibt es genug GPU-, CPU-, Speicher- und Queue-Headroom für echte Lastspitzen?
- Stellt die Route Latenz-, Fehler- und Sättigungssignale auf dieselbe Weise bereit wie gehostete Provider?
- Ist ein Fallback zu einem Cloud-Provider gemäß der Datenrichtlinie des Kunden erlaubt?
Diese Prüfungen sind Infrastrukturprüfungen, nicht nur API-Prüfungen. Ein lokales LLM-Provider-Gateway kann die richtige Antwort für Datenschutz, Offline-Arbeit oder Kostenkontrolle sein, aber nur, wenn regionales LLM-Provider-Routing lokale Gesundheit, Kapazität, Funktionsunterstützung und Versionsdrift als erstklassige Einschränkungen behandelt.
Verwenden Sie eine Provider-Prüfmatrix, bevor Sie Traffic umleiten
Ein dauerhaftes Rollout für regionales LLM-Provider-Routing benötigt eine Matrix, die Engineering, Produkt, Sicherheit und Finanzen gleichermaßen lesen können.
| Prüfklasse | DeepSeek-Route | Qwen-Route | Route des lokalen Providers |
|---|---|---|---|
| Endpunkt | Offizielle oder Gateway-Basis-URL bestätigen. | Region-Endpunkt und workspacespezifische Domain bestätigen. | localhost, privaten Endpunkt oder lokale Gateway-URL bestätigen. |
| API-Schlüssel | Konto- und Modellzugriff bestätigen. | Bestätigen, dass die Region des API-Schlüssels mit der Endpunkt-Region übereinstimmt. | Lokale Authentifizierung und Umgebungszugriff bestätigen. |
| Kompatibilität | OpenAI-Format, Anthropic-Format, Responses API, Tools, Vision und Thinking-Steuerungen nur dort testen, wo sie benötigt werden. | OpenAI-kompatiblen Chat plus Modellfamilien- Besonderheiten testen, insbesondere Audio, Vision, Tools und Streaming. | |
| Kapazität | Konto-Konkurrenz, 429-Rate, Latenz und Anforderungsdauer verfolgen. | Region-Quota, Endpunktgesundheit, 401/403/404-Ursachen und Throttle-Verhalten des Providers verfolgen. | Maschinenauslastung, Warteschlangentiefe, Modellladezeit und Daemon-Neustarts verfolgen. |
| Kosten | Cache-Treffer, Cache-Miss, Ausgabe, Peak- und Off-Peak-Ökonomie in Kosten pro akzeptierter Antwort normalisieren. | Tokenkosten plus Region-/Workspace-Verhalten in Kosten pro akzeptierter Antwort normalisieren. | Hardware-, Betriebs-, Warteschlangenverzögerungs- und Cloud-Fallback-Kosten einbeziehen. |
| Lebenszyklus | Modell-Aliase, Legacy-Namen, Preview-Status und Funktionsänderungen beobachten. | Änderungen am regionalen Endpunkt, Unterstützung der Modellfamilie und Protokollausnahmen beobachten. | Runtime-Version, Modellgewichte, Quantisierung und lokale Paket-Updates beobachten. |
| Fallback | Nur freigegebene gehostete Routen mit übereinstimmender Funktions- und Richtlinienklasse verwenden. | Nur regionsfreigegebene oder richtlinienfreigegebene Alternativen verwenden. | Nur einen zweiten lokalen Knoten oder eine freigegebene Cloud-Route nach Datenrichtlinienprüfung verwenden. |
Diese Matrix verhindert, dass DeepSeek Qwen Routing zu einem Modellwechsel in einer Zeile wird. Die Route ist nur dann zulässig, wenn ihre Provider-Klasse die für die Arbeitslast relevanten Prüfungen besteht.
Ein praktischer Entscheidungsbaum für das regionale LLM-Provider-Routing
Verwenden Sie diesen Workflow immer dann, wenn eine neue Arbeitslast DeepSeek, Qwen oder einen lokalen Provider anfragt:
- Klassifizieren Sie die Arbeitslast: Chat, Code, Extraktion, Agent-Tool-Nutzung, Vision, Audio, Batch oder Multimodal.
- Bestimmen Sie die Datenrichtlinie: zulässige Region, Aufbewahrungssensitivität, Kundenvertrag und ob ausschließlich lokale Verarbeitung erforderlich ist.
- Wählen Sie zulässige Provider-Klassen vor Modellnamen aus.
- Führen Sie die Prüfung der Provider-Klasse durch: Endpunkt, Schlüssel, Kompatibilität, Kapazität, Lebenszyklus und Fallback.
- Führen Sie einen workload-spezifischen Smoke-Test mit realen Prompts und Parsern durch.
- Leiten Sie einen kleinen Staging- oder Canary-Anteil um.
- Messen Sie die Rate akzeptierter Antworten, p95-Latenz, Fallback-Rate, 429/401/403/404-Rate und Kosten pro akzeptierter Antwort.
- Genehmigen Sie die Route nur für die Workload-Klassen, für die sie bestanden wurde.
- Behalten Sie einen Rollback-Pfad bei, bis die Route Produktionsnachweise hat.
Hier ist die gleiche Logik als Richtliniendaten:
regional_llm_provider_routing:
  classify:
    inputs:
      - workload_type
      - required_features
      - data_region
      - customer_policy
      - latency_budget
  provider_classes:
    deepseek:
      checks:
        - base_url_or_gateway_route
        - model_alias_lifecycle
        - required_feature_support
        - account_concurrency_headroom
        - cost_per_accepted_response
    qwen:
      checks:
        - region_endpoint
        - workspace_domain
        - api_key_region_match
        - required_feature_support
        - quota_and_error_classification
    local_gateway:
      checks:
        - host_reachability
        - model_version_pin
        - hardware_headroom
        - compatibility_smoke_test
        - approved_cloud_fallback_policy
  fallback:
    allowed_only_when:
      - same_workload_contract
      - same_data_policy
      - required_features_supported
      - retry_budget_remaining
    otherwise: manual_review
  observe:
    log:
      - route
      - provider_class
      - model
      - endpoint_region
      - status
      - latency_ms
      - input_tokens
      - output_tokens
      - cost
      - fallback_reason
Dies ist der Kern des regionalen LLM-Provider-Routings. Definieren Sie die Richtlinie einmal und ordnen Sie dann Modelle darin ein, wenn Provider Routen hinzufügen, umbenennen oder auslaufen lassen.
Wo Flatkey hineinpasst
Flatkey ist nützlich, wenn das betriebliche Problem nicht mehr nur ein einzelner API-Aufruf ist. Das Problem sind verstreute Provider-Schlüssel, Modellkataloge, Tool-Aufrufe, Nutzungsprüfungen und Fallback-Richtlinien über Teams und Agents hinweg.
Die aktuelle öffentliche Homepage von Flatkey beschreibt einen Schlüssel hinter den offiziellen GPT-, Claude-, Gemini-, DeepSeek-, Qwen- und GLM-APIs sowie mehr als 100 Frontier-Modelle und mehr als 1.000 KI-Tools. Das Flatkey-Modellverzeichnis ist darauf ausgelegt, aktuelle Modellverfügbarkeit, Preise, Endpoint-Unterstützung und Modell-Detailseiten anzuzeigen. Die Dokumentation zeigt das übliche Migrationsmuster: Behalten Sie Ihre OpenAI-kompatible Request-Struktur bei und richten Sie das SDK auf https://router.flatkey.ai/v1 aus.
Für dieses Thema zeigte der aktuelle Flatkey-Katalog- und Preis-Feed, der am 12. September 2026 abgefragt wurde, verfügbare DeepSeek- und Qwen-Beispiele in der Gruppe China LLM, darunter deepseek-v4-pro, deepseek-v4-flash, deepseek-v3.2-thinking, deepseek-v3.2, qwen3.8-max, qwen3.7-max, qwen3.7-plus, qwen3.6-max-preview und mehrere Qwen-3.5-Routen. Behandeln Sie diese Beispiele als veraltete Katalog-Schnappschussdaten, nicht als dauerhafte Verfügbarkeitszusage.
Die richtige Rolle von Flatkey im regionalen LLM-Provider-Routing ist die Steuerungsebene:
- Vergleichen Sie unterstützte gehostete Routen in einem Modellverzeichnis.
- Behalten Sie eine stabile OpenAI-kompatible Basis-URL für den Anwendungscode bei.
- Verfolgen Sie Modell, Endpoint-Typ, Status, Token-Nutzung, Latenz und Kosten an einem Ort.
- Erleichtern Sie die Prüfung von Provider-Klassen-Routing und Fallback-Entscheidungen.
- Bewahren Sie separate Prüfungen für DeepSeek-, Qwen- und lokale Provider-Gateways, statt sie zu verbergen.
Wenn Sie Flatkey bereits verwenden, beginnen Sie mit dem Prüfen des Modellverzeichnisses, der Preisseite und des Flatkey-API-Quickstarts. Für einen kontextbezogenen Bezug zum Routing kombinieren Sie diesen Leitfaden mit dem Workflow für die einheitliche KI-API, dem Migrationsleitfaden für OpenAI-API-Alternativen, dem Playbook für multimodales Fallback-Routing und dem Framework für KI-Routing-API-Metriken.
Start-Checkliste
Bevor Sie regionales LLM-Provider-Routing in die Produktion überführen, bestätigen Sie diese Punkte:
- DeepSeek-, Qwen- und lokale Routen sind in der Routing-Richtlinie getrennte Provider-Klassen.
- Qwen-Endpunktregion, Workspace-Domäne und API-Key-Region werden validiert, bevor Traffic umgeleitet wird.
- DeepSeek-Modell-Aliase, Funktionsunterstützung, Token-Preis-Einheiten und Parallelitätsverhalten werden geprüft.
- Lokale Routen verfügen über Host-Erreichbarkeit, festgelegtes Modellversions-Pinning, Hardware-Reserven und Warteschlangenüberwachung.
- Tool-Nutzung, Streaming, Vision, Audio, Reasoning-Steuerungen und strukturierte Ausgabe werden nur dort getestet, wo der Workload sie erfordert.
- Fallback-Routen bewahren denselben Workload-Vertrag und dieselbe Datenrichtlinie.
- Logs enthalten Provider-Klasse, Endpunktregion, finales Modell, Status, Latenz, Tokens, Kosten und Fallback-Grund.
- Produkt und Finance prüfen die Kosten pro akzeptierter Antwort, nicht nur den ausgewiesenen Tokenpreis.
- Ein Rollback bleibt verfügbar, bis die Route echte Produktionsnachweise hat.
Wenn diese Prüfungen vorhanden sind, wird regionales LLM-Provider-Routing zu einem wiederholbaren Betriebsmodell statt zu einem versteckten Satz von Provider-Ausnahmen.
FAQ
Was ist regionales LLM-Provider-Routing?
Regionales LLM-Provider-Routing ist die Richtlinienebene, die entscheidet, welche Provider-Klasse eine KI-Anfrage auf Grundlage von Endpunktregion, API-Key-Umfang, Kompatibilität, Kapazität, Lebenszyklusrisiko, Kosten und Fallback-Sicherheit bearbeiten soll.
Warum benötigt chinesisches LLM-API-Routing separate Prüfungen?
Chinesisches LLM-API-Routing benötigt separate Prüfungen, weil sich DeepSeek, Qwen und andere regionale Provider hinsichtlich Endpunktgeografie, API-Key-Region, Tiefe der Kompatibilität, Modell-Lebenszyklus, Kontingentverhalten und Preiseinheiten unterscheiden können, selbst wenn sie OpenAI-kompatible Schnittstellen bereitstellen.
Warum ist DeepSeek-Qwen-Routing nicht einfach ein Modellvergleich?
DeepSeek-Qwen-Routing ist nicht einfach ein Vergleich, weil DeepSeek und Qwen unterschiedliche operative Verträge haben. Die Prüfungen bei DeepSeek konzentrieren sich auf Modell-Aliase, Funktionsunterstützung, Token-Preise und Konto-Parallelität. Die Prüfungen bei Qwen konzentrieren sich auf Endpunktregion, Workspace-Domäne, API-Key-Region und Protokollunterstützung der Modellfamilie.
Wann ist ein lokales LLM-Provider-Gateway sinnvoll?
Ein lokales LLM-Provider-Gateway ist sinnvoll, wenn Datenschutz, Offline-Betrieb, Entwicklungskontrolle oder Kostenbeschränkungen den lokalen Betrieb von Modellen rechtfertigen und Ihr Team die zusätzlichen Prüfungen für Gesundheit, Kapazität, Kompatibilität und Versionsdrift übernehmen kann.
Kann eine OpenAI-kompatible Route provider-spezifische QA überspringen?
Nein. OpenAI-Kompatibilität kann den Integrationsaufwand reduzieren, aber jede Route benötigt weiterhin workload-spezifische QA für Tools, Streaming, strukturierte Ausgabe, multimodale Eingaben, Fehlerbehandlung, Nutzungsfelder, Ratenlimits und Fallback-Verhalten.
Das Fazit
Die richtige Strategie für regional LLM provider routing dreht sich weniger um einen universellen Endpunkt als um disziplinierte Provider-Prüfungen. Das gilt insbesondere dann, wenn Chinese LLM API routing sowohl DeepSeek als auch Qwen umfasst und wenn ein lokales Provider-Gateway neben gehosteten Routen für Datenschutz-, Offline- oder Kostenkontroll-Workflows steht.
Betrachten Sie DeepSeek Qwen routing zunächst als ein Problem der Provider-Richtlinien. Validieren Sie dann den Live-Endpunkt, den Schlüssel, die Kompatibilität, die Kapazität, den Lebenszyklus und die Kostenbelege, bevor Sie Produktionsverkehr umschalten.
Flatkey hilft, wenn Sie einen Schlüssel, einen Modellkatalog, eine OpenAI-kompatible Basis-URL und eine einheitliche Nutzungsoberfläche für unterstützte gehostete Routen wünschen. Nutzen Sie das Gateway, um den Betrieb zu zentralisieren, aber behalten Sie die separaten Provider-Prüfungen bei, die regionales Routing sicher machen.


