
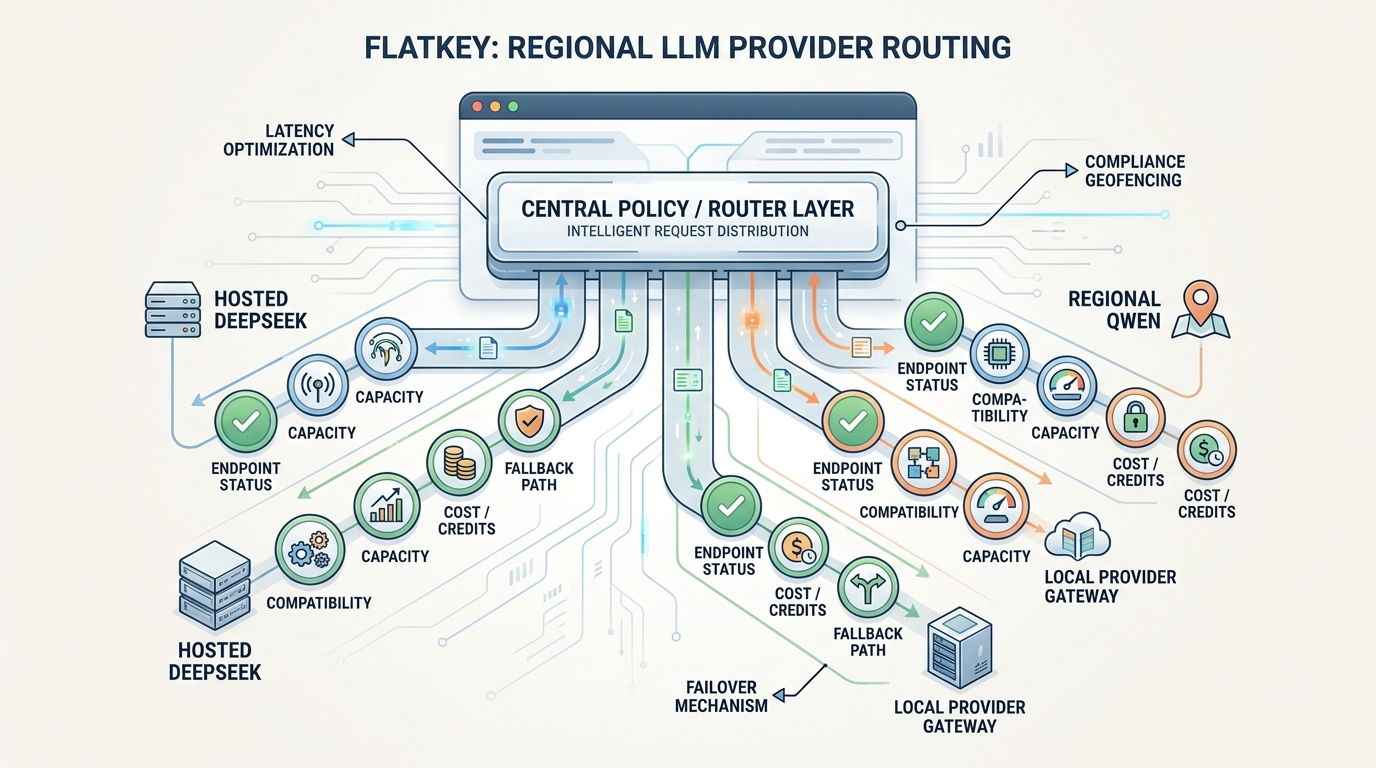
Si vous planifiez un routage régional des fournisseurs de LLM, la partie risquée n’est pas de trouver un autre endpoint compatible OpenAI. La partie risquée consiste à décider quand une route DeepSeek peut être traitée comme un fournisseur cloud hébergé, quand une route Qwen nécessite des vérifications d’endpoint liées à la région, et quand un fournisseur local a besoin de vérifications d’infrastructure avant de pouvoir recevoir du trafic de production.
C’est pourquoi le routage régional des fournisseurs de LLM doit commencer par la classe de fournisseur, et non par le langage des classements de modèles. DeepSeek, Qwen et les runtimes locaux peuvent tous sembler familiers au niveau du SDK, mais ils ne partagent pas le même contrat régional, le même risque de cycle de vie, le même signal de capacité ni les mêmes règles de sécurité de repli.
Ce guide donne aux équipes produit IA une politique pratique pour le routage régional des fournisseurs de LLM entre DeepSeek, Qwen et les passerelles de fournisseurs locaux. Utilisez-le avant de déplacer le trafic de production, d’ajouter un repli, ou de standardiser une passerelle IA partagée entre équipes.
La réponse rapide
Une politique plus sûre de routage régional des fournisseurs de LLM sépare les routes en trois classes de fournisseurs avant de comparer les noms des modèles :
| Classe de fournisseur | Premières vérifications | Pourquoi elle a besoin d’une politique distincte |
|---|---|---|
| DeepSeek | Format de l’API, alias du modèle, prise en charge des fonctionnalités, unité de tarification des jetons, limite de concurrence | DeepSeek expose des chemins compatibles OpenAI et Anthropic, mais la sécurité de la route dépend toujours du cycle de vie du modèle, du mode de tarification et de la capacité au niveau du compte. |
| Qwen / Alibaba Cloud Model Studio | Endpoint régional, domaine du workspace, clé API liée à la région, réserves sur les fonctionnalités compatibles OpenAI | Le routage Qwen est régional par conception ; l’endpoint, l’ID du workspace et la région de la clé API peuvent faire partie des conditions de réussite d’un appel. |
| Passerelle de fournisseur local | Accessibilité de l’hôte, verrouillage du modèle, marge matérielle locale, écarts de compatibilité, isolation du repli | Une route locale échoue comme une infrastructure que vous exploitez, et non comme un compte API hébergé. |
Flatkey s’inscrit dans ce flux de travail comme couche de passerelle partagée : une clé, un catalogue de modèles, une surface de route compatible OpenAI et une vue d’utilisation unique pour les modèles et outils pris en charge. Mais une passerelle ne doit pas effacer les vérifications spécifiques au fournisseur. Elle doit rendre ces vérifications explicites, observables et plus faciles à examiner.
Ce que le routage régional des fournisseurs de LLM cherche réellement à optimiser
Un bon routage régional des fournisseurs de LLM ne demande pas seulement quel modèle obtient le meilleur score sur un benchmark. Il demande quelle classe de fournisseur peut prendre en charge une requête en toute sécurité dans le cadre du produit, de la région et de la politique de repli actuels.
En production, le routage régional des fournisseurs de LLM équilibre généralement six choses à la fois :
- Géographie du point de terminaison : certains fournisseurs exposent des URL de base différentes selon la région, et cela peut modifier la latence, la configuration du compte, la vérification de la résidence des données et la conception du basculement.
- Profondeur de compatibilité : la compatibilité OpenAI peut couvrir les complétions de chat tout en différant sur les outils, le streaming, la vision, l’audio, les contrôles de raisonnement ou les champs d’utilisation.
- Stabilité du cycle de vie : les alias de modèle, les modèles de prévisualisation, les routes retirées et les rustines de compatibilité peuvent modifier la requête même si l’appel SDK réussit toujours.
- Modèle de capacité : la concurrence au niveau du compte est différente des limites de débit, et toutes deux sont différentes d’un goulot d’étranglement local GPU ou CPU.
- Sécurité du repli : une route de secours n’est utile que si elle préserve la même région, les mêmes fonctionnalités, les mêmes données et le même contrat de qualité.
- Visibilité des coûts : les équipes doivent comparer le coût par réponse acceptée, et pas seulement les prix unitaires des jetons.
C’est le vrai rôle du routage régional des fournisseurs de LLM. Ce n’est pas une abstraction unique et universelle de point de terminaison. C’est une politique de vérification des fournisseurs qui décide quelles routes sont éligibles pour quelle charge de travail.
Commencez le routage d’API LLM chinoises en séparant les classes de fournisseurs
La première erreur dans le routage d’API LLM chinoises consiste à traiter chaque route liée à la Chine ou hébergée en Asie comme un seul ensemble. Cela écrase trop de différences opérationnelles.
DeepSeek et Qwen sont tous deux importants pour le routage d’API LLM chinoises, mais leurs vérifications de routage ne sont pas les mêmes. La documentation de l’API publique de DeepSeek met en avant un accès compatible OpenAI et Anthropic avec des noms de modèles spécifiques et une concurrence au niveau du compte. La documentation de Alibaba Cloud Model Studio pour Qwen met en avant un accès compatible OpenAI via des points de terminaison spécifiques à la région, des domaines spécifiques à l’espace de travail et des clés API liées à la région où elles ont été créées.
Utilisez cette séparation avant de router le trafic :
| Question de routage | DeepSeek | Qwen / Model Studio | Passerelle de fournisseur local |
|---|---|---|---|
| L’endpoint est-il régional ? | Validez l’URL de base officielle et tout chemin de passerelle. | Validez l’endpoint régional exact et le domaine spécifique au workspace. | Validez l’hôte, le réseau privé ou l’adresse d’exécution locale. |
| La clé API est-elle liée à une région ? | Vérifiez le compte et l’accès au modèle. | Vérifiez que la clé API a été créée dans la même région que l’endpoint. | Vérifiez l’authentification locale, l’accès réseau et les autorisations de la machine. |
| La compatibilité est-elle suffisamment complète ? | Testez chat, tools, reasoning, le format Anthropic et Responses API uniquement si votre charge de travail les utilise. | Testez chat, tools, streaming, la prise en charge multimodale et les réserves propres à la famille de modèles selon le modèle sélectionné. | Considérez la compatibilité comme partielle jusqu’à ce que vos propres tests de vérification réussissent. |
| Quel est le signal de capacité ? | Concurrence au niveau du compte et comportement 429. | Région, workspace, quota, santé de l’endpoint et limites du fournisseur. | Marge de sécurité GPU/CPU/RAM, santé du daemon, profondeur de la file d’attente et temps de chargement du modèle. |
| Quel fallback est autorisé ? | Un chemin hébergé avec une classe de fonctionnalités et de politique correspondante. | Un autre chemin approuvé dans la même politique régionale, ou un fallback hébergé approuvé. | Un second nœud local ou un chemin cloud préapprouvé avec une revue explicite de la politique des données. |
Si vous omettez cette séparation, le routage régional des fournisseurs de LLM devient une devinette. La même charge de travail peut basculer entre trois classes de fournisseurs très différentes sans que personne ne puisse expliquer quelles vérifications ont été appliquées.
DeepSeek nécessite des vérifications séparées même lorsque le SDK semble familier
La documentation officielle de DeepSeek rend la migration accessible : l’API utilise un format compatible avec OpenAI et Anthropic, avec https://api.deepseek.com pour les appels au format OpenAI et https://api.deepseek.com/anthropic pour les appels au format Anthropic. Cette compatibilité est utile, mais elle ne supprime pas la nécessité de vérifications spécifiques à DeepSeek.
Pour le routage DeepSeek Qwen, DeepSeek doit être vérifié séparément pour quatre raisons.
Premièrement, les alias de modèle et les notes de cycle de vie affectent la sécurité du routage. Au 12 septembre 2026, la documentation de DeepSeek liste deepseek-flash et deepseek-v4-pro comme noms de modèles actuels. La documentation précise également que les anciens noms deepseek-v4-flash et deepseek-v4-flash-vision-exp sont toujours acceptés, mais que les requêtes sont servies par le nouveau modèle Flash et facturées au prix Flash. C’est exactement le type de détail de cycle de vie qu’un routeur devrait exposer au lieu de le masquer.
Deuxièmement, la prise en charge des fonctionnalités dépend du modèle. Le tableau tarifaire de DeepSeek indique la sortie JSON, les appels d’outils, Responses API, l’API Anthropic, l’achèvement de préfixe de chat bêta, FIM bêta et la prise en charge de la vision selon le modèle. Cela signifie que votre politique de routage régional des fournisseurs de LLM doit tester uniquement les fonctionnalités réellement utilisées par la charge de travail et ne doit pas supposer que toutes les routes DeepSeek sont interchangeables.
Troisièmement, la tarification est propre au fournisseur. DeepSeek publie ses tarifs en unités de 1 million de tokens et distingue les tarifs pour cache hit, cache miss, output, peak et off-peak. Les équipes produit n’ont pas besoin de coder en dur chaque prix dans la logique de routage, mais elles doivent faire en sorte que le routeur consigne suffisamment d’utilisation pour comparer DeepSeek à Qwen, GPT, Claude, Gemini ou aux routes locales sur le coût par réponse acceptée.
Quatrièmement, la capacité est au niveau du compte. La page de limite de débit de DeepSeek indique que les limites de concurrence sont calculées au niveau du compte, indépendamment de la clé API, et que les requêtes dépassant la limite de concurrence renvoient HTTP 429. Les vérifications de santé pour le routage régional des fournisseurs de LLM doivent donc inclure une marge de manœuvre sur la concurrence, et pas seulement vérifier si une petite requête de test a renvoyé 200.
La leçon est simple : ne commencez pas le routage DeepSeek Qwen à partir de « les deux sont compatibles avec OpenAI ». Partez plutôt des vérifications spécifiques au fournisseur sur le cycle de vie, les fonctionnalités, le prix et la capacité, qui déterminent si une route est sûre pour la charge de travail.
Qwen nécessite des vérifications séparées parce que la région fait partie du contrat d’API
La documentation Qwen de Alibaba Cloud Model Studio est un excellent exemple de la raison pour laquelle le routage d’API LLM chinois a besoin de vérifications régionales. Le guide compatible avec OpenAI indique que les modèles Qwen sur Model Studio prennent en charge des interfaces compatibles avec OpenAI et que les équipes peuvent migrer le code OpenAI existant en modifiant la clé API, l’URL de base et le nom du modèle.
Mais le même guide rend aussi explicite le contrat de région. Il répertorie différentes URL de base pour Singapour, Virginia, Pékin, Hong Kong et le Japon. Il indique également que Model Studio a introduit des noms de domaine spécifiques à l’espace de travail pour Pékin, Singapour et Hong Kong, et que {WorkspaceId} doit être remplacé par l’ID réel de l’espace de travail.
Cela signifie que le routage régional des fournisseurs de LLM pour Qwen ne consiste pas seulement à « choisir un nom de modèle ». Il doit vérifier :
- quel point de terminaison régional la charge de travail est autorisée à appeler
- si le domaine spécifique à l’espace de travail est requis
- si la clé API a été créée dans la même région que le point de terminaison
- si un décalage interrégional renvoie une erreur d’authentification
- si le modèle Qwen ou tiers sélectionné prend en charge exactement les fonctionnalités de protocole utilisées par la charge de travail
Le guide de compatibilité Qwen indique également que les modèles compatibles OpenAI pris en charge incluent les grands modèles de langage Qwen, Qwen-VL, Qwen-Coder, Qwen-Omni, Qwen-Math, DeepSeek, Kimi, GLM et MiniMax. Il précise séparément que Qwen-Audio ne prend pas en charge le protocole compatible OpenAI et doit utiliser à la place le protocole DashScope.
Cette mise en garde est importante pour le routage DeepSeek Qwen. Une famille de modèles peut se trouver à proximité dans le même catalogue ou la même console cloud tout en nécessitant un chemin de protocole différent. Si votre produit utilise des outils, le streaming, l’audio, la vision ou des entrées multimodales, le routage Qwen a besoin de tests de fumée au niveau des fonctionnalités avant tout basculement du trafic de production.
Une passerelle locale de fournisseur de LLM a besoin de vérifications d’infrastructure
La troisième erreur dans le routage régional des fournisseurs de LLM consiste à supposer qu’une passerelle locale de fournisseur se comporte comme un autre fournisseur hébergé. Ce n’est pas le cas.
La documentation de compatibilité OpenAI d’Ollama montre pourquoi. Ollama expose des Chat Completions OpenAI compatibles en local via http://localhost:11434/v1, et sa documentation décrit cette prise en charge comme initiale et expérimentale. C’est utile pour le développement local et les workflows internes contrôlés, mais cela ne doit pas être considéré comme relevant de la même classe de risque qu’une route hébergée.
Avec une passerelle de fournisseur locale, vos contrôles de routage changent :
- La charge de travail peut-elle atteindre l’hôte local ou la route du réseau privé depuis l’environnement où elle s’exécute ?
- La version du modèle est-elle figée, ou un développeur ou une mise à jour de paquet peut-il la modifier ?
- La route locale prend-elle en charge les mêmes fonctionnalités de requête que la route cloud ?
- Y a-t-il suffisamment de marge en GPU, CPU, mémoire et file d’attente pour de vraies pointes de charge ?
- La route expose-t-elle les signaux de latence, d’erreur et de saturation de la même manière que les fournisseurs hébergés ?
- Le repli vers un fournisseur cloud est-il autorisé par la politique de données du client ?
Ces contrôles sont des contrôles d’infrastructure, pas seulement des contrôles d’API. Une passerelle locale de fournisseur de LLM peut être la bonne solution pour la confidentialité, le travail hors ligne ou la maîtrise des coûts, mais uniquement lorsque le routage régional des fournisseurs de LLM traite la santé locale, la capacité, la prise en charge des fonctionnalités et la dérive des versions comme des contraintes de premier ordre.
Utilisez une matrice de vérification des fournisseurs avant de déplacer le trafic
Un déploiement durable de routage régional des fournisseurs de LLM nécessite une matrice que l’ingénierie, le produit, la sécurité et la finance peuvent tous lire.
| Classe de vérification | Route DeepSeek | Route Qwen | Route du fournisseur local |
|---|---|---|---|
| Point de terminaison | Confirmer l’URL de base officielle ou de passerelle. | Confirmer le point de terminaison régional et le domaine spécifique à l’espace de travail. | Confirmer localhost, un point de terminaison privé ou l’URL d’une passerelle locale. |
| Clé API | Confirmer l’accès au compte et au modèle. | Confirmer que la région de la clé API correspond à la région du point de terminaison. | Confirmer l’authentification locale et l’accès à l’environnement. |
| Compatibilité | Tester le format OpenAI, le format Anthropic, l’API Responses, les outils, la vision et les contrôles de réflexion uniquement lorsque cela est nécessaire. | Tester le chat compatible OpenAI ainsi que les réserves propres à la famille de modèles, en particulier pour l’audio, la vision, les outils et le streaming. | Tester la forme exacte de la requête/réponse ; supposer une compatibilité partielle tant que ce n’est pas prouvé. |
| Capacité | Suivre la concurrence du compte, le taux de 429, la latence et la durée des requêtes. | Suivre le quota régional, l’état de santé du point de terminaison, les causes des 401/403/404 et le comportement de limitation du fournisseur. | Suivre la saturation de la machine, la profondeur de la file d’attente, le temps de chargement du modèle et les redémarrages du daemon. |
| Coût | Normaliser le cache hit, le cache miss, la sortie, le pic et les économies hors pointe en coût par réponse acceptée. | Normaliser le coût des jetons ainsi que le comportement lié à la région et à l’espace de travail en coût par réponse acceptée. | Inclure le matériel, l’exploitation, le délai de file d’attente et le coût de repli vers le cloud. |
| Cycle de vie | Surveiller les alias de modèle, les noms hérités, le statut de préversion et les changements de fonctionnalités. | Surveiller les changements de point de terminaison régional, la prise en charge de la famille de modèles et les exceptions de protocole. | Surveiller la version d’exécution, les poids du modèle, la quantification et les mises à jour des packages locaux. |
| Repli | Utiliser uniquement les routes hébergées approuvées avec une classe de fonctionnalités et de politiques correspondante. | Utiliser uniquement des alternatives approuvées par la région ou par la politique. | Utiliser uniquement un second nœud local ou une route cloud approuvée après examen de la politique de données. |
Cette matrice empêche le routage DeepSeek Qwen de se réduire à un simple changement de modèle en une ligne. La route n’est éligible que lorsque sa classe de fournisseur passe les vérifications importantes pour la charge de travail.
Un arbre de décision pratique pour le routage régional des fournisseurs de LLM
Utilisez ce flux de travail chaque fois qu’une nouvelle charge de travail demande DeepSeek, Qwen ou un fournisseur local :
- Classer la charge de travail : chat, code, extraction, utilisation d’outils d’agent, vision, audio, lot ou multimodal.
- Identifier la politique de données : région autorisée, sensibilité de la rétention, contrat client et nécessité éventuelle d’un traitement local uniquement.
- Choisir les classes de fournisseurs éligibles avant les noms de modèles.
- Exécuter la vérification de la classe de fournisseur : point de terminaison, clé, compatibilité, capacité, cycle de vie et repli.
- Exécuter un test de fumée spécifique à la charge de travail à l’aide de vraies invites et de vrais parseurs.
- Acheminer une petite portion de staging ou de canari.
- Mesurer le taux de réponses acceptées, la latence p95, le taux de repli, le taux 429/401/403/404 et le coût par réponse acceptée.
- Approuver la route uniquement pour les classes de charge de travail pour lesquelles elle a réussi.
- Conserver un chemin de retour arrière jusqu’à ce que la route dispose de preuves en production.
Voici la même logique sous forme de données de politique :
regional_llm_provider_routing:
  classify:
    inputs:
      - workload_type
      - required_features
      - data_region
      - customer_policy
      - latency_budget
  provider_classes:
    deepseek:
      checks:
        - base_url_or_gateway_route
        - model_alias_lifecycle
        - required_feature_support
        - account_concurrency_headroom
        - cost_per_accepted_response
    qwen:
      checks:
        - region_endpoint
        - workspace_domain
        - api_key_region_match
        - required_feature_support
        - quota_and_error_classification
    local_gateway:
      checks:
        - host_reachability
        - model_version_pin
        - hardware_headroom
        - compatibility_smoke_test
        - approved_cloud_fallback_policy
  fallback:
    allowed_only_when:
      - same_workload_contract
      - same_data_policy
      - required_features_supported
      - retry_budget_remaining
    otherwise: manual_review
  observe:
    log:
      - route
      - provider_class
      - model
      - endpoint_region
      - status
      - latency_ms
      - input_tokens
      - output_tokens
      - cost
      - fallback_reason
C'est le cœur du routage régional des fournisseurs de LLM. Élaborez la politique une fois, puis mappez-y les modèles au fur et à mesure que les fournisseurs ajoutent, renomment ou retirent des routes.
Où Flatkey s'insère
Flatkey est utile lorsque le problème opérationnel ne se limite plus à un simple appel d'API. Le problème, ce sont des clés de fournisseurs dispersées, des catalogues de modèles, des appels d'outils, la revue de l'utilisation et la politique de repli répartis entre plusieurs équipes et agents.
La page d'accueil publique actuelle de Flatkey décrit une clé unique derrière les API officielles GPT, Claude, Gemini, DeepSeek, Qwen et GLM, ainsi que plus de 100 modèles de pointe et plus de 1 000 outils IA. Le répertoire de modèles Flatkey est conçu pour exposer la disponibilité en direct des modèles, la tarification, la prise en charge des points de terminaison et des pages de détail des modèles. La documentation montre le schéma de migration courant : conserver la forme de requête compatible OpenAI et pointer le SDK vers https://router.flatkey.ai/v1.
Pour ce sujet, le catalogue et le flux de tarification Flatkey actuels, échantillonnés le 12 septembre 2026, montraient des exemples DeepSeek et Qwen disponibles dans le groupe China LLM, notamment deepseek-v4-pro, deepseek-v4-flash, deepseek-v3.2-thinking, deepseek-v3.2, qwen3.8-max, qwen3.7-max, qwen3.7-plus, qwen3.6-max-preview et plusieurs routes Qwen 3.5. Considérez ces exemples comme un instantané de catalogue daté, et non comme une promesse permanente de disponibilité.
Le bon rôle de Flatkey dans le routage régional des fournisseurs de LLM est celui de plan de contrôle :
- Comparer les routes hébergées prises en charge dans un seul répertoire de modèles.
- Conserver une URL de base compatible OpenAI stable pour le code applicatif.
- Suivre en un seul endroit le modèle, le type de point de terminaison, l'état, l'utilisation des jetons, la latence et le coût.
- Faciliter la revue des décisions de routage par classe de fournisseur et des décisions de repli.
- Préserver des vérifications séparées pour DeepSeek, Qwen et les passerelles de fournisseurs locaux au lieu de les masquer.
Si vous utilisez déjà Flatkey, commencez par consulter le répertoire des modèles, la page de tarification et le guide de démarrage rapide de l’API Flatkey. Pour un contexte connexe au routage, associez ce guide avec le workflow d’API IA unifiée, le guide de migration vers une alternative à l’API OpenAI, le guide pratique de routage de repli multimodal et le cadre de métriques pour l’API de routage IA.
Liste de contrôle de lancement
Avant de mettre le routage régional des fournisseurs de LLM en production, confirmez les éléments suivants :
- DeepSeek, Qwen et les routes locales sont des classes de fournisseurs distinctes dans la politique de routage.
- La région du point de terminaison Qwen, le domaine de l’espace de travail et la région de la clé API sont validés avant le transfert du trafic.
- Les alias de modèles DeepSeek, la prise en charge des fonctionnalités, les unités de tarification des jetons et le comportement de concurrence sont examinés.
- Les routes locales disposent d’une accessibilité de l’hôte, d’un verrouillage de la version du modèle, d’une marge matérielle et d’une surveillance de la file d’attente.
- L’utilisation des outils, le streaming, la vision, l’audio, les contrôles de raisonnement et les sorties structurées ne sont testés que lorsque la charge de travail l’exige.
- Les routes de repli conservent le même contrat de charge de travail et la même politique de données.
- Les journaux incluent la classe de fournisseur, la région du point de terminaison, le modèle final, le statut, la latence, les jetons, le coût et la raison du repli.
- Les équipes produit et finance examinent le coût par réponse acceptée, et non seulement le prix affiché par jeton.
- Le retour arrière reste disponible jusqu’à ce que la route dispose de preuves réelles en production.
Lorsque ces vérifications sont en place, le routage régional des fournisseurs de LLM devient un modèle opérationnel reproductible au lieu d’un ensemble caché d’exceptions propres à chaque fournisseur.
FAQ
Qu’est-ce que le routage régional des fournisseurs de LLM ?
Le routage régional des fournisseurs de LLM est la couche de politique qui décide quelle classe de fournisseur doit traiter une requête IA en fonction de la région du point de terminaison, du périmètre de la clé API, de la compatibilité, de la capacité, du risque lié au cycle de vie, du coût et de la sécurité du repli.
Pourquoi le routage des API LLM chinoises nécessite-t-il des vérifications séparées ?
Le routage des API LLM chinoises nécessite des vérifications séparées car DeepSeek, Qwen et d’autres fournisseurs régionaux peuvent différer en matière de géographie du point de terminaison, de région de la clé API, de profondeur de compatibilité, de cycle de vie du modèle, de comportement des quotas et d’unités de tarification, même lorsqu’ils exposent des interfaces compatibles avec OpenAI.
Pourquoi le routage DeepSeek Qwen n’est-il pas simplement une comparaison de modèles ?
Le routage DeepSeek Qwen n’est pas qu’une simple comparaison, car DeepSeek et Qwen ont des contrats opérationnels différents. Les vérifications DeepSeek se concentrent sur les alias de modèles, la prise en charge des fonctionnalités, la tarification des jetons et la concurrence des comptes. Les vérifications Qwen se concentrent sur la région du point de terminaison, le domaine de l’espace de travail, la région de la clé API et la prise en charge du protocole de la famille de modèles.
Quand une passerelle de fournisseur LLM locale a-t-elle du sens ?
Une passerelle locale de fournisseur de LLM a du sens lorsque la confidentialité, le fonctionnement hors ligne, le contrôle du développement ou les contraintes de coût justifient l’exécution des modèles en local et que votre équipe peut prendre en charge les vérifications supplémentaires de santé, de capacité, de compatibilité et de dérive de version.
Une route compatible OpenAI peut-elle se passer de l’assurance qualité spécifique au fournisseur ?
Non. La compatibilité OpenAI peut réduire le travail d’intégration, mais chaque route nécessite toujours une assurance qualité spécifique à la charge de travail pour les outils, le streaming, les sorties structurées, les entrées multimodales, la gestion des erreurs, les champs d’utilisation, les limites de débit et le comportement de repli.
En résumé
La bonne stratégie de routage régional des fournisseurs de LLM repose moins sur un point de terminaison universel que sur des vérifications disciplinées des fournisseurs. C’est particulièrement vrai lorsque le routage d’API de LLM chinois inclut à la fois DeepSeek et Qwen, et lorsqu’une passerelle locale de fournisseur côtoie des routes hébergées pour des flux de travail axés sur la confidentialité, le hors ligne ou la maîtrise des coûts.
Considérez d’abord le routage DeepSeek Qwen comme un problème de politique fournisseur. Validez ensuite la preuve du point de terminaison en direct, de la clé, de la compatibilité, de la capacité, du cycle de vie et des coûts avant de déplacer le trafic de production.
Flatkey est utile lorsque vous voulez une seule clé, un seul catalogue de modèles, une seule URL de base compatible OpenAI et une seule interface d’utilisation pour les routes hébergées prises en charge. Utilisez la passerelle pour centraliser les opérations, mais conservez les vérifications distinctes des fournisseurs qui rendent le routage régional sûr.


