
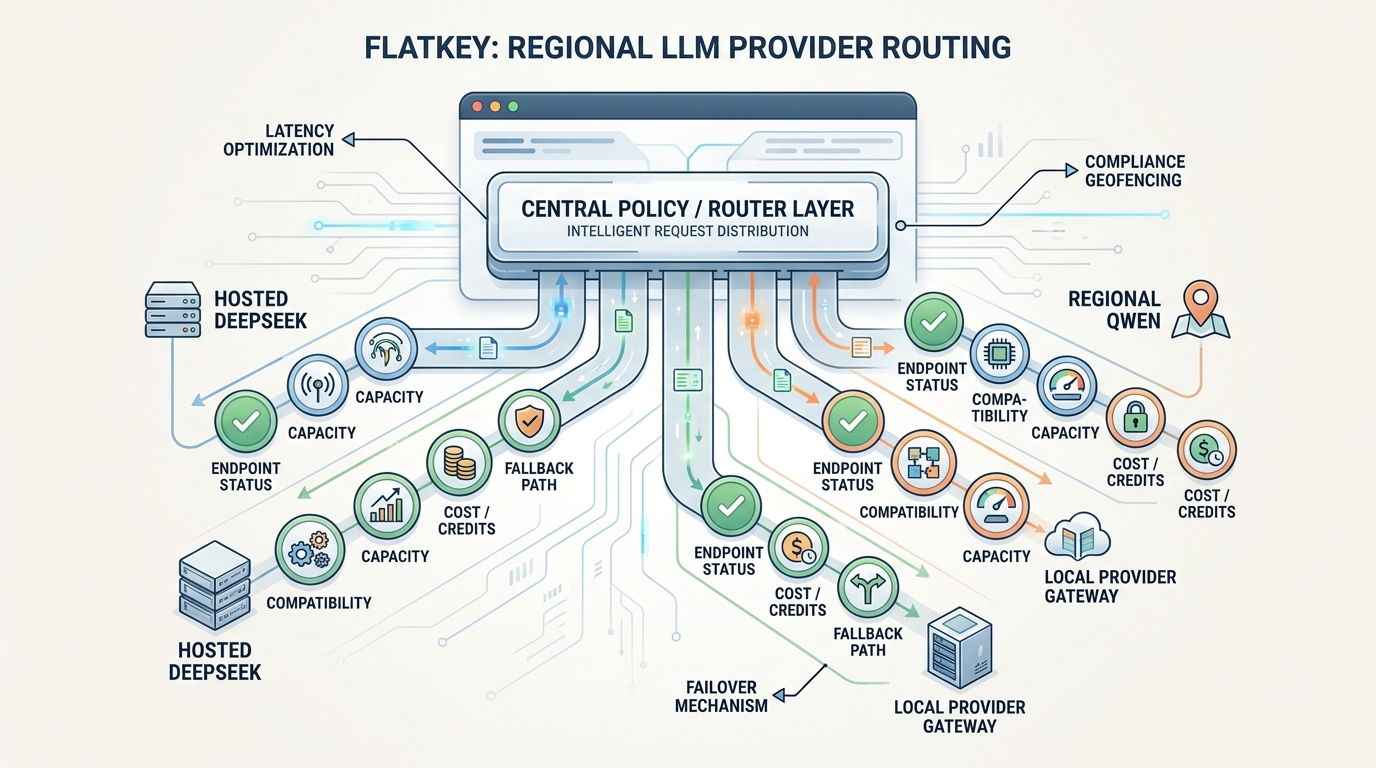
Nếu bạn đang lập kế hoạch cho định tuyến nhà cung cấp LLM theo khu vực, phần rủi ro không nằm ở việc tìm thêm một endpoint tương thích OpenAI. Phần rủi ro là quyết định khi nào một tuyến DeepSeek có thể được xem như một nhà cung cấp đám mây được lưu trữ, khi nào một tuyến Qwen cần các kiểm tra endpoint ràng buộc theo khu vực, và khi nào một nhà cung cấp nội bộ cần các kiểm tra hạ tầng trước khi có thể nhận lưu lượng production.
Đó là lý do định tuyến nhà cung cấp LLM theo khu vực nên bắt đầu từ lớp nhà cung cấp, chứ không phải ngôn ngữ xếp hạng mô hình. DeepSeek, Qwen và các runtime nội bộ đều có thể trông quen thuộc ở lớp SDK, nhưng chúng không chia sẻ cùng một hợp đồng khu vực, rủi ro vòng đời, tín hiệu năng lực hay quy tắc an toàn fallback.
Hướng dẫn này cung cấp cho các nhóm sản phẩm AI một chính sách thực tiễn cho định tuyến nhà cung cấp LLM theo khu vực trên DeepSeek, Qwen và các cổng nhà cung cấp nội bộ. Hãy dùng nó trước khi bạn chuyển lưu lượng production, thêm fallback, hoặc chuẩn hóa một AI gateway dùng chung giữa các nhóm.
Câu trả lời ngắn
Một chính sách định tuyến nhà cung cấp LLM theo khu vực an toàn hơn sẽ tách các tuyến thành ba lớp nhà cung cấp trước khi so sánh tên mô hình:
| Lớp nhà cung cấp | Các kiểm tra đầu tiên | Tại sao cần một chính sách riêng |
|---|---|---|
| DeepSeek | Định dạng API, bí danh mô hình, hỗ trợ tính năng, đơn vị giá token, giới hạn đồng thời | DeepSeek cung cấp các đường dẫn tương thích OpenAI và Anthropic, nhưng độ an toàn của tuyến vẫn phụ thuộc vào vòng đời mô hình, chế độ định giá và năng lực ở cấp tài khoản. |
| Qwen / Alibaba Cloud Model Studio | Endpoint khu vực, miền workspace, API key ràng buộc theo khu vực, các lưu ý về tính năng tương thích OpenAI | Định tuyến Qwen được thiết kế theo khu vực; endpoint, workspace ID và khu vực của API key có thể là một phần quyết định một lời gọi có hoạt động hay không. |
| Cổng nhà cung cấp nội bộ | Khả năng truy cập host, ghim mô hình, dư địa phần cứng cục bộ, các khoảng trống tương thích, cô lập fallback | Một tuyến nội bộ thất bại như hạ tầng bạn vận hành, chứ không như một tài khoản API được lưu trữ. |
Flatkey phù hợp với quy trình này như một lớp gateway dùng chung: một key, một danh mục mô hình, một bề mặt tuyến tương thích OpenAI, và một chế độ xem sử dụng cho các mô hình và công cụ được hỗ trợ. Nhưng một gateway không nên xóa bỏ các kiểm tra riêng theo nhà cung cấp. Nó nên làm cho các kiểm tra đó trở nên rõ ràng, có thể quan sát và dễ rà soát hơn.
Định tuyến nhà cung cấp LLM theo khu vực thực sự đang tối ưu điều gì
Định tuyến nhà cung cấp LLM theo khu vực tốt không chỉ hỏi mô hình nào đạt điểm cao nhất trên một benchmark. Nó hỏi lớp nhà cung cấp nào có thể an toàn chịu trách nhiệm cho một yêu cầu dưới chính sách sản phẩm, khu vực và fallback hiện tại.
Trong production, định tuyến nhà cung cấp LLM theo khu vực thường cân bằng đồng thời sáu yếu tố:
- Vị trí địa lý của endpoint: một số nhà cung cấp công khai các base URL khác nhau theo khu vực, và điều đó có thể thay đổi độ trễ, thiết lập tài khoản, rà soát cư trú dữ liệu và thiết kế chuyển đổi dự phòng.
- Độ sâu tương thích: tính tương thích với OpenAI có thể bao phủ chat completions nhưng vẫn khác nhau ở tools, streaming, vision, audio, điều khiển suy luận hoặc các trường usage.
- Độ ổn định vòng đời: bí danh mô hình, mô hình xem trước, tuyến đã ngừng hỗ trợ và các lớp tương thích có thể thay đổi request ngay cả khi lệnh gọi SDK vẫn thành công.
- Mô hình năng lực: độ đồng thời ở cấp tài khoản khác với giới hạn tốc độ, và cả hai đều khác với nút thắt cổ chai GPU hoặc CPU cục bộ.
- An toàn khi dự phòng: một tuyến sao lưu chỉ hữu ích nếu nó giữ nguyên cùng khu vực, tính năng, dữ liệu và cam kết chất lượng.
- Tính minh bạch chi phí: các nhóm cần so sánh chi phí trên mỗi phản hồi được chấp nhận, không chỉ giá token niêm yết.
Đó mới là công việc thực sự của định tuyến nhà cung cấp LLM theo khu vực. Đây không phải là một lớp trừu tượng endpoint универсал duy nhất. Đây là một chính sách kiểm tra nhà cung cấp quyết định tuyến nào đủ điều kiện cho khối lượng công việc nào.
Bắt đầu định tuyến API LLM Trung Quốc bằng cách tách các lớp nhà cung cấp
Sai lầm đầu tiên trong định tuyến API LLM Trung Quốc là coi mọi tuyến liên quan đến Trung Quốc hoặc được lưu trữ ở châu Á như một nhóm duy nhất. Điều đó làm mờ quá nhiều khác biệt vận hành.
DeepSeek và Qwen đều quan trọng đối với định tuyến API LLM Trung Quốc, nhưng các kiểm tra định tuyến của chúng không giống nhau. Tài liệu API công khai của DeepSeek nhấn mạnh quyền truy cập tương thích OpenAI và Anthropic với các tên mô hình cụ thể và độ đồng thời ở cấp tài khoản. Tài liệu Qwen của Alibaba Cloud Model Studio nhấn mạnh quyền truy cập tương thích OpenAI thông qua các endpoint theo khu vực, các domain theo workspace và các khóa API được ràng buộc với khu vực nơi chúng được tạo ra.
Hãy dùng cách phân tách này trước khi bạn định tuyến lưu lượng:
| Câu hỏi định tuyến | DeepSeek | Qwen / Model Studio | Cổng nhà cung cấp nội bộ |
|---|---|---|---|
| Điểm cuối có theo khu vực không? | Xác thực URL gốc chính thức và mọi tuyến cổng trung gian. | Xác thực chính xác điểm cuối theo khu vực và tên miền cụ thể theo workspace. | Xác thực host, mạng riêng hoặc địa chỉ runtime cục bộ. |
| API key có bị ràng buộc theo khu vực không? | Kiểm tra quyền truy cập tài khoản và mô hình. | Kiểm tra rằng API key đã được tạo ở cùng khu vực với điểm cuối. | Kiểm tra xác thực cục bộ, quyền truy cập mạng và quyền của máy. |
| Tính tương thích đã đủ hoàn chỉnh chưa? | Kiểm tra chat, tools, reasoning, định dạng Anthropic và Responses API chỉ khi khối lượng công việc của bạn sử dụng chúng. | Kiểm tra chat, tools, streaming, hỗ trợ multimodal và các lưu ý theo họ mô hình đối với mô hình đã chọn. | Coi khả năng tương thích là một phần cho đến khi các kiểm tra smoke của riêng bạn vượt qua. |
| Tín hiệu năng lực là gì? | Đồng thời ở cấp tài khoản và hành vi 429. | Khu vực, workspace, hạn ngạch, tình trạng điểm cuối và giới hạn của nhà cung cấp. | Dư địa GPU/CPU/RAM, tình trạng daemon, độ sâu hàng đợi và thời gian tải mô hình. |
| Được phép phương án dự phòng nào? | Một tuyến hosted có cùng lớp tính năng và chính sách. | Một tuyến khác đã được phê duyệt trong cùng chính sách khu vực, hoặc một phương án dự phòng hosted đã được phê duyệt. | Một node cục bộ thứ hai hoặc một tuyến cloud đã được phê duyệt trước với việc rà soát chính sách dữ liệu rõ ràng. |
Nếu bạn bỏ qua sự tách biệt này, định tuyến nhà cung cấp LLM theo khu vực sẽ trở thành phỏng đoán. Cùng một khối lượng công việc có thể di chuyển giữa ba lớp nhà cung cấp rất khác nhau mà không ai có thể giải thích những kiểm tra nào đã được áp dụng.
DeepSeek Cần Các Kiểm Tra Riêng Ngay Cả Khi SDK Trông Có Vẻ Quen Thuộc
Tài liệu chính thức của DeepSeek giúp việc di chuyển trở nên dễ tiếp cận: API sử dụng định dạng tương thích với OpenAI và Anthropic, với https://api.deepseek.com cho các cuộc gọi theo định dạng OpenAI và https://api.deepseek.com/anthropic cho các cuộc gọi theo định dạng Anthropic. Khả năng tương thích đó hữu ích, nhưng không loại bỏ nhu cầu kiểm tra riêng cho DeepSeek.
Đối với định tuyến DeepSeek Qwen, DeepSeek nên được kiểm tra riêng vì bốn lý do.
Thứ nhất, các bí danh mô hình và ghi chú vòng đời ảnh hưởng đến an toàn tuyến. Tính đến ngày 12 tháng 9 năm 2026, tài liệu của DeepSeek liệt kê deepseek-flash và deepseek-v4-pro là tên mô hình hiện tại. Tài liệu cũng lưu ý rằng các tên cũ deepseek-v4-flash và deepseek-v4-flash-vision-exp vẫn được chấp nhận, nhưng các yêu cầu sẽ được phục vụ bởi mô hình Flash mới hơn và tính phí theo giá Flash. Đó chính là loại chi tiết vòng đời mà một bộ định tuyến nên hiển thị thay vì che giấu.
Thứ hai, hỗ trợ tính năng phụ thuộc vào từng mô hình. Bảng giá của DeepSeek liệt kê đầu ra JSON, lệnh gọi tool, Responses API, Anthropic API, beta chat prefix completion, beta FIM và hỗ trợ vision theo từng mô hình. Điều đó có nghĩa là chính sách định tuyến nhà cung cấp LLM theo khu vực của bạn nên chỉ kiểm tra các tính năng mà khối lượng công việc thực sự sử dụng và không nên giả định mọi tuyến DeepSeek đều có thể thay thế cho nhau.
Thứ ba, giá cả là bản địa của nhà cung cấp. DeepSeek công bố giá theo đơn vị 1M token và tách riêng mức giá cho cache hit, cache miss, đầu ra, giờ cao điểm và giờ thấp điểm. Các nhóm sản phẩm không cần hardcode mọi mức giá vào logic định tuyến, nhưng họ cần bộ định tuyến ghi lại đủ mức sử dụng để so sánh DeepSeek với Qwen, GPT, Claude, Gemini hoặc các tuyến nội bộ theo chi phí trên mỗi phản hồi được chấp nhận.
Thứ tư, dung lượng là ở cấp tài khoản. Trang giới hạn tốc độ của DeepSeek cho biết giới hạn đồng thời được tính ở cấp tài khoản bất kể API key, và các yêu cầu vượt quá giới hạn đồng thời sẽ trả về HTTP 429. Vì vậy, các kiểm tra sức khỏe cho định tuyến nhà cung cấp LLM theo khu vực cần bao gồm cả biên độ dự phòng đồng thời, chứ không chỉ là việc một yêu cầu thử nhỏ trả về 200.
Bài học rất đơn giản: đừng bắt đầu định tuyến DeepSeek Qwen từ câu "cả hai đều tương thích OpenAI." Hãy bắt đầu từ các kiểm tra vòng đời, tính năng, giá và dung lượng đặc thù của nhà cung cấp để quyết định một tuyến có an toàn cho khối lượng công việc hay không.
Qwen Cần Các Kiểm Tra Riêng Vì Khu Vực Là Một Phần Của Hợp Đồng API
Tài liệu Qwen của Alibaba Cloud Model Studio là một ví dụ điển hình cho thấy tại sao định tuyến API LLM Trung Quốc cần các kiểm tra theo khu vực. Hướng dẫn tương thích OpenAI cho biết các mô hình Qwen trên Model Studio hỗ trợ giao diện tương thích OpenAI và rằng các nhóm có thể di chuyển mã OpenAI hiện có bằng cách thay đổi API key, base URL và tên mô hình.
Nhưng cùng hướng dẫn đó cũng nêu rõ hợp đồng khu vực. Nó liệt kê các base URL khác nhau cho Singapore, Virginia, Bắc Kinh, Hồng Kông và Nhật Bản. Nó cũng cho biết Model Studio đã giới thiệu các tên miền riêng theo workspace cho Bắc Kinh, Singapore và Hồng Kông, và rằng {WorkspaceId} nên được thay bằng ID workspace thực tế.
Điều đó có nghĩa là định tuyến nhà cung cấp LLM theo khu vực cho Qwen không chỉ là "chọn một tên mô hình." Nó phải kiểm tra:
- endpoint khu vực nào mà khối lượng công việc được phép gọi
- liệu tên miền theo workspace có bắt buộc hay không
- API key có được tạo ở cùng khu vực với endpoint hay không
- việc lệch khu vực có trả về lỗi xác thực hay không
- mô hình Qwen hoặc bên thứ ba được chọn có hỗ trợ chính xác các tính năng giao thức mà khối lượng công việc sử dụng hay không
Hướng dẫn tương thích Qwen cũng nêu rằng các mô hình tương thích OpenAI được hỗ trợ bao gồm các mô hình ngôn ngữ lớn Qwen, Qwen-VL, Qwen-Coder, Qwen-Omni, Qwen-Math, DeepSeek, Kimi, GLM và MiniMax. Tài liệu này cũng ghi riêng rằng Qwen-Audio không hỗ trợ giao thức tương thích OpenAI và nên sử dụng giao thức DashScope thay thế.
Lưu ý đó rất quan trọng đối với định tuyến DeepSeek Qwen. Một họ mô hình có thể nằm gần cùng danh mục hoặc cùng bảng điều khiển đám mây nhưng vẫn cần một đường giao thức khác. Nếu sản phẩm của bạn dùng tool, streaming, audio, vision hoặc đầu vào đa phương thức, định tuyến Qwen cần các kiểm tra khói ở cấp tính năng trước khi chuyển lưu lượng sản xuất.
Một Cổng Nhà Cung Cấp LLM Nội Bộ Cần Các Kiểm Tra Hạ Tầng
Sai lầm thứ ba trong định tuyến nhà cung cấp LLM theo khu vực là cho rằng một cổng nhà cung cấp nội bộ hoạt động giống như một nhà cung cấp được lưu trữ khác. Không phải vậy.
Tài liệu tương thích OpenAI của Ollama cho thấy vì sao. Ollama cung cấp Chat Completions tương thích OpenAI cục bộ thông qua http://localhost:11434/v1, và tài liệu của họ mô tả hỗ trợ này là ban đầu và thử nghiệm. Điều đó hữu ích cho phát triển cục bộ và các luồng công việc nội bộ có kiểm soát, nhưng không nên được coi là cùng một mức rủi ro như một tuyến lưu trữ trên đám mây.
Với một cổng nhà cung cấp cục bộ, các kiểm tra định tuyến của bạn sẽ thay đổi:
- Khối lượng công việc có thể truy cập host cục bộ hoặc tuyến mạng riêng từ môi trường đang chạy hay không?
- Phiên bản mô hình có được ghim cố định hay một nhà phát triển hoặc bản cập nhật gói có thể thay đổi nó?
- Tuyến cục bộ có hỗ trợ các tính năng yêu cầu giống như tuyến đám mây hay không?
- Có đủ GPU, CPU, bộ nhớ và khoảng trống hàng đợi cho các đợt tăng đột biến thực tế hay không?
- Tuyến có hiển thị các tín hiệu độ trễ, lỗi và bão hòa theo cùng cách như các nhà cung cấp lưu trữ hay không?
- Việc chuyển sang nhà cung cấp đám mây dự phòng có được phép theo chính sách dữ liệu của khách hàng hay không?
Những kiểm tra đó là kiểm tra hạ tầng, không chỉ kiểm tra API. Một cổng nhà cung cấp LLM cục bộ có thể là câu trả lời phù hợp cho quyền riêng tư, công việc ngoại tuyến hoặc kiểm soát chi phí, nhưng chỉ khi định tuyến nhà cung cấp LLM theo khu vực xem sức khỏe cục bộ, năng lực, hỗ trợ tính năng và độ lệch phiên bản như các ràng buộc hàng đầu.
Hãy dùng ma trận kiểm tra nhà cung cấp trước khi bạn chuyển lưu lượng
Một triển khai định tuyến nhà cung cấp LLM theo khu vực bền vững cần một ma trận mà kỹ thuật, sản phẩm, bảo mật và tài chính đều có thể đọc được.
| Loại kiểm tra | Tuyến DeepSeek | Tuyến Qwen | Tuyến nhà cung cấp nội bộ |
|---|---|---|---|
| Điểm cuối | Xác nhận URL cơ sở chính thức hoặc của cổng gateway. | Xác nhận điểm cuối khu vực và miền dành riêng cho workspace. | Xác nhận localhost, điểm cuối riêng tư hoặc URL cổng gateway nội bộ. |
| API key | Xác nhận quyền truy cập tài khoản và model. | Xác nhận khu vực của API key khớp với khu vực của điểm cuối. | Xác nhận xác thực cục bộ và quyền truy cập môi trường. |
| Tính tương thích | Kiểm tra định dạng OpenAI, định dạng Anthropic, Responses API, tools, vision và điều khiển thinking chỉ khi cần. | Kiểm tra chat tương thích OpenAI cùng các lưu ý theo họ model, đặc biệt là audio, vision, tools và streaming. | Kiểm tra đúng cấu trúc request/response; giả định chỉ tương thích một phần cho đến khi được chứng minh. |
| Năng lực | Theo dõi concurrency của tài khoản, tỷ lệ 429, độ trễ và thời lượng request. | Theo dõi quota theo khu vực, tình trạng khỏe của điểm cuối, nguyên nhân 401/403/404 và hành vi giới hạn của nhà cung cấp. | Theo dõi mức bão hòa của máy, độ sâu hàng đợi, thời gian tải model và việc khởi động lại daemon. |
| Chi phí | Chuẩn hóa kinh tế của cache hit, cache miss, output, giờ cao điểm và thấp điểm thành chi phí trên mỗi phản hồi được chấp nhận. | Chuẩn hóa chi phí token cộng với hành vi theo khu vực/workspace thành chi phí trên mỗi phản hồi được chấp nhận. | Tính cả phần cứng, vận hành, độ trễ hàng đợi và chi phí dự phòng trên cloud. |
| Vòng đời | Theo dõi alias model, tên cũ, trạng thái preview và các thay đổi tính năng. | Theo dõi thay đổi điểm cuối theo khu vực, hỗ trợ theo họ model và các ngoại lệ giao thức. | Theo dõi phiên bản runtime, trọng số model, quantization và các cập nhật gói cục bộ. |
| Dự phòng | Chỉ dùng các tuyến hosted đã được phê duyệt với class tính năng và chính sách tương ứng. | Chỉ dùng các phương án thay thế được phê duyệt theo khu vực hoặc theo chính sách. | Chỉ dùng một node cục bộ thứ hai hoặc tuyến cloud đã được phê duyệt sau khi rà soát chính sách dữ liệu. |
Ma trận này giúp định tuyến DeepSeek Qwen không biến thành một lần chuyển model chỉ bằng một dòng. Tuyến chỉ đủ điều kiện khi class nhà cung cấp của nó vượt qua các kiểm tra quan trọng đối với khối lượng công việc.
Một cây quyết định thực tế cho định tuyến nhà cung cấp LLM theo khu vực
Hãy dùng quy trình này bất cứ khi nào một workload mới yêu cầu DeepSeek, Qwen hoặc một nhà cung cấp nội bộ:
- Phân loại workload: chat, code, trích xuất, sử dụng công cụ tác tử, vision, audio, batch hoặc multimodal.
- Xác định chính sách dữ liệu: khu vực được phép, mức nhạy cảm của dữ liệu lưu giữ, hợp đồng khách hàng và liệu có yêu cầu xử lý chỉ nội bộ hay không.
- Chọn các class nhà cung cấp đủ điều kiện trước khi chọn tên model.
- Chạy kiểm tra theo class nhà cung cấp: điểm cuối, key, tính tương thích, năng lực, vòng đời và dự phòng.
- Chạy smoke test đặc thù theo workload bằng prompt và parser thực tế.
- Định tuyến một phần nhỏ ở staging hoặc canary.
- Đo tỷ lệ phản hồi được chấp nhận, độ trễ p95, tỷ lệ fallback, tỷ lệ 429/401/403/404 và chi phí trên mỗi phản hồi được chấp nhận.
- Chỉ phê duyệt tuyến cho các class workload mà nó đã vượt qua.
- Duy trì đường rollback cho đến khi tuyến có bằng chứng từ production.
Đây là logic tương tự dưới dạng dữ liệu chính sách:
regional_llm_provider_routing:
  classify:
    inputs:
      - workload_type
      - required_features
      - data_region
      - customer_policy
      - latency_budget
  provider_classes:
    deepseek:
      checks:
        - base_url_or_gateway_route
        - model_alias_lifecycle
        - required_feature_support
        - account_concurrency_headroom
        - cost_per_accepted_response
    qwen:
      checks:
        - region_endpoint
        - workspace_domain
        - api_key_region_match
        - required_feature_support
        - quota_and_error_classification
    local_gateway:
      checks:
        - host_reachability
        - model_version_pin
        - hardware_headroom
        - compatibility_smoke_test
        - approved_cloud_fallback_policy
  fallback:
    allowed_only_when:
      - same_workload_contract
      - same_data_policy
      - required_features_supported
      - retry_budget_remaining
    otherwise: manual_review
  observe:
    log:
      - route
      - provider_class
      - model
      - endpoint_region
      - status
      - latency_ms
      - input_tokens
      - output_tokens
      - cost
      - fallback_reason
Đây là phần cốt lõi của định tuyến nhà cung cấp LLM theo khu vực. Xây dựng chính sách một lần, rồi ánh xạ các model vào đó khi các nhà cung cấp thêm, đổi tên hoặc ngừng các tuyến.
Flatkey phù hợp ở đâu
Flatkey hữu ích khi vấn đề vận hành không còn chỉ là một lần gọi API. Vấn đề là các khóa nhà cung cấp, danh mục model, lệnh gọi công cụ, rà soát mức sử dụng và chính sách dự phòng bị phân tán giữa các nhóm và tác nhân.
Trang chủ công khai hiện tại của Flatkey mô tả một khóa đứng sau các API chính thức của GPT, Claude, Gemini, DeepSeek, Qwen và GLM, cùng hơn 100 model tiên phong và hơn 1.000 công cụ AI. Danh mục model của Flatkey được thiết kế để hiển thị khả dụng model theo thời gian thực, giá, hỗ trợ endpoint và các trang chi tiết model. Tài liệu cho thấy mẫu di chuyển phổ biến: giữ nguyên định dạng yêu cầu tương thích OpenAI của bạn và trỏ SDK tới https://router.flatkey.ai/v1.
Với chủ đề này, danh mục Flatkey và nguồn cấp giá hiện tại được lấy mẫu vào ngày 12 tháng 9 năm 2026 cho thấy các ví dụ DeepSeek và Qwen khả dụng trong nhóm China LLM, bao gồm deepseek-v4-pro, deepseek-v4-flash, deepseek-v3.2-thinking, deepseek-v3.2, qwen3.8-max, qwen3.7-max, qwen3.7-plus, qwen3.6-max-preview, và nhiều tuyến Qwen 3.5. Hãy xem các ví dụ đó như một ảnh chụp danh mục tại thời điểm nhất định, không phải một cam kết về khả dụng vĩnh viễn.
Vai trò đúng của Flatkey trong định tuyến nhà cung cấp LLM theo khu vực là lớp điều khiển:
- So sánh các tuyến được hỗ trợ, được lưu trữ trong một danh mục model duy nhất.
- Duy trì một base URL tương thích OpenAI ổn định cho mã ứng dụng.
- Theo dõi model, loại endpoint, trạng thái, mức dùng token, độ trễ và chi phí ở một nơi.
- Làm cho các quyết định định tuyến theo lớp nhà cung cấp và dự phòng dễ xem xét hơn.
- Giữ các kiểm tra riêng cho DeepSeek, Qwen và các cổng nhà cung cấp nội bộ thay vì che giấu chúng đi.
Nếu bạn đã sử dụng Flatkey, hãy bắt đầu bằng cách xem danh mục mô hình, trang giá, và hướng dẫn bắt đầu nhanh Flatkey API. Để có bối cảnh liên quan đến định tuyến, hãy ghép hướng dẫn này với quy trình làm việc AI API hợp nhất, hướng dẫn chuyển đổi sang lựa chọn thay thế OpenAI API, sổ tay định tuyến dự phòng đa phương thức, và khung chỉ số API định tuyến AI.
Danh sách kiểm tra khi ra mắt
Trước khi đưa định tuyến nhà cung cấp LLM theo khu vực vào sản xuất, hãy xác nhận các mục sau:
- DeepSeek, Qwen và các tuyến cục bộ là các lớp nhà cung cấp riêng biệt trong chính sách định tuyến.
- Khu vực endpoint của Qwen, miền workspace và khu vực API key được xác thực trước khi lưu lượng chuyển sang.
- Các bí danh mô hình DeepSeek, hỗ trợ tính năng, đơn vị định giá token và hành vi đồng thời được rà soát.
- Các tuyến cục bộ có khả năng truy cập host, ghim phiên bản mô hình, dư địa phần cứng và giám sát hàng đợi.
- Việc sử dụng công cụ, streaming, vision, audio, điều khiển reasoning và đầu ra có cấu trúc chỉ được kiểm tra ở những nơi khối lượng công việc thực sự cần chúng.
- Các tuyến dự phòng giữ nguyên cùng một hợp đồng khối lượng công việc và chính sách dữ liệu.
- Log bao gồm lớp nhà cung cấp, khu vực endpoint, mô hình cuối cùng, trạng thái, độ trễ, token, chi phí và lý do dự phòng.
- Product và finance xem xét chi phí trên mỗi phản hồi được chấp nhận, không chỉ giá token niêm yết.
- Rollback vẫn khả dụng cho đến khi tuyến có bằng chứng thực tế từ sản xuất.
Khi những kiểm tra đó đã sẵn sàng, định tuyến nhà cung cấp LLM theo khu vực trở thành một mô hình vận hành có thể lặp lại thay vì một tập hợp ẩn các ngoại lệ của nhà cung cấp.
Câu hỏi thường gặp
Định tuyến nhà cung cấp LLM theo khu vực là gì?
Định tuyến nhà cung cấp LLM theo khu vực là lớp chính sách quyết định lớp nhà cung cấp nào nên xử lý một yêu cầu AI dựa trên khu vực endpoint, phạm vi API key, khả năng tương thích, dung lượng, rủi ro vòng đời, chi phí và an toàn khi dự phòng.
Tại sao định tuyến API LLM Trung Quốc cần các kiểm tra riêng?
Định tuyến API LLM Trung Quốc cần các kiểm tra riêng vì DeepSeek, Qwen và các nhà cung cấp theo khu vực khác có thể khác nhau về địa lý endpoint, khu vực API key, độ sâu tương thích, vòng đời mô hình, hành vi hạn ngạch và đơn vị định giá, ngay cả khi chúng cung cấp giao diện tương thích OpenAI.
Tại sao định tuyến DeepSeek Qwen không chỉ là một so sánh mô hình?
Định tuyến DeepSeek Qwen không chỉ là một so sánh vì DeepSeek và Qwen có các hợp đồng vận hành khác nhau. Các kiểm tra DeepSeek tập trung vào bí danh mô hình, hỗ trợ tính năng, định giá token và đồng thời của tài khoản. Các kiểm tra Qwen tập trung vào endpoint khu vực, miền workspace, khu vực API key và hỗ trợ giao thức của họ mô hình.
Khi nào một cổng nhà cung cấp LLM nội bộ là hợp lý?
Một cổng nhà cung cấp LLM nội bộ hợp lý khi quyền riêng tư, vận hành ngoại tuyến, kiểm soát phát triển hoặc ràng buộc chi phí biện minh cho việc chạy mô hình tại chỗ và đội ngũ của bạn có thể tự đảm nhiệm các kiểm tra bổ sung về tình trạng hoạt động, năng lực, khả năng tương thích và độ lệch phiên bản.
Một route tương thích OpenAI có thể bỏ qua QA riêng theo từng nhà cung cấp không?
Không. Khả năng tương thích OpenAI có thể giảm khối lượng tích hợp, nhưng mỗi route vẫn cần QA theo từng khối lượng công việc cho công cụ, streaming, đầu ra có cấu trúc, đầu vào đa phương thức, xử lý lỗi, các trường sử dụng, giới hạn tốc độ và hành vi dự phòng.
Kết luận
Chiến lược định tuyến nhà cung cấp LLM theo khu vực phù hợp không phải là về một điểm cuối phổ quát, mà là về các kiểm tra nhà cung cấp có kỷ luật. Điều đó đặc biệt đúng khi định tuyến API LLM Trung Quốc bao gồm cả DeepSeek và Qwen, và khi một cổng nhà cung cấp nội bộ nằm bên cạnh các route được lưu trữ cho các quy trình làm việc về quyền riêng tư, ngoại tuyến hoặc kiểm soát chi phí.
Hãy xem định tuyến DeepSeek Qwen trước hết là một vấn đề về chính sách nhà cung cấp. Sau đó xác thực bằng chứng thực tế về endpoint trực tiếp, khóa, khả năng tương thích, năng lực, vòng đời và chi phí trước khi bạn chuyển lưu lượng sản xuất.
Flatkey hữu ích khi bạn muốn một khóa, một danh mục mô hình, một base URL tương thích OpenAI và một bề mặt sử dụng cho các route được lưu trữ được hỗ trợ. Hãy dùng gateway để tập trung hóa vận hành, nhưng vẫn giữ các kiểm tra riêng theo từng nhà cung cấp giúp định tuyến theo khu vực an toàn.


