
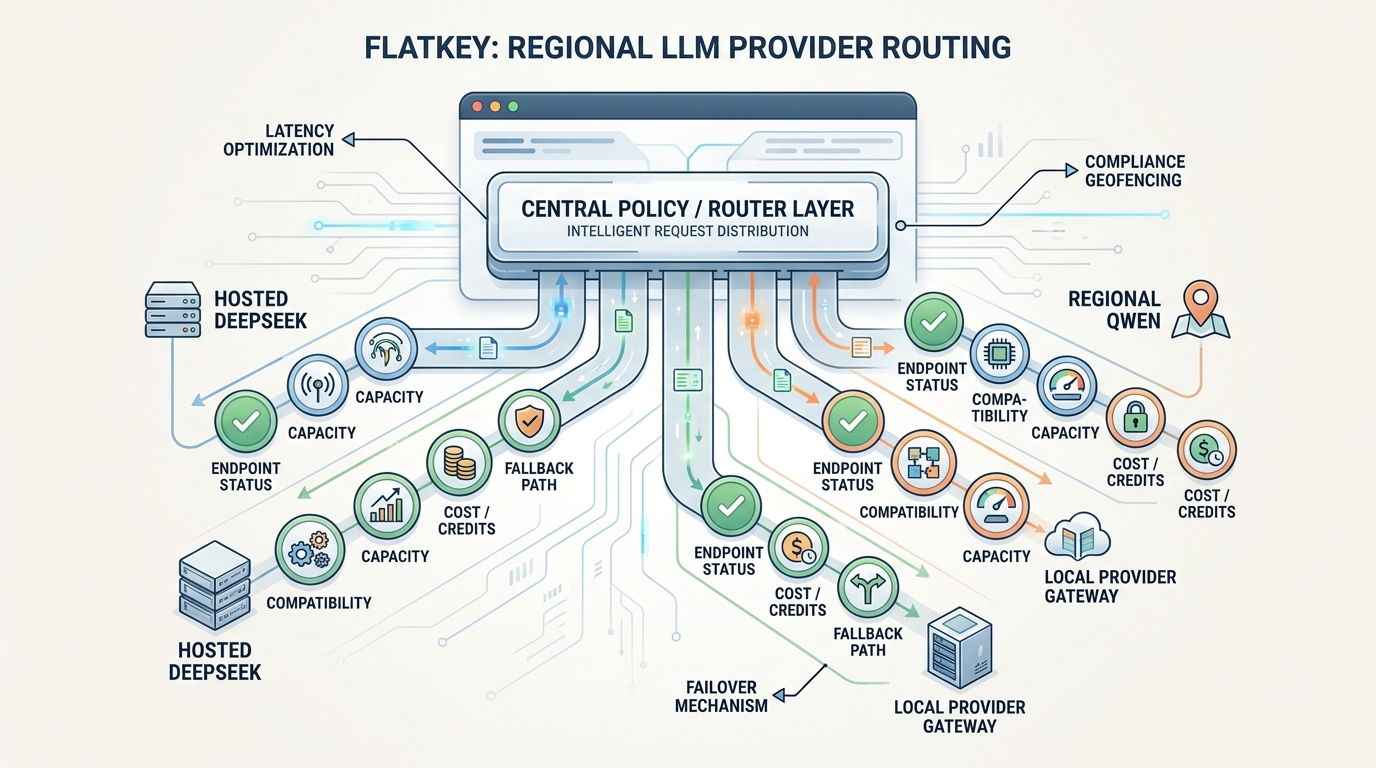
Si estás planeando un enrutamiento regional de proveedores LLM, la parte arriesgada no es encontrar otro endpoint compatible con OpenAI. La parte arriesgada es decidir cuándo una ruta de DeepSeek puede tratarse como un proveedor en la nube alojado, cuándo una ruta de Qwen necesita comprobaciones de endpoint vinculadas a la región y cuándo un proveedor local necesita comprobaciones de infraestructura antes de poder recibir tráfico de producción.
Por eso el enrutamiento regional de proveedores LLM debe comenzar por la clase de proveedor, no por el lenguaje del ranking de modelos. DeepSeek, Qwen y los runtimes locales pueden parecer similares en la capa del SDK, pero no comparten el mismo contrato de región, riesgo de ciclo de vida, señal de capacidad ni reglas de seguridad de fallback.
Esta guía ofrece a los equipos de producto de IA una política práctica para el enrutamiento regional de proveedores LLM en DeepSeek, Qwen y gateways de proveedores locales. Úsala antes de mover tráfico de producción, añadir fallback o estandarizar un gateway de IA compartido entre equipos.
La respuesta rápida
Una política más segura de enrutamiento regional de proveedores LLM separa las rutas en tres clases de proveedor antes de comparar nombres de modelos:
| Clase de proveedor | Primeras comprobaciones | Por qué necesita una política separada |
|---|---|---|
| DeepSeek | Formato de API, alias del modelo, compatibilidad de funciones, unidad de precios por token, límite de concurrencia | DeepSeek expone rutas compatibles con OpenAI y Anthropic, pero la seguridad de la ruta sigue dependiendo del ciclo de vida del modelo, el modo de precios y la capacidad a nivel de cuenta. |
| Qwen / Alibaba Cloud Model Studio | Endpoint de región, dominio del espacio de trabajo, clave API vinculada a la región, advertencias sobre funciones compatibles con OpenAI | El enrutamiento de Qwen es regional por diseño; el endpoint, el ID del espacio de trabajo y la región de la clave API pueden formar parte de que una llamada funcione. |
| Gateway de proveedor local | Accesibilidad del host, fijación del modelo, margen de hardware local, brechas de compatibilidad, aislamiento del fallback | Una ruta local falla como una infraestructura que operas, no como una cuenta de API alojada. |
Flatkey encaja en este flujo de trabajo como la capa de gateway compartida: una clave, un catálogo de modelos, una superficie de ruta compatible con OpenAI y una vista de uso para los modelos y herramientas compatibles. Pero un gateway no debe borrar las comprobaciones específicas del proveedor. Debe hacer que esas comprobaciones sean explícitas, observables y más fáciles de revisar.
Qué optimiza realmente el enrutamiento regional de proveedores LLM
Un buen enrutamiento regional de proveedores LLM no pregunta solo qué modelo obtiene la mejor puntuación en un benchmark. Pregunta qué clase de proveedor puede asumir con seguridad una solicitud bajo la política actual de producto, región y fallback.
En producción, el enrutamiento regional de proveedores LLM suele equilibrar seis cosas a la vez:
- Geografía del endpoint: algunos proveedores exponen distintas URL base por región, y eso puede cambiar la latencia, la configuración de la cuenta, la revisión de residencia y el diseño de failover.
- Profundidad de compatibilidad: la compatibilidad con OpenAI puede cubrir completions de chat y aun así diferir en herramientas, streaming, visión, audio, controles de razonamiento o campos de uso.
- Estabilidad del ciclo de vida: los alias de modelo, los modelos en vista previa, las rutas retiradas y los adaptadores de compatibilidad pueden cambiar la solicitud aunque la llamada del SDK siga teniendo éxito.
- Modelo de capacidad: la concurrencia a nivel de cuenta es distinta de los límites de tasa, y ambas son distintas de un cuello de botella local de GPU o CPU.
- Seguridad del fallback: una ruta de respaldo solo ayuda si conserva la misma región, características, datos y contrato de calidad.
- Visibilidad de costes: los equipos necesitan comparar el coste por respuesta aceptada, no solo los precios nominales por token.
Ese es el trabajo real del enrutamiento regional de proveedores LLM. No es una abstracción universal de un único endpoint. Es una política de comprobación de proveedores que decide qué rutas son elegibles para cada carga de trabajo.
Empiece el enrutamiento de API LLM china separando las clases de proveedores
El primer error en el enrutamiento de API LLM china es tratar cualquier ruta vinculada a China o alojada en Asia como un solo grupo. Eso agrupa demasiadas diferencias operativas.
DeepSeek y Qwen son ambos importantes para el enrutamiento de API LLM china, pero sus comprobaciones de enrutamiento no son las mismas. La documentación de la API pública de DeepSeek enfatiza el acceso compatible con OpenAI y Anthropic con nombres de modelo específicos y concurrencia a nivel de cuenta. La documentación de Qwen de Alibaba Cloud Model Studio enfatiza el acceso compatible con OpenAI a través de endpoints específicos de la región, dominios específicos del espacio de trabajo y claves API vinculadas a la región en la que se crearon.
Use esta separación antes de enrutar el tráfico:
| Pregunta de enrutamiento | DeepSeek | Qwen / Model Studio | Gateway del proveedor local |
|---|---|---|---|
| ¿El endpoint es regional? | Valide la URL base oficial y cualquier ruta de gateway. | Valide el endpoint exacto de la región y el dominio específico del workspace. | Valide el host, la red privada o la dirección del runtime local. |
| ¿La clave de API está vinculada a la región? | Verifique el acceso a la cuenta y al modelo. | Verifique que la clave de API se haya creado en la misma región que el endpoint. | Verifique la autenticación local, el acceso a la red y los permisos de la máquina. |
| ¿La compatibilidad es lo suficientemente completa? | Pruebe chat, tools, razonamiento, formato Anthropic, visión y Responses API solo si su carga de trabajo los utiliza. | Pruebe chat, tools, streaming, soporte multimodal y las advertencias de la familia de modelos según el modelo seleccionado. | Considere la compatibilidad como parcial hasta que pasen sus propias pruebas de humo. |
| ¿Cuál es la señal de capacidad? | Concurrencia a nivel de cuenta y comportamiento 429. | Región, workspace, cuota, estado del endpoint y límites del proveedor. | Margen libre de GPU/CPU/RAM, estado del daemon, profundidad de la cola y tiempo de carga del modelo. |
| ¿Qué fallback está permitido? | Una ruta alojada con clase de función y política coincidentes. | Otra ruta aprobada en la misma política regional, o un fallback alojado aprobado. | Un segundo nodo local o una ruta en la nube preaprobada con revisión explícita de la política de datos. |
Si omite esta separación, el enrutamiento regional de proveedores LLM se convierte en una suposición. La misma carga de trabajo puede moverse entre tres clases de proveedor muy diferentes sin que nadie pueda explicar qué comprobaciones se aplicaron.
DeepSeek necesita comprobaciones separadas incluso cuando el SDK parece familiar
La documentación oficial de DeepSeek hace que la migración resulte accesible: la API utiliza un formato compatible con OpenAI y Anthropic, con https://api.deepseek.com para llamadas en formato OpenAI y https://api.deepseek.com/anthropic para llamadas en formato Anthropic. Esa compatibilidad es útil, pero no elimina la necesidad de comprobaciones específicas de DeepSeek.
Para el enrutamiento DeepSeek Qwen, DeepSeek debe comprobarse por separado por cuatro razones.
Primero, los alias de modelos y las notas de ciclo de vida afectan a la seguridad de la ruta. A fecha de 12 de septiembre de 2026, la documentación de DeepSeek enumera deepseek-flash y deepseek-v4-pro como los nombres de modelo actuales. La documentación también señala que los nombres heredados deepseek-v4-flash y deepseek-v4-flash-vision-exp siguen aceptándose, pero las solicitudes se sirven con el nuevo modelo Flash y se facturan al precio de Flash. Ese es exactamente el tipo de detalle de ciclo de vida que un router debería mostrar en lugar de ocultar.
Segundo, el soporte de funciones depende del modelo. La tabla de precios de DeepSeek enumera la salida JSON, las llamadas a herramientas, Responses API, Anthropic API, la finalización de prefijo de chat beta, FIM beta y el soporte de visión por modelo. Eso significa que su política de enrutamiento regional de proveedores LLM debe probar solo las funciones que la carga de trabajo realmente utiliza y no debe asumir que todas las rutas de DeepSeek son intercambiables.
Tercero, los precios son nativos del proveedor. DeepSeek publica los precios en unidades de 1M de tokens y separa las tarifas de acierto de caché, fallo de caché, salida, pico y fuera de pico. Los equipos de producto no necesitan tener cada precio codificado de forma fija en la lógica de enrutamiento, pero sí necesitan que el router registre suficiente uso para comparar DeepSeek con Qwen, GPT, Claude, Gemini o rutas locales en coste por respuesta aceptada.
Cuarto, la capacidad es a nivel de cuenta. La página de límites de tasa de DeepSeek dice que los límites de concurrencia se calculan a nivel de cuenta independientemente de la API key, y que las solicitudes por encima del límite de concurrencia devuelven HTTP 429. Por tanto, las comprobaciones de salud para el enrutamiento regional de proveedores LLM deben incluir margen de concurrencia, no solo si una pequeña solicitud de prueba devolvió 200.
La lección es sencilla: no empieces el enrutamiento DeepSeek Qwen desde "ambos son compatibles con OpenAI." Empieza por las comprobaciones específicas del proveedor de ciclo de vida, funciones, precio y capacidad que deciden si una ruta es segura para la carga de trabajo.
Qwen necesita comprobaciones separadas porque la región forma parte del contrato de la API
La documentación de Qwen de Alibaba Cloud Model Studio es un ejemplo sólido de por qué el enrutamiento de API LLM chinas necesita comprobaciones regionales. La guía compatible con OpenAI dice que los modelos Qwen en Model Studio admiten interfaces compatibles con OpenAI y que los equipos pueden migrar el código OpenAI existente cambiando la API key, la URL base y el nombre del modelo.
Pero la misma guía también deja explícito el contrato de región. Enumera distintas URL base para Singapur, Virginia, Pekín, Hong Kong y Japón. También dice que Model Studio introdujo nombres de dominio específicos por workspace para Pekín, Singapur y Hong Kong, y que {WorkspaceId} debe sustituirse por el ID real del workspace.
Eso significa que el enrutamiento regional de proveedores LLM para Qwen no es solo "elegir un nombre de modelo". Debe comprobar:
- a qué endpoint regional se permite llamar a la carga de trabajo
- si se requiere el dominio específico del workspace
- si la API key se creó en la misma región que el endpoint
- si una discrepancia entre regiones devuelve un error de autenticación
- si el modelo Qwen o de terceros seleccionado admite exactamente las funciones de protocolo que usa la carga de trabajo
La guía de compatibilidad de Qwen también indica que los modelos compatibles con OpenAI incluyen los modelos de lenguaje grandes Qwen, Qwen-VL, Qwen-Coder, Qwen-Omni, Qwen-Math, DeepSeek, Kimi, GLM y MiniMax. Además, señala por separado que Qwen-Audio no admite el protocolo compatible con OpenAI y debe usar el protocolo DashScope en su lugar.
Ese matiz importa para el enrutamiento DeepSeek Qwen. Una familia de modelos puede estar cerca del mismo catálogo o consola en la nube y aun así necesitar una ruta de protocolo diferente. Si tu producto usa herramientas, streaming, audio, visión o entradas multimodales, el enrutamiento de Qwen necesita pruebas de humo a nivel de función antes de mover tráfico de producción.
Una pasarela local de proveedor LLM necesita comprobaciones de infraestructura
El tercer error en el enrutamiento regional de proveedores LLM es asumir que una pasarela de proveedor local se comporta como otro proveedor alojado. No es así.
La documentación de compatibilidad con OpenAI de Ollama muestra por qué. Ollama expone Chat Completions local compatibles con OpenAI a través de http://localhost:11434/v1, y su documentación describe ese soporte como inicial y experimental. Eso es útil para el desarrollo local y los flujos de trabajo internos controlados, pero no debe tratarse como la misma clase de riesgo que una ruta alojada.
Con una pasarela de proveedor local, tus comprobaciones de enrutamiento cambian:
- ¿Puede la carga de trabajo الوصول the local host or private network route from the environment where it runs?
- ¿La versión del modelo está fijada, o puede un desarrollador o una actualización de paquete cambiarla?
- ¿La ruta local admite las mismas funciones de solicitud que la ruta en la nube?
- ¿Hay suficiente margen de GPU, CPU, memoria y cola para picos reales?
- ¿La ruta expone señales de latencia, errores y saturación de la misma manera que los proveedores alojados?
- ¿Se permite la conmutación por error a un proveedor en la nube según la política de datos del cliente?
Esas comprobaciones son comprobaciones de infraestructura, no solo comprobaciones de API. Una pasarela de proveedor LLM local puede ser la respuesta correcta para la privacidad, el trabajo sin conexión o el control de costes, pero solo cuando el enrutamiento regional de proveedores LLM trata la salud local, la capacidad, la compatibilidad de funciones y la deriva de versiones como restricciones de primera clase.
Usa una matriz de comprobación de proveedores antes de mover tráfico
Una implementación duradera de enrutamiento regional de proveedores LLM necesita una matriz que ingeniería, producto, seguridad y finanzas puedan leer.
| Clase de comprobación | Ruta DeepSeek | Ruta Qwen | Ruta del proveedor local |
|---|---|---|---|
| Endpoint | Confirmar la URL base oficial o del gateway. | Confirmar el endpoint de la región y el dominio específico del espacio de trabajo. | Confirmar localhost, endpoint privado o URL del gateway local. |
| Clave API | Confirmar el acceso a la cuenta y al modelo. | Confirmar que la región de la clave API coincida con la región del endpoint. | Confirmar la autenticación local y el acceso al entorno. |
| Compatibilidad | Probar el formato OpenAI, el formato Anthropic, la Responses API, las herramientas, la visión y los controles de pensamiento solo cuando sea necesario. | Probar chat compatible con OpenAI junto con las advertencias de la familia de modelos, especialmente audio, visión, herramientas y streaming. | Probar la forma exacta de la solicitud/respuesta; asumir compatibilidad parcial hasta que se demuestre lo contrario. |
| Capacidad | Rastrear la concurrencia de la cuenta, la tasa de 429, la latencia y la duración de la solicitud. | Rastrear la cuota regional, el estado del endpoint, las causas de 401/403/404 y el comportamiento de limitación del proveedor. | Rastrear la saturación de la máquina, la profundidad de la cola, el tiempo de carga del modelo y los reinicios del daemon. |
| Coste | Normalizar el acierto de caché, el fallo de caché, la salida, los costes en pico y fuera de pico en coste por respuesta aceptada. | Normalizar el coste por token más el comportamiento de región/espacio de trabajo en coste por respuesta aceptada. | Incluir hardware, operaciones, retraso de cola y coste de respaldo en la nube. |
| Ciclo de vida | Vigilar alias de modelos, nombres heredados, estado de vista previa y cambios de funciones. | Vigilar cambios de endpoint regional, compatibilidad de la familia de modelos y excepciones de protocolo. | Vigilar la versión del runtime, los pesos del modelo, la cuantización y las actualizaciones de paquetes locales. |
| Fallback | Usar solo rutas alojadas aprobadas con clase de funciones y políticas coincidente. | Usar solo alternativas aprobadas por región o por política. | Usar solo un segundo nodo local o una ruta en la nube aprobada después de revisar la política de datos. |
Esta matriz evita que el enrutamiento DeepSeek Qwen se convierta en un simple cambio de modelo en una sola línea. La ruta solo es elegible cuando su clase de proveedor supera las comprobaciones que importan para la carga de trabajo.
Un árbol de decisión práctico para el enrutamiento regional de proveedores LLM
Use este flujo de trabajo siempre que una nueva carga de trabajo solicite DeepSeek, Qwen o un proveedor local:
- Clasifique la carga de trabajo: chat, código, extracción, uso de herramientas de agente, visión, audio, por lotes o multimodal.
- Identifique la política de datos: región permitida, sensibilidad de retención, contrato del cliente y si se requiere procesamiento solo local.
- Elija clases de proveedor elegibles antes que nombres de modelo.
- Ejecute la comprobación de la clase de proveedor: endpoint, clave, compatibilidad, capacidad, ciclo de vida y fallback.
- Ejecute una prueba de humo específica de la carga de trabajo usando prompts y analizadores reales.
- Dirija una pequeña porción de staging o canary.
- Mida la tasa de respuesta aceptada, la latencia p95, la tasa de fallback, la tasa de 429/401/403/404 y el coste por respuesta aceptada.
- Aprove la ruta solo para las clases de carga de trabajo que superó.
- Mantenga una ruta de reversión hasta que la ruta tenga evidencia en producción.
He aquí la misma lógica como datos de política:
regional_llm_provider_routing:
  classify:
    inputs:
      - workload_type
      - required_features
      - data_region
      - customer_policy
      - latency_budget
  provider_classes:
    deepseek:
      checks:
        - base_url_or_gateway_route
        - model_alias_lifecycle
        - required_feature_support
        - account_concurrency_headroom
        - cost_per_accepted_response
    qwen:
      checks:
        - region_endpoint
        - workspace_domain
        - api_key_region_match
        - required_feature_support
        - quota_and_error_classification
    local_gateway:
      checks:
        - host_reachability
        - model_version_pin
        - hardware_headroom
        - compatibility_smoke_test
        - approved_cloud_fallback_policy
  fallback:
    allowed_only_when:
      - same_workload_contract
      - same_data_policy
      - required_features_supported
      - retry_budget_remaining
    otherwise: manual_review
  observe:
    log:
      - route
      - provider_class
      - model
      - endpoint_region
      - status
      - latency_ms
      - input_tokens
      - output_tokens
      - cost
      - fallback_reason
Este es el núcleo del enrutamiento regional de proveedores LLM. Construye la política una vez y luego asigna modelos a ella a medida que los proveedores añaden, cambian de nombre o retiran rutas.
Dónde encaja Flatkey
Flatkey resulta útil cuando el problema operativo ya no es una sola llamada API. El problema son claves de proveedores dispersas, catálogos de modelos, llamadas a herramientas, revisión de uso y política de fallback entre equipos y agentes.
La página de inicio pública actual de Flatkey describe una sola clave detrás de las APIs oficiales de GPT, Claude, Gemini, DeepSeek, Qwen y GLM, además de más de 100 modelos de frontera y más de 1.000 herramientas de IA. El directorio de modelos de Flatkey está diseñado para exponer disponibilidad de modelos en tiempo real, precios, compatibilidad de endpoints y páginas de detalle de modelos. La documentación muestra el patrón de migración habitual: conserva tu formato de solicitud compatible con OpenAI y apunta el SDK a https://router.flatkey.ai/v1.
Para este tema, el catálogo y el feed de precios actuales de Flatkey, muestreados el 12 de septiembre de 2026, mostraban ejemplos disponibles de DeepSeek y Qwen en el grupo China LLM, incluidos deepseek-v4-pro, deepseek-v4-flash, deepseek-v3.2-thinking, deepseek-v3.2, qwen3.8-max, qwen3.7-max, qwen3.7-plus, qwen3.6-max-preview y varias rutas de Qwen 3.5. Trata esos ejemplos como una instantánea de catálogo con fecha, no como una promesa permanente de disponibilidad.
El papel adecuado de Flatkey en el enrutamiento regional de proveedores LLM es el plano de control:
- Comparar rutas alojadas compatibles en un solo directorio de modelos.
- Mantener una URL base estable compatible con OpenAI para el código de la aplicación.
- Rastrear en un solo lugar el modelo, el tipo de endpoint, el estado, el uso de tokens, la latencia y el coste.
- Facilitar la revisión de las decisiones de enrutamiento por clase de proveedor y de fallback.
- Conservar comprobaciones separadas para DeepSeek, Qwen y las pasarelas de proveedores locales en lugar de ocultarlas.
Si ya está usando Flatkey, comience revisando el directorio de modelos, la página de precios y la guía rápida de la API de Flatkey. Para contexto relacionado con el enrutamiento, combine esta guía con el flujo de trabajo unificado de la API de IA, la guía de migración a una alternativa a la API de OpenAI, el manual de enrutamiento de fallback multimodal y el marco de métricas de la API de enrutamiento de IA.
Lista de verificación de lanzamiento
Antes de llevar el enrutamiento regional de proveedores LLM a producción, confirme estos elementos:
- DeepSeek, Qwen y las rutas locales son clases de proveedor separadas en la política de enrutamiento.
- La región del endpoint de Qwen, el dominio del espacio de trabajo y la región de la clave API se validan antes de mover el tráfico.
- Se revisan los alias de modelo de DeepSeek, la compatibilidad de funciones, las unidades de precios por token y el comportamiento de concurrencia.
- Las rutas locales tienen comprobación de accesibilidad del host, fijación de la versión del modelo, margen de hardware y supervisión de la cola.
- El uso de herramientas, la transmisión, la visión, el audio, los controles de razonamiento y la salida estructurada se prueban solo donde la carga de trabajo los requiere.
- Las rutas de fallback preservan el mismo contrato de carga de trabajo y la misma política de datos.
- Los registros incluyen la clase de proveedor, la región del endpoint, el modelo final, el estado, la latencia, los tokens, el coste y el motivo del fallback.
- Producto y finanzas revisan el coste por respuesta aceptada, no solo el precio destacado por token.
- La reversión sigue disponible hasta que la ruta tenga evidencia real en producción.
Cuando esas comprobaciones están en su lugar, el enrutamiento regional de proveedores LLM se convierte en un modelo operativo repetible en lugar de un conjunto oculto de excepciones de proveedor.
FAQ
¿Qué es el enrutamiento regional de proveedores LLM?
El enrutamiento regional de proveedores LLM es la capa de política que decide qué clase de proveedor debe gestionar una solicitud de IA en función de la región del endpoint, el alcance de la clave API, la compatibilidad, la capacidad, el riesgo del ciclo de vida, el coste y la seguridad del fallback.
¿Por qué el enrutamiento de API LLM chino necesita comprobaciones separadas?
El enrutamiento de API LLM chino necesita comprobaciones separadas porque DeepSeek, Qwen y otros proveedores regionales pueden diferir en la geografía del endpoint, la región de la clave API, la profundidad de la compatibilidad, el ciclo de vida del modelo, el comportamiento de cuota y las unidades de precios, incluso cuando exponen interfaces compatibles con OpenAI.
¿Por qué el enrutamiento DeepSeek Qwen no es solo una comparación de un modelo?
El enrutamiento DeepSeek Qwen no es solo una comparación porque DeepSeek y Qwen tienen contratos operativos diferentes. Las comprobaciones de DeepSeek se centran en los alias de modelo, la compatibilidad de funciones, los precios por token y la concurrencia de la cuenta. Las comprobaciones de Qwen se centran en el endpoint de la región, el dominio del espacio de trabajo, la región de la clave API y la compatibilidad del protocolo de la familia de modelos.
¿Cuándo tiene sentido una pasarela local de proveedor LLM?
Una pasarela local de proveedor LLM tiene sentido cuando la privacidad, la operación sin conexión, el control del desarrollo o las restricciones de coste justifican ejecutar los modelos localmente y tu equipo puede encargarse de las comprobaciones adicionales de estado, capacidad, compatibilidad y desfase de versiones.
¿Puede una ruta compatible con OpenAI omitir la QA específica del proveedor?
No. La compatibilidad con OpenAI puede reducir el trabajo de integración, pero cada ruta sigue necesitando QA específica de la carga de trabajo para herramientas, streaming, salida estructurada, entradas multimodales, gestión de errores, campos de uso, límites de velocidad y comportamiento de fallback.
La conclusión
La estrategia adecuada de enrutamiento regional de proveedores LLM trata menos de un único endpoint universal y más de comprobaciones disciplinadas del proveedor. Esto es especialmente cierto cuando el enrutamiento de API LLM chinas incluye tanto DeepSeek como Qwen, y cuando una pasarela local de proveedor se sitúa junto a rutas alojadas para flujos de trabajo de privacidad, sin conexión o control de costes.
Trata el enrutamiento DeepSeek Qwen primero como un problema de política del proveedor. Luego valida evidencia real del endpoint activo, la clave, la compatibilidad, la capacidad, el ciclo de vida y los costes antes de mover tráfico de producción.
Flatkey ayuda cuando quieres una clave, un catálogo de modelos, una URL base única compatible con OpenAI y una única superficie de uso para las rutas alojadas compatibles admitidas. Usa la pasarela para centralizar las operaciones, pero mantén las comprobaciones separadas del proveedor que hacen seguro el enrutamiento regional.


