
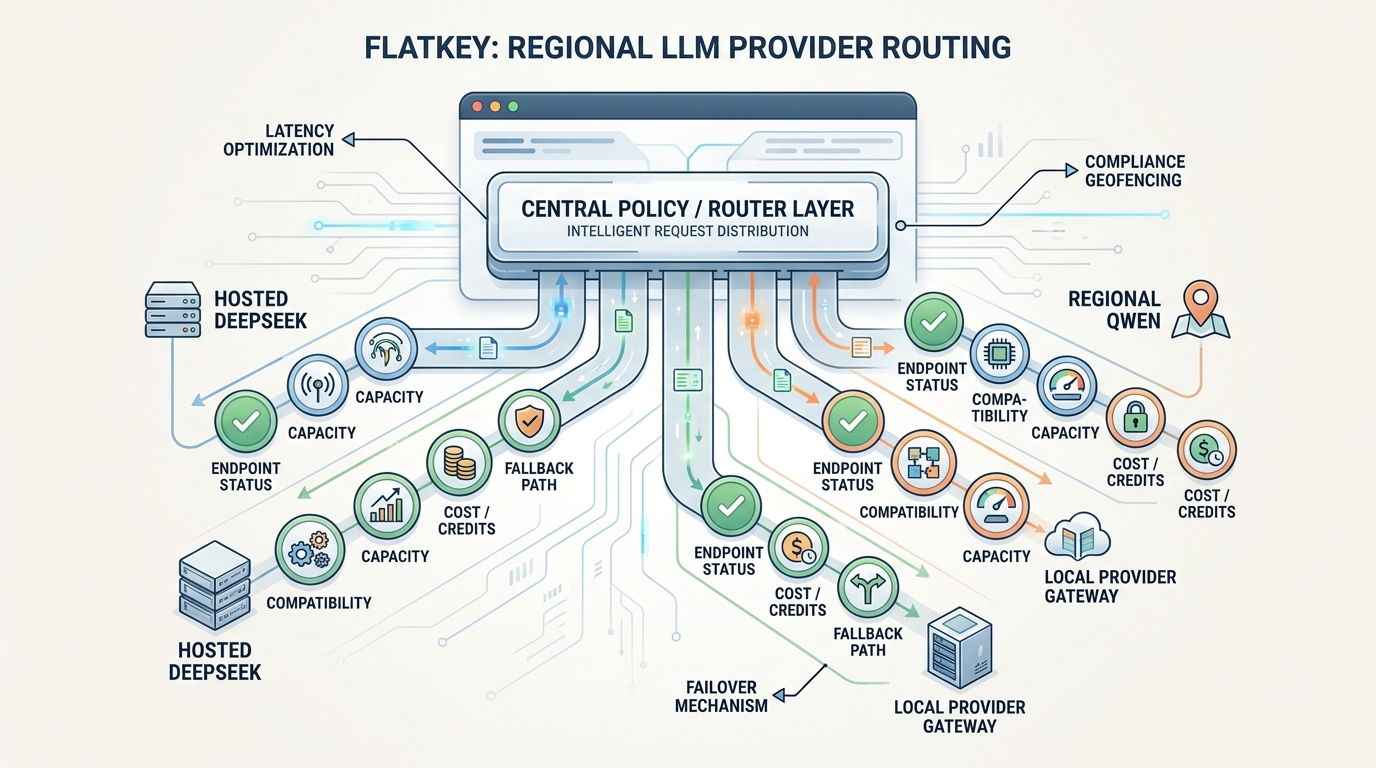
地域別LLMプロバイダールーティングを計画しているなら、リスクが高いのはOpenAI互換のエンドポイントをもう1つ見つけることではありません。本当に難しいのは、DeepSeekのルートをホスト型クラウドプロバイダーのように扱えるのはいつか、Qwenのルートにリージョン境界のエンドポイントチェックが必要なのはいつか、そしてローカルプロバイダーが本番トラフィックを受け取る前にインフラチェックが必要なのはいつかを判断することです。
だからこそ、地域別LLMプロバイダールーティングは、モデルのリーダーボード上の表現ではなく、プロバイダークラスから始めるべきです。DeepSeek、Qwen、ローカルランタイムは、SDK層ではどれも似て見えるかもしれませんが、同じリージョン契約、ライフサイクルリスク、キャパシティシグナル、フォールバック安全ルールを共有しているわけではありません。
このガイドでは、AIプロダクトチーム向けに、DeepSeek、Qwen、ローカルプロバイダーゲートウェイをまたいだ地域別LLMプロバイダールーティングの実践的なポリシーを示します。本番トラフィックを移す前、フォールバックを追加する前、チーム間で共有AIゲートウェイを標準化する前に使ってください。
簡単な答え
より安全な地域別LLMプロバイダールーティングのポリシーでは、モデル名を比較する前にルートを3つのプロバイダークラスに分けます。
| プロバイダークラス | 最初のチェック | 個別ポリシーが必要な理由 |
|---|---|---|
| DeepSeek | API形式、モデルエイリアス、機能サポート、トークン価格の単位、同時実行制限 | DeepSeekはOpenAIおよびAnthropic互換のパスを提供しますが、ルートの安全性はモデルのライフサイクル、価格モード、アカウントレベルのキャパシティに依存します。 |
| Qwen / Alibaba Cloud Model Studio | リージョンエンドポイント、ワークスペースドメイン、リージョン境界のAPIキー、OpenAI互換機能の注意点 | Qwenのルーティングは設計上リージョンベースです。エンドポイント、ワークスペースID、APIキーのリージョンが、呼び出しの成否の一部になることがあります。 |
| ローカルプロバイダーゲートウェイ | ホスト到達性、モデル固定、ローカルハードウェアの余力、互換性の差分、フォールバック分離 | ローカルルートは、ホスト型APIアカウントではなく、あなたが運用するインフラのように失敗します。 |
Flatkeyは、このワークフローにおける共有ゲートウェイ層として機能します。1つのキー、1つのモデルカタログ、1つのOpenAI互換ルート面、そして対応モデルとツールのための1つの利用状況ビューです。ただし、ゲートウェイはプロバイダー固有のチェックを消し去るべきではありません。それらのチェックを明確にし、可観測にし、レビューしやすくするべきです。
地域別LLMプロバイダールーティングが実際に最適化しているもの
優れた地域別LLMプロバイダールーティングは、ベンチマークでどのモデルのスコアが最も高いかだけを問いません。現在のプロダクト、リージョン、フォールバックポリシーの下で、どのプロバイダークラスが安全にリクエストを担えるかを問います。
本番環境では、地域別LLMプロバイダールーティングは通常、次の6つを同時にバランスします。
- エンドポイントの地理的条件: 一部のプロバイダーは地域ごとに異なるベースURLを公開しており、それによってレイテンシー、アカウント設定、居住性レビュー、フェイルオーバー設計が変わる場合があります。
- 互換性の深さ: OpenAI互換性はチャット完了をカバーできても、ツール、ストリーミング、ビジョン、音声、推論制御、または使用量フィールドでは異なる場合があります。
- ライフサイクルの安定性: モデルの別名、プレビューモデル、廃止されたルート、互換性シムは、SDK呼び出しが成功し続けていてもリクエストを変更することがあります。
- キャパシティモデル: アカウントレベルの同時実行数はレート制限とは異なり、どちらもローカルGPUまたはCPUのボトルネックとは異なります。
- フォールバックの安全性: バックアップルートは、同じ地域、機能、データ、および品質の契約を維持できる場合にのみ役立ちます。
- コストの可視性: チームは、表面的なトークン単価だけでなく、受け入れられた応答あたりのコストを比較する必要があります。
それが地域別LLMプロバイダールーティングの本当の役割です。これは単一の सार्व用エンドポイント抽象化ではありません。どのルートがどのワークロードに適格かを決定するプロバイダーチェックポリシーです。
プロバイダークラスを分けて中国系LLM APIルーティングを開始する
中国系LLM APIルーティングで最初に犯しがちなミスは、中国関連またはアジアホストのルートをすべて1つのバケットとして扱うことです。これでは運用上の差異をあまりにも多く潰してしまいます。
DeepSeekとQwenはどちらも中国系LLM APIルーティングで重要ですが、ルーティングチェックは同じではありません。DeepSeekの公開APIドキュメントは、特定のモデル名とアカウントレベルの同時実行数を伴う、OpenAIおよびAnthropic互換のアクセスを強調しています。Alibaba Cloud Model StudioのQwenドキュメントは、リージョン固有のエンドポイント、ワークスペース固有のドメイン、および作成されたリージョンに紐づくAPIキーを通じたOpenAI互換アクセスを強調しています。
トラフィックをルーティングする前に、この分け方を使ってください:
| ルートの質問 | DeepSeek | Qwen / Model Studio | ローカルプロバイダーゲートウェイ |
|---|---|---|---|
| エンドポイントはリージョン別か? | 公式のベースURLと、必要に応じてゲートウェイルートを検証する。 | 正確なリージョンエンドポイントと、ワークスペース固有のドメインを検証する。 | ホスト、プライベートネットワーク、またはローカルランタイムのアドレスを検証する。 |
| APIキーはリージョンに紐づいているか? | アカウントとモデルへのアクセスを確認する。 | APIキーがエンドポイントと同じリージョンで作成されたことを確認する。 | ローカル認証、ネットワークアクセス、マシン権限を確認する。 |
| 互換性は十分に完全か? | ワークロードで使用する場合にのみ、chat、tools、reasoning、Anthropic形式、vision、Responses APIをテストする。 | 選択したモデルに応じて、chat、tools、streaming、マルチモーダル対応、およびモデルファミリー固有の注意点をテストする。 | 自前のスモークテストが通るまでは、互換性は部分的なものとして扱う。 |
| キャパシティのシグナルは何か? | アカウントレベルの同時実行数と429の挙動。 | リージョン、ワークスペース、クォータ、エンドポイントの健全性、プロバイダーの制限。 | GPU/CPU/RAMの余裕、デーモンの健全性、キュー深度、モデルのロード時間。 |
| 許可されるフォールバックは何か? | 機能とポリシークラスが一致するホスト型ルート。 | 同じリージョンポリシー内の別の承認済みルート、または承認済みのホスト型フォールバック。 | 2台目のローカルノード、または明示的なデータポリシー審査済みの事前承認クラウドルート。 |
この分岐を省略すると、regional LLM provider routingは勘頼みになります。同じワークロードが、適用されたチェック内容を誰も説明できないまま、まったく異なる3種類のプロバイダークラスを行き来する可能性があります。
SDKが見慣れていてもDeepSeekには個別チェックが必要
DeepSeekの公式ドキュメントは移行をしやすくしています。APIはOpenAIおよびAnthropicと互換性のある形式を使用し、OpenAI形式の呼び出しには https://api.deepseek.com、Anthropic形式の呼び出しには https://api.deepseek.com/anthropic を使います。この互換性は便利ですが、DeepSeek固有のチェックが不要になるわけではありません。
DeepSeek Qwen routingでは、DeepSeekを個別に確認すべき理由が4つあります。
第一に、モデルのエイリアスとライフサイクルに関する注意書きがルートの安全性に影響するからです。2026年9月12日時点で、DeepSeekのドキュメントでは deepseek-flash と deepseek-v4-pro が現在のモデル名として記載されています。ドキュメントには、旧来の deepseek-v4-flash と deepseek-v4-flash-vision-exp の名前もまだ受け付けられるが、リクエストは新しいFlashモデルで処理され、Flash価格で課金されるともあります。これはまさに、ルーターが隠すのではなく表に出すべきライフサイクル上の詳細です。
第二に、機能サポートはモデルごとに異なるからです。DeepSeekの価格表では、JSON出力、ツール呼び出し、Responses API、Anthropic API、beta chat prefix completion、beta FIM、visionサポートがモデル別に示されています。つまり、regional LLM provider routingのポリシーは、ワークロードが実際に使う機能だけをテストすべきであり、DeepSeekのすべてのルートが互換的だと仮定すべきではありません。
第三に、価格設定はプロバイダーネイティブです。DeepSeek は価格を 100 万トークン単位で公開しており、キャッシュヒット、キャッシュミス、出力、ピーク、オフピークの各レートを分けています。プロダクトチームはルーティングロジックにあらゆる価格をハードコードする必要はありませんが、受理された応答あたりのコストで DeepSeek を Qwen、GPT、Claude、Gemini、またはローカルルートと比較できるだけの使用量を、ルーターが記録する必要があります。
第四に、キャパシティはアカウントレベルです。DeepSeek のレート制限ページでは、同時実行制限は API キーに関係なくアカウント単位で計算され、同時実行制限を超えたリクエストは HTTP 429 を返すと説明されています。したがって、地域別 LLM プロバイダールーティングのヘルスチェックには、小さなテストリクエストが 200 を返したかどうかだけでなく、同時実行の余裕も含める必要があります。
教訓はシンプルです。DeepSeek Qwen ルーティングを「どちらも OpenAI 互換だから」から始めてはいけません。ワークロードに対してそのルートが安全かどうかを判断する、プロバイダー固有のライフサイクル、機能、価格、キャパシティのチェックから始めてください。
Qwen に個別チェックが必要なのは、リージョンが API 契約の一部だからです
Alibaba Cloud Model Studio の Qwen ドキュメントは、中国の LLM API ルーティングに地域チェックが必要である理由を示す強力な例です。OpenAI 互換ガイドでは、Model Studio の Qwen モデルが OpenAI 互換インターフェースをサポートし、API キー、ベース URL、モデル名を変更するだけで既存の OpenAI コードを移行できると説明しています。
しかし同じガイドでは、リージョン契約も明示されています。シンガポール、バージニア、北京、香港、日本向けに異なるベース URL が列挙されています。また、Model Studio が北京、シンガポール、香港向けにワークスペース固有のドメイン名を導入したこと、そして {WorkspaceId} は実際のワークスペース ID に置き換える必要があることも記載されています。
つまり、Qwen の地域別 LLM プロバイダールーティングは、単に「モデル名を選ぶ」だけではありません。以下を確認する必要があります。
- ワークロードが呼び出し可能なリージョンエンドポイントはどれか
- ワークスペース固有ドメインが必要かどうか
- API キーがエンドポイントと同じリージョンで作成されているかどうか
- リージョン間の不一致が認証エラーを返すかどうか
- 選択した Qwen またはサードパーティモデルが、ワークロードで使用する正確なプロトコル機能をサポートしているかどうか
Qwen の互換性ガイドでは、サポートされる OpenAI 互換モデルとして、Qwen 大規模言語モデル、Qwen-VL、Qwen-Coder、Qwen-Omni、Qwen-Math、DeepSeek、Kimi、GLM、MiniMax が含まれるとも記載されています。別途、Qwen-Audio は OpenAI 互換プロトコルをサポートせず、代わりに DashScope プロトコルを使用すべきだと示しています。
この注意書きは、DeepSeek Qwen ルーティングにとって重要です。モデルファミリーが同じカタログやクラウドコンソールの近くにあっても、別のプロトコルパスが必要な場合があります。製品でツール、ストリーミング、音声、画像、またはマルチモーダル入力を使用する場合、Qwen のルーティングには本番トラフィックを切り替える前に機能レベルのスモークテストが必要です。
ローカル LLM プロバイダーゲートウェイにはインフラストラクチャチェックが必要です
地域別 LLM プロバイダールーティングにおける3つ目の誤りは、ローカルプロバイダーのゲートウェイが別のホスト型プロバイダーのように動作すると想定することです。そんなことはありません。
Ollama の OpenAI 互換ドキュメントがその理由を示しています。Ollama はローカルの OpenAI 互換 Chat Completions を http://localhost:11434/v1 で公開しており、そのサポートは初期段階かつ実験的であるとドキュメントに記載されています。これはローカル開発や制御された社内ワークフローには有用ですが、ホスト型ルートと同じリスク分類として扱うべきではありません。
ローカルプロバイダーゲートウェイを使う場合、ルーティングチェックは次のように変わります。
- ワークロードは、実行環境からローカルホストまたはプライベートネットワークのルートに到達できますか?
- モデルのバージョンは固定されていますか、それとも開発者やパッケージ更新で変更される可能性がありますか?
- ローカルルートはクラウドルートと同じリクエスト機能をサポートしていますか?
- 実際の急増に対応するのに十分な GPU、CPU、メモリ、およびキューの余裕がありますか?
- そのルートは、ホスト型プロバイダーと同じ方法でレイテンシ、エラー、飽和のシグナルを公開しますか?
- 顧客のデータポリシー上、クラウドプロバイダーへのフェイルバックは許可されていますか?
これらのチェックは、単なる API チェックではなくインフラのチェックです。ローカル LLM プロバイダーゲートウェイは、プライバシー、オフライン作業、コスト管理に対して適切な選択肢になりえますが、地域別 LLM プロバイダールーティングがローカルの正常性、容量、機能サポート、バージョンのずれを最重要の制約として扱う場合に限られます。
トラフィックを移す前にプロバイダーチェックマトリクスを使う
持続可能な地域別 LLM プロバイダールーティングの展開には、エンジニアリング、プロダクト、セキュリティ、財務のすべてが読めるマトリクスが必要です。
| チェック種別 | DeepSeek ルート | Qwen ルート | ローカルプロバイダールート |
|---|---|---|---|
| エンドポイント | 公式 URL またはゲートウェイのベース URL を確認します。 | リージョンのエンドポイントとワークスペース固有のドメインを確認します。 | localhost、プライベートエンドポイント、またはローカルゲートウェイ URL を確認します。 |
| API キー | アカウントとモデルへのアクセスを確認します。 | API キーのリージョンがエンドポイントのリージョンと一致していることを確認します。 | ローカル認証と環境アクセスを確認します。 |
| 互換性 | OpenAI 形式、Anthropic 形式、Responses API、ツール、ビジョン、thinking 制御は、必要な場合にのみテストします。 | OpenAI 互換のチャットに加え、モデルファミリー固有の注意点、特に audio、vision、tools、streaming をテストします。 | 正確なリクエスト/レスポンスの形状をテストします。証明されるまでは部分互換とみなします。 |
| 容量 | アカウントの同時実行数、429 レート、レイテンシ、リクエスト所要時間を追跡します。 | リージョンのクォータ、エンドポイントの健全性、401/403/404 の原因、プロバイダのスロットリング挙動を追跡します。 | マシンの飽和度、キュー深さ、モデルのロード時間、デーモンの再起動を追跡します。 |
| コスト | キャッシュヒット、キャッシュミス、出力、ピーク、オフピークの経済性を、受理されたレスポンスあたりのコストに正規化します。 | トークンコストに加え、リージョン/ワークスペースの挙動を、受理されたレスポンスあたりのコストに正規化します。 | ハードウェア、運用、キュー遅延、クラウドフォールバックのコストを含めます。 |
| ライフサイクル | モデルのエイリアス、旧名称、プレビュー状態、機能変更を監視します。 | リージョンのエンドポイント変更、モデルファミリーのサポート、プロトコル例外を監視します。 | ランタイムバージョン、モデル重み、量子化、ローカルパッケージの更新を監視します。 |
| フォールバック | 機能クラスとポリシークラスが一致する、承認済みのホスト型ルートのみを使用します。 | リージョン承認済み、またはポリシー承認済みの代替のみを使用します。 | データポリシーのレビュー後に、第二のローカルノードまたは承認済みクラウドルートのみを使用します。 |
このマトリクスにより、DeepSeek Qwen ルーティング が単なる 1 行のモデル切り替えになるのを防げます。ルートは、そのプロバイダークラスがワークロードに重要なチェックを通過した場合にのみ適格です。
地域別LLMプロバイダールーティングのための実践的な意思決定ツリー
新しいワークロードが DeepSeek、Qwen、またはローカルプロバイダーを必要とするときは、いつでも次の手順を使用してください:
- ワークロードを分類します: チャット、コード、抽出、エージェントのツール利用、ビジョン、音声、バッチ、またはマルチモーダル。
- データポリシーを特定します: 許可されるリージョン、保持の機微性、顧客契約、ローカルのみの処理が必要かどうか。
- モデル名より先に、利用可能なプロバイダークラスを選びます。
- プロバイダークラスのチェックを実行します: エンドポイント、キー、互換性、容量、ライフサイクル、フォールバック。
- 実際のプロンプトとパーサーを使って、ワークロード固有のスモークテストを実行します。
- ステージングまたはカナリアの小さな割合にルーティングします。
- 受理されたレスポンス率、p95 レイテンシ、フォールバック率、429/401/403/404 率、受理されたレスポンスあたりのコストを測定します。
- そのルートが通過したワークロードクラスに対してのみ承認します。
- 本番での実績が得られるまで、ロールバックパスを維持します。
同じロジックをポリシーデータとして示すと次のとおりです:
regional_llm_provider_routing:
  classify:
    inputs:
      - workload_type
      - required_features
      - data_region
      - customer_policy
      - latency_budget
  provider_classes:
    deepseek:
      checks:
        - base_url_or_gateway_route
        - model_alias_lifecycle
        - required_feature_support
        - account_concurrency_headroom
        - cost_per_accepted_response
    qwen:
      checks:
        - region_endpoint
        - workspace_domain
        - api_key_region_match
        - required_feature_support
        - quota_and_error_classification
    local_gateway:
      checks:
        - host_reachability
        - model_version_pin
        - hardware_headroom
        - compatibility_smoke_test
        - approved_cloud_fallback_policy
  fallback:
    allowed_only_when:
      - same_workload_contract
      - same_data_policy
      - required_features_supported
      - retry_budget_remaining
    otherwise: manual_review
  observe:
    log:
      - route
      - provider_class
      - model
      - endpoint_region
      - status
      - latency_ms
      - input_tokens
      - output_tokens
      - cost
- fallback_reasonこれは地域別LLMプロバイダールーティングの中核です。ポリシーを一度作成し、その後はプロバイダーがルートを追加、名称変更、または廃止するたびにモデルをそこへ割り当てます。
Flatkeyが適する場面
Flatkeyは、運用上の問題がもはや単一のAPI呼び出しではない場合に有用です。問題は、散在するプロバイダーキー、モデルカタログ、ツール呼び出し、利用状況レビュー、そしてチームやエージェント全体にまたがるフォールバックポリシーです。
Flatkeyの現在の公開ホームページでは、公式のGPT、Claude、Gemini、DeepSeek、Qwen、GLM APIの背後にある1つのキーに加え、100以上のフロンティアモデルと1,000以上のAIツールが紹介されています。Flatkeyのモデルディレクトリは、ライブのモデル可用性、価格、エンドポイント対応、モデル詳細ページを表示するよう設計されています。ドキュメントでは一般的な移行パターンが示されています。OpenAI互換のリクエスト形式を維持し、SDKの向き先をhttps://router.flatkey.ai/v1に設定します。
このトピックに関して、2026年9月12日に取得した現在のFlatkeyカタログと価格フィードでは、China LLMグループに利用可能なDeepSeekとQwenの例が表示されており、deepseek-v4-pro、deepseek-v4-flash、deepseek-v3.2-thinking、deepseek-v3.2、qwen3.8-max、qwen3.7-max、qwen3.7-plus、qwen3.6-max-preview、および複数のQwen 3.5ルートが含まれていました。これらの例は、恒久的な利用可能性の約束ではなく、時点のカタログ・スナップショットとして扱ってください。
地域別LLMプロバイダールーティングにおけるFlatkeyの適切な役割は、コントロールプレーンです。
- 1つのモデルディレクトリで、対応するホスト型ルートを比較する。
- アプリケーションコード向けに安定したOpenAI互換のベースURLを維持する。
- モデル、エンドポイント種別、ステータス、トークン使用量、レイテンシ、コストを一箇所で追跡する。
- プロバイダー種別のルーティングとフォールバックの判断をレビューしやすくする。
- DeepSeek、Qwen、ローカルプロバイダーゲートウェイの個別チェックを隠さずに保持する。
すでに Flatkey を使用している場合は、まず モデルディレクトリ、料金ページ、そして Flatkey API クイックスタートを確認してください。ルーティングに隣接する文脈としては、このガイドを 統合 AI API ワークフロー、OpenAI API 代替移行ガイド、マルチモーダルフォールバックルーティングのプレイブック、および AI ルーティング API メトリクスのフレームワークと組み合わせてください。
導入チェックリスト
地域別 LLM プロバイダールーティングを本番環境に移す前に、次の項目を確認してください:
- DeepSeek、Qwen、およびローカルルートが、ルーティングポリシー上で別々のプロバイダークラスとして扱われている。
- Qwen のエンドポイント地域、ワークスペースドメイン、API キーの地域が、トラフィック移行前に検証されている。
- DeepSeek のモデルエイリアス、機能サポート、トークン価格の単位、並行処理の挙動が確認されている。
- ローカルルートについて、ホスト到達性、モデルバージョンの固定、ハードウェア余力、キュー監視が整っている。
- ツール使用、ストリーミング、ビジョン、オーディオ、推論制御、構造化出力は、ワークロードが必要とする場合にのみテストされている。
- フォールバックルートが、同じワークロード契約とデータポリシーを維持している。
- ログに、プロバイダークラス、エンドポイント地域、最終モデル、ステータス、レイテンシー、トークン、コスト、フォールバック理由が含まれている。
- プロダクトと財務が、単なる表面的なトークン価格ではなく、受理されたレスポンスあたりのコストを確認している。
- ルートに実際の本番実績が得られるまでは、ロールバックが利用可能なままである。
これらの確認が整えば、地域別 LLM プロバイダールーティングは、プロバイダー例外の隠れた集合ではなく、再現可能な運用モデルになります。
FAQ
地域別 LLM プロバイダールーティングとは何ですか?
地域別 LLM プロバイダールーティングとは、エンドポイント地域、API キースコープ、互換性、容量、ライフサイクルリスク、コスト、およびフォールバックの安全性に基づいて、どのプロバイダークラスが AI リクエストを処理すべきかを決定するポリシーレイヤーです。
中国系 LLM API ルーティングに個別チェックが必要なのはなぜですか?
中国系 LLM API ルーティングには個別チェックが必要です。DeepSeek、Qwen、その他の地域別プロバイダーは、OpenAI 互換インターフェースを公開していても、エンドポイントの地理的条件、API キーの地域、互換性の深さ、モデルのライフサイクル、クォータの挙動、価格単位が異なる場合があるためです。
DeepSeek Qwen ルーティングが単なる 1 つのモデル比較ではないのはなぜですか?
DeepSeek Qwen ルーティングは単なる比較ではありません。DeepSeek と Qwen では運用契約が異なるためです。DeepSeek の確認ポイントは、モデルエイリアス、機能サポート、トークン価格、アカウントの並行処理です。Qwen の確認ポイントは、地域エンドポイント、ワークスペースドメイン、API キーの地域、モデルファミリーのプロトコルサポートです。
ローカル LLM プロバイダーゲートウェイが有効なのはいつですか?
ローカルLLMプロバイダゲートウェイは、プライバシー、オフライン運用、開発管理、またはコスト制約のためにモデルをローカルで実行することが妥当で、かつチームが追加のヘルス、容量、互換性、バージョンずれのチェックを担える場合に適しています。
OpenAI互換のルートはプロバイダ固有のQAを省略できますか?
いいえ。OpenAI互換性は統合作業を減らせますが、各ルートには依然として、ツール、ストリーミング、構造化出力、マルチモーダル入力、エラー処理、usageフィールド、レート制限、フォールバック動作に関するワークロード固有のQAが必要です。
要点
適切な地域別LLMプロバイダールーティング戦略は、単一の汎用エンドポイントよりも、規律あるプロバイダチェックに重点を置くべきです。これは特に、中国のLLM APIルーティングにDeepSeekとQwenの両方が含まれる場合や、プライバシー、オフライン、またはコスト管理のワークフローのためにローカルプロバイダゲートウェイがホスト型ルートと並んで存在する場合に当てはまります。
DeepSeek Qwenルーティングは、まずプロバイダポリシーの問題として扱ってください。そのうえで、本番トラフィックを移す前に、ライブエンドポイント、キー、互換性、容量、ライフサイクル、コストの根拠を検証します。
Flatkeyは、1つのキー、1つのモデルカタログ、1つのOpenAI互換ベースURL、そしてサポートされるホスト型ルート向けの1つの利用状況サーフェスを求める場合に役立ちます。ゲートウェイを使って運用を一元化しつつ、地域別ルーティングを安全にするための個別プロバイダチェックは維持してください。


