
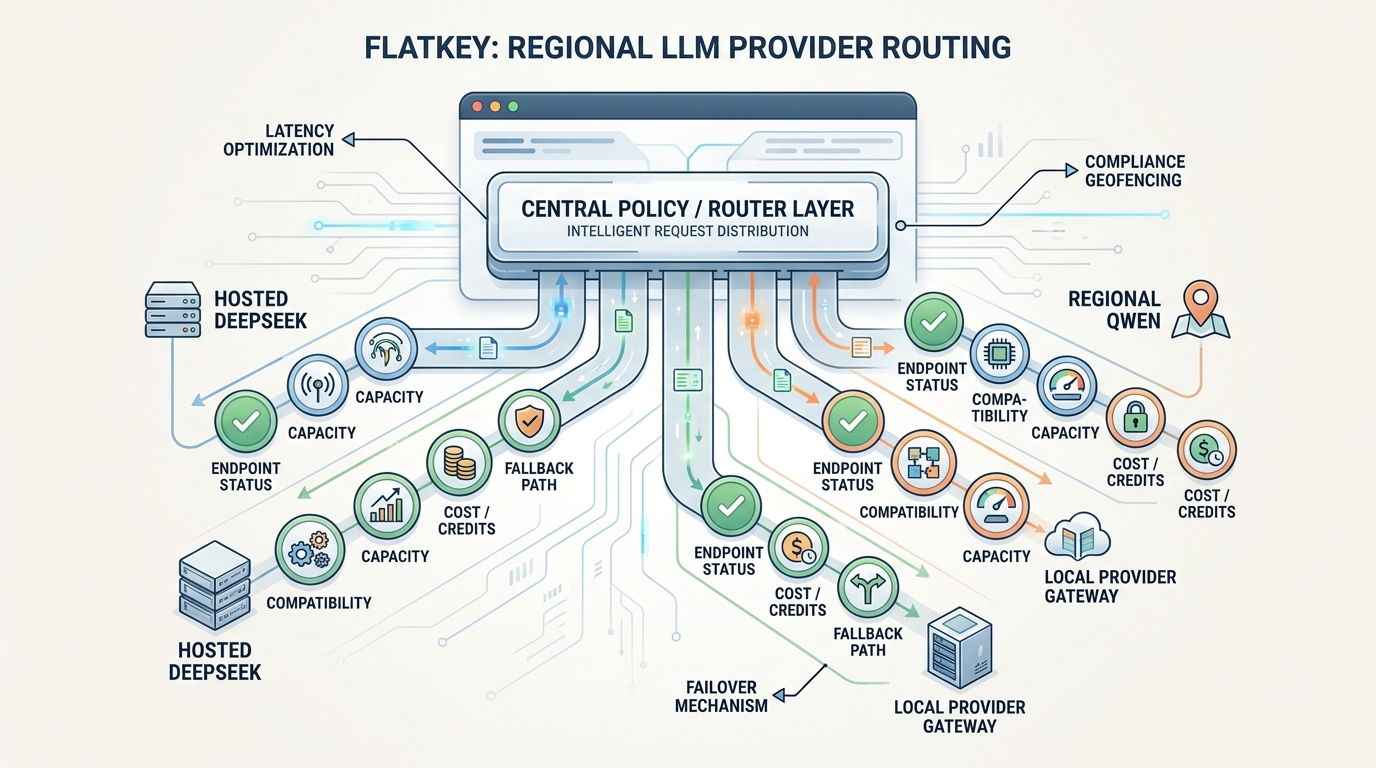
Se você está planejando roteamento regional de provedores LLM, a parte arriscada não é encontrar outro endpoint compatível com OpenAI. A parte arriscada é decidir quando uma rota DeepSeek pode ser tratada como um provedor de nuvem hospedado, quando uma rota Qwen precisa de verificações de endpoint vinculadas à região e quando um provedor local precisa de verificações de infraestrutura antes de receber tráfego de produção.
É por isso que o roteamento regional de provedores LLM deve começar pela classe do provedor, e não pela linguagem do ranking de modelos. DeepSeek, Qwen e runtimes locais podem todos parecer familiares na camada do SDK, mas não compartilham o mesmo contrato de região, risco de ciclo de vida, sinal de capacidade ou regras de segurança de fallback.
Este guia oferece às equipes de produto de IA uma política prática para roteamento regional de provedores LLM entre DeepSeek, Qwen e gateways de provedores locais. Use-o antes de mover tráfego de produção, adicionar fallback ou padronizar um gateway de IA compartilhado entre equipes.
A Resposta Rápida
Uma política mais segura de roteamento regional de provedores LLM separa as rotas em três classes de provedor antes de comparar nomes de modelos:
| Classe de provedor | Primeiras verificações | Por que precisa de uma política separada |
|---|---|---|
| DeepSeek | Formato da API, alias do modelo, suporte a recursos, unidade de preço por token, limite de concorrência | DeepSeek expõe caminhos compatíveis com OpenAI e Anthropic, mas a segurança da rota ainda depende do ciclo de vida do modelo, do modo de precificação e da capacidade no nível da conta. |
| Qwen / Alibaba Cloud Model Studio | Endpoint da região, domínio do workspace, chave de API vinculada à região, ressalvas de recursos compatíveis com OpenAI | O roteamento do Qwen é regional por design; o endpoint, o ID do workspace e a região da chave de API podem fazer parte do funcionamento de uma chamada. |
| Gateway de provedor local | Alcance do host, fixação do modelo, folga de hardware local, lacunas de compatibilidade, isolamento de fallback | Uma rota local falha como uma infraestrutura que você opera, não como uma conta de API hospedada. |
Flatkey se encaixa neste fluxo como a camada de gateway compartilhada: uma chave, um catálogo de modelos, uma superfície de rota compatível com OpenAI e uma visão de uso para modelos e ferramentas suportados. Mas um gateway não deve apagar as verificações específicas do provedor. Ele deve tornar essas verificações explícitas, observáveis e mais fáceis de revisar.
O que o Roteamento Regional de Provedores LLM Está Realmente Otimizando
Um bom roteamento regional de provedores LLM não pergunta apenas qual modelo tem a maior pontuação em um benchmark. Ele pergunta qual classe de provedor pode assumir uma solicitação com segurança sob a política atual de produto, região e fallback.
Em produção, o roteamento regional de provedores LLM normalmente equilibra seis coisas ao mesmo tempo:
- Geografia do endpoint: alguns provedores expõem URLs base diferentes por região, e isso pode alterar a latência, a configuração da conta, a revisão de residência e o design de failover.
- Profundidade de compatibilidade: a compatibilidade com OpenAI pode cobrir conclusões de chat enquanto ainda difere em ferramentas, streaming, visão, áudio, controles de raciocínio ou campos de uso.
- Estabilidade do ciclo de vida: aliases de modelos, modelos de pré-visualização, rotas aposentadas e shims de compatibilidade podem alterar a solicitação mesmo que a chamada do SDK ainda seja bem-sucedida.
- Modelo de capacidade: a concorrência no nível da conta é diferente dos limites de taxa, e ambos são diferentes de um gargalo local de GPU ou CPU.
- Segurança de fallback: uma rota de backup só ajuda se preservar a mesma região, recursos, dados e contrato de qualidade.
- Visibilidade de custo: as equipes precisam comparar o custo por resposta aceita, e não apenas os preços de token divulgados.
Essa é a verdadeira função do roteamento regional de provedores LLM. Não é uma abstração universal de endpoint. É uma política de verificação de provedor que decide quais rotas são elegíveis para cada carga de trabalho.
Comece o roteamento da API LLM chinesa separando as classes de provedores
O primeiro erro no roteamento da API LLM chinesa é tratar toda rota ligada à China ou hospedada na Ásia como um único grupo. Isso apaga diferenças operacionais demais.
DeepSeek e Qwen ambos importam para o roteamento da API LLM chinesa, mas suas verificações de roteamento não são as mesmas. A documentação da API pública da DeepSeek enfatiza acesso compatível com OpenAI e Anthropic, com nomes de modelos específicos e concorrência no nível da conta. A documentação do Alibaba Cloud Model Studio para Qwen enfatiza acesso compatível com OpenAI por meio de endpoints específicos por região, domínios específicos por workspace e chaves de API vinculadas à região em que foram criadas.
Use essa separação antes de rotear o tráfego:
| Pergunta de roteamento | DeepSeek | Qwen / Model Studio | Gateway do provedor local |
|---|---|---|---|
| O endpoint é regional? | Valide a URL base oficial e qualquer rota de gateway. | Valide o endpoint exato da região e o domínio específico do workspace. | Valide o host, a rede privada ou o endereço de runtime local. |
| A chave de API é vinculada à região? | Verifique a conta e o acesso ao modelo. | Verifique se a chave de API foi criada na mesma região do endpoint. | Verifique a autenticação local, o acesso à rede e as permissões da máquina. |
| A compatibilidade é suficientemente completa? | Teste chat, tools, reasoning, formato Anthropic, visão e Responses API apenas se sua carga de trabalho os usar. | Teste chat, tools, streaming, suporte multimodal e ressalvas da família de modelos conforme o modelo selecionado. | Considere a compatibilidade como parcial até que seus próprios smoke tests passem. |
| Qual é o sinal de capacidade? | Concorrência no nível da conta e comportamento de 429. | Região, workspace, quota, integridade do endpoint e limites do provedor. | Margem de folga de GPU/CPU/RAM, saúde do daemon, profundidade da fila e tempo de carregamento do modelo. |
| Qual fallback é permitido? | Uma rota hospedada com classe de recurso e política correspondentes. | Outra rota aprovada na mesma política regional, ou um fallback hospedado aprovado. | Um segundo nó local ou uma rota em nuvem pré-aprovada com revisão explícita da política de dados. |
Se você ignorar essa divisão, o roteamento regional de provedores LLM vira adivinhação. A mesma carga de trabalho pode se mover entre três classes de provedor muito diferentes, sem que ninguém consiga explicar quais verificações foram aplicadas.
DeepSeek Precisa de Verificações Separadas Mesmo Quando o SDK Parece Familiar
A documentação oficial da DeepSeek torna a migração acessível: a API usa um formato compatível com OpenAI e Anthropic, com https://api.deepseek.com para chamadas no formato OpenAI e https://api.deepseek.com/anthropic para chamadas no formato Anthropic. Essa compatibilidade é útil, mas não elimina a necessidade de verificações específicas da DeepSeek.
Para o roteamento DeepSeek Qwen, a DeepSeek deve ser verificada separadamente por quatro motivos.
Primeiro, os aliases de modelos e as observações de ciclo de vida afetam a segurança da rota. Em 12 de setembro de 2026, a documentação da DeepSeek lista deepseek-flash e deepseek-v4-pro como os nomes atuais dos modelos. A documentação também observa que os nomes legados deepseek-v4-flash e deepseek-v4-flash-vision-exp ainda são aceitos, mas as solicitações são atendidas pelo novo modelo Flash e cobradas pelo preço do Flash. Esse é exatamente o tipo de detalhe de ciclo de vida que um roteador deve expor em vez de ocultar.
Segundo, o suporte a recursos é específico por modelo. A tabela de preços da DeepSeek lista saída JSON, chamadas de tools, Responses API, API Anthropic, conclusão de prefixo de chat beta, FIM beta e suporte a visão por modelo. Isso significa que sua política de roteamento regional de provedores LLM deve testar apenas os recursos que a carga de trabalho realmente usa e não deve presumir que toda rota da DeepSeek seja intercambiável.
Terceiro, o preço é nativo do provedor. A DeepSeek publica preços em unidades de 1M tokens e separa as tarifas de cache hit, cache miss, output, peak e off-peak. As equipes de produto não precisam de cada preço codificado no logic de roteamento, mas precisam que o roteador registre uso suficiente para comparar DeepSeek com Qwen, GPT, Claude, Gemini ou rotas locais em custo por resposta aceita.
Quarto, a capacidade é no nível da conta. A página de limite de taxa da DeepSeek diz que os limites de concorrência são calculados no nível da conta, independentemente da API key, e que requisições acima do limite de concorrência retornam HTTP 429. As verificações de saúde para roteamento regional de provedores LLM precisam, portanto, incluir margem de concorrência, e não apenas se uma pequena requisição de teste retornou 200.
A lição é simples: não comece o roteamento DeepSeek Qwen a partir de "ambos são compatíveis com OpenAI." Comece pelas verificações específicas do provedor de ciclo de vida, recursos, preço e capacidade que decidem se uma rota é segura para a carga de trabalho.
Qwen Precisa De Verificações Separadas Porque A Região Faz Parte Do Contrato Da API
A documentação do Qwen no Alibaba Cloud Model Studio é um forte exemplo de por que o roteamento de API LLM chinesa precisa de verificações regionais. O guia compatível com OpenAI diz que os modelos Qwen no Model Studio oferecem interfaces compatíveis com OpenAI e que as equipes podem migrar o código OpenAI existente alterando a API key, a base URL e o nome do modelo.
Mas o mesmo guia também deixa explícito o contrato de região. Ele lista diferentes base URLs para Singapura, Virgínia, Pequim, Hong Kong e Japão. Ele também diz que o Model Studio introduziu nomes de domínio específicos do workspace para Pequim, Singapura e Hong Kong, e que {WorkspaceId} deve ser substituído pelo ID real do workspace.
Isso significa que o roteamento regional de provedores LLM para Qwen não é apenas "escolher um nome de modelo." Ele precisa verificar:
- qual endpoint regional a carga de trabalho está autorizada a chamar
- se o domínio específico do workspace é necessário
- se a API key foi criada na mesma região do endpoint
- se uma incompatibilidade entre regiões retorna um erro de autenticação
- se o modelo Qwen selecionado ou de terceiros oferece suporte aos recursos exatos do protocolo que a carga de trabalho usa
O guia de compatibilidade do Qwen também afirma que os modelos compatíveis com OpenAI incluem os grandes modelos de linguagem Qwen, Qwen-VL, Qwen-Coder, Qwen-Omni, Qwen-Math, DeepSeek, Kimi, GLM e MiniMax. Ele observa separadamente que o Qwen-Audio não oferece suporte ao protocolo compatível com OpenAI e deve usar o protocolo DashScope em vez disso.
Essa ressalva importa para o roteamento DeepSeek Qwen. Uma família de modelos pode ficar próxima do mesmo catálogo ou console de nuvem e ainda assim precisar de um caminho de protocolo diferente. Se o seu produto usa ferramentas, streaming, áudio, visão ou entradas multimodais, o roteamento Qwen precisa de testes rápidos de recursos antes da mudança do tráfego de produção.
Um Gateway Local De Provedor LLM Precisa De Verificações De Infraestrutura
O terceiro erro em roteamento regional de provedores LLM é assumir que um gateway de provedor local se comporta como outro provedor hospedado. Não se comporta.
A documentação de compatibilidade com OpenAI do Ollama mostra por quê. O Ollama expõe Chat Completions locais compatíveis com OpenAI por meio de http://localhost:11434/v1, e sua documentação descreve esse suporte como inicial e experimental. Isso é útil para desenvolvimento local e fluxos de trabalho internos controlados, mas não deve ser tratado como a mesma classe de risco que uma rota hospedada.
Com um gateway de provedor local, suas verificações de roteamento mudam:
- A carga de trabalho consegue alcançar o host local ou a rota de rede privada a partir do ambiente em que é executada?
- A versão do modelo está fixada, ou uma atualização do desenvolvedor ou do pacote pode alterá-la?
- A rota local oferece os mesmos recursos de requisição que a rota na nuvem?
- Há GPU, CPU, memória e folga de fila suficientes para picos reais?
- A rota expõe sinais de latência, erro e saturação da mesma forma que os provedores hospedados?
- O fallback para um provedor em nuvem é permitido pela política de dados do cliente?
Essas verificações são verificações de infraestrutura, não apenas verificações de API. Um gateway de provedor LLM local pode ser a resposta certa para privacidade, trabalho offline ou controle de custos, mas apenas quando o roteamento regional de provedores LLM trata a integridade local, a capacidade, o suporte a recursos e a divergência de versão como restrições de primeira classe.
Use Uma Matriz de Verificação de Provedores Antes de Movimentar Tráfego
Uma implementação durável de roteamento regional de provedores LLM precisa de uma matriz que engenharia, produto, segurança e finanças possam ler.
| Classe de verificação | Rota DeepSeek | Rota Qwen | Rota do provedor local |
|---|---|---|---|
| Endpoint | Confirme a URL base oficial ou do gateway. | Confirme o endpoint regional e o domínio específico do workspace. | Confirme localhost, endpoint privado ou URL do gateway local. |
| Chave de API | Confirme o acesso à conta e ao modelo. | Confirme se a região da chave de API corresponde à região do endpoint. | Confirme a autenticação local e o acesso ao ambiente. |
| Compatibilidade | Teste o formato OpenAI, o formato Anthropic, a Responses API, ferramentas, visão e controles de pensamento apenas quando necessário. | Teste o chat compatível com OpenAI mais as ressalvas da família de modelos, especialmente áudio, visão, ferramentas e streaming. | Teste a forma exata da requisição/resposta; presuma compatibilidade parcial até que seja comprovada. |
| Capacidade | Acompanhe a concorrência da conta, a taxa de 429, a latência e a duração da requisição. | Acompanhe a cota da região, a integridade do endpoint, as causas de 401/403/404 e o comportamento de limitação do provedor. | Acompanhe a saturação da máquina, a profundidade da fila, o tempo de carregamento do modelo e as reinicializações do daemon. |
| Custo | Normalize a economia de hit de cache, miss de cache, saída, pico e fora de pico em custo por resposta aceita. | Normalize o custo de tokens mais o comportamento da região/workspace em custo por resposta aceita. | Inclua hardware, operações, atraso de fila e custo de fallback para a nuvem. |
| Ciclo de vida | Observe aliases de modelo, nomes legados, status de pré-visualização e mudanças de recursos. | Observe mudanças de endpoint regional, suporte à família de modelos e exceções de protocolo. | Observe a versão do runtime, os pesos do modelo, a quantização e as atualizações de pacotes locais. |
| Fallback | Use apenas rotas hospedadas aprovadas com classe de recurso e política correspondentes. | Use apenas alternativas aprovadas pela região ou pela política. | Use apenas um segundo nó local ou uma rota de nuvem aprovada após a revisão da política de dados. |
Esta matriz impede que o roteamento DeepSeek Qwen se torne uma troca de modelo de uma linha só. A rota só é elegível quando sua classe de provedor passa nas verificações que importam para a carga de trabalho.
Uma árvore de decisão prática para roteamento regional de provedores LLM
Use este fluxo de trabalho sempre que uma nova carga de trabalho solicitar DeepSeek, Qwen ou um provedor local:
- Classifique a carga de trabalho: chat, código, extração, uso de ferramentas por agentes, visão, áudio, lote ou multimodal.
- Identifique a política de dados: região permitida, sensibilidade de retenção, contrato do cliente e se o tratamento somente local é exigido.
- Escolha classes de provedor elegíveis antes dos nomes dos modelos.
- Execute a verificação da classe de provedor: endpoint, chave, compatibilidade, capacidade, ciclo de vida e fallback.
- Execute um smoke test específico da carga de trabalho usando prompts e parsers reais.
- Roteie uma pequena fatia de staging ou canário.
- Meça a taxa de respostas aceitas, a latência p95, a taxa de fallback, a taxa de 429/401/403/404 e o custo por resposta aceita.
- Aprove a rota apenas para as classes de carga de trabalho pelas quais ela passou.
- Mantenha um caminho de rollback até que a rota tenha evidências em produção.
Aqui está a mesma lógica como dados de política:
regional_llm_provider_routing:
  classify:
    inputs:
      - workload_type
      - required_features
      - data_region
      - customer_policy
      - latency_budget
  provider_classes:
    deepseek:
      checks:
        - base_url_or_gateway_route
        - model_alias_lifecycle
        - required_feature_support
        - account_concurrency_headroom
        - cost_per_accepted_response
    qwen:
      checks:
        - region_endpoint
        - workspace_domain
        - api_key_region_match
        - required_feature_support
        - quota_and_error_classification
    local_gateway:
      checks:
        - host_reachability
        - model_version_pin
        - hardware_headroom
        - compatibility_smoke_test
        - approved_cloud_fallback_policy
  fallback:
    allowed_only_when:
      - same_workload_contract
      - same_data_policy
      - required_features_supported
      - retry_budget_remaining
    otherwise: manual_review
  observe:
    log:
      - route
      - provider_class
      - model
      - endpoint_region
      - status
      - latency_ms
      - input_tokens
      - output_tokens
      - cost
      - fallback_reason
Este é o núcleo do roteamento regional de provedores LLM. Defina a política uma vez e, depois, mapeie os modelos nela à medida que os provedores adicionam, renomeiam ou descontinuam rotas.
Onde o Flatkey se Encaixa
O Flatkey é útil quando o problema operacional já não é apenas uma chamada de API. O problema passa a ser chaves de provedores espalhadas, catálogos de modelos, chamadas de ferramentas, revisão de uso e política de fallback distribuídas entre equipes e agentes.
A página inicial pública atual do Flatkey descreve uma chave por trás das APIs oficiais da GPT, Claude, Gemini, DeepSeek, Qwen e GLM, além de mais de 100 modelos de fronteira e mais de 1.000 ferramentas de IA. O diretório de modelos do Flatkey foi projetado para expor disponibilidade de modelos em tempo real, preços, suporte a endpoints e páginas de detalhes dos modelos. A documentação mostra o padrão comum de migração: mantenha o formato de solicitação compatível com a OpenAI e aponte o SDK para https://router.flatkey.ai/v1.
Para este tópico, o catálogo e o feed de preços atuais do Flatkey amostrados em 12 de setembro de 2026 mostraram exemplos disponíveis de DeepSeek e Qwen no grupo China LLM, incluindo deepseek-v4-pro, deepseek-v4-flash, deepseek-v3.2-thinking, deepseek-v3.2, qwen3.8-max, qwen3.7-max, qwen3.7-plus, qwen3.6-max-preview e várias rotas Qwen 3.5. Trate esses exemplos como uma captura de catálogo datada, não como uma promessa permanente de disponibilidade.
O papel correto do Flatkey em roteamento regional de provedores LLM é o plano de controle:
- Comparar rotas hospedadas compatíveis em um único diretório de modelos.
- Manter uma base URL estável compatível com OpenAI para o código da aplicação.
- Rastrear modelo, tipo de endpoint, status, uso de tokens, latência e custo em um só lugar.
- Tornar mais fáceis de revisar as decisões de roteamento por classe de provedor e de fallback.
- Preservar verificações separadas para DeepSeek, Qwen e gateways de provedores locais em vez de ocultá-las.
Se você já está usando o Flatkey, comece revisando o diretório de modelos, a página de preços e o guia de início rápido da API do Flatkey. Para contexto adjacente ao roteamento, combine este guia com o fluxo de trabalho unificado de API de IA, o guia de migração para alternativa à API da OpenAI, o manual de fallback de roteamento multimodal e a estrutura de métricas para API de roteamento de IA.
Checklist de Lançamento
Antes de levar o roteamento regional de provedores LLM para produção, confirme estes itens:
- DeepSeek, Qwen e rotas locais são classes de provedor separadas na política de roteamento.
- A região do endpoint do Qwen, o domínio do workspace e a região da chave de API são validados antes da movimentação do tráfego.
- Os aliases de modelo do DeepSeek, o suporte a recursos, as unidades de preço por token e o comportamento de concorrência são revisados.
- As rotas locais têm verificações de alcançabilidade do host, fixação da versão do modelo, margem de hardware e monitoramento de fila.
- Uso de ferramentas, streaming, visão, áudio, controles de raciocínio e saída estruturada são testados somente onde a carga de trabalho os exige.
- As rotas de fallback preservam o mesmo contrato de carga de trabalho e a mesma política de dados.
- Os logs incluem classe de provedor, região do endpoint, modelo final, status, latência, tokens, custo e motivo do fallback.
- Produto e finanças analisam o custo por resposta aceita, não apenas o preço de token destacado.
- O rollback permanece disponível até que a rota tenha evidências reais de produção.
Quando essas verificações estiverem em vigor, o roteamento regional de provedores LLM se torna um modelo operacional repetível em vez de um conjunto oculto de exceções de provedor.
FAQ
O que é roteamento regional de provedores LLM?
O roteamento regional de provedores LLM é a camada de política que decide qual classe de provedor deve tratar uma solicitação de IA com base na região do endpoint, no escopo da chave de API, na compatibilidade, na capacidade, no risco de ciclo de vida, no custo e na segurança do fallback.
Por que o roteamento de API de LLM chineses precisa de verificações separadas?
O roteamento de API de LLM chineses precisa de verificações separadas porque DeepSeek, Qwen e outros provedores regionais podem diferir na geografia do endpoint, na região da chave de API, na profundidade de compatibilidade, no ciclo de vida do modelo, no comportamento de cotas e nas unidades de preço, mesmo quando expõem interfaces compatíveis com a OpenAI.
Por que o roteamento DeepSeek Qwen não é apenas uma comparação de modelos?
O roteamento DeepSeek Qwen não é apenas uma comparação porque DeepSeek e Qwen têm contratos operacionais diferentes. As verificações do DeepSeek se concentram em aliases de modelo, suporte a recursos, preço por token e concorrência da conta. As verificações do Qwen se concentram na região do endpoint, no domínio do workspace, na região da chave de API e no suporte ao protocolo da família de modelos.
Quando faz sentido usar um gateway de provedor LLM local?
Um gateway local de provedor LLM faz sentido quando privacidade, operação offline, controle de desenvolvimento ou restrições de custo justificam executar modelos localmente e sua equipe pode assumir as verificações extras de saúde, capacidade, compatibilidade e desvio de versão.
Uma rota compatível com OpenAI pode dispensar QA específico do provedor?
Não. A compatibilidade com OpenAI pode reduzir o trabalho de integração, mas toda rota ainda precisa de QA específico da carga de trabalho para ferramentas, streaming, saída estruturada, entradas multimodais, tratamento de erros, campos de uso, limites de taxa e comportamento de fallback.
A Conclusão
A estratégia certa de roteamento regional de provedores LLM diz menos respeito a um único endpoint universal e mais a verificações disciplinadas de provedores. Isso é especialmente verdadeiro quando o roteamento de API LLM chinesa inclui tanto DeepSeek quanto Qwen, e quando um gateway local de provedor fica ao lado de rotas hospedadas para fluxos de trabalho de privacidade, offline ou controle de custos.
Trate o roteamento DeepSeek Qwen primeiro como um problema de política do provedor. Depois valide evidências ao vivo de endpoint, chave, compatibilidade, capacidade, ciclo de vida e custo antes de mover tráfego de produção.
A Flatkey ajuda quando você quer uma chave, um catálogo de modelos, uma URL base única compatível com OpenAI e uma superfície única de uso para rotas hospedadas compatíveis. Use o gateway para centralizar as operações, mas mantenha as verificações separadas de provedores que tornam o roteamento regional seguro.


