
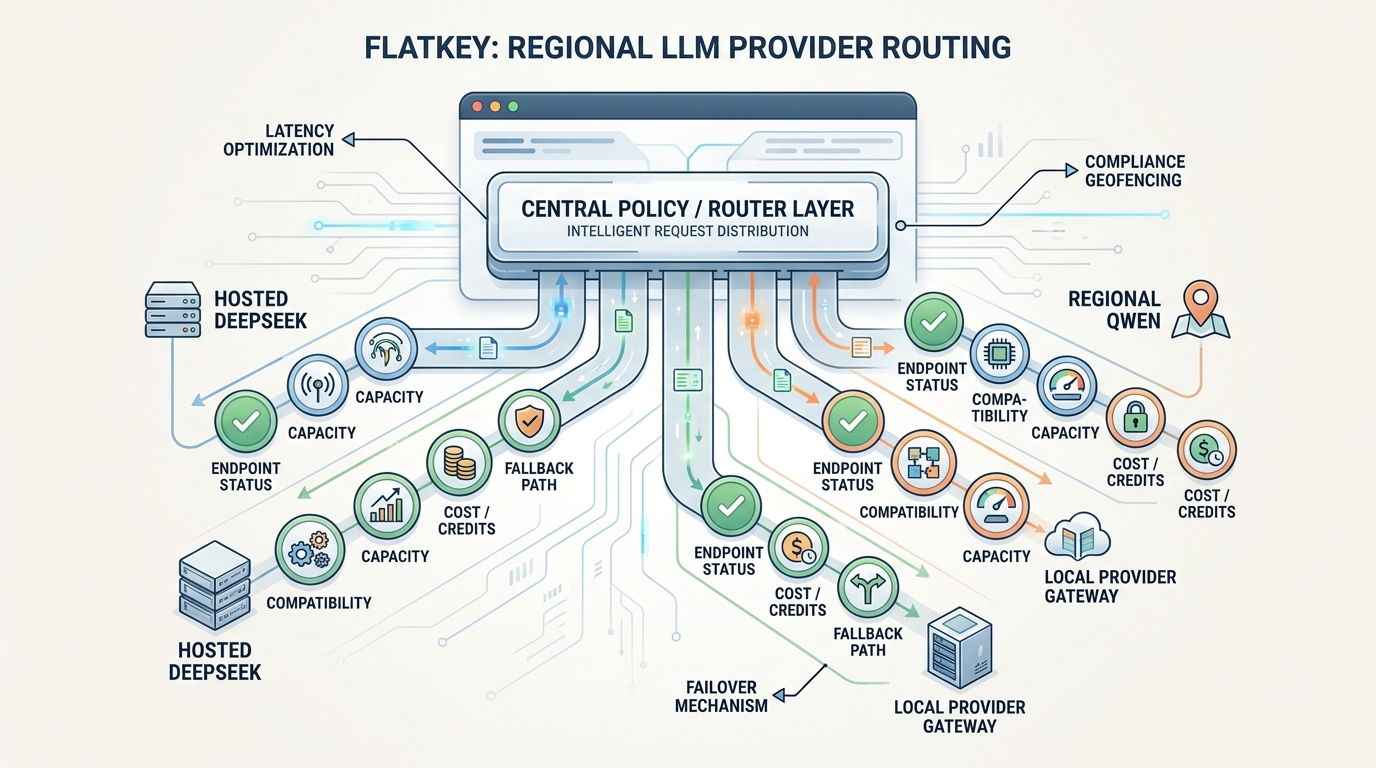
如果你正在规划区域性 LLM 提供商路由,真正有风险的不是再找一个兼容 OpenAI 的端点。真正有风险的是:什么时候可以把 DeepSeek 路由当作托管云提供商,什么时候 Qwen 路由需要按区域绑定的端点进行检查,以及什么时候本地提供商在接收生产流量之前需要先做基础设施检查。
这就是为什么区域性 LLM 提供商路由应该先从提供商类别入手,而不是先看模型排行榜上的描述。DeepSeek、Qwen 和本地运行时在 SDK 层看起来都很熟悉,但它们并不共享相同的区域契约、生命周期风险、容量信号或回退安全规则。
本指南为 AI 产品团队提供了一套实用策略,用于在 DeepSeek、Qwen 和本地提供商网关之间进行区域性 LLM 提供商路由。在你迁移生产流量、添加回退,或在团队之间标准化共享 AI 网关之前,可以先参考这份指南。
快速答案
更安全的区域性 LLM 提供商路由策略,会在比较模型名称之前先将路由分成三类提供商:
| 提供商类别 | 首先检查什么 | 为什么需要单独的策略 |
|---|---|---|
| DeepSeek | API 格式、模型别名、功能支持、token 计价单位、并发限制 | DeepSeek 提供了兼容 OpenAI 和 Anthropic 的路径,但路由安全仍然取决于模型生命周期、计费模式和账户级容量。 |
| Qwen / Alibaba Cloud Model Studio | 区域端点、工作区域名、区域绑定的 API 密钥、OpenAI 兼容功能注意事项 | Qwen 路由本身就是按区域设计的;端点、工作区 ID 和 API 密钥所在区域都可能决定一次调用能否成功。 |
| 本地提供商网关 | 主机可达性、模型固定绑定、本地硬件余量、兼容性差距、回退隔离 | 本地路由失败的方式更像你自己运维的基础设施,而不是托管 API 账户。 |
Flatkey 适合充当这套流程中的共享网关层:一个密钥、一个模型目录、一个兼容 OpenAI 的路由表面,以及一个支持模型和工具的使用视图。但网关不应抹去提供商特定检查;它应该让这些检查变得明确、可观察,并且更容易审查。
区域性 LLM 提供商路由真正优化的是什么
好的区域性 LLM 提供商路由并不只问哪个模型在基准测试中得分最高。它问的是:在当前产品、区域和回退策略下,哪一类提供商可以安全地承担一个请求。
在生产环境中,区域性 LLM 提供商路由通常要同时平衡六件事:
- 端点地理位置:有些提供商会按地区公开不同的基础 URL,这会影响延迟、账户设置、数据驻留审查和故障切换设计。
- 兼容性深度:OpenAI 兼容性可能覆盖聊天补全,但在工具、流式传输、视觉、音频、推理控制或使用字段方面仍可能存在差异。
- 生命周期稳定性:即使 SDK 调用仍然成功,模型别名、预览模型、已退役路由和兼容性适配层也可能改变请求。
- 容量模型:账户级并发不同于速率限制,而这两者又不同于本地 GPU 或 CPU 瓶颈。
- 回退安全性:只有在备份路由保持相同的地区、功能、数据和质量契约时,它才真正有帮助。
- 成本可见性:团队需要比较每个被接受响应的成本,而不仅仅是表面的 token 价格。
这才是区域性 LLM 提供商路由的真正工作。它不是一个通用的端点抽象,而是一种提供商检查策略,用于决定哪些路由适合哪些工作负载。
通过区分提供商类别开始中国 LLM API 路由
中国 LLM API 路由中的第一个错误,是把所有与中国相关或托管在亚洲的路由都视为一个桶。这会掩盖太多运营差异。
DeepSeek 和 Qwen 都与中国 LLM API 路由密切相关,但它们的路由检查并不相同。DeepSeek 的公开 API 文档强调与 OpenAI 和 Anthropic 兼容的访问方式,带有特定的模型名称和账户级并发限制。阿里云百炼的 Qwen 文档则强调通过特定地区端点、工作空间专属域名,以及与创建地区绑定的 API 密钥来提供 OpenAI 兼容访问。
在路由流量之前,先使用这个划分:
| 路由问题 | DeepSeek | Qwen / Model Studio | 本地提供商网关 |
|---|---|---|---|
| 端点是否具有地域性? | 验证官方基础 URL 以及任何网关路由。 | 验证确切的区域端点和工作区特定域名。 | 验证主机、私有网络或本地运行时地址。 |
| API 密钥是否受区域限制? | 检查账户和模型访问权限。 | 检查 API 密钥是否在与端点相同的区域创建。 | 检查本地认证、网络访问和机器权限。 |
| 兼容性是否足够完整? | 仅在你的工作负载使用这些功能时,测试聊天、工具、推理、Anthropic 格式、视觉和 Responses API。 | 根据所选模型,测试聊天、工具、流式传输、多模态支持以及模型家族注意事项。 | 在你自己的冒烟测试通过之前,将兼容性视为部分支持。 |
| 容量信号是什么? | 账户级并发和 429 行为。 | 区域、工作区、配额、端点健康状况和提供商限制。 | GPU/CPU/RAM 余量、守护进程健康状况、队列深度和模型加载时间。 |
| 允许什么回退? | 具有匹配功能和策略类别的托管路由。 | 同一区域策略中的另一个已批准路由,或已批准的托管回退路由。 | 第二个本地节点,或经过明确数据策略审查的预先批准云路由。 |
如果你跳过这种拆分,区域性 LLM 提供商路由就会变成猜测。同一个工作负载可能在三种截然不同的提供商类别之间切换,却没有人能够解释应用了哪些检查。
即使 SDK 看起来很熟悉,DeepSeek 也需要单独检查
DeepSeek 的官方文档让迁移变得容易上手:该 API 采用与 OpenAI 和 Anthropic 兼容的格式,OpenAI 格式调用使用 https://api.deepseek.com,Anthropic 格式调用使用 https://api.deepseek.com/anthropic。这种兼容性很有帮助,但并不能免除对 DeepSeek 进行专门检查的需要。
对于 DeepSeek Qwen 路由,DeepSeek 应该因四个原因单独检查。
首先,模型别名和生命周期说明会影响路由安全性。截至 2026 年 9 月 12 日,DeepSeek 文档将 deepseek-flash 和 deepseek-v4-pro 列为当前模型名称。文档还指出,旧的 deepseek-v4-flash 和 deepseek-v4-flash-vision-exp 名称仍然被接受,但请求会由更新的 Flash 模型提供服务,并按 Flash 价格计费。这正是路由器应该暴露而不是隐藏的那类生命周期细节。
其次,功能支持是按模型区分的。DeepSeek 的定价表按模型列出了 JSON 输出、工具调用、Responses API、Anthropic API、beta chat prefix completion、beta FIM 和视觉支持。这意味着你的 区域性 LLM 提供商路由 策略应仅测试工作负载实际使用的功能,而不应假设每条 DeepSeek 路由都可以互换。
第三,定价是 provider-native 的。DeepSeek 以 100 万 tokens 为单位公布价格,并区分缓存命中、缓存未命中、输出、峰值和非峰值费率。产品团队不需要把每个价格都硬编码到路由逻辑中,但确实需要路由器记录足够的使用情况,以便按每个已接受响应的成本将 DeepSeek 与 Qwen、GPT、Claude、Gemini 或本地路由进行比较。
第四,容量是账户级别的。DeepSeek 的限流页面说明,不论 API key 如何, 并发限制都按账户级别计算,超过并发限制的请求会返回 HTTP 429。因此,区域性 LLM 提供商路由的健康检查需要包含并发余量,而不仅仅是某个小型测试请求是否返回了 200。
结论很简单:不要因为DeepSeek Qwen 路由里的“两者都兼容 OpenAI”就开始设计。应当从提供商特定的生命周期、功能、价格和容量检查入手,这些检查决定了一条路由是否适合该工作负载。
Qwen 需要单独检查,因为区域是 API 合同的一部分
阿里云百炼的 Qwen 文档是一个很好的例子,说明为什么中文 LLM API 路由需要区域检查。OpenAI 兼容指南说明,百炼上的 Qwen 模型支持 OpenAI 兼容接口,团队可以通过更改 API key、base URL 和模型名称来迁移现有的 OpenAI 代码。
但同一份指南也明确了区域合同。它列出了新加坡、弗吉尼亚、北京、香港和日本的不同 base URL。它还说明,百炼为北京、新加坡和香港引入了工作空间专属域名,并且应将 {WorkspaceId} 替换为实际的 workspace ID。
这意味着 Qwen 的区域性 LLM 提供商路由不只是“选择一个模型名称”。它必须检查:
- 工作负载被允许调用的是哪个区域端点
- 是否需要工作空间专属域名
- API key 是否在与端点相同的区域创建
- 跨区域不匹配是否会返回认证错误
- 所选的 Qwen 或第三方模型是否支持工作负载使用的精确协议特性
Qwen 兼容性指南还指出,支持的 OpenAI 兼容模型包括 Qwen 大语言模型、Qwen-VL、Qwen-Coder、Qwen-Omni、Qwen-Math、DeepSeek、Kimi、GLM 和 MiniMax。它还单独说明,Qwen-Audio 不支持 OpenAI 兼容协议,应改用 DashScope 协议。
这一注意事项对DeepSeek Qwen 路由很重要。一个模型家族可能位于相近的目录或云控制台中,却仍然需要不同的协议路径。如果你的产品使用工具、流式传输、音频、视觉或多模态输入,Qwen 路由在生产流量切换之前需要进行功能级冒烟测试。
本地 LLM 提供商网关需要基础设施检查
区域性 LLM 提供商路由中的第三个错误,是假设本地提供商网关会像另一个托管提供商一样工作。事实并非如此。
Ollama 的 OpenAI 兼容性文档说明了原因。Ollama 通过 http://localhost:11434/v1 暴露本地的、兼容 OpenAI 的 Chat Completions,其文档将这种支持描述为初始阶段且具有实验性。这对于本地开发和受控的内部工作流很有用,但不应将其视为与托管路由相同的风险类别。
对于本地提供商网关,你的路由检查会发生变化:
- 工作负载能否从其运行环境访问本地主机或私有网络路由?
- 模型版本是否已固定,还是开发人员或包更新可能会改变它?
- 本地路由是否支持与云路由相同的请求特性?
- 对于真实的突发流量,是否有足够的 GPU、CPU、内存和队列余量?
- 该路由是否以与托管提供商相同的方式暴露延迟、错误和饱和度信号?
- 在客户的数据政策下,是否允许回退到云提供商?
这些检查是基础设施检查,而不仅仅是 API 检查。本地 LLM 提供商网关可以是隐私、离线工作或成本控制的正确答案,但前提是区域性 LLM 提供商路由将本地健康状况、容量、功能支持和版本漂移视为一等约束。
在迁移流量之前使用提供商检查矩阵
一个可持续的区域性 LLM 提供商路由上线方案,需要一张工程、产品、安全和财务都能读懂的矩阵。
| 检查类别 | DeepSeek 路由 | Qwen 路由 | 本地提供商路由 |
|---|---|---|---|
| Endpoint | 确认官方或网关基础 URL。 | 确认区域端点和工作区特定域名。 | 确认 localhost、私有端点或本地网关 URL。 |
| API key | 确认账户和模型访问权限。 | 确认 API key 区域与端点区域匹配。 | 确认本地认证和环境访问权限。 |
| Compatibility | 仅在需要时测试 OpenAI 格式、Anthropic 格式、Responses API、工具、视觉和思维控制。 | 测试兼容 OpenAI 的聊天接口,并注意模型家族的限制,尤其是音频、视觉、工具和流式传输。 | 测试精确的请求/响应结构;在证实之前,假定只有部分兼容。 |
| Capacity | 跟踪账户并发、429 速率、延迟和请求持续时间。 | 跟踪区域配额、端点健康状况、401/403/404 的原因以及提供商限流行为。 | 跟踪机器饱和度、队列深度、模型加载时间和守护进程重启。 |
| Cost | 将缓存命中、缓存未命中、输出、高峰和非高峰经济性归一化为每个已接受响应的成本。 | 将 token 成本以及区域/工作区行为归一化为每个已接受响应的成本。 | 包含硬件、运维、队列延迟和云端回退成本。 |
| Lifecycle | 关注模型别名、旧名称、预览状态和功能变更。 | 关注区域端点变更、模型家族支持和协议异常。 | 关注运行时版本、模型权重、量化和本地包更新。 |
| Fallback | 仅使用已批准、且功能和策略类别匹配的托管路由。 | 仅使用区域批准或策略批准的替代方案。 | 仅在数据策略审查后使用第二个本地节点或已批准的云端路由。 |
这个矩阵可防止 DeepSeek Qwen routing 变成一个一行式的模型切换。只有当其提供商类别通过了对该工作负载重要的检查时,路由才具备资格。
区域性 LLM 提供商路由的实用决策树
每当新的工作负载请求 DeepSeek、Qwen 或本地提供商时,都使用此工作流:
- 对工作负载分类:聊天、代码、抽取、Agent 工具使用、视觉、音频、批处理或多模态。
- 识别数据策略:允许的区域、保留敏感性、客户合同,以及是否需要仅本地处理。
- 先选择符合条件的提供商类别,再选择模型名称。
- 运行提供商类别检查:端点、密钥、兼容性、容量、生命周期和回退。
- 使用真实提示词和解析器运行工作负载特定的冒烟测试。
- 路由一小部分预发或金丝雀流量。
- 衡量已接受响应率、p95 延迟、回退率、429/401/403/404 速率,以及每个已接受响应的成本。
- 仅对通过的工作负载类别批准该路由。
- 在该路由获得生产证据之前,保留回滚路径。
以下是相同逻辑的数据策略版本:
regional_llm_provider_routing:
  classify:
    inputs:
      - workload_type
      - required_features
      - data_region
      - customer_policy
      - latency_budget
  provider_classes:
    deepseek:
      checks:
        - base_url_or_gateway_route
        - model_alias_lifecycle
        - required_feature_support
        - account_concurrency_headroom
        - cost_per_accepted_response
    qwen:
      checks:
        - region_endpoint
        - workspace_domain
        - api_key_region_match
        - required_feature_support
        - quota_and_error_classification
    local_gateway:
      checks:
        - host_reachability
        - model_version_pin
        - hardware_headroom
        - compatibility_smoke_test
        - approved_cloud_fallback_policy
  fallback:
    allowed_only_when:
      - same_workload_contract
      - same_data_policy
      - required_features_supported
      - retry_budget_remaining
    otherwise: manual_review
  observe:
    log:
      - route
      - provider_class
      - model
      - endpoint_region
      - status
      - latency_ms
      - input_tokens
      - output_tokens
      - cost
- fallback_reason这就是区域性 LLM 提供商路由的核心。先构建一次策略,然后随着提供商新增、重命名或退役路由,将模型映射进去。
Flatkey 适合在哪里
当运营问题不再是单次 API 调用时,Flatkey 就很有用。问题变成了分散在团队和代理中的提供商密钥、模型目录、工具调用、使用审查和回退策略。
Flatkey 当前公开主页描述了一个密钥可接入官方 GPT、Claude、Gemini、DeepSeek、Qwen 和 GLM APIs,以及 100 多个前沿模型和 1,000 多个 AI 工具。Flatkey 模型目录旨在展示实时模型可用性、定价、端点支持和模型详情页。文档展示了常见迁移模式:保持你的 OpenAI 兼容请求格式,并将 SDK 指向 https://router.flatkey.ai/v1。
就这个主题而言,2026 年 9 月 12 日采样的当前 Flatkey 目录和定价源在 China LLM 组中显示了可用的 DeepSeek 和 Qwen 示例,包括 deepseek-v4-pro、deepseek-v4-flash、deepseek-v3.2-thinking、deepseek-v3.2、qwen3.8-max、qwen3.7-max、qwen3.7-plus、qwen3.6-max-preview,以及多个 Qwen 3.5 路由。请将这些示例视为带日期的目录快照,而不是永久可用性的承诺。
在区域性 LLM 提供商路由中,Flatkey 的正确角色是控制平面:
- 在一个模型目录中比较受支持的托管路由。
- 为应用代码保留稳定的 OpenAI 兼容 base URL。
- 在一个地方跟踪模型、端点类型、状态、token 使用量、延迟和成本。
- 让按提供商类别的路由和回退决策更容易审查。
- 保留对 DeepSeek、Qwen 和本地提供商网关的单独检查,而不是将它们隐藏起来。
如果你已经在使用 Flatkey,可以先查看 模型目录、定价页面,以及 Flatkey API 快速入门。对于与路由相关的上下文,请将本指南与 统一 AI API 工作流、OpenAI API 替代迁移指南、多模态回退路由实战手册以及 AI 路由 API 指标框架搭配阅读。
上线检查清单
在将区域性 LLM 提供商路由投入生产之前,请确认以下事项:
- DeepSeek、Qwen 和本地路由在路由策略中被划分为独立的提供商类别。
- 在流量切换前,已验证 Qwen 端点区域、工作区域名和 API 密钥区域。
- 已审查 DeepSeek 的模型别名、功能支持、token 计价单位和并发行为。
- 本地路由已检查主机可达性、模型版本固定、硬件余量和队列监控。
- 工具调用、流式输出、视觉、音频、推理控制和结构化输出,仅在工作负载确实需要时才进行测试。
- 回退路由保留相同的工作负载契约和数据策略。
- 日志包含提供商类别、端点区域、最终模型、状态、延迟、tokens、成本和回退原因。
- 产品和财务会审查每个已接受响应的成本,而不只是表面的 token 单价。
- 在该路由获得真实生产证据之前,回滚始终保持可用。
当这些检查都到位后,区域性 LLM 提供商路由就会成为一种可重复的运营模型,而不是一组隐藏的提供商例外情况。
常见问题
什么是区域性 LLM 提供商路由?
区域性 LLM 提供商路由是一层策略,用于根据端点区域、API 密钥范围、兼容性、容量、生命周期风险、成本和回退安全性,决定由哪一类提供商处理 AI 请求。
为什么中文 LLM API 路由需要单独检查?
中文 LLM API 路由需要单独检查,因为即使 DeepSeek、Qwen 和其他区域性提供商都提供 OpenAI 兼容接口,它们在端点地理位置、API 密钥区域、兼容性深度、模型生命周期、配额行为和计价单位方面也可能不同。
为什么 DeepSeek Qwen 路由不只是一次模型对比?
DeepSeek Qwen 路由不只是一次对比,因为 DeepSeek 和 Qwen 的运营契约不同。DeepSeek 的检查重点是模型别名、功能支持、token 计价和账户并发。Qwen 的检查重点是区域端点、工作区域名、API 密钥区域和模型家族协议支持。
本地 LLM 提供商网关在什么时候有意义?
当隐私、离线运行、开发控制或成本约束足以证明本地运行模型的合理性,并且你的团队能够负责额外的健康状态、容量、兼容性和版本漂移检查时,本地 LLM 提供商网关就很有意义。
OpenAI 兼容路由可以跳过特定提供商的 QA 吗?
不可以。OpenAI 兼容性可以减少集成工作,但每条路由仍然需要针对工作负载进行 QA,检查工具、流式传输、结构化输出、多模态输入、错误处理、用量字段、速率限制以及回退行为。
结论
正确的区域性 LLM 提供商路由策略,重点不在于一个通用端点,而在于有纪律的提供商检查。尤其是在中文 LLM API 路由同时包含 DeepSeek 和 Qwen,以及本地提供商网关与托管路由并存、用于隐私、离线或成本控制工作流的情况下,更是如此。
首先将DeepSeek Qwen 路由视为一个提供商策略问题。然后在将生产流量迁移之前,验证线上端点、密钥、兼容性、容量、生命周期和成本证据。
当你希望为受支持的托管路由提供一个密钥、一个模型目录、一个 OpenAI 兼容的基础 URL 和一个统一的使用情况入口时,Flatkey 会很有帮助。使用该网关来集中运维,但仍要保留那些让区域性路由更安全的独立提供商检查。


