
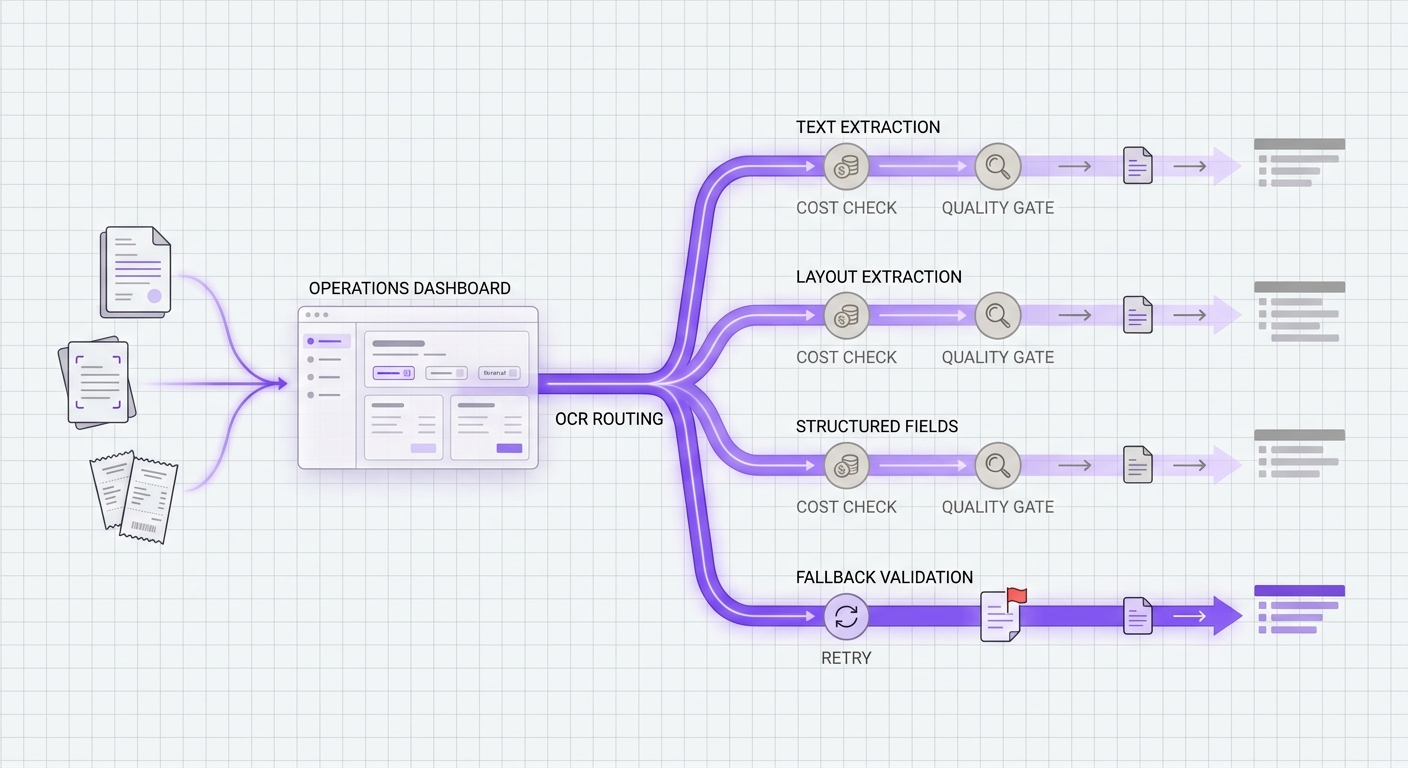
Wenn Sie OCR-Model-Routing planen, liegt der riskante Teil nicht darin, ein OCR-Modell zu finden, das Text aus einem Scan lesen kann. Der riskante Teil besteht darin zu entscheiden, welche Route einfache Bilder verarbeiten soll, welche Route mehrseitige PDFs verarbeiten soll, welche Route strukturierte Felder extrahieren soll und welcher Fallback dasselbe Dokumentenformat überhaupt berühren darf, wenn die erste Route fehlschlägt.
Deshalb sollte OCR-Model-Routing mit der Workload-Policy beginnen, nicht mit einer Vendor-Rangliste. Ein günstiger OCR-Pfad für reinen Text kann für Rechnungen die falsche Wahl sein. Ein hochwertiger Extraktor für strukturierte Daten kann für umfangreiche Archivtexte Verschwendung sein. Ein Fallback kann zuverlässig wirken, bis er stillschweigend Tabellen verwirft, Seitenlimits überschreitet oder die Kosten eines Retry-Sturms verdoppelt.
Dieser Leitfaden gibt Media-, Produkt- und Engineering-Teams eine praktische Möglichkeit, Kosten, Qualität und Fallback-Prüfungen bei der Textextraktion auszubalancieren, bevor sie den Dokumentenverkehr standardisieren. Er betrachtet AI OCR API Routing und Document-AI-Model-Routing als Betriebsentscheidungen, nicht als einmalige Benchmark-Übungen.
Die kurze Antwort
Die sicherste OCR-Model-Routing-Policy trennt Dokumentenaufträge in vier Klassen:
| Route class | Use it for | Primary decision | Fallback rule |
|---|---|---|---|
| Plain text OCR | Bildschirmfotos, gescannte Notizen, einfacher Bildtext, durchsuchbare Archive | Niedrigste freigegebene Kosten pro akzeptierter Seite | Fallback nur auf eine andere Route, die Textvollständigkeit und Sprachabdeckung erhält |
| Layout-aware OCR | PDFs, Quittungen, Berichte, Kataloge, Folien-Exporte | Lese-Reihenfolge, Tabellen, Absätze und Downstream-Chunk-Qualität | Fallback nur, wenn die Layout-Qualität akzeptabel bleibt |
| Structured extraction | Rechnungen, Steuerformulare, Verträge, Ausweise, Claims, Anträge | Feldgenauigkeit und Schema-Stabilität | Fallback nur auf eine Route, die dieselben erforderlichen Felder zurückgeben kann |
| Restricted documents | Regulierte oder vertragskritische Dateien | Datenverarbeitung, Aufbewahrung, Region und Anbieterfreigabe | Fallback nur innerhalb desselben genehmigten Anbieter-Sets |
Das ist der Kern von OCR-Model-Routing: Wählen Sie die Route, die zum Dokument und zur Ausgabeform passt, und erlauben Sie Fallback nur dann, wenn die Backup-Option dieselben Anforderungen an Kosten, Qualität und Kontrolle erfüllen kann.
Warum Textextraktionskosten leicht falsch verstanden werden
Die Kosten einer OCR-API sind selten eine einzige, klare Zahl. Anbieter können einfaches OCR, Layout-Analyse, Formulare, Tabellen, Abfragen, benutzerdefinierte Extraktion oder Batch-Verarbeitung unterschiedlich bepreisen. Manche Seiten werden pro Seite abgerechnet. Einige Workflows kosten mehr, wenn dieselbe Seite strukturierte Felder benötigt. Manche Limits verschieben Traffic von einem synchronen Aufruf in einen asynchronen Job.
Bevor Sie OCR-Routen vergleichen, normalisieren Sie jeden Kandidaten auf dieselbe Betriebseinheit:
| Metrik | Warum sie in die Routing-Tabelle gehört |
|---|---|
| Kosten pro akzeptierter Seite | Der reine Seitenpreis reicht nicht aus, wenn ein Route mehr abgelehnte Ausgaben oder Wiederholungen erzeugt. |
| Kosten pro akzeptiertem strukturierten Dokument | Rechnungen und Formulare sollten anhand der nutzbaren Feldausgabe gemessen werden, nicht nur anhand von OCR-Text. |
| Synchrone Seiten-/Dateilimits | Ein Route, der die Dateiform nicht akzeptieren kann, ist kein gültiger Fallback. |
| Asynchrone Joblimits | Große PDFs und Archivstapel benötigen eine routingsensible Warteschlangenlogik. |
| Funktionstier | Formulare, Tabellen, Abfragen, Unterschriften und Layout können den effektiven Preis verändern. |
| Kontingent- und Drosselungsverhalten | Ein Route, der bei geringem Volumen günstig ist, kann unter Batch-Last ausfallen. |
Offizielle Preisseiten zeigen, warum eine Normalisierung der Einheit wichtig ist. Amazon Textract pricing listet separate APIs und Funktionen für Detect Document Text, Analyze Document, Analyze Expense, Analyze ID und Analyze Lending auf. Die Beispiele zeigen Detect Document Text mit 0,0015 $ pro Seite für die ersten eine Million Seiten in US West (Oregon), während ein Analyze Document-Beispiel für Formulare und Tabellen 0,015 $ pro Tabellen-Seite und 0,05 $ pro Formular-Seite kombiniert. Google Document AI pricing führt Enterprise Document OCR, OCR add-ons, Layout Parser, Custom Extractor und Form Parser als separat bepreiste Oberflächen auf. Azure Document Intelligence sagt, dass die Abrechnung monatlich auf Grundlage des Modelltyps und der analysierten Seiten berechnet wird, und die Seite zu den Dienstlimits verknüpft das Routing-Verhalten mit Dateigröße, Seitenanzahl und Transaktionen-pro-Sekunde-Limits.
Die Lektion für OCR-Model-Routing ist einfach: Vergleichen Sie die auf den ersten Blick genannten Preise der Anbieter nicht, bevor Workload, Ausgabeform, Abrechnungseinheit und Retry-Policy normalisiert sind.
Erstellen Sie die Routing-Tabelle, bevor Sie Modelle benchmarken
Teams führen oft einige Testdokumente durch mehrere OCR-Modelle und wählen das Modell aus, das "am besten aussieht". Das kann für eine Demo funktionieren, ergibt aber keine belastbare Routing-Policy.
Erstellen Sie zuerst die Routing-Tabelle. Für das Routing von Document-AI-Modellen ist diese Tabelle der Vertrag, der einfaches OCR, Layout-Extraktion und strukturierte Extraktion davor bewahrt, in einem einzigen Default-Route zusammenzufallen. Wenn Sie die Routing-Qualität bereits in einem Gateway verfolgen, kombinieren Sie diese Tabelle mit einer AI routing API metrics-Scorecard:
| Arbeitslast | Beispiel-Eingabe | Erforderliche Ausgabe | Standardverhalten der Route | Ablehnungsbedingung |
|---|---|---|---|---|
| OCR für durchsuchbare Archive | Gescannt PDFs, Screenshots, Legacy-Berichte | Klartext mit akzeptabler Lesereihenfolge | Günstigste zugelassene Route | Fehlende Seiten, falsche Sprache, fehlerhafte Reihenfolge |
| Erfassung von Belegen oder Rechnungen | Belege, Rechnungen, Zahlungsdokumente | Felder, Summen, Daten, Positionen | Strukturierte Extraktionsroute | Erforderliches Feld fehlt oder geringe Konfidenz |
| Verständnis von Katalogen oder Berichten | Produktkataloge, dichte Berichte, Foliensätze | Layoutbewusster Text und Tabellen | Layout-Route mit Tabellenprüfungen | Tabellen zusammengeführt, Spalten verloren, Abschnittsreihenfolge beschädigt |
| Prüfung von Ausweisen oder Anträgen | Ausweise, Anträge, Onboarding-Formulare | Bestimmte Felder plus Prüfprotokoll | Zugelassene eingeschränkte Route | Anbieter nicht freigegeben, Aufbewahrung unbekannt, Feldabweichung |
| Batch-Migration | Große PDFs oder Bildarchive | Vollständige Seitenabdeckung | Async-Route mit Puffer für Seitenobergrenze | Job zu groß, Drosselung, unvollständiger Abschluss |
Sobald diese Tabelle existiert, wird die Modellauswertung nützlicher. Sie fragen nicht mehr "Welches OCR-Modell ist am besten?" Sie fragen "Welche Route ist für genau diese Dokumentenklasse bei diesen Kosten und diesem Fallback-Risiko akzeptabel?" Das ist der praktische Unterschied zwischen einer Demo und einem AI OCR API Routing, das Produktionsverkehr standhalten kann.
Qualitäts-Gates Sollten Zur Ausgabe Passen, Nicht Zur Demo
OCR-Qualität braucht unterschiedliche Gates für unterschiedliche Arbeitslasten.
Für OCR in Klartext messen Sie:
- Seitenabdeckung.
- Vollständigkeit von Zeichen und Wörtern.
- Lesereihenfolge.
- Toleranz gegenüber Sprache und Handschrift.
- Den Anteil der Seiten, die eine menschliche Prüfung erfordern.
Für layoutbewusste OCR messen Sie:
- Absatzgruppierung.
- Überschriftenhierarchie.
- Tabellenbegrenzungen.
- Spaltenreihenfolge.
- Ob die Qualität von nachgelagertem Search, Retrieval oder der Review-UI verbessert wird.
Für strukturierte Extraktion messen Sie:
- Präzision erforderlicher Felder.
- Recall erforderlicher Felder.
- Normalisierungsstabilität für Daten, Beträge, Namen und IDs.
- Kalibrierung der Konfidenz.
- Schema-Kompatibilität über primäre und Fallback-Routen hinweg.
Hier scheitern viele OCR-Model-Routing-Projekte. Ein Fallback, der Klartext zurückgibt, ist nicht gleichwertig zu einem strukturierten Rechnungsextraktor. Eine Route, die die meisten Wörter erhält, aber Tabellenbegrenzungen verliert, kann dennoch Retrieval- oder Review-Workflows beeinträchtigen. Ein hochgenaues Modell, das dieselbe Seitenzahl nicht verarbeiten kann, ist kein sicherer Fallback für Batch-PDFs.
Fallback-Prüfungen Sind Eine Produktanforderung
Fallback sollte nicht bedeuten "einen anderen OCR-Anbieter ausprobieren." Es sollte bedeuten "einen anderen zugelassenen Pfad ausprobieren, der denselben Arbeitslastvertrag erfüllen kann."
Verwenden Sie diese Checkliste, bevor eine Route als Fallback verwendet werden kann:
| Fallback-Prüfung | Bestehensbedingung |
|---|---|
| Gleiche Dokumentklasse | Der Fallback akzeptiert denselben Dateityp, dieselbe Seitenanzahl und dieselbe Größe. |
| Gleiches Ausgabe-Contract | Der Fallback liefert denselben erforderlichen Text, dasselbe Layout oder dieselben Felder zurück. |
| Gleiche Datenkontrollen | Der Fallback erfüllt dieselben Vorgaben zu Aufbewahrung, Region und Kundenvertrag. |
| Gleiche Observability | Der Fallback protokolliert Route, Kosten, Latenz, Fehler, Konfidenz und Ablehnungsgrund. |
| Begrenzte Retry-Kosten | Retry- und Fallback-Budgets sind pro Job, Mandant und Batch begrenzt. |
| Pfad zur manuellen Prüfung | Nicht äquivalente Fehler gehen zur Prüfung statt in eine stille Verschlechterung. |
Amazon Textract ist ein nützliches Beispiel dafür, warum die Fallback-Berechtigung Dokumentgrenzen einschließen muss: Die Dokumentgrenzen sagen, dass synchrone PDF- und TIFF-Operationen auf eine Seite beschränkt sind, während asynchrone PDF- und TIFF-Operationen bis zu 3.000 Seiten erlauben. Die Dienstgrenzen von Azure Document Intelligence dokumentieren ein Standardlimit von 15 TPS für Analyze-Transaktionen der Standard-Tier, eine maximale Dokumentgröße von 500 MB und ein Analyse-Limit von 2.000 Seiten. Die Quotas von Google Document AI dokumentieren Processor-Quotas, Limits für Online-Anfragen und Seiten-pro-Minute-Quotas für generative Processor-Versionen.
Diese Einschränkungen sind keine Randfälle. Sie entscheiden darüber, ob ein Fallback gültig ist.
Ein praktischer Entscheidungsbaum für OCR-Model-Routing
Verwenden Sie diesen Entscheidungsbaum, wenn ein neuer Dokument-Job in die Pipeline eintritt:
- Klassifizieren Sie das Dokument, bevor Sie eine OCR-Route aufrufen.
- Entscheiden Sie, ob die Ausgabe Nurtext, Layout oder strukturierte Felder benötigt.
- Schließen Sie Routen aus, die Aufbewahrungs-, Regions-, Vertrags-, Dateityp-, Seitenzahl- oder Quota-Anforderungen nicht erfüllen.
- Schätzen Sie die Kosten pro akzeptierter Ausgabe, nicht nur die Kosten pro Rohseite.
- Führen Sie die Primärroute aus.
- Wenden Sie workload-spezifische Qualitäts-Gates an.
- Wiederholen Sie nur bei transienten Fehlern oder sicheren idempotenten Fehlern.
- Fallen Sie nur innerhalb derselben Routenkategorie zurück.
- Senden Sie nicht äquivalente Fehler zur Prüfung oder in eine Batch-Warteschlange.
- Protokollieren Sie die Routenscheidung, Kosten, Konfidenz, Fallback-Grund und den final akzeptierten/abgelehnten Status.
Hier ist die Routing-Richtlinie in kompakter Form:
document_job:
  classify:
    inputs: [file_type, page_count, document_type, customer_tier, data_region]
  exclude:
    - route_not_approved_for_data_policy
    - route_page_limit_below_job_size
    - route_missing_required_output_contract
  choose_primary:
    optimize_for: cost_per_accepted_output
    guardrails: [quality_gate, latency_budget, quota_headroom]
  fallback:
    allowed_only_when:
      - transient_error
      - same_route_class
      - same_output_contract
      - retry_budget_remaining
    otherwise: manual_review
  observe:
    log: [route, model, cost, latency, confidence, error_class, fallback_reason]
Die Richtlinie ist wichtiger als die Modellauswahl. Neue OCR-Modelle können später hinzugefügt werden, ohne den Dokument-Workflow neu zu schreiben.
Wo Flatkey in OCR-Model-Routing passt
Flatkey ist bei OCR-Model-Routing nützlich, wenn das Team eine operative Schicht für Modellzugriff, Ausgaben-Transparenz und Routenprüfung möchte, statt Provider-Keys über Agenten, Jobs und Services zu verstreuen. Wenn euer Team noch direkte Provider-Konten anbinden muss, beginnt mit dem Workflow der einheitlichen KI-API und ordnet dann OCR-spezifische Fallback-Regeln dem Playbook zur Modell-Fallback-Strategie zu.
Flatkeys aktuelle öffentliche Website positioniert das Produkt rund um einen Key, ein Balance-Modell und Tool-Nutzung, nutzungsbasierte Abrechnung bei erfolgreichen Aufrufen, ein gemeinsames Ledger und ein öffentliches Modellverzeichnis mit Live-Verfügbarkeit, Preisen, Endpoint-Support und Modell-Detailseiten. Für OCR-Workflows macht das das Gateway vor allem als Control Plane relevant: verfügbare multimodale oder dokumentenfähige Routen validieren, festlegen, welche Workloads sie nutzen dürfen, und Kosten sowie Fehler auf Routenebene an einem Ort prüfen.
Behandelt keinen Gateway-Katalog als Ersatz für euren eigenen OCR-Qualitätstest. Seht ihn als den Ort, an dem freigegebene Routen, Nutzungsdaten, Fallback-Richtlinien und Kostenkontrollen einfacher zu betreiben sind. Wenn ihr bereit seid, die Wirtschaftlichkeit von Routen zu vergleichen, nutzt die aktuelle Flatkey-Preisseite statt veralteter Modellnamen aus alten Implementierungsnotizen.
Launch-Checkliste
Bevor ihr OCR-Model-Routing in die Produktion überführt, bestätigt diese Punkte:
- Jede Dokumentklasse hat eine Standardroute und eine zulässige Fallback-Klasse.
- Jede Route hat einen normalisierten Preis pro akzeptierter Seite oder akzeptiertem strukturierten Dokument.
- Jeder strukturierte Workflow hat Qualitäts-Gates auf Feldebene.
- Sync- und Async-Seitenlimits werden mit echten Dateien getestet, nicht aus Beispielen angenommen.
- Kontingent- und Throttling-Verhalten ist in Lasttests abgebildet.
- Geschützte Dokumente dürfen nur freigegebene Routen nutzen.
- Fehlgeschlagene Jobs protokollieren, warum ein Fallback ausgelöst wurde und ob die Ausgabe akzeptiert wurde.
- Finance kann Ausgaben nach Route, Workload, Tenant und Fallback-Grund nachvollziehen.
- Product hat einen manuellen Prüfpfad für nicht äquivalente Fehler.
OCR-Model-Routing funktioniert, wenn es im Betrieb langweilig ist: Die günstige Arbeit bleibt günstig, die strukturierte Arbeit bekommt das richtige Modell, und ein Fallback verändert den Dokumentenvertrag nie unbemerkt.
FAQ
Was ist OCR-Model-Routing?
OCR-Model-Routing ist die Policy-Schicht, die jeden Dokumentenauftrag basierend auf Dokumenttyp, erforderlichem Output, Kosten, Qualitätsanforderungen und Fallback-Einschränkungen an eine OCR- oder Document-AI-Route sendet.
Wie sollten Teams die Kosten von OCR-APIs vergleichen?
Vergleicht die Kosten von OCR-APIs anhand des akzeptierten Outputs. Bei reinem OCR ist das meist der Preis pro akzeptierter Seite. Bei Rechnungen, Formularen, Verträgen und Ausweisen ist es meist der Preis pro akzeptiertem strukturierten Dokument nach Wiederholungen und abgelehnten Prüfungen.
Wann wird Fallback bei OCR unsicher?
Fallback wird unsicher, wenn die Backup-Route nicht dieselbe Dateiform, dieselbe Seitenanzahl, dieselbe Datenrichtlinie oder denselben Ausgabe-Vertrag akzeptieren kann. Eine reine Text-OCR-Route ist kein sicherer Fallback für einen Workflow, der strukturierte Rechnungsfelder erfordert.
Sollte ein OCR-Modell jeden Dokumenttyp verarbeiten?
Meistens nein. Einfaches OCR, Layout-Extraktion, strukturierte Extraktion, große PDF-Stapel und geschützte Dokumente haben unterschiedliche Anforderungen an Kosten, Qualität und Kontrolle.
Wie hilft Flatkey beim OCR-Model-Routing?
Flatkey kann Teams dabei helfen, OCR-Model-Routing über einen Schlüssel, ein Guthaben, Verfügbarkeitsprüfungen der Modelle, Transparenz bei der Nutzung und Prüfungen auf Routing-Ebene zu betreiben. Teams müssen vor der Umstellung des Produktionsverkehrs weiterhin eigene Tests zur Dokumentqualität durchführen.


