
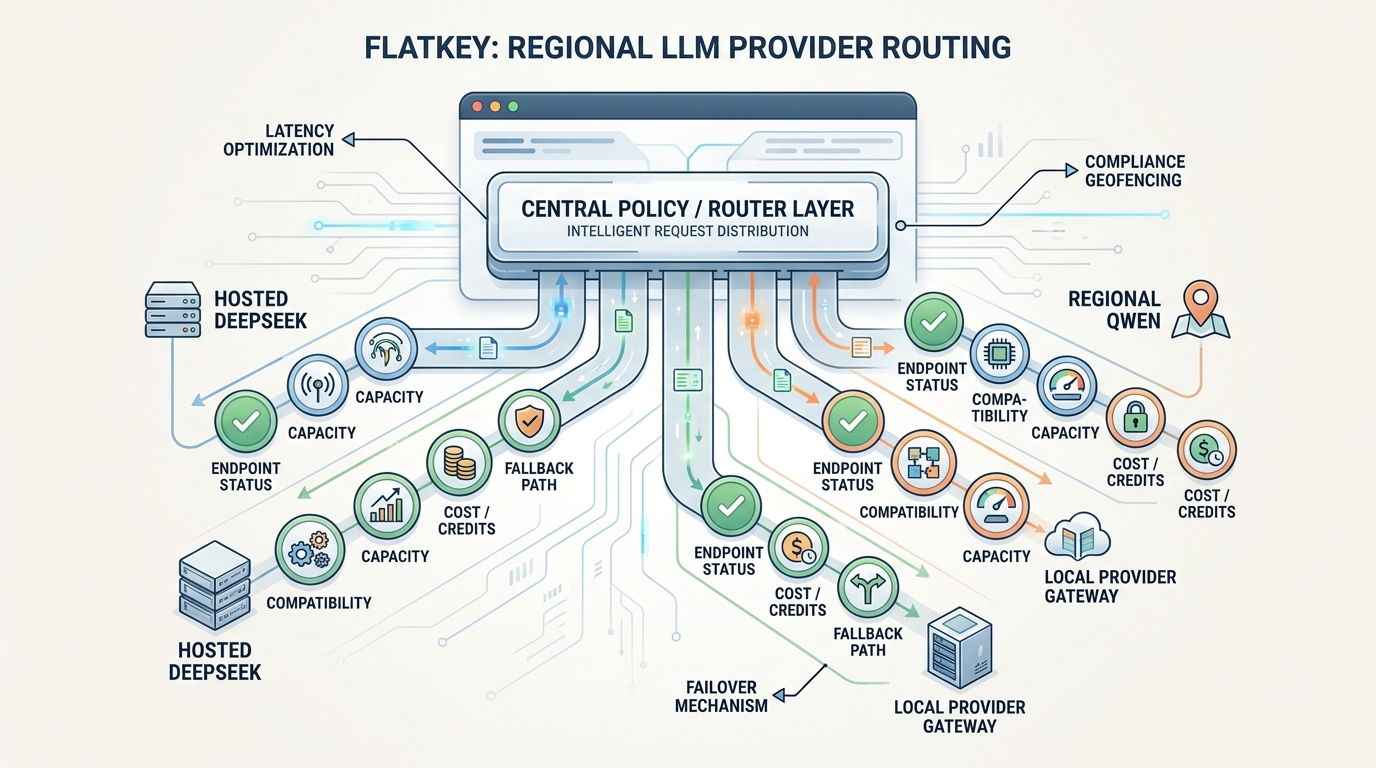
Если вы планируете региональную маршрутизацию LLM-провайдеров, риск заключается не в поиске ещё одной OpenAI-совместимой конечной точки. Риск в том, чтобы решить, когда маршрут DeepSeek можно считать таким же, как у облачного хостинг-провайдера, когда маршруту Qwen нужны проверки конечной точки с привязкой к региону, и когда локальному провайдеру нужны инфраструктурные проверки, прежде чем он сможет получать production-трафик.
Именно поэтому региональная маршрутизация LLM-провайдеров должна начинаться с класса провайдера, а не с языка описания модели в рейтинге. DeepSeek, Qwen и локальные runtime-среды могут выглядеть одинаково на уровне SDK, но у них не совпадают региональный контракт, риск жизненного цикла, сигнал ёмкости и правила безопасного fallback.
Это руководство даёт AI product-командам практическую политику для региональной маршрутизации LLM-провайдеров между DeepSeek, Qwen и локальными gateway провайдера. Используйте его, прежде чем переводить production-трафик, добавлять fallback или стандартизировать общий AI gateway между командами.
Краткий ответ
Более безопасная политика региональной маршрутизации LLM-провайдеров сначала разделяет маршруты на три класса провайдеров, а уже потом сравнивает названия моделей:
| Класс провайдера | Первые проверки | Почему нужна отдельная политика |
|---|---|---|
| DeepSeek | Формат API, псевдоним модели, поддержка функций, единица тарификации токенов, лимит конкурентности | DeepSeek предоставляет пути, совместимые с OpenAI и Anthropic, но безопасность маршрута по-прежнему зависит от жизненного цикла модели, режима ценообразования и ёмкости на уровне аккаунта. |
| Qwen / Alibaba Cloud Model Studio | Регион конечной точки, домен workspace, API-ключ с привязкой к региону, оговорки по функциям OpenAI-совместимости | Маршрутизация Qwen по своей сути региональная; конечная точка, workspace ID и регион API-ключа могут определять, будет ли вызов успешным. |
| Gateway локального провайдера | Доступность хоста, закрепление модели, запас ресурсов локального оборудования, пробелы совместимости, изоляция fallback | Локальный маршрут отказывает как инфраструктура, которой вы управляете, а не как хостируемый API-аккаунт. |
Flatkey подходит для этого workflow как общий gateway-слой: один ключ, один каталог моделей, одна OpenAI-совместимая поверхность маршрута и один экран использования для поддерживаемых моделей и инструментов. Но gateway не должен стирать проверки, специфичные для провайдера. Он должен делать эти проверки явными, наблюдаемыми и более удобными для ревью.
Что на самом деле оптимизирует региональная маршрутизация LLM-провайдеров
Хорошая региональная маршрутизация LLM-провайдеров не спрашивает только, какая модель показывает лучший результат в бенчмарке. Она спрашивает, какой класс провайдера может безопасно обслужить запрос при текущих правилах продукта, региона и fallback-политики.
В production региональная маршрутизация LLM-провайдеров обычно одновременно балансирует шесть вещей:
- География конечной точки: некоторые провайдеры предоставляют разные базовые URL в зависимости от региона, и это может менять задержку, настройку аккаунта, проверку соответствия требованиям к резидентности данных и схему отказоустойчивости.
- Глубина совместимости: совместимость с OpenAI может покрывать chat completions, но при этом отличаться в инструментах, потоковой передаче, vision, аудио, управляющих параметрах reasoning или полях использования.
- Стабильность жизненного цикла: псевдонимы моделей, preview-модели, устаревшие маршруты и compatibility shims могут менять запрос, даже если вызов SDK по-прежнему завершается успешно.
- Модель емкости: параллелизм на уровне аккаунта отличается от rate limits, и и то, и другое отличается от узкого места локального GPU или CPU.
- Безопасность fallback: резервный маршрут полезен только если он сохраняет тот же регион, те же функции, данные и соглашение по качеству.
- Прозрачность затрат: командам нужно сравнивать стоимость за принятого ответа, а не только номинальные цены за токены.
Именно в этом и заключается настоящая задача региональной маршрутизации LLM-провайдеров. Это не одна универсальная абстракция конечной точки. Это политика проверки провайдеров, которая определяет, какие маршруты допустимы для какой нагрузки.
Начните маршрутизацию китайских LLM API с разделения классов провайдеров
Первая ошибка в маршрутизации китайских LLM API — рассматривать каждый маршрут, связанный с Китаем или размещенный в Азии, как одну категорию. Это слишком сильно скрывает операционные различия.
DeepSeek и Qwen оба важны для маршрутизации китайских LLM API, но их проверки маршрутизации не одинаковы. В публичной документации API DeepSeek подчеркивается доступ, совместимый с OpenAI и Anthropic, с конкретными именами моделей и параллелизмом на уровне аккаунта. В документации Alibaba Cloud Model Studio для Qwen подчеркивается доступ, совместимый с OpenAI, через региональные конечные точки, домены, специфичные для рабочего пространства, и API-ключи, привязанные к региону, в котором они были созданы.
Используйте это разделение, прежде чем направлять трафик:
| Вопрос маршрутизации | DeepSeek | Qwen / Model Studio | Шлюз локального провайдера |
|---|---|---|---|
| Региональна ли конечная точка? | Проверьте официальный базовый URL и любой маршрут шлюза. | Проверьте точную региональную конечную точку и домен, специфичный для рабочей области. | Проверьте хост, частную сеть или адрес локальной среды выполнения. |
| Привязан ли API-ключ к региону? | Проверьте доступ к аккаунту и модели. | Проверьте, что API-ключ был создан в том же регионе, что и конечная точка. | Проверьте локальную аутентификацию, доступ к сети и разрешения машины. |
| Достаточна ли совместимость? | Тестируйте chat, tools, reasoning, формат Anthropic и Responses API только если ваша рабочая нагрузка использует их. | Тестируйте chat, tools, streaming, поддержку multimodal и оговорки по семейству моделей в зависимости от выбранной модели. | Считайте совместимость частичной, пока не пройдут ваши собственные smoke-тесты. |
| Каков сигнал пропускной способности? | Конкурентность на уровне аккаунта и поведение 429. | Регион, рабочая область, квота, состояние конечной точки и ограничения провайдера. | Запас по GPU/CPU/RAM, состояние демона, глубина очереди и время загрузки модели. |
| Какой fallback разрешен? | Хостируемый маршрут с совпадающим классом функций и политики. | Другой одобренный маршрут в той же региональной политике или одобренный хостируемый fallback. | Второй локальный узел или заранее одобренный облачный маршрут с явной проверкой политики данных. |
Если вы пропустите это разделение, региональная маршрутизация LLM-провайдеров превратится в гадание. Одна и та же рабочая нагрузка может перемещаться между тремя очень разными классами провайдеров, и никто не сможет объяснить, какие проверки были применены.
DeepSeek требует отдельных проверок, даже когда SDK выглядит знакомо
Официальная документация DeepSeek делает миграцию удобной: API использует формат, совместимый с OpenAI и Anthropic, с https://api.deepseek.com для вызовов в формате OpenAI и https://api.deepseek.com/anthropic для вызовов в формате Anthropic. Такая совместимость полезна, но она не отменяет необходимости в проверках, специфичных для DeepSeek.
Для маршрутизации DeepSeek Qwen DeepSeek следует проверять отдельно по четырем причинам.
Во-первых, алиасы моделей и примечания к жизненному циклу влияют на безопасность маршрута. По состоянию на 12 сентября 2026 года в документации DeepSeek текущими именами моделей указаны deepseek-flash и deepseek-v4-pro. В документации также отмечено, что устаревшие имена deepseek-v4-flash и deepseek-v4-flash-vision-exp по-прежнему принимаются, но запросы обслуживаются новой моделью Flash и тарифицируются по цене Flash. Это как раз та деталь жизненного цикла, которую маршрутизатор должен показывать, а не скрывать.
Во-вторых, поддержка функций зависит от модели. В таблице цен DeepSeek указаны JSON output, вызовы tool, Responses API, Anthropic API, beta chat prefix completion, beta FIM и поддержка vision по моделям. Это означает, что ваша политика региональной маршрутизации LLM-провайдеров должна тестировать только те функции, которые реально использует рабочая нагрузка, и не должна предполагать, что любой маршрут DeepSeek взаимозаменяем с другим.
В-третьих, ценообразование задаётся на стороне провайдера. DeepSeek публикует цены в единицах по 1 млн токенов и отдельно указывает тарифы для cache hit, cache miss, выходных данных, peak и off-peak. Командам продукта не нужно хардкодить каждую цену в логику маршрутизации, но им нужно, чтобы роутер логировал достаточно данных об использовании, чтобы сравнивать DeepSeek с Qwen, GPT, Claude, Gemini или локальными маршрутами по стоимости на каждый принятый ответ.
В-четвёртых, ёмкость определяется на уровне аккаунта. На странице лимитов DeepSeek указано, что ограничения на параллелизм рассчитываются на уровне аккаунта независимо от API-ключа, а запросы сверх лимита параллелизма возвращают HTTP 429. Поэтому проверки состояния для маршрутизации региональных LLM-провайдеров должны включать запас по параллелизму, а не только проверку того, что небольшой тестовый запрос вернул 200.
Урок прост: не начинайте маршрутизацию DeepSeek и Qwen с фразы «оба совместимы с OpenAI». Начинайте с проверок, зависящих от конкретного провайдера: жизненный цикл, функции, цена и ёмкость — именно они определяют, безопасен ли маршрут для этой нагрузки.
Qwen требует отдельных проверок, потому что регион — часть API-контракта
Документация Alibaba Cloud Model Studio по Qwen — хороший пример того, почему для маршрутизации китайских LLM API нужны региональные проверки. В руководстве по совместимости с OpenAI говорится, что модели Qwen в Model Studio поддерживают интерфейсы, совместимые с OpenAI, и что команды могут перенести существующий код OpenAI, изменив API-ключ, base URL и имя модели.
Но в том же руководстве региональный контракт тоже прописан явно. Там перечислены разные base URL для Сингапура, Вирджинии, Пекина, Гонконга и Японии. Также говорится, что Model Studio ввёл доменные имена, специфичные для рабочих пространств, для Пекина, Сингапура и Гонконга, и что {WorkspaceId} следует заменить на фактический ID рабочего пространства.
Это означает, что маршрутизация региональных LLM-провайдеров для Qwen — это не просто «выбрать имя модели». Нужно проверить:
- к какому региональному endpoint разрешено обращаться этой нагрузке
- требуется ли домен, специфичный для рабочего пространства
- был ли API-ключ создан в том же регионе, что и endpoint
- возвращает ли несоответствие между регионами ошибку аутентификации
- поддерживает ли выбранная модель Qwen или сторонняя модель именно те протокольные функции, которые использует нагрузка
В руководстве по совместимости Qwen также указано, что поддерживаемые модели, совместимые с OpenAI, включают большие языковые модели Qwen, Qwen-VL, Qwen-Coder, Qwen-Omni, Qwen-Math, DeepSeek, Kimi, GLM и MiniMax. Отдельно отмечается, что Qwen-Audio не поддерживает протокол, совместимый с OpenAI, и должна использовать протокол DashScope.
Это оговорка важна для маршрутизации DeepSeek и Qwen. Семейство моделей может находиться рядом в одном каталоге или облачной консоли, но при этом требовать другого протокольного пути. Если ваш продукт использует инструменты, потоковую передачу, аудио, зрение или мультимодальные входные данные, маршрутизация Qwen должна пройти smoke-тесты на уровне функций до переключения production-трафика.
Шлюзу локального LLM-провайдера нужны инфраструктурные проверки
Третья ошибка в маршрутизации региональных LLM-провайдеров — предполагать, что локальный шлюз провайдера ведёт себя как любой другой облачно размещённый провайдер. Это не так.
Документация Ollama по совместимости с OpenAI показывает, почему это так. Ollama предоставляет локальные Chat Completions, совместимые с OpenAI, через http://localhost:11434/v1, и в документации эта поддержка описана как начальная и экспериментальная. Это полезно для локальной разработки и контролируемых внутренних рабочих процессов, но не следует считать это тем же классом риска, что и размещённый маршрут.
С локальным шлюзом провайдера проверки маршрутизации меняются:
- Может ли рабочая нагрузка достичь локального хоста или маршрута частной сети из среды, в которой она работает?
- Зафиксирована ли версия модели, или её может изменить обновление от разработчика либо пакета?
- Поддерживает ли локальный маршрут те же возможности запросов, что и облачный маршрут?
- Хватает ли GPU, CPU, памяти и запаса по очереди для реальных всплесков нагрузки?
- Предоставляет ли маршрут сигналы задержки, ошибок и насыщения так же, как размещённые провайдеры?
- Разрешён ли переход на резервного облачного провайдера в соответствии с политикой данных клиента?
Эти проверки — инфраструктурные, а не только API-проверки. Локальный шлюз провайдера LLM может быть правильным решением для конфиденциальности, офлайн-работы или контроля затрат, но только если региональная маршрутизация LLM-провайдеров рассматривает здоровье локального узла, ёмкость, поддержку функций и дрейф версий как первоочередные ограничения.
Используйте матрицу проверок провайдера, прежде чем перенаправлять трафик
Устойчивая реализация региональной маршрутизации LLM-провайдеров требует матрицы, которую смогут читать инженерные, продуктовые, security- и финансовые команды.
| Класс проверки | Маршрут DeepSeek | Маршрут Qwen | Маршрут локального провайдера |
|---|---|---|---|
| Endpoint | Подтвердите официальный базовый URL или базовый URL шлюза. | Подтвердите региональный endpoint и домен, специфичный для workspace. | Подтвердите localhost, private endpoint или URL локального шлюза. |
| API key | Подтвердите доступ к аккаунту и модели. | Подтвердите, что регион API key совпадает с регионом endpoint. | Подтвердите локальную аутентификацию и доступ к среде. |
| Compatibility | Тестируйте формат OpenAI, формат Anthropic, Responses API, tools, vision и controls for thinking только там, где это нужно. | Тестируйте chat, совместимый с OpenAI, плюс оговорки семейства моделей, особенно для audio, vision, tools и streaming. | Тестируйте точную форму request/response; предполагайте частичную совместимость, пока она не подтверждена. |
| Capacity | Отслеживайте одновременную нагрузку аккаунта, частоту 429, latency и длительность запроса. | Отслеживайте региональную квоту, состояние endpoint, причины 401/403/404 и поведение throttling у провайдера. | Отслеживайте насыщение машины, глубину очереди, время загрузки модели и перезапуски daemon. |
| Cost | Нормализуйте экономику cache hit, cache miss, output, peak и off-peak в стоимость на принятый response. | Нормализуйте стоимость токенов плюс поведение региона/workspace в стоимость на принятый response. | Включайте стоимость оборудования, операций, задержки очереди и cloud fallback. |
| Lifecycle | Следите за alias модели, legacy-именами, статусом preview и изменениями функций. | Следите за изменениями региональных endpoint, поддержкой семейств моделей и исключениями протокола. | Следите за версией runtime, весами модели, quantization и обновлениями локальных пакетов. |
| Fallback | Используйте только одобренные hosted-маршруты с совпадающим классом функций и политик. | Используйте только альтернативы, одобренные по региону или по политике. | Используйте только второй локальный node или одобренный cloud route после проверки data-policy. |
Эта матрица не позволяет маршрутизации DeepSeek Qwen превратиться в переключение модели в одну строку. Маршрут допустим только тогда, когда его класс провайдера проходит проверки, важные для данной нагрузки.
Практическое дерево решений для региональной маршрутизации LLM-провайдеров
Используйте этот workflow всякий раз, когда новая нагрузка запрашивает DeepSeek, Qwen или локального провайдера:
- Классифицируйте нагрузку: chat, code, extraction, agent tool use, vision, audio, batch или multimodal.
- Определите политику данных: разрешенный регион, чувствительность к хранению, контракт с клиентом и требуется ли обработка только локально.
- Сначала выберите допустимые классы провайдеров, а уже потом — имена моделей.
- Выполните проверку класса провайдера: endpoint, key, compatibility, capacity, lifecycle и fallback.
- Запустите smoke test, специфичный для этой нагрузки, используя реальные prompts и parsers.
- Направьте небольшой staging- или canary-сегмент.
- Измерьте accepted response rate, p95 latency, fallback rate, rate 429/401/403/404 и cost per accepted response.
- Одобрите маршрут только для тех классов нагрузок, для которых он прошел проверку.
- Сохраняйте путь отката, пока маршрут не получит подтверждение в production.
Вот та же логика в виде данных политики:
regional_llm_provider_routing:
  classify:
    inputs:
      - workload_type
      - required_features
      - data_region
      - customer_policy
      - latency_budget
  provider_classes:
    deepseek:
      checks:
        - base_url_or_gateway_route
        - model_alias_lifecycle
        - required_feature_support
        - account_concurrency_headroom
        - cost_per_accepted_response
    qwen:
      checks:
        - region_endpoint
        - workspace_domain
        - api_key_region_match
        - required_feature_support
        - quota_and_error_classification
    local_gateway:
      checks:
        - host_reachability
        - model_version_pin
        - hardware_headroom
        - compatibility_smoke_test
        - approved_cloud_fallback_policy
  fallback:
    allowed_only_when:
      - same_workload_contract
      - same_data_policy
      - required_features_supported
      - retry_budget_remaining
    otherwise: manual_review
  observe:
    log:
      - route
      - provider_class
      - model
      - endpoint_region
      - status
      - latency_ms
      - input_tokens
      - output_tokens
      - cost
      - fallback_reason
Это основа региональной маршрутизации LLM-провайдеров. Сначала создайте политику, а затем сопоставляйте с ней модели по мере того, как провайдеры добавляют, переименовывают или выводят маршруты из эксплуатации.
Где подходит Flatkey
Flatkey полезен, когда операционная проблема уже не сводится к одному API-вызову. Проблема — в разрозненных ключах провайдеров, каталогах моделей, вызовах инструментов, обзоре использования и политике fallback между командами и агентами.
На текущей публичной домашней странице Flatkey описывается один ключ для официальных API GPT, Claude, Gemini, DeepSeek, Qwen и GLM, а также более 100 frontier-моделей и более 1 000 AI-инструментов. Каталог моделей Flatkey предназначен для отображения доступности моделей в реальном времени, цен, поддержки endpoint'ов и страниц с подробностями о моделях. В документации показан типичный путь миграции: сохранить совместимый с OpenAI формат запроса и направить SDK на https://router.flatkey.ai/v1.
Для этой темы текущий каталог Flatkey и лента цен, выборка из которых была сделана 12 сентября 2026 года, показали доступные примеры DeepSeek и Qwen в группе China LLM, включая deepseek-v4-pro, deepseek-v4-flash, deepseek-v3.2-thinking, deepseek-v3.2, qwen3.8-max, qwen3.7-max, qwen3.7-plus, qwen3.6-max-preview и несколько маршрутов Qwen 3.5. Рассматривайте эти примеры как устаревший снимок каталога, а не как постоянное обещание доступности.
Правильная роль Flatkey в региональной маршрутизации LLM-провайдеров — это control plane:
- Сравнивать поддерживаемые hosted-маршруты в одном каталоге моделей.
- Сохранять стабильный OpenAI-compatible base URL для кода приложения.
- Отслеживать модель, тип endpoint'а, статус, использование токенов, задержку и стоимость в одном месте.
- Упрощать проверку решений по маршрутизации между классами провайдеров и fallback.
- Сохранять отдельные проверки для DeepSeek, Qwen и gateway локальных провайдеров вместо того, чтобы скрывать их.
Если вы уже используете Flatkey, начните с просмотра каталога моделей, страницы с тарифами и быстрого старта Flatkey API. Для контекста, связанного с маршрутизацией, дополните это руководство рабочим процессом Unified AI API, руководством по миграции на альтернативу OpenAI API, практическим руководством по мультимодальной fallback-маршрутизации и фреймворком метрик для AI routing API.
Чек-лист перед запуском
Перед тем как вывести маршрутизацию региональных LLM-провайдеров в production, подтвердите следующие пункты:
- DeepSeek, Qwen и локальные маршруты определены как отдельные классы провайдеров в политике маршрутизации.
- Регион endpoint’а Qwen, домен workspace и регион API-ключа проверяются до переноса трафика.
- Псевдонимы моделей DeepSeek, поддержка функций, единицы тарификации токенов и поведение при конкурентном доступе проверены.
- Для локальных маршрутов проверены доступность хоста, закрепление версии модели, запас по hardware и мониторинг очереди.
- Использование инструментов, streaming, vision, audio, control reasoning и structured output тестируются только там, где это требуется рабочей нагрузкой.
- Fallback-маршруты сохраняют тот же контракт рабочей нагрузки и политику данных.
- Логи включают класс провайдера, регион endpoint’а, финальную модель, статус, задержку, токены, стоимость и причину fallback.
- Продукт и финансы оценивают стоимость за принятый ответ, а не только заявленную цену за токены.
- Rollback остается доступным до тех пор, пока у маршрута нет реальных production-доказательств.
Когда эти проверки выполнены, маршрутизация региональных LLM-провайдеров становится повторяемой операционной моделью, а не скрытым набором исключений для провайдеров.
FAQ
Что такое маршрутизация региональных LLM-провайдеров?
Маршрутизация региональных LLM-провайдеров — это слой политики, который решает, какой класс провайдера должен обрабатывать запрос к ИИ, на основе региона endpoint’а, области действия API-ключа, совместимости, емкости, рисков жизненного цикла, стоимости и безопасности fallback.
Почему маршрутизация Chinese LLM API требует отдельных проверок?
Маршрутизация Chinese LLM API требует отдельных проверок, потому что DeepSeek, Qwen и другие региональные провайдеры могут отличаться по географии endpoint’а, региону API-ключа, глубине совместимости, жизненному циклу модели, поведению квот и единицам тарификации, даже если они предоставляют OpenAI-совместимые интерфейсы.
Почему маршрутизация DeepSeek Qwen — это не просто сравнение одной модели?
Маршрутизация DeepSeek Qwen — это не просто одно сравнение, потому что у DeepSeek и Qwen разные операционные контракты. Проверки DeepSeek сосредоточены на псевдонимах моделей, поддержке функций, тарификации токенов и конкурентном доступе аккаунта. Проверки Qwen сосредоточены на регионе endpoint’а, домене workspace, регионе API-ключа и поддержке протокола семейства моделей.
Когда имеет смысл локальный шлюз LLM-провайдера?
Локальный шлюз провайдера LLM имеет смысл, когда требования к конфиденциальности, работе в офлайн-режиме, контролю разработки или ограничения по стоимости оправдывают запуск моделей локально, а ваша команда готова взять на себя дополнительные проверки работоспособности, мощности, совместимости и дрейфа версий.
Может ли OpenAI-совместимый маршрут обойтись без QA, специфичного для провайдера?
Нет. Совместимость с OpenAI может сократить объем интеграционной работы, но каждый маршрут все равно требует QA, специфичного для рабочей нагрузки: для инструментов, потоковой передачи, структурированного вывода, мультимодальных входных данных, обработки ошибок, полей использования, лимитов запросов и поведения при отказе.
Итог
Правильная стратегия региональной маршрутизации LLM-провайдеров — это не столько один универсальный endpoint, сколько дисциплинированные проверки провайдеров. Особенно это верно, когда маршрутизация API китайских LLM включает и DeepSeek, и Qwen, а рядом с размещенными маршрутами для сценариев конфиденциальности, офлайн-работы или контроля затрат находится шлюз локального провайдера.
Рассматривайте маршрутизацию DeepSeek Qwen в первую очередь как проблему политики провайдера. Затем проверяйте работающий endpoint, ключ, совместимость, мощность, жизненный цикл и подтверждение затрат, прежде чем переводить производственный трафик.
Flatkey помогает, когда вам нужен один ключ, один каталог моделей, один базовый URL, совместимый с OpenAI, и одна поверхность учета использования для поддерживаемых размещенных маршрутов. Используйте шлюз, чтобы централизовать операции, но сохраняйте отдельные проверки провайдеров, которые делают региональную маршрутизацию безопасной.


