
flatkey.ai Blog
Einblicke, Produktnotizen und Implementierungsleitfäden für Teams, die mit KI-APIs entwickeln.
Architektur von KI-Gateways
Neueste Artikel in Architektur von KI-Gateways.
WeiterlesenMigration von Basis-URL und SDK
Neueste Artikel in Migration von Basis-URL und SDK.
WeiterlesenKosten, Abrechnung und Betrieb
Neueste Artikel in Kosten, Abrechnung und Betrieb.
WeiterlesenUnternehmenskontrollen und Vertrauen
Neueste Artikel in Unternehmenskontrollen und Vertrauen.
WeiterlesenGateway-Vergleiche
Neueste Artikel in Gateway-Vergleiche.
WeiterlesenLeitfäden für Modelle und Modalitäten
Neueste Artikel in Leitfäden für Modelle und Modalitäten.
WeiterlesenZuverlässigkeit und Routing
Neueste Artikel in Zuverlässigkeit und Routing.
WeiterlesenWerkzeugintegrationen
Neueste Artikel in Werkzeugintegrationen.
Weiterlesen
Beste Cloud-GPU-Mietplattformen 2026: Preis, Kapazität, Netzwerk und Support
Eine praxisnahe Shortlist von GPU-Cloud-Plattformen für KI-Teams im Jahr 2026 – mit Vergleich von Preisniveau, Kapazität, Netzwerk, Support und der Frage, wann eine Modell-API die bessere Basis ist.
NVIDIA Blackwell Ultra B300: Was hat sich gegenüber dem B200 geändert?
Ein praktischer NVIDIA B300 Blackwell Ultra-Tracker für Teams im Bereich KI-Infrastruktur, der B300-Spezifikationen, den Veröffentlichungsstatus, Preisvorbehalte und die Eignung für Workloads mit dem B200 vergleicht.
AMD MI455X und Helios: Architektur-, Speicher- und Verfügbarkeits-Tracker
Ein kauforientierter Tracker für AMD MI455X und Helios mit Fokus auf Architektur, HBM4-Speicher, Bandbreite, Verfügbarkeit, vLLM-Bereitschaft, Fragen an Anbieter und Fallback-Strategien für Modelle/APIs.
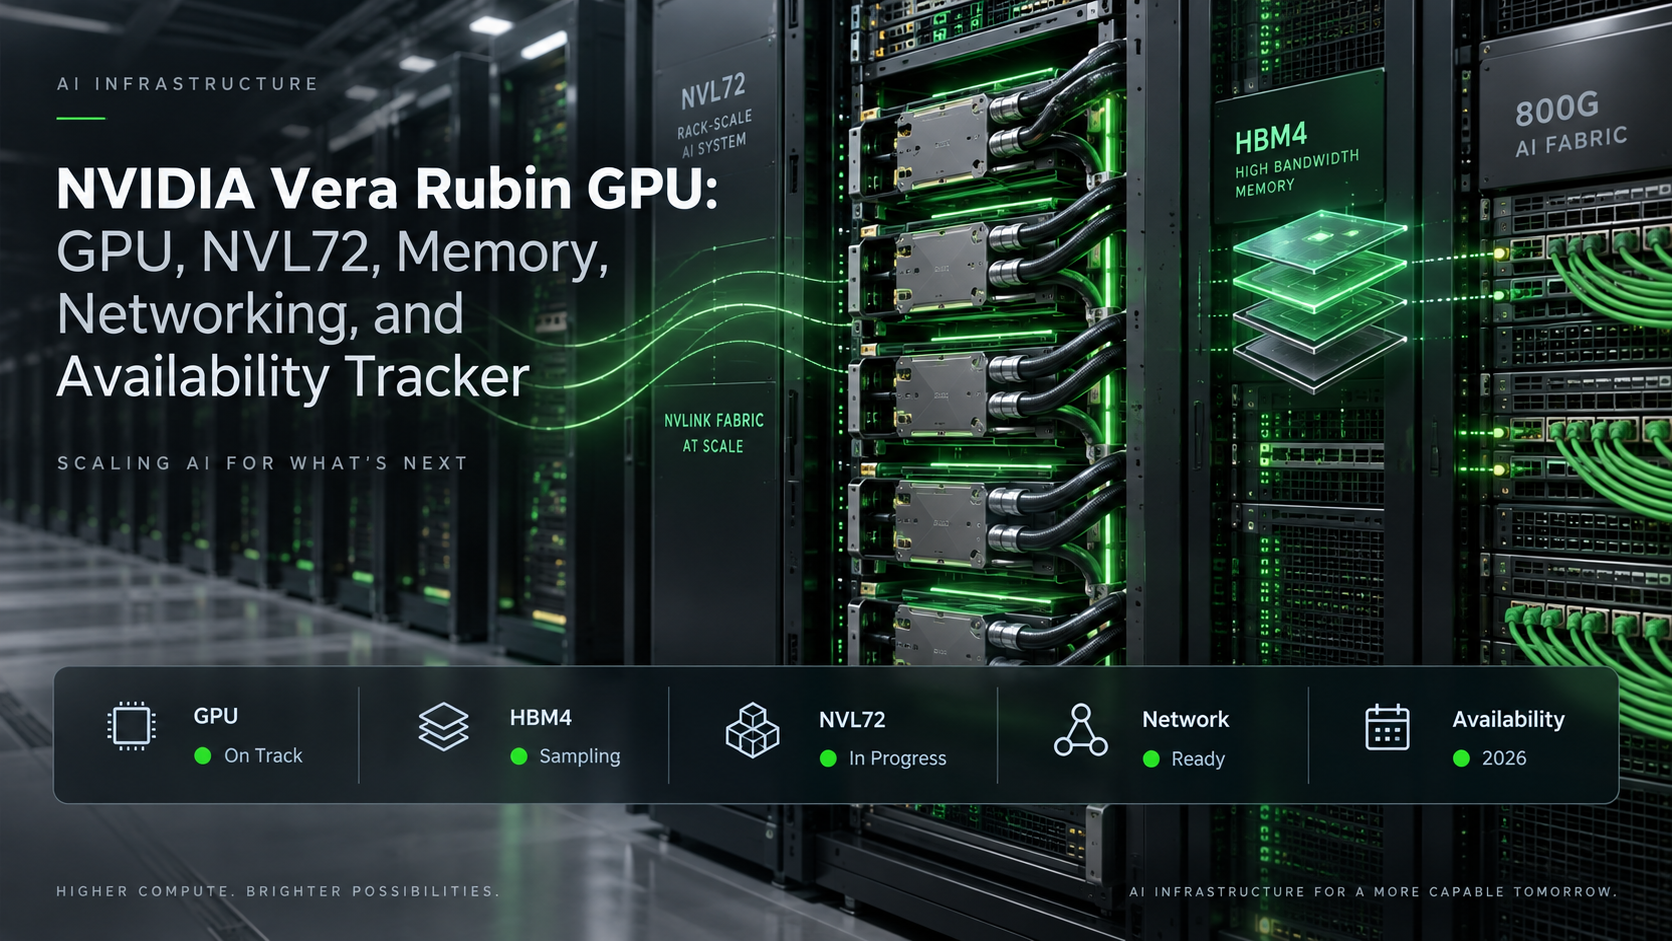
NVIDIA Vera Rubin GPU: GPU, NVL72, Speicher, Netzwerk und Verfügbarkeits-Tracker
Ein aktueller Tracker für NVIDIA Vera Rubin GPU-Spezifikationen, DGX Vera Rubin NVL72, HBM4-Speicher, Netzwerk und Verfügbarkeitsmeilensteine für Cloud-GPU-Käufer.
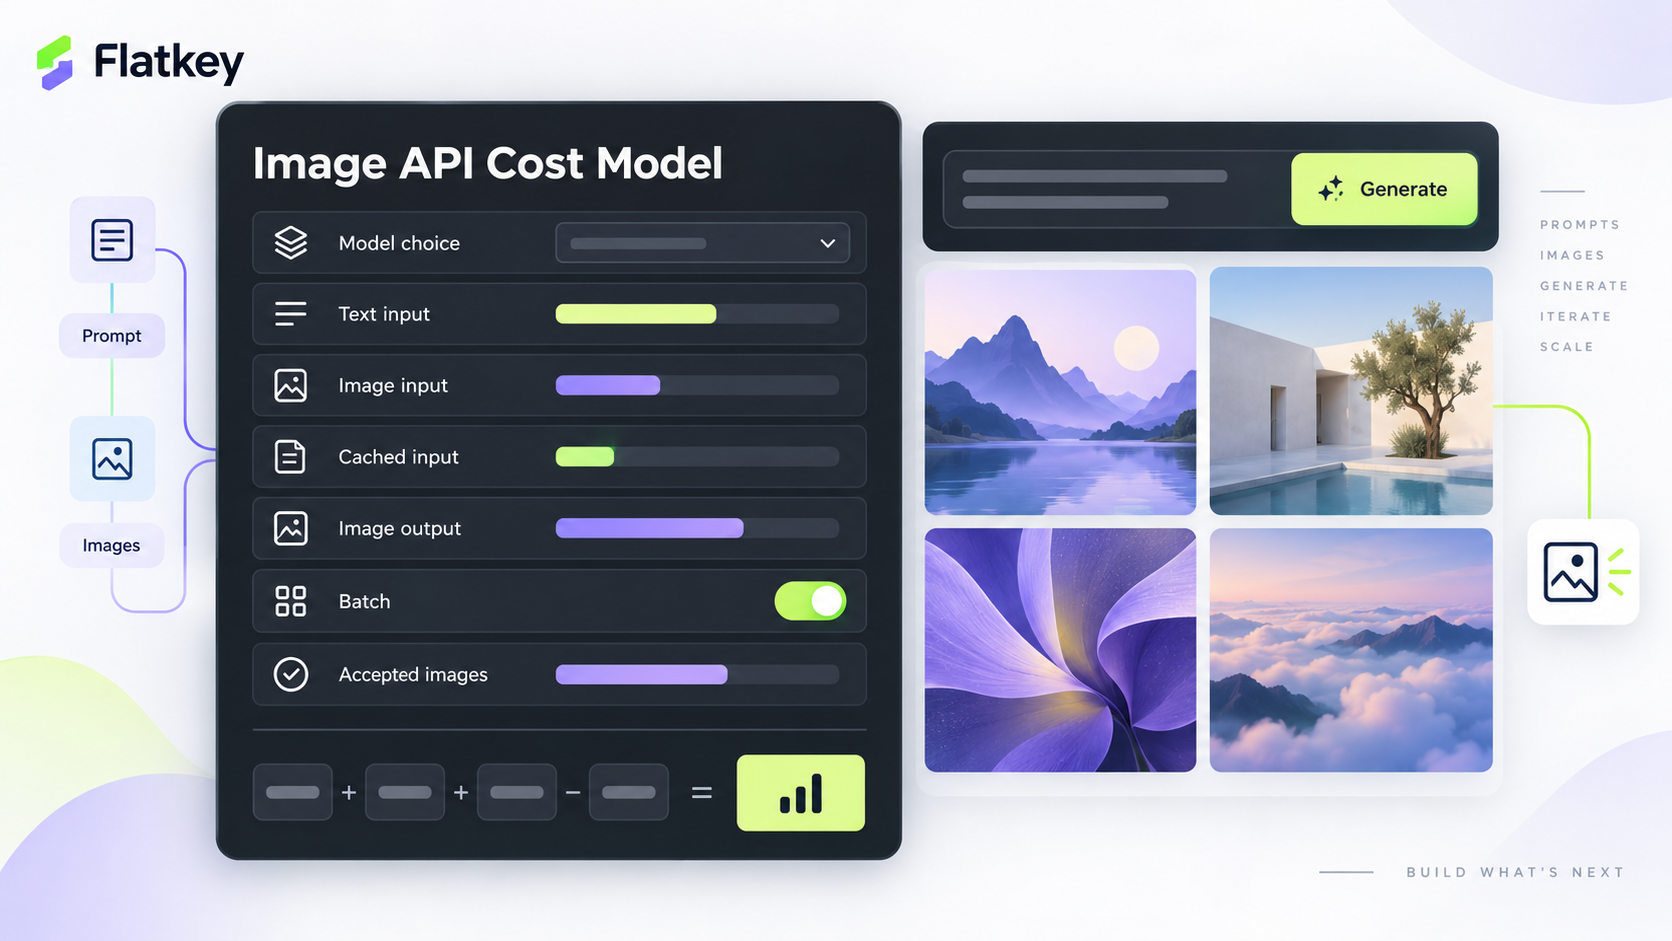
OpenAI Image API Preisgestaltung: GPT Image 2.5 Tarife, Kostenformel und Budgetkontrollen
Erfahren Sie, wie die OpenAI Image API-Preisgestaltung für GPT Image 2.5 funktioniert – einschließlich Token-Tarifen, Regeln für zwischengespeicherte Eingaben, Teilbilder, Batch und Kosten pro akzeptiertem Bild.
GB200 vs B200: Grace Blackwell Superchip oder x86 HGX?
Vergleichen Sie GB200 vs B200 für die Beschaffung von KI-Infrastruktur: Grace Blackwell NVL72-Rack-Scale-Systeme, B200 HGX/x86-Nodes, Benchmarks und TCO-Prüfungen.
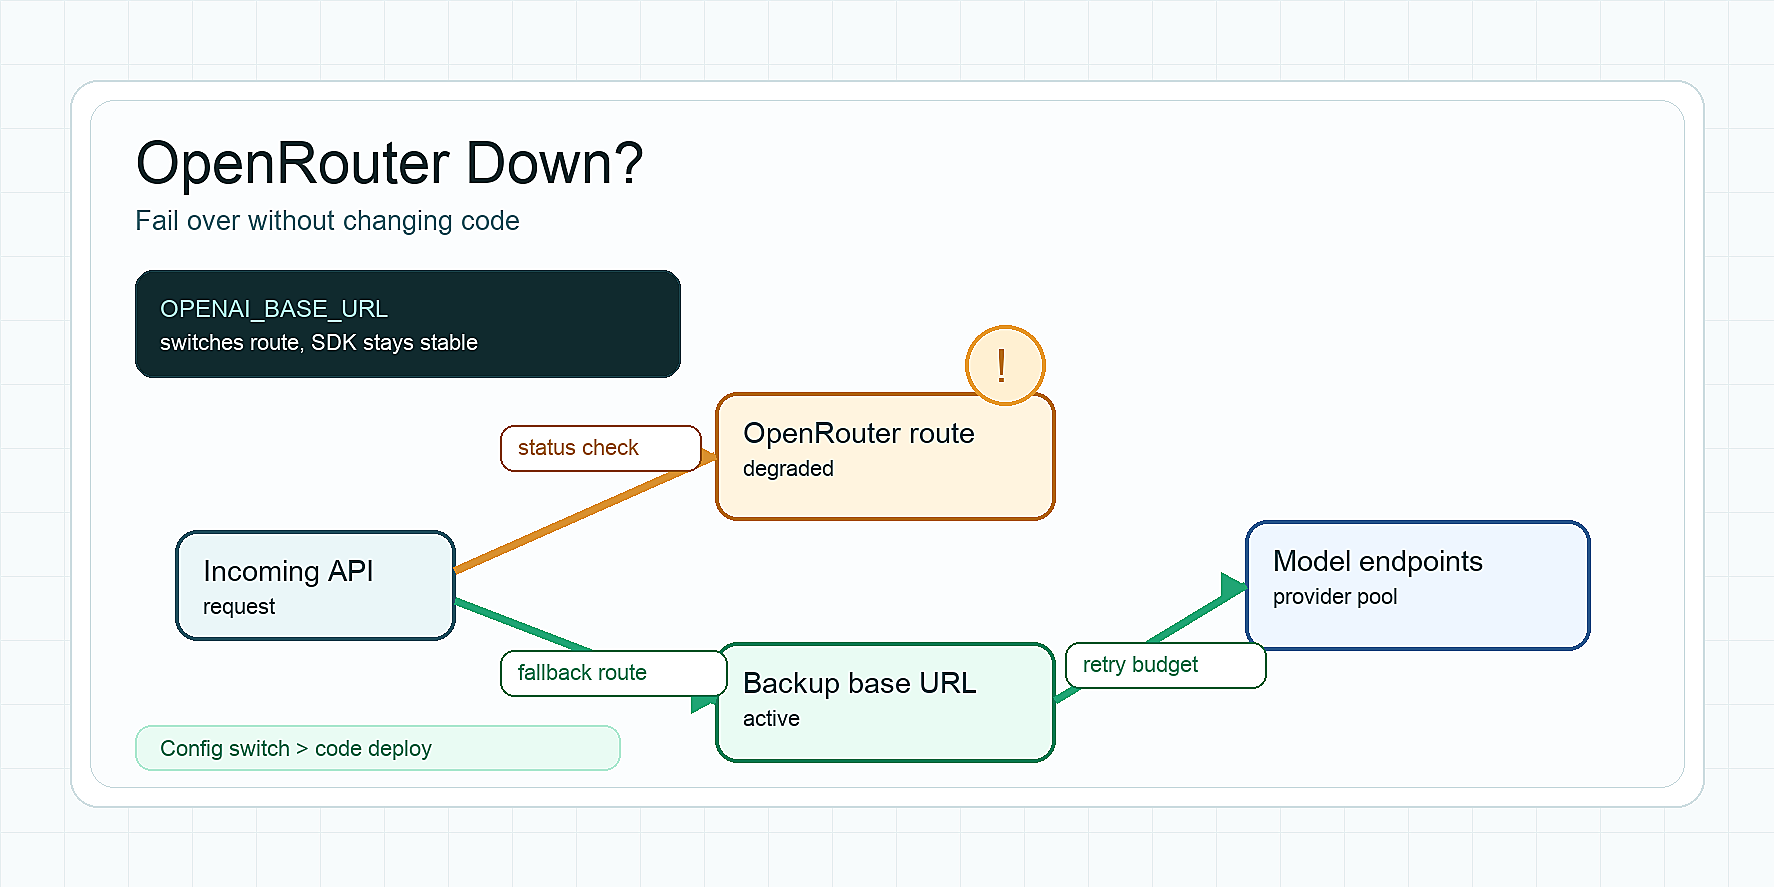
OpenRouter down? Wie Sie ohne Codeänderungen auf einen Ausfall umschalten
Prüfen Sie, ob OpenRouter ausgefallen ist, unterscheiden Sie Provider-Fehler von Plattformstörungen und schalten Sie mit base_url, Retries, Provider-Fallback und Model-Fallback um.
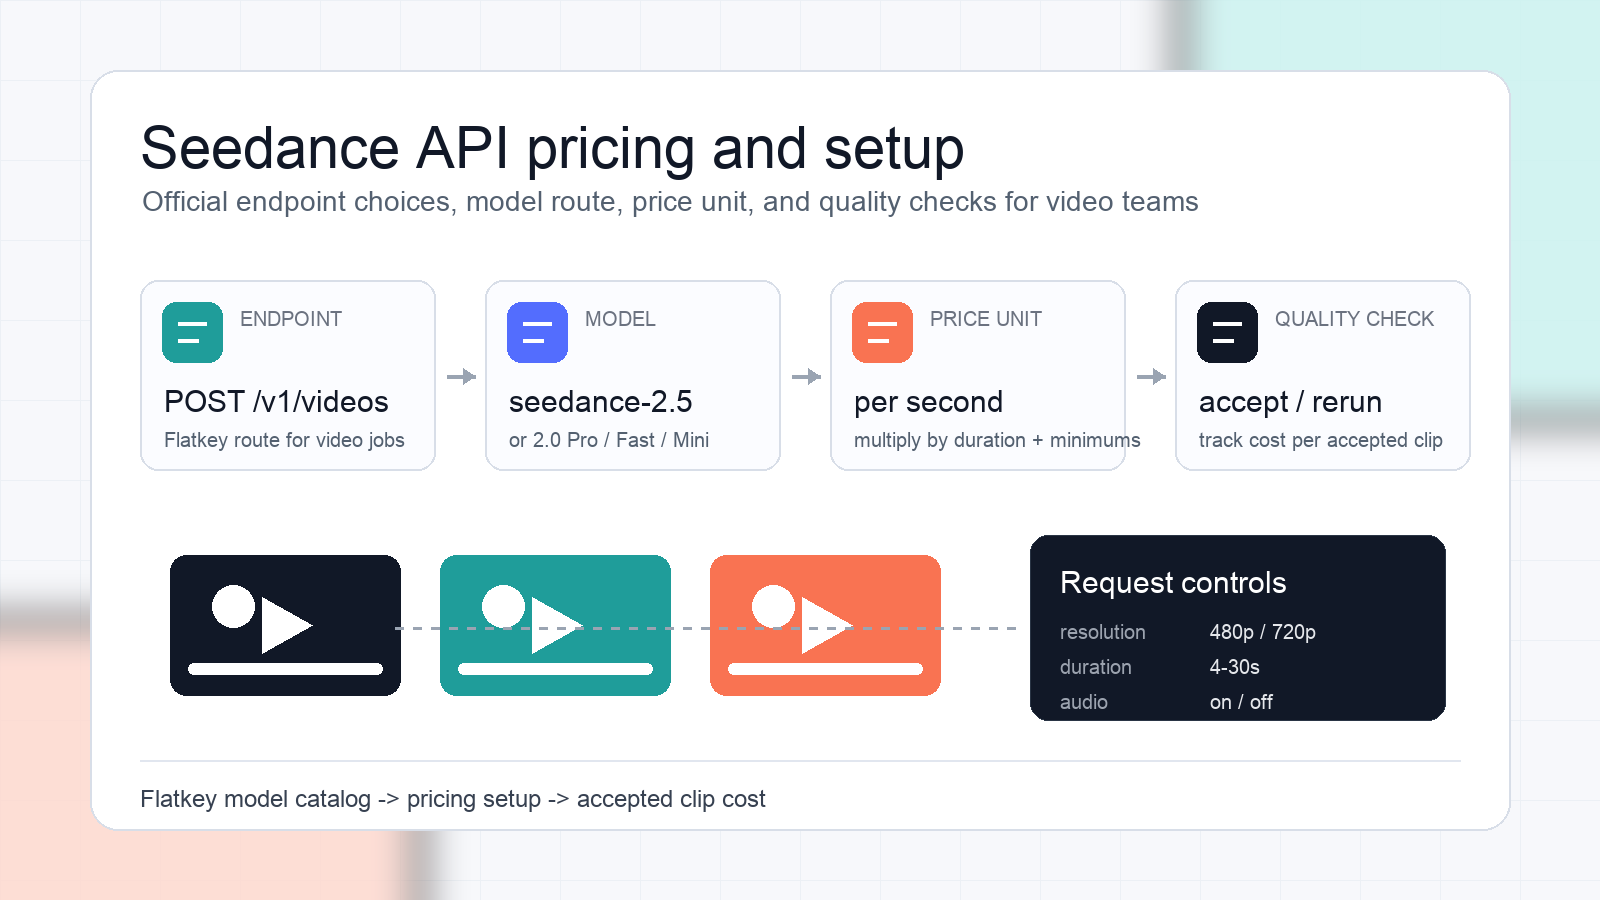
Seedance API: Preise, Qualität und Setup für offizielle Endpoints
Vergleichen Sie offizielle Seedance API-Endpoint-Optionen, Flatkeys Preis pro Sekunde, Setup-Schritte und Qualitätsprüfungen für Videogenerierungsteams.
Was ist eine AI Factory? GPU-Cluster, Daten, Modelle und Betrieb
Erfahren Sie, was eine AI Factory ist, wie GPU-Cluster, Datenpipelines, Modelle, Inferenz, Governance und Betrieb zusammenwirken und wann Modell-APIs eine direkte GPU-Besitzstruktur ersetzen können.
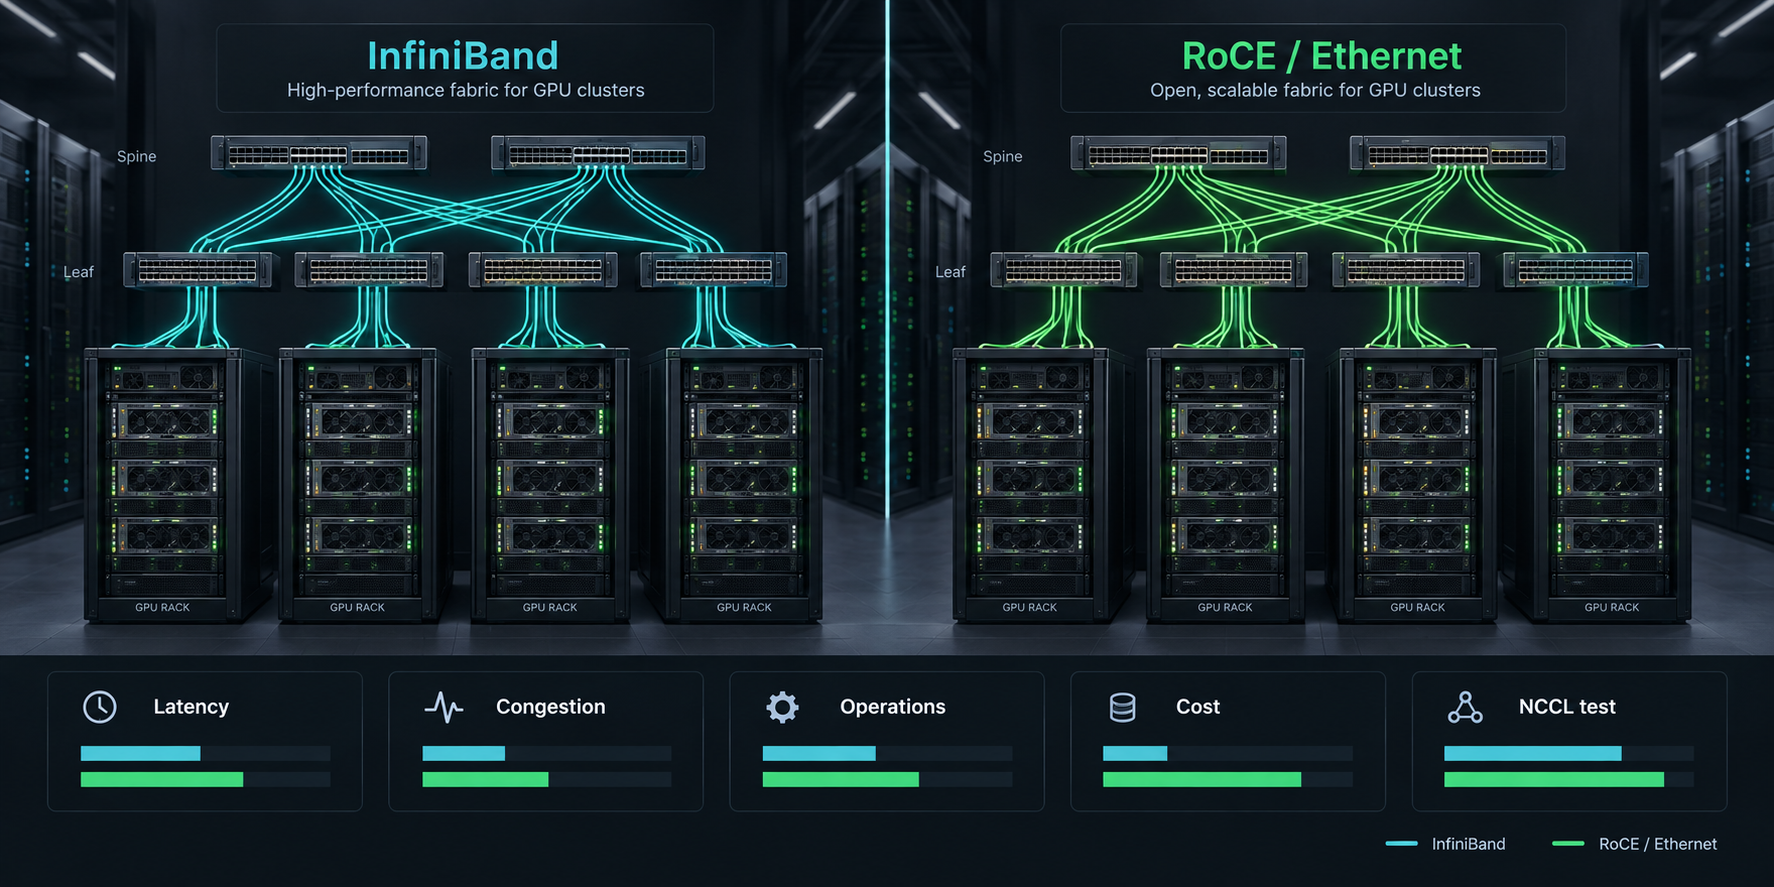
RoCE vs. InfiniBand für GPU-Cluster: Latenz, Betrieb und Kosten
Vergleichen Sie RoCE und InfiniBand für Multi-Node-GPU-Cluster mit einer praktischen Entscheidungsmatrix, einem NCCL-Abnahmetest, einem Kostenmodell und einer Beschaffungs-Checkliste.
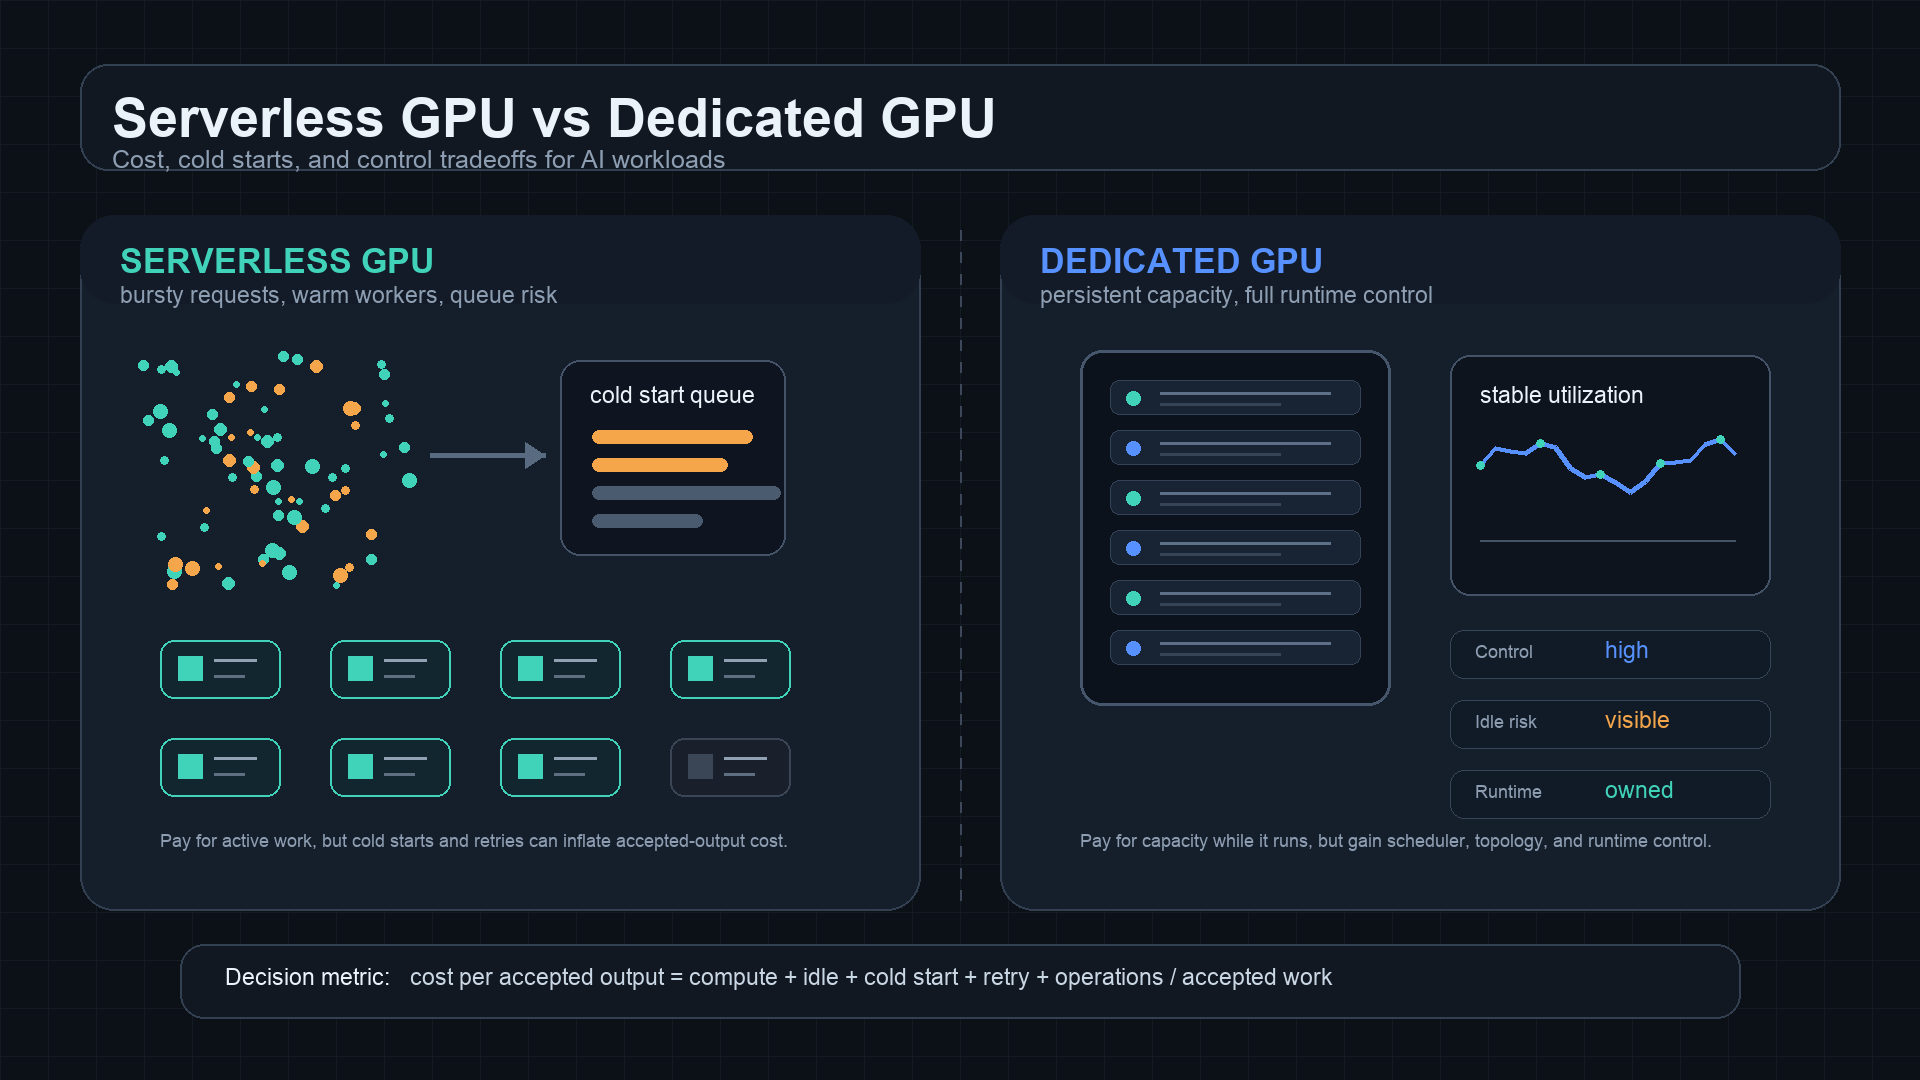
Serverless GPU vs. Dedizierte GPU: Kosten, Cold Starts und Kontrolle
Vergleiche Serverless GPU vs. dedizierte GPU anhand von Kosten pro akzeptierter Ausgabe, Cold Starts, ungenutzter Kapazität, Autoscaling und operativer Kontrolle.
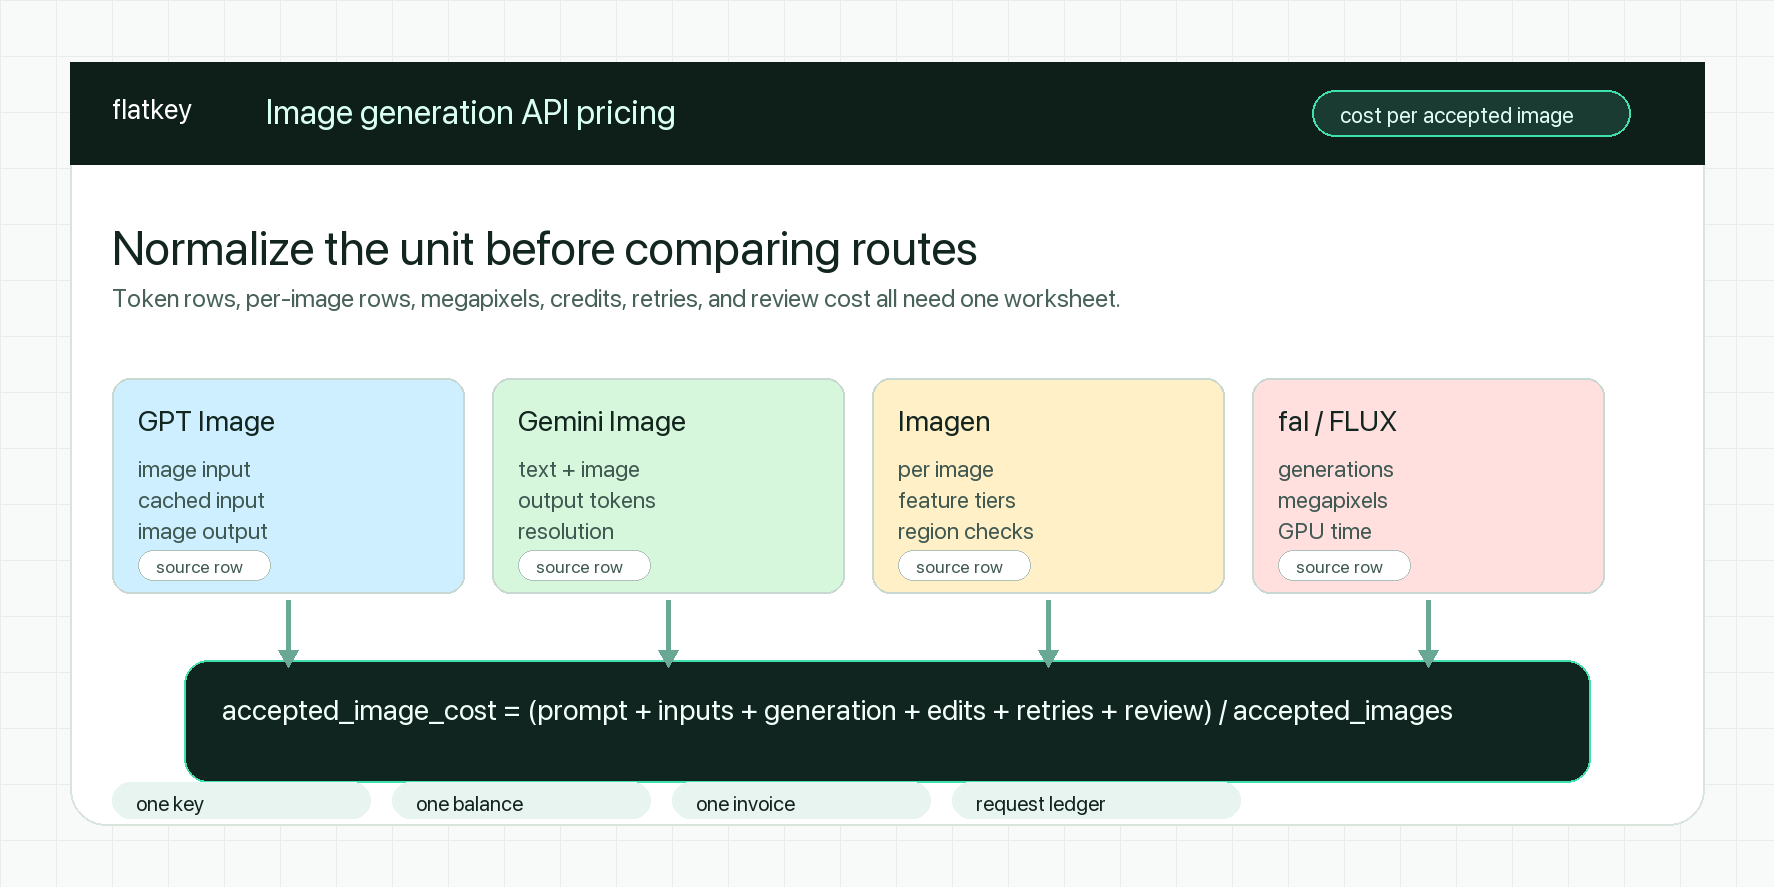
Vergleich der Preise für AI-Bildgenerierungs-APIs: GPT Image, Gemini, Imagen und fal
Vergleiche die Preise für Bildgenerierungs-APIs von GPT Image, Gemini Image, Imagen und fal, indem die Abrechnungseinheiten auf Kosten pro akzeptiertem Bild normalisiert werden.
Welche versteckten Kosten haben Cloud-GPU-Services? Speicher, Egress, Leerlaufzeit und Support
Ein praktischer TCO-Leitfaden für Cloud-GPUs, um Speicher-, Egress-, Leerlaufzeit-, Fehljob-, Support-, Netzwerk- und Betriebskosten zu erkennen, bevor die Rechnung kommt.
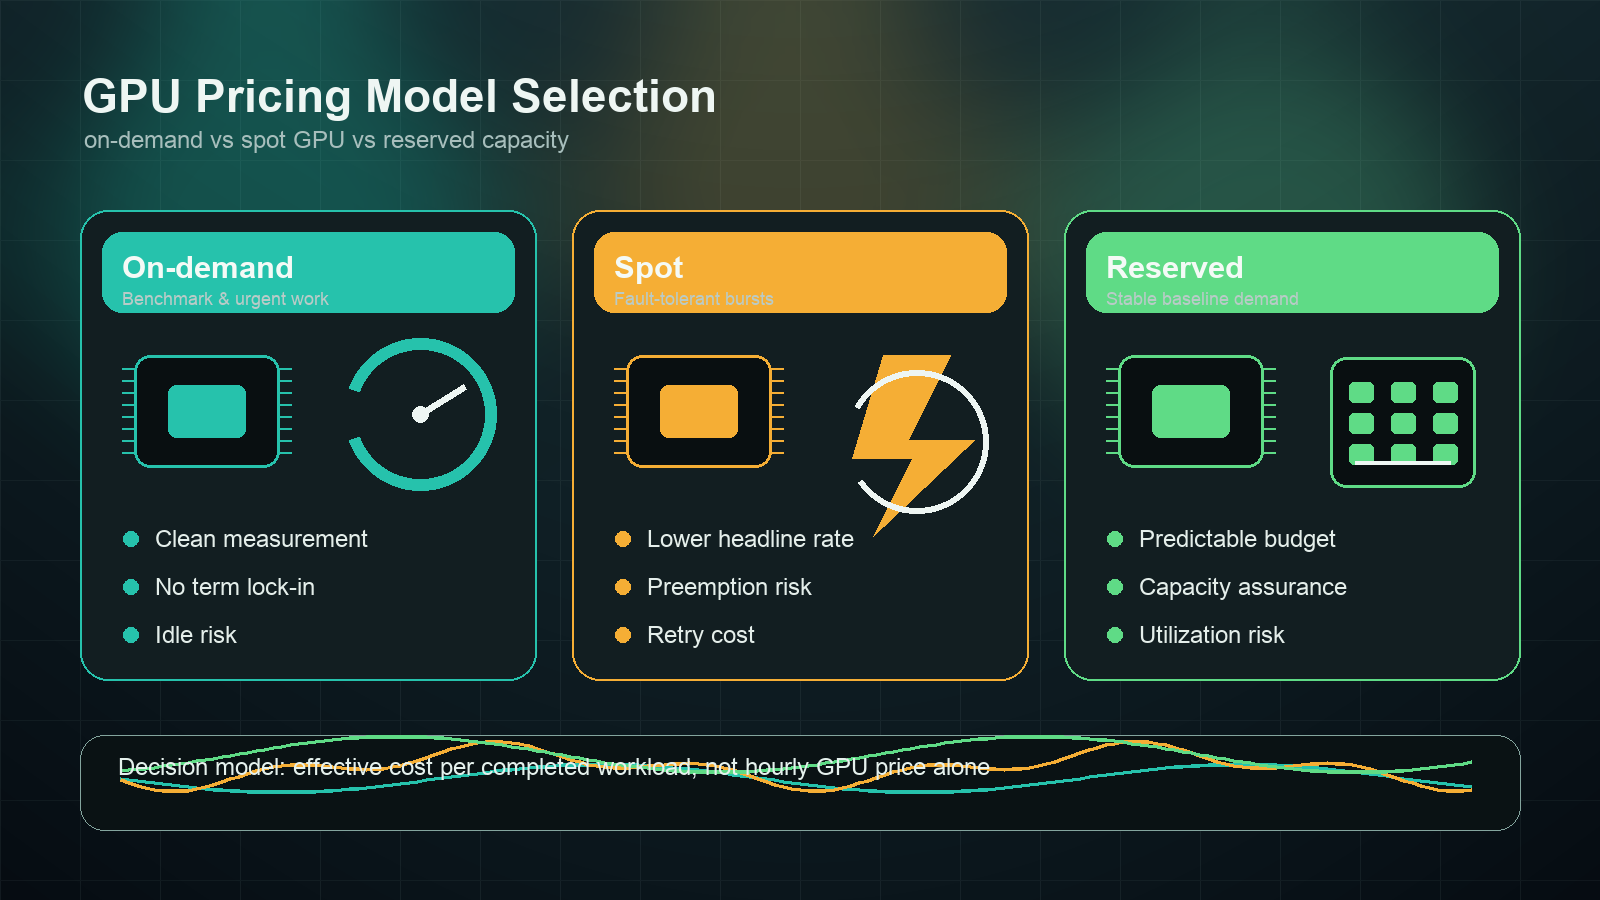
On-Demand vs. Spot vs. Reserved GPU-Preise: Welches Modell passt zu Ihrer Workload?
Ein workloaddriver Rahmenwerk zur Auswahl von On-Demand-, Spot- oder reservierter GPU-Kapazität, ohne den angegebenen Stundensatz mit den Kosten der abgeschlossenen Workload zu verwechseln.
Private GPU Cloud: Architektur, Isolation und Betriebsmodell
Erfahren Sie, wie Sie die Architektur einer Private GPU Cloud, Isolation, Scheduler-Verantwortung, Sicherheitsnachweise, das Betriebsmodell, TCO und Abnahmetests bewerten.
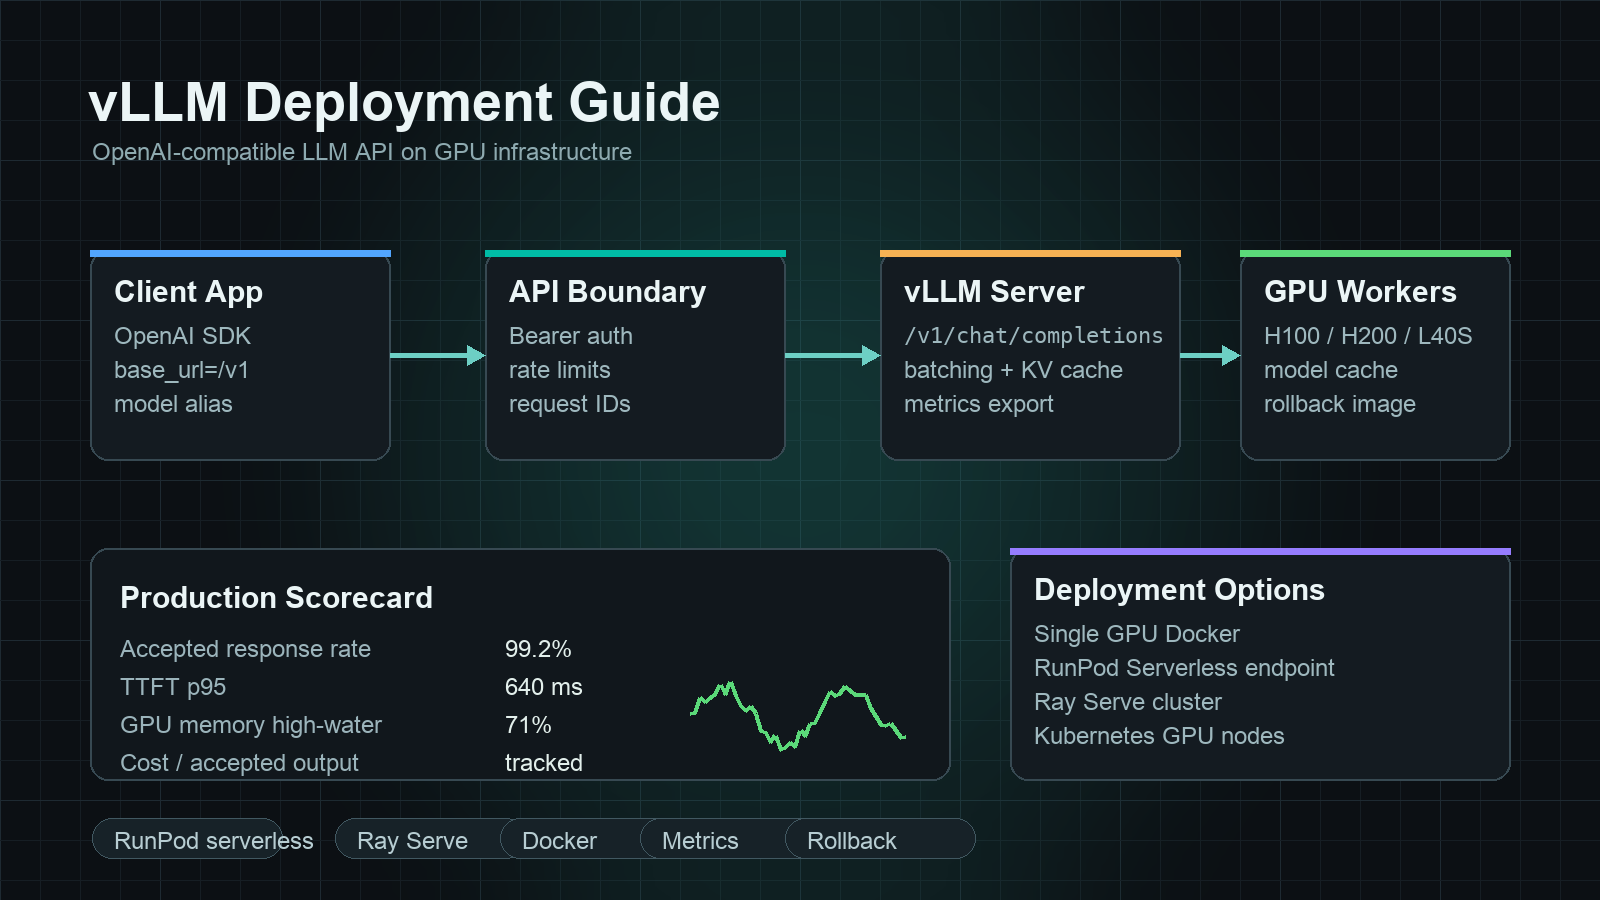
vLLM-Deployment-Guide: Eine OpenAI-kompatible LLM-API auf GPUs bereitstellen
Setzen Sie vLLM als OpenAI-kompatible API auf GPUs ein – mit Docker, RunPod Serverless, Ray Serve, Metriken, Rollout-Steuerung und Prüfungen der Kosten pro akzeptierter Ausgabe.
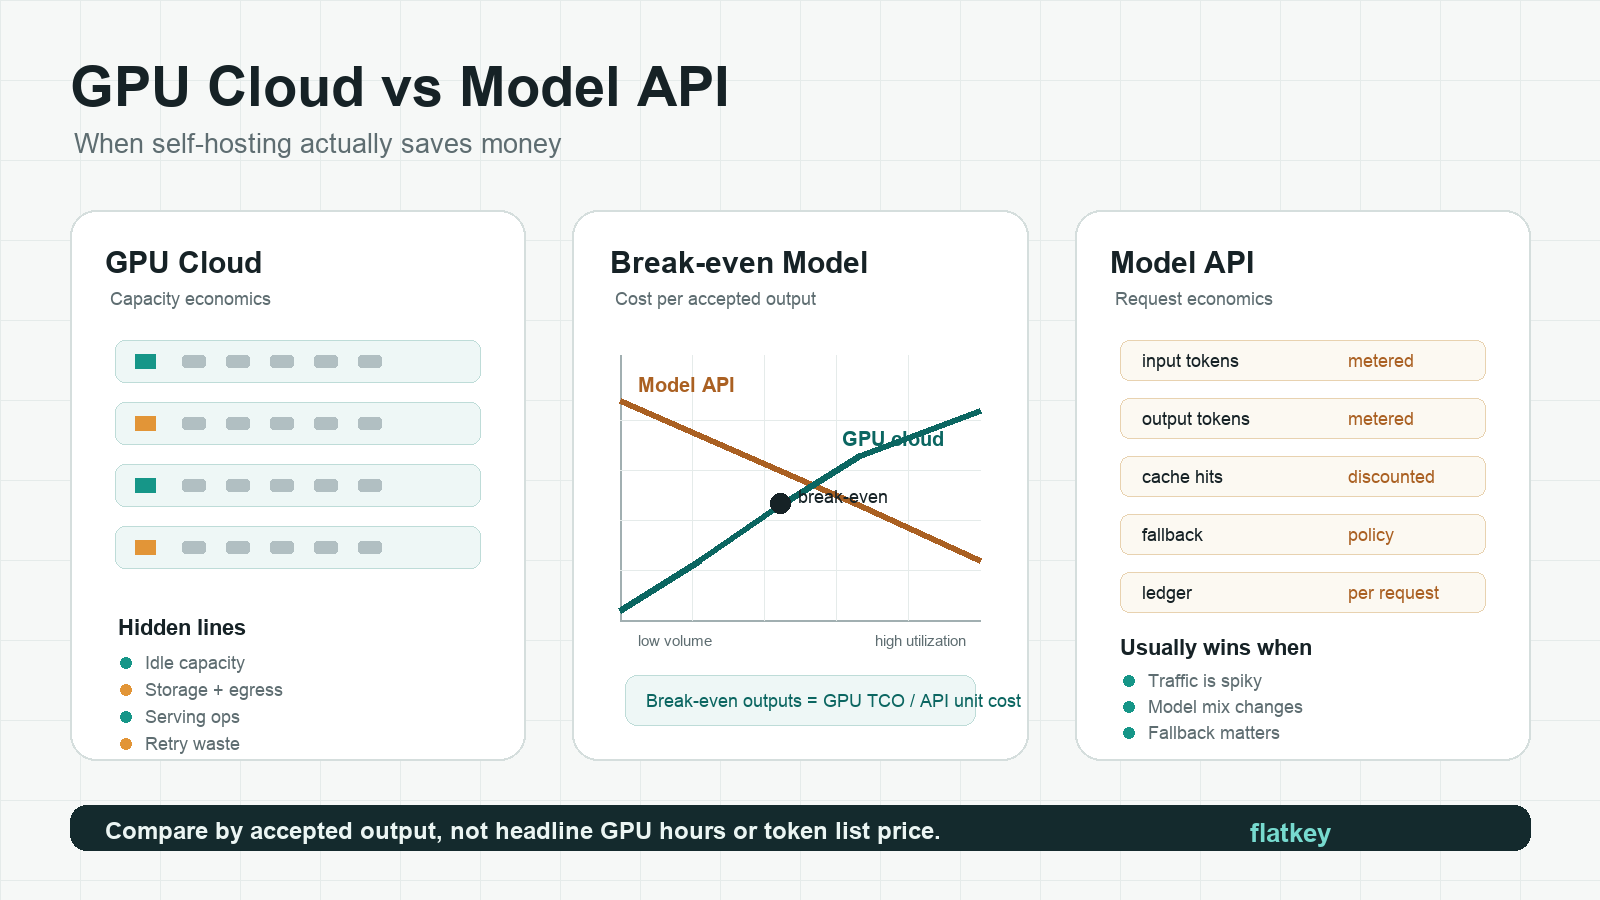
GPU-Cloud vs. Model-API: Wann Self-Hosting sich tatsächlich bezahlt macht
Vergleichen Sie die Wirtschaftlichkeit von GPU-Cloud und Model-API mit einem Break-even-Arbeitsblatt für akzeptierte Output-Kosten, Auslastung, Retries, Leerkapazität und Serving-Operations.
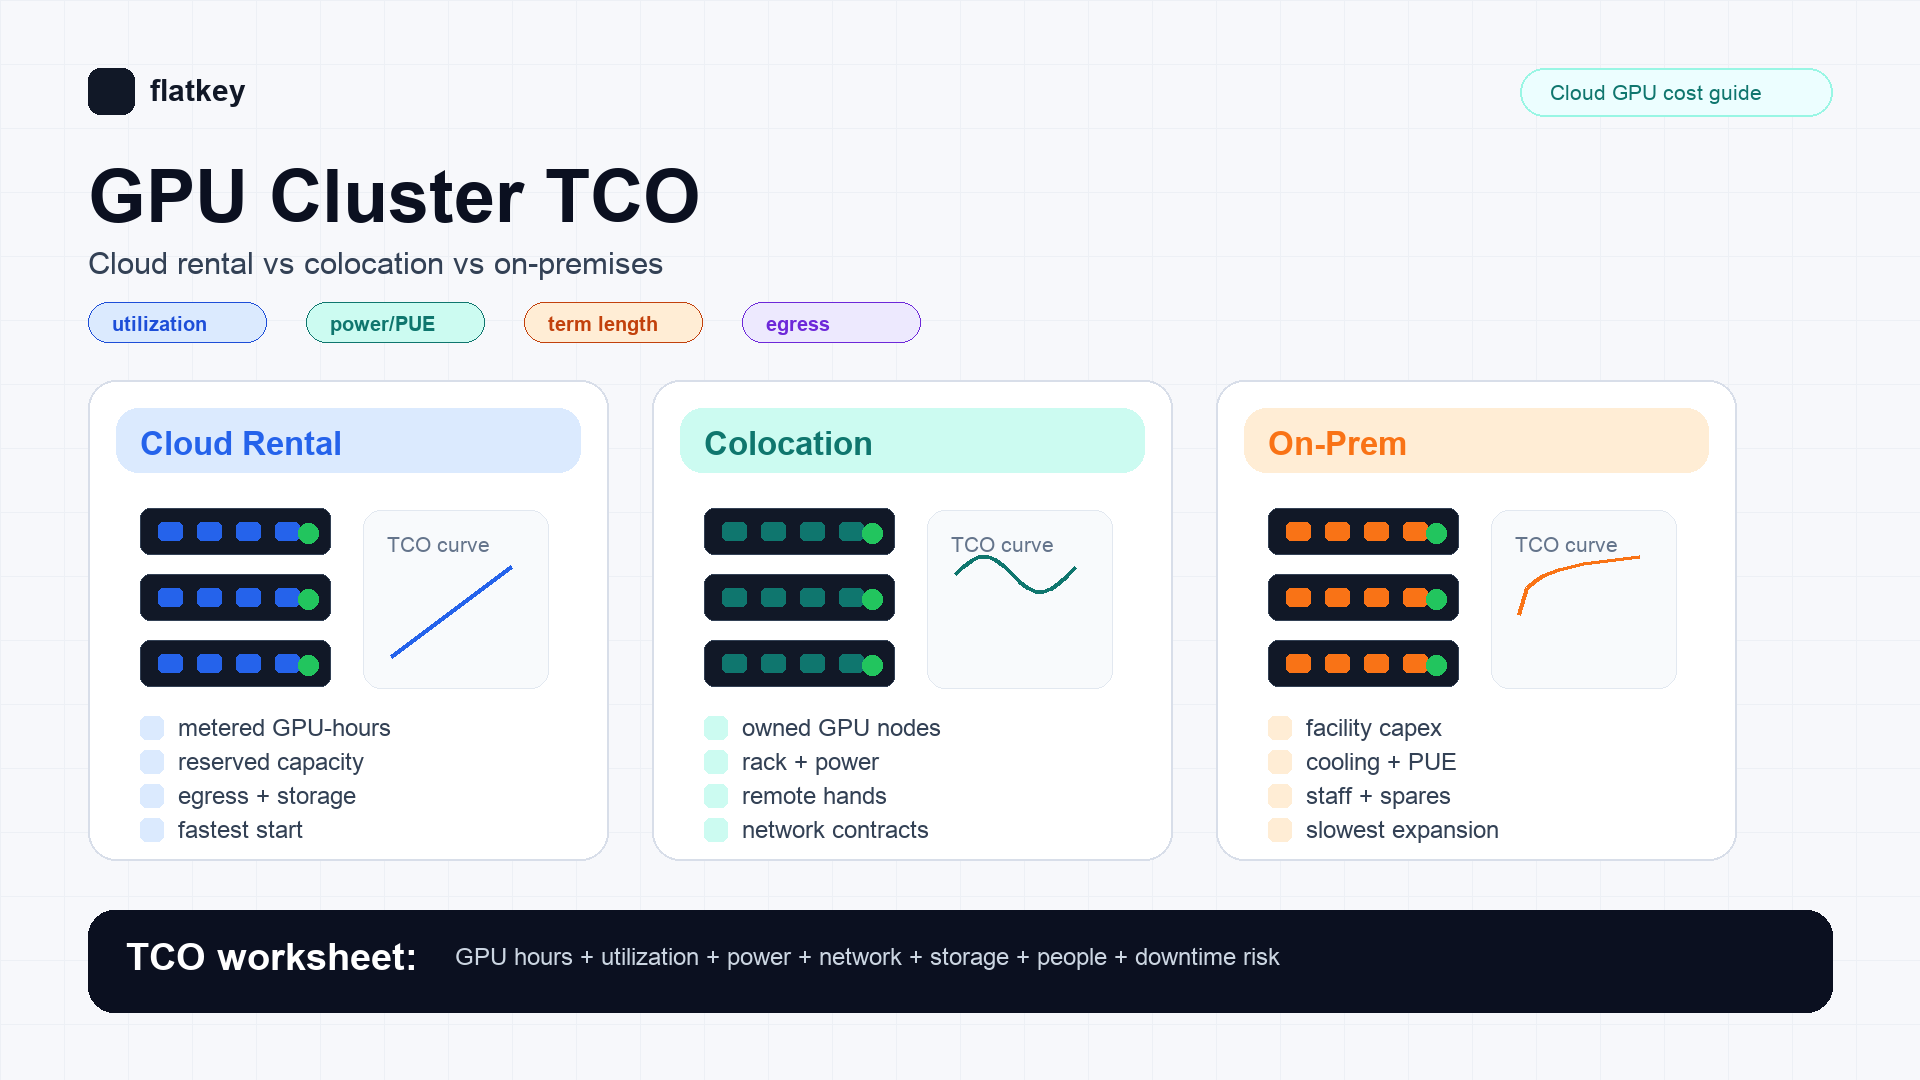
GPU-Cluster-TCO: Cloud-Miete vs. Colocation vs. On-Premises
Vergleichen Sie die TCO von GPU-Clustern in Cloud-Miete, Colocation und On-Premises mit einem praktischen FinOps-Arbeitsblatt für Käufer von KI-Infrastruktur.
Schneller entwickeln mit einem KI-Gateway.
Nutze flatkey.ai, um Modelle, Schlüssel, Abrechnung und Observability über eine API-Plattform zu verwalten.
Loslegen