
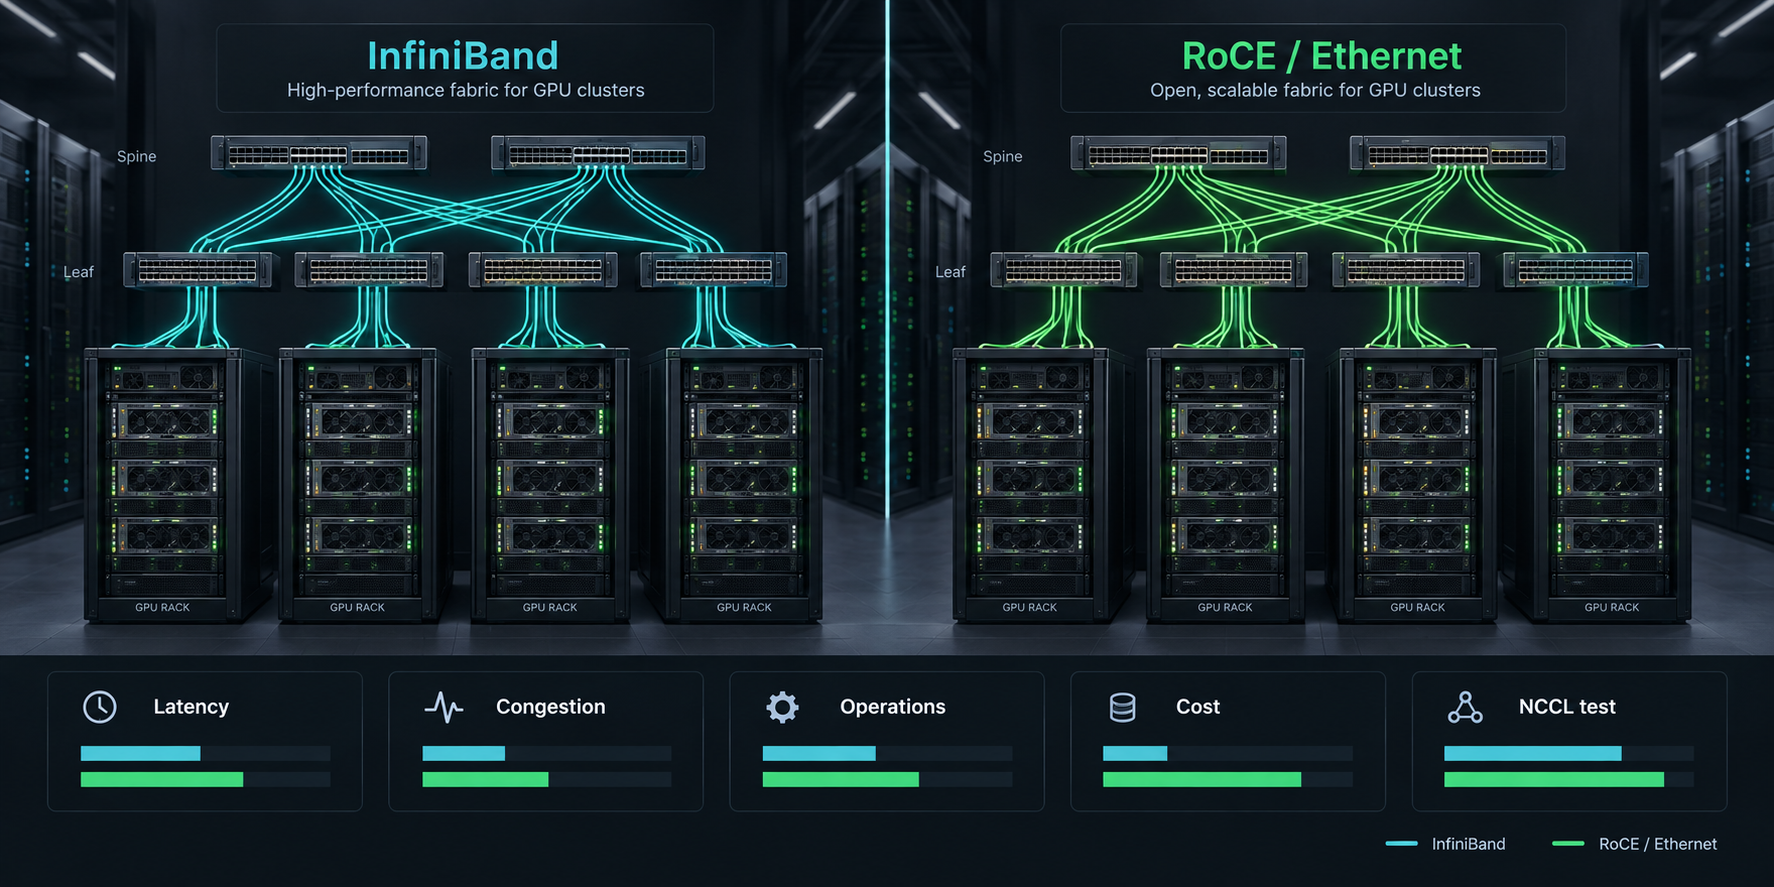
Die meisten RoCE-vs.-InfiniBand-Diskussionen setzen am falschen Punkt an. Sie vergleichen Protokollnamen, statt zu fragen, was der GPU-Cluster aushalten muss: eng gekoppelte Trainingsläufe, sharded Inference, gemeinsamen Speicherverkehr, gemischte Mandanten, Beschaffungsvorgaben und das Betriebsteam, das das Fabric nach dem Start feinabstimmen wird.
Für Multi-Node-GPU-Cluster ist InfiniBand in der Regel die sicherere Standardwahl, wenn die Workload latenzempfindlich, kollektivlastig und groß genug ist, um ein speziell dafür ausgelegtes AI/HPC-Fabric zu rechtfertigen. RoCE ist meist der bessere Ausgangspunkt, wenn das Team bereits High-Speed-Ethernet betreibt, eine größere Herstellerauswahl wünscht und das verlustfreie Ethernet-Design vor dem Commit mit echten NCCL-Tests belegen kann.
Der schwierige Teil ist, dass beide funktionieren können und beide scheitern können. Ein gut aufgebautes RoCE-v2-Fabric kann ernsthafte KI-Cluster betreiben. Ein schlecht betriebenes InfiniBand-Fabric kann trotzdem das Trainingsfenster verpassen. Dieser Leitfaden vergleicht roce vs infiniband anhand von Latenz, Betrieb und Kosten, damit Plattformteams das Fabric wählen können, das zur Workload passt, statt zur lautesten Herstellerfolie.
RoCE vs InfiniBand: schnelle Antwort
Verwenden Sie diese Tabelle als ersten Entscheidungsfilter.
| Situation | Normalerweise starten mit | Warum |
|---|---|---|
| Großes verteiltes Training mit häufigem All-Reduce-Verkehr | InfiniBand | Es ist ein speziell entwickeltes Switching-Fabric für latenzarme, bandbreitenstarke HPC- und KI-Kommunikation. |
| Das Angebot für den GPU-Cluster enthält bereits ein validiertes NVIDIA Quantum- oder ähnliches InfiniBand-Fabric | InfiniBand | Das Risiko verlagert sich von der Auslegung hin zu Abnahmetests und dem Nachweis durch den Anbieter. |
| Das Enterprise-Netzwerkteam verfügt bereits über tiefgehende Ethernet-Automatisierung, Monitoring und Beschaffungshebel | RoCE | RoCE behält RDMA auf Ethernet bei, braucht aber disziplinierte Staukontrolle und verlustfreies Verhalten. |
| Gemischter KI-, Speicher- und normaler Rechenzentrumsverkehr auf einem Betriebsmodell | RoCE oder separates Ethernet plus dediziertes KI-Fabric | RoCE kann sich mit dem Ethernet-Betrieb decken, aber gemeinsame Fabrics müssen sorgfältig entworfen werden. |
| Kleine Inference-Flotte, Batch-Jobs oder Workloads, die nicht über mehrere Knoten skalieren | Weder das eine noch das andere Fabric sollte die Entscheidung bestimmen | GPU-Speicher, Auslastung, Queueing und Modell-/API-Alternativen sind wichtiger als das Interconnect. |
| Die Beschaffung braucht maximale Herstellervielfalt und standardisierte Switch-Beschaffung | RoCE | Die Ethernet-Beschaffung kann breiter sein, während InfiniBand-Cluster vertikal spezialisierter sind. |
| Das Team hat keine Erfahrung mit RDMA-Fabrics und kein Benchmark-Fenster | Erst mieten, dann entscheiden | Unterschreiben Sie keinen Multi-Node-Vertrag, bevor NCCL-, Fehler- und Observability-Tests bestanden sind. |
Die praktische Antwort: Wählen Sie InfiniBand, wenn die Anwendung ein dediziertes AI/HPC-Fabric mit dem geringsten Risiko auf Protokollebene beim Tuning benötigt. Wählen Sie RoCE, wenn Ethernet-Standardisierung, Beschaffungsflexibilität oder bestehende Betriebsprozesse wichtig genug sind, um den zusätzlichen Fabric-Engineering-Aufwand zu rechtfertigen.
Was InfiniBand in einem GPU-Cluster bedeutet
InfiniBand ist eine branchenübliche, geschaltete Fabric-Architektur zur Verknüpfung von Servern und Speicher. In GPU-Clustern wird sie häufig mit niedriger Latenz, hoher Bandbreite, RDMA, GPU Direct RDMA, adaptivem Routing, Stau-Management und vom Hersteller integrierten AI/HPC-Tools verbunden.
Der wichtige Punkt ist nicht nur, dass InfiniBand schnell ist. Der wichtige Punkt ist, dass es als Fabric gebaut ist. Subnetzmanagement, Verhalten auf Fabric-Ebene, virtuelle Lanes, Quality of Service, In-Network-Beschleunigung und die Integration von Switch und Adapter sind Teil der Designgrenze. Das ist wichtig, wenn ein Trainingsjob Hunderte oder Tausende von GPUs umfasst und jede kollektive Operation die Tail-Latenz verstärkt.
Cloud-Beispiele zeigen, warum dieses Fabric in vielen großen KI-Clustern weiterhin dominiert. Die Dokumentation zu Azure ND H100 v5 beschreibt acht H100-GPUs pro VM, dedizierte 400-Gbps-NVIDIA-Quantum-2-CX7-InfiniBand-Konnektivität pro GPU, 3,2 Tbit/s Interconnect-Bandbreite pro VM, Unterstützung für GPU Direct RDMA und NCCL-orientiertes Scale-out-Clustering. Diese Details sind keine generischen "schnelles Netzwerk"-Floskeln; es sind Fakten zur Cluster-Topologie, die das Verhalten des verteilten Trainings beeinflussen.
Für einen Käufer sollte die InfiniBand-Frage konkret sein:
- Welche InfiniBand-Generation und welche Switch-Plattform ist enthalten?
- Wie viele NICs oder Host Channel Adapter sind pro Knoten angebunden?
- Ist jede GPU einem dedizierten Netzwerkpfad zugeordnet oder wird der Verkehr aggregiert?
- Ist GPUDirect RDMA aktiviert und getestet?
- Welche Platzierungsgarantie hält die Knoten im selben Fabric-Domain?
- Welches Fabric-Management, welche Telemetrie und welche Behebung von Störungen übernimmt der Anbieter?
Wenn der Verkäufer nur sagt "InfiniBand included", ist das Angebot unvollständig.
Was RoCE in einem GPU-Cluster bedeutet
RoCE bedeutet RDMA over Converged Ethernet. RoCE v2 transportiert RDMA über routbare Ethernet/IP-Netzwerke, sodass Teams Ethernet-Switching nutzen können und dennoch einen Großteil des CPU- und Kernel-Overheads umgehen, der mit gewöhnlichen TCP-Pfaden verbunden ist.
Das ist der Reiz. RoCE kann es einem KI-Plattformteam ermöglichen, RDMA-fähige GPU-Cluster mit Ethernet-Switches, Ethernet-Betriebspraktiken und einer größeren Beschaffungsfläche aufzubauen. Für Organisationen, die bereits High-Speed-Ethernet in großem Maßstab betreiben, lässt sich RoCE oft leichter in Change Control, Telemetrie, Verkabelung, Optik und Lieferantenmanagement integrieren.
Der Nachteil ist, dass RoCE davon abhängt, dass sich das Ethernet-Fabric unter Last gut verhält. GPU-Kollektive erzeugen synchronisierte Bursts. Checkpointing und Speicherverkehr können mit Trainingsverkehr kollidieren. Stau kann zu Latenzspitzen werden. Paketverlust kann für RDMA deutlich teurer sein als für normalen Anwendungsverkehr.
Deshalb umfasst das Design von RoCE-Clustern in der Regel:
- Priority Flow Control oder eine andere getestete verlustfreie Strategie.
- Explicit Congestion Notification und Tuning der Congestion Control.
- Data Center Bridging-Konfiguration über Switches und NICs hinweg.
- Disziplin bei der Zuordnung von Queues, Serviceklassen und DSCP/Prioritäten.
- Zähler pro Priorität für Drops, Pause Frames, ECN-Marks, Retransmits und Buffer-Druck.
- Striktes Change Control für Firmware, Switch-OS, NIC-Treiber, MTU und Routing-Policy.
RoCE kann ausgezeichnet sein, aber „es ist einfach Ethernet“ ist das falsche mentale Modell. In einem GPU-Cluster ist RoCE ein konstruiertes Ethernet-Fabric für RDMA-Datenverkehr.
Latency: Vergleichen Sie das Tail-Verhalten, nicht nur den Median
Bei der roce vs infiniband-Entscheidung ist die durchschnittliche Latenz weniger nützlich als das Tail-Verhalten unter realer kollektiver Last.
Verteiltes Training wartet oft auf den langsamsten Teilnehmer. Eine kleine Zahl von Ranks mit höherer Latenz kann den gesamten Schritt ausbremsen. Bei Sharded Inference können p95- und p99-Netzwerkverzögerungen als benutzerseitige Latenz oder geringere Batch-Effizienz sichtbar werden. Bei speicherintensivem Training kann Checkpoint-Traffic Bursts erzeugen, die in einem sauberen Mikrobenchmark unsichtbar sind.
Messen Sie auf vier Ebenen:
| Ebene | Was messen | Warum das wichtig ist |
|---|---|---|
| Link und Fabric | Portfehler, Drops, ECN-Marks, Pause Frames, Congestion-Events, Routenänderungen | Findet Fabric-Gesundheitsprobleme, bevor Frameworks verantwortlich gemacht werden. |
| RDMA-Transport | Retransmits, Completion-Latenz, Queue-Tiefe, NIC-Zähler | Zeigt, ob RDMA unter Last stabil ist. |
| NCCL-Kollektive | All-Reduce-Bandbreite, Bus-Bandbreite, min./avg./max. Latenz, Timing pro Iteration | Entspricht den Kommunikationsmustern beim KI-Training. |
| Anwendung | Schrittdauer, Tokens/s, Request-Latenz, Checkpoint-Dauer, Wiederherstellung nach Fehlern | Zeigt Finanz- und Produktteams, ob das Fabric nützliche Arbeit verbessert. |
InfiniBand hat oft einen Vorteil, weil viele Cluster-Designs von Anfang an um kollektivlastige Workloads herum gebaut und validiert werden. RoCE kann den Abstand verkleinern, wenn das Ethernet-Fabric getunt, isoliert und bewährt ist. Der Test ist nicht, ob RoCE v2 theoretisch RDMA ausführen kann. Der Test ist, ob genau diese Kombination aus Switch, NIC, Verkabelung, Treiber und Topologie das p95- und p99-Verhalten während der Workload, die Sie tatsächlich ausführen werden, einhält.
Operations: InfiniBand ist spezialisiert, RoCE ist integriert
Betrieb ist der Punkt, an dem der roce vs infiniband comparison weniger offensichtlich wird.
InfiniBand bietet Plattformteams ein spezialisiertes Fabric mit ausgereiften Annahmen für KI/HPC. Das kann die Tuning-Unklarheit reduzieren. Der Nachteil ist, dass das Team InfiniBand-spezifische Fähigkeiten, Fabric-Management-Tools, Kenntnisse zum Subnet Manager und Support-Pfade benötigt. Wenn der Cluster von einem spezialisierten Anbieter oder Hyperscaler gemietet wird, kann vieles davon hinter der Servicegrenze des Anbieters verborgen sein. Wenn der Cluster selbst betrieben oder in einem Colocation-Umfeld gehostet wird, wird die Qualifikationslücke real.
RoCE passt natürlicher in viele Enterprise-Netzwerkorganisationen, weil es über Ethernet läuft. Beschaffung, Verkabelung, Switch-Betrieb, Monitoring und Change-Management-Muster können bereits vorhanden sein. Das Risiko besteht darin, dass der normale Ethernet-Betrieb nicht ausreicht. RDMA-Traffic braucht eine konsistente End-to-End-Behandlung. Eine routinemäßige Switch-Policy-Änderung kann das Fabric brechen, wenn PFC, ECN, Queue-Mapping, MTU, Hashing oder Congestion Controls abweichen.
Nutzen Sie diese Checkliste für das Betriebsmodell:
| Betriebsfrage | InfiniBand-Antwort auf die Anforderung | RoCE-Antwort auf die Anforderung |
|---|---|---|
| Wer verantwortet das Fabric-Design? | AI/HPC-Netzwerkspezialist oder Anbieter | Netzwerkteam plus AI-Plattformverantwortlicher |
| Wer validiert die Topologie? | Anbieter-Fabric-Report, Subnet-/Fabric-Tools, NCCL-Tests | Audit der Switch/NIC-Konfiguration, Telemetrie, NCCL-Tests |
| Was bricht am häufigsten? | Placement-Mismatch, Firmware-/Treiber-Drift, ausgefallene Links, nicht unterstützte Topologieannahmen | Drift der verlustfreien Konfiguration, Fehlkonfiguration der Congestion, Interferenzen mit gemeinsamem Traffic, Queue-Mapping-Fehler |
| Was muss überwacht werden? | Link-Status, Portfehler, Congestion, Routen-Gesundheit, GPU/NIC-Affinität, NCCL-Performance | Drops, Pause-/ECN-Verhalten, PFC-Stürme, Retransmits, Buffer-Druck, NCCL-Performance |
| Welche Fähigkeiten sind knapp? | InfiniBand-Fabric-Spezialisten | Ingenieure, die sowohl Ethernet-Betrieb als auch RDMA-sensiblen KI-Traffic verstehen |
Wenn Ihr Team bereits starke Ethernet-Automatisierung, aber keine InfiniBand-Kenntnisse hat, kann RoCE operativ attraktiv sein. Wenn Ihr Team möchte, dass der Anbieter das KI-Fabric als getestete appliance-ähnliche Schicht verantwortet, kann InfiniBand das Lieferrisiko senken.
Kosten: Berücksichtigen Sie das Fabric-Risiko, nicht nur den Switch-Preis
RoCE wird oft als günstiger dargestellt, weil Ethernet-Equipment breit beschafft und wiederverwendet werden kann. InfiniBand wird oft als teuer dargestellt, weil es ein spezialisiertes AI/HPC-Fabric ist. Diese Aussagen können stimmen und dennoch zu schlechten Entscheidungen führen.
Für GPU-Cluster bestehen die Fabric-Kosten nicht nur aus Switch-, NIC-, Optik- und Kabelpreis. Es sind die Kosten für nützliche erledigte Arbeit.
fabric_adjusted_gpu_cluster_cost =
  compute_capacity
  + network_adapters
  + switches
  + optics_and_cables
  + rack_power_and_space
  + storage_and_data_path
  + fabric_operations
  + failed_job_and_retry_waste
  + queue_delay_and_idle_gpu_time
  + support_and_escalation
Dann normalisieren Sie:
cost_per_accepted_training_run =
  fabric_adjusted_gpu_cluster_cost
  / accepted_training_runs_completed_on_time
oder:
cost_per_accepted_output =
  fabric_adjusted_gpu_cluster_cost
  / accepted_inference_outputs_after_retries
RoCE kann gewinnen, wenn Ethernet-Beschaffung, Wiederverwendung und Betrieb die Gesamtkosten senken, ohne die Auftragsfertigstellung zu beeinträchtigen. InfiniBand kann gewinnen, wenn höhere Fabric-Kosten Trainingsverzögerungen, fehlgeschlagene Multi-Node-Jobs und wochenlanges Tuning vermeiden. Eine günstigere Fabric, die teure GPUs untätig lässt, ist nicht günstiger.
Verknüpfen Sie die Kostenentscheidung roce networking vs infiniband mit drei Zahlen:
- Nützliche GPU-Auslastung nach Netzwerk-Stalls und fehlgeschlagenen Jobs.
- Benchmark-Abnahmerate über die exakte Node-Anzahl.
- Betriebsstunden, die erforderlich sind, um die Fabric stabil zu halten.
Wenn diese Zahlen fehlen, ist das Kostenmodell noch nicht bereit.
Passung zum Workload: Training, Inference, Storage und gemischte Cluster
Der richtige roce vs infiniband comparison hängt vom Traffic-Muster ab.
Verteiltes Training
Verteiltes Training ist der stärkste Fall für InfiniBand. Große All-Reduce- und Reduce-Scatter-Operationen, synchronisierte Schritte und Scale-out-Jobs bestrafen Jitter. Wenn sich der Job über viele Nodes erstreckt und das Unternehmen Wert darauf legt, Trainingsfenster planmäßig einzuhalten, ist InfiniBand oft der risikoärmere Weg.
RoCE kann trotzdem eine gültige Wahl sein, insbesondere in Organisationen mit starker Ethernet/RDMA-Praxis. Es muss jedoch mit derselben Modellfamilie, demselben Framework, derselben Genauigkeit, derselben Batch Size, derselben Node-Anzahl und demselben Checkpoint-Muster nachgewiesen werden, die Sie später ausführen wollen.
Aufgeteilte und verteilte Inference
Inference ist gemischter. Wenn ein Modell über GPUs oder Nodes aufgeteilt ist, ist Netzwerklatenz wichtig. Wenn die Flotte überwiegend aus unabhängigen Replikaten besteht, können GPU-Speicher, Batching, Cache-Verhalten, Queueing und Autoscaling wichtiger sein als die Fabric.
Für viele Production-Inference-Teams ist die bessere erste Frage nicht InfiniBand vs. RoCE. Es ist, ob der Workload überhaupt direkte GPU-Kontrolle benötigt. Wenn eine verwaltete Model-API das Ziel bei Latenz, Qualität, Datenschutz und Kosten erreicht, vergleichen Sie diesen Weg, bevor Sie einen Clustervertrag unterschreiben.
Weiterführende Lektüre: Flatkeys Leitfäden zu GPU-Cloud vs. Model-API, die beste GPU für LLM-Inference und vLLM-Deployment decken die Kostengrenze auf der Serving-Seite ab.
Storage-intensive Workloads
Trainingsläufe, die große Datensätze bereitstellen, häufig Checkpoints schreiben oder Modellgewichte neu laden, können zu Storage-Netzwerk-Problemen werden. Eine schnelle GPU-Fabric behebt weder langsames Dataset-Staging noch ein gemeinsam genutztes Filesystem, das während Checkpoints an seine Grenzen stößt.
Sowohl für InfiniBand als auch für RoCE sollten Sie Storage in den Benchmark einbeziehen:
- Dataset-Ladezeit.
- Checkpoint-Schreib- und Wiederherstellungszeit.
- Verhalten des lokalen NVMe-Spillovers.
- Pfad zum Objektspeicher und Egress.
- Contention des gemeinsamen Filesystems.
- Wiederherstellungszeit nach einem Node-Ausfall.
GPU-Cluster mit mehreren Tenants
Multi-Tenant-Cluster benötigen stärkere Isolation als ein Benchmark-Labor. Lautstarke Nachbarn, Hintergrund-Storage-Jobs, User-Container und Wartungsfenster können das Fabric-Verhalten verändern. Sowohl InfiniBand als auch RoCE benötigen Admission Control, Quoten, Telemetrie und Incident Response. RoCE erfordert zusätzliche Sorgfalt, wenn RDMA-Traffic operative Grenzen mit normalem Ethernet-Traffic teilt.
Abnahmetest für beide Fabrics
Akzeptieren Sie nicht den infiniband vs roce comparison eines Anbieters als Beweis. Führen Sie den Abnahmetest auf genau der Cluster-Architektur aus, die Sie kaufen oder mieten werden.
1. Test-Stückliste fixieren
Dokumentieren Sie:
- GPU-Modell, Speicherkapazität und GPUs pro Node.
- CPU, RAM, PCIe-/SXM-Layout, NUMA und lokales NVMe.
- NIC-/HCA-Modell, Geschwindigkeit, Firmware und Treiber.
- Switch-Modell, Switch-OS und Fabric-Generation.
- Optik, Kabeltyp und Link-Geschwindigkeit.
- MTU- und Queue-Konfiguration.
- Placement Group, Rack, Zone, Region und Node-Anzahl.
- CUDA, NCCL, MPI, Framework, Container-Image und Kernel-Version.
Wenn sich eines davon nach dem Benchmark ändert, führen Sie den Test erneut aus.
2. NCCL-Tests über jeden Node hinweg ausführen
NVIDIAs Projekt nccl-tests ist die praktische Baseline, weil es sowohl die Leistung als auch die Korrektheit von NCCL-Operationen prüft und Multi-Node-MPI-Läufe unterstützt.
Beispiel für eine Abnahmeausprägung:
# Build with MPI support.
make MPI=1 MPI_HOME=/path/to/mpi CUDA_HOME=/usr/local/cuda NCCL_HOME=/usr

# Example: 8 nodes, 8 GPUs per node, 64 ranks total.
mpirun -np 64 -N 8 ./build/all_reduce_perf -b 8 -e 8G -f 2 -g 1 \
  -n 50 -w 10 -a 2 -S 1 -J all-reduce-64gpu.json
Verfolgen Sie:
- Algorithmische Bandbreite und Bus-Bandbreite.
- Minimale, durchschnittliche und maximale Latenz.
- P95/P99 pro Iteration, falls aktiviert.
- Rank-Ausreißer.
- Fehlgeschlagene Korrektheitsprüfungen.
- Variation über wiederholte Läufe hinweg.
- Leistung nach einem Node-Neustart, einem Treiberneustart oder einem Switch-Wartungsereignis.
3. Den tatsächlichen Workload nachspielen
Mikrobenchmarks sind notwendig, aber nicht ausreichend. Spielen Sie einen realen Trainings- oder Inference-Job nach:
- Gleiche Modellfamilie und Sequenzlänge.
- Gleiche Framework- und Verteilungsstrategie.
- Gleiche Präzision, Quantisierung und Batch Size.
- Gleiche Checkpoint-Frequenz.
- Gleicher Datenpfad.
- Gleiche Autoscaling- oder Job-Scheduler-Richtlinie.
Vergleichen Sie dann Schrittzeit, Tokens/s, Warteschlangenverzögerung, Checkpoint-Dauer, Fehlerwiederherstellung und Kosten pro akzeptierter Ausgabe.
4. Fehler und Überlastung injizieren
Eine Fabric, die nur an einem sauberen Tag besteht, ist nicht produktionsreif.
Testen Sie:
- Ein Node aus dem Job entfernt.
- Ein Link ausgefallen oder degradiert.
- Checkpoint-Burst des Speichers während des Trainings.
- Hintergrund-Inferenzlast während eines Trainingsjobs.
- Schwellenwerte und Alarme für Switch-/NIC-Zähler.
- Antwort des Provider-Supports auf einen Fabric-Vorfall.
Der Gewinner von roce vs infiniband ist die Fabric, die nach diesen Tests nutzbare Arbeit vorhersehbar hält, nicht die Fabric mit der besseren theoretischen Datenrate.
Beschaffungsfragen für InfiniBand-Anbieter
Fragen Sie vor der Unterzeichnung diese Punkte:
- Welche genaue InfiniBand-Generation, welches Switch-Modell, welches Adapter-Modell und welche Link-Geschwindigkeit sind enthalten?
- Ist GPUDirect RDMA für den GPU-, Treiber- und Framework-Stack aktiviert und unterstützt?
- Sind alle Nodes garantiert in einer Fabric-Domäne oder Placement Group?
- Welche NCCL-All-Reduce-Ergebnisse können Sie für die gleiche GPU-Anzahl bereitstellen?
- Wer verantwortet Subnetzverwaltung, Firmware-Updates, Congestion-Tuning und Incident Response?
- Sind SHARP, adaptives Routing, Quality of Service oder In-Network-Features aktiviert und unterstützt?
- Welche Telemetrie kann der Kunde sehen: Port-Zähler, Congestion-Events, HCA-Fehler, Routenänderungen und Fabric-Metriken auf Job-Ebene?
- Welche finanziellen Folgen gibt es, wenn die angebotene Fabric den vereinbarten Benchmark nicht besteht?
- Kann das Cluster erweitert werden, ohne Topologie- oder Oversubscription-Annahmen zu ändern?
- Welche Wartungsfenster, Ersatzteile und Austauschzeiträume gelten?
Beschaffungsfragen für RoCE-Anbieter
Fragen Sie vor der Unterzeichnung diese Punkte:
- Ist die Fabric RoCE v2, und ist sie über die benötigte Topologie routbar?
- Welche Switch- und NIC-Modelle sind für diese exakte GPU-Cluster-Größe validiert?
- Welche PFC-, ECN-, DSCP-, Queue-, MTU- und Congestion-Control-Einstellungen sind erforderlich?
- Ist RDMA-Traffic von normalem Ethernet-Traffic isoliert oder wird er gemeinsam genutzt?
- Welche Zähler belegen, dass die verlustfreie Konfiguration unter NCCL-Last gesund ist?
- Wie werden PFC-Stürme, Pause-Frame-Aufbau, ECN-Fehlkonfiguration und Pufferdruck erkannt?
- Wer verantwortet Drift der Switch-Konfiguration und Firmware-Kompatibilität?
- Welche NCCL-Ergebnisse liegen für die gleiche Node-Anzahl und Workload-Klasse vor?
- Kann das Netzwerkteam die Konfiguration aus Code reproduzieren?
- Welche Support-Grenze gilt, wenn das Problem GPU-Treiber, NIC-Firmware, Switch-Richtlinie und Anwendungs-Framework umfasst?
Entscheidungsmatrix
Verwenden Sie diese Matrix nach dem Benchmark, nicht davor.
| Kriterium | InfiniBand bevorzugen, wenn... | RoCE bevorzugen, wenn... |
|---|---|---|
| Latenzsensitivität | Die Trainingsschrittzeit wird von Collectives dominiert oder p99-Jitter beeinträchtigt Inferenz | Tests zeigen unter realer Last stabile p95/p99-Werte |
| Skalierung | Das Cluster umfasst viele Nodes und benötigt vorhersehbare Platzierung | Das Cluster hat mittlere Größe oder die Ethernet-Fabric ist bereits in ähnlicher Größenordnung bewährt |
| Betrieb | Provider oder Team verfügt über InfiniBand-Fabric-Expertise | Das Netzwerkteam hat starke Ethernet-Automatisierung und RDMA-spezifische Praxis |
| Beschaffung | Sie können eine validierte KI-/HPC-Fabric kaufen oder mieten | Sie benötigen breitere Switch-Beschaffung oder Ethernet-Standardisierung |
| Kosten | Die Vermeidung fehlgeschlagener Jobs und von Tuning-Verzögerungen rechtfertigt die Kosten der Spezial-Fabric | Ethernet-Einsparungen bleiben nach Tuning-, Telemetrie- und Wiederholkosten bestehen |
| Flexibilität | Das Cluster ist für KI-/HPC-Workloads reserviert | Die Fabric muss zu breiteren Rechenzentrums-Netzwerkpraktiken passen |
| Risiko | Die Projektfrist ist knapp und Fabric-Unklarheit ist teuer | Das Team hat Zeit und Kompetenz, verlustfreies Ethernet zu validieren und zu betreiben |
Wenn die Matrix ein Unentschieden ergibt, mieten oder benchmarken Sie beides. Multi-Node-GPU-Netzwerke sind zu teuer, um allein anhand einer Protokollzusammenfassung entschieden zu werden.
Kopierbares Arbeitsblatt für RoCE vs InfiniBand
Verwenden Sie diese Tabelle im Beschaffungsdokument.
| Feld | InfiniBand-Option | RoCE-Option |
|---|---|---|
| GPU-Modell und Node-Anzahl | ||
| Fabric-Generation und Link-Geschwindigkeit | ||
| NIC/HCA pro Node | ||
| Switch-Modell und Port-Anzahl | ||
| Oversubscription-Verhältnis | ||
| Placement-Garantie | ||
| GPUDirect-RDMA-Unterstützung | ||
| NCCL-All-Reduce-Busbandbreite | ||
| NCCL p95/p99 oder maximale Latenz | ||
| Trainingsschrittzeit | ||
| Checkpoint-Schreib-/Wiederherstellungszeit | ||
| Fabric-Drops-/Congestion-Zähler | ||
| Verantwortlicher für den Betrieb | ||
| Support-SLA | ||
| Monatliche Fabric-Kosten | ||
| Schätzung für Leerlauf-/Wiederholungsverluste | ||
| Kosten pro akzeptierter Ausgabe | ||
| Erweiterungspfad | ||
| Exit-Risiko |
Die wichtigsten Zeilen sind nicht der aufgelistete Fabric-Preis. Es sind Benchmark-Ergebnis, Verantwortlicher für den Betrieb, Leerlauf-/Wiederholungsverluste und der Erweiterungspfad.
Wann eine Modell-API die bessere Antwort ist
Einige Teams, die roce vs infiniband recherchieren, sind eigentlich noch nicht bereit, eine Netzwerk-Fabric zu kaufen. Sie versuchen, die Kosten der KI-Ausgabe zu senken, Warteschlangenverzögerungen zu reduzieren oder ein Produktfeature auszuliefern.
Wenn die Workload keine benutzerdefinierten Gewichte, kein direktes GPU-Scheduling, keine benutzerdefinierten Kernel, keine strikte Platzierung oder keine Isolierung auf Hardware-Ebene erfordert, vergleichen Sie zuerst eine verwaltete Modell-API. Flatkey gibt Teams einen Schlüssel, ein Guthaben und ein einheitliches Nutzungsprotokoll über offizielle Modelle und KI-Tools hinweg, was einfacher sein kann, als einen GPU-Cluster zu betreiben, solange sich das Produkt noch verändert.
Nutzen Sie den Fabric-Ansatz, wenn Sie Hardware-Kontrolle benötigen. Nutzen Sie einen Modell/API-Ansatz, wenn die Geschäftskennzahl akzeptierte Ausgaben sind und nicht der Besitz des Netzwerks.
Verwandte Flatkey-Leitfäden:
- TCO von GPU-Clustern für die Kalkulation von Cloud-Miete, Colocation und On-Premises.
- GPU-Cluster-Miete für die Bewertung von Anbietern und Kapazitätsverträge.
- GPU-Mietpreise für On-Demand-, Spot-, Reserved- und versteckte Kosten.
- Serverless-GPU vs. dedizierte GPU für Kaltstarts, ungenutzte Kapazität und Kontrolle.
Offizielle Quell-Checkliste
Nutzen Sie offizielle Seiten als Quellenprüfung und validieren Sie dann den genauen Cluster, den Sie kaufen.
| Quelle | Zu verifizieren |
|---|---|
| InfiniBand Trade Association: About InfiniBand | InfiniBand als branchenübliche Switched-Fabric für Server- und Speicher-Konnektivität. |
| NVIDIA Quantum InfiniBand platform | InfiniBand-Switch, Adapter, Fabric-Management, SHARP und Positionierung der Fabric für KI/HPC. |
| NVIDIA Spectrum-X Ethernet | Für Ethernet/RoCE ausgerichtete Positionierung des KI-Netzwerks und zu verifizierende Aussagen zum Congestion-Management. |
| Azure ND H100 v5 sizes | Beispiel für Cloud-GPU-Cluster mit dediziertem InfiniBand pro GPU und GPUDirect RDMA. |
| AWS Elastic Fabric Adapter | Cloud-Alternative mit OS-Bypass, Congestion Control, Libfabric, NCCL und GPUDirect-RDMA-Unterstützung auf ausgewählten Instanzen. |
| Google Cloud GPUDirect documentation | Anforderungen für das Cloud-GPU-Networking-Setup bei GPUDirect-fähigen Instanzen der A3-Familie. |
| NVIDIA nccl-tests | Wiederholbarer Collective-Benchmark und Korrektheitstests für die exakte Cluster-Topologie. |
Betrachten Sie diese Seiten nicht als Ersatz für Abnahmetests. Betrachten Sie sie als die minimale Quellenliste für eine ernsthafte Käuferprüfung.
Häufig gestellte Fragen
Ist InfiniBand immer schneller als RoCE?
Nein. InfiniBand ist normalerweise die risikoärmere Wahl für speziell aufgebaute, latenzsensitive KI/HPC-Fabrics, aber eine gut entworfene RoCE-v2-Fabric kann ebenfalls gut performen. Vergleichen Sie den exakten Cluster mit NCCL- und Anwendungstests.
Ist RoCE günstiger als InfiniBand?
RoCE kann günstiger sein, wenn Ethernet-Beschaffung, Wiederverwendung und bestehende Betriebsstrukturen die Gesamtkosten senken. Es ist nicht günstiger, wenn Lossless-Ethernet-Tuning, Congestion-Vorfälle, fehlgeschlagene Jobs oder ungenutzte GPUs die Einsparungen zunichtemachen.
Was ist der Unterschied zwischen RoCE v2 und InfiniBand?
RoCE v2 überträgt RDMA über routbare Ethernet/IP-Netzwerke. InfiniBand ist eine dedizierte Switched-Fabric-Architektur, die häufig für HPC- und KI-Cluster verwendet wird. Der operative Unterschied besteht darin, dass RoCE die Flexibilität des Ethernet-Designs und den Tuning-Aufwand übernimmt, während InfiniBand stärker auf die Fabric spezialisiert ist.
Was ist besser für verteiltes Training?
Für großes, eng gekoppelte verteilte Trainings ist InfiniBand oft die sicherere Standardwahl. RoCE kann eine starke Option sein, wenn die Ethernet-Fabric isoliert, getunt, überwacht und mit derselben Trainings-Workload erprobt ist.
Was ist besser für Inferenz?
Das hängt von der Inferenzarchitektur ab. Aufgesplittete Modelle und Serving über mehrere Knoten hinweg sind auf Fabric-Latenz angewiesen. Unabhängige Replikate achten möglicherweise stärker auf GPU-Speicher, Batching, Cache-Hitrate, Autoscaling und Kosten pro akzeptierter Ausgabe.
Was sollte ich vor der Auswahl benchmarken?
Führen Sie NCCL All-Reduce über die Zielanzahl von Knoten aus, spielen Sie die reale Workload erneut ab, beziehen Sie Speicher-/Checkpoint-Traffic ein, injizieren Sie Fehler oder Congestion und zeichnen Sie Fabric-Counter auf. Die Entscheidung roce vs infiniband sollte auf diesen Ergebnissen basieren.
Endempfehlung
Wählen Sie roce vs infiniband nicht anhand eines generischen Benchmarks. Entscheiden Sie anhand der Workload, des Betriebsmodells und des Abnahmetests.
Wählen Sie InfiniBand, wenn der Cluster eine dedizierte KI/HPC-Fabric ist, verteiltes Training der kritische Pfad ist und verpasste Trainingsfenster teuer sind. Wählen Sie RoCE, wenn Ethernet-Standardisierung, Beschaffungsflexibilität und bestehende Betriebsprozesse wichtig sind und das Team ein verlustfreies RDMA-Verhalten unter realen GPU-Workloads nachweisen kann.
Wenn die Anwendung nur KI-Ausgaben benötigt und keine direkte Kontrolle über die GPU-Fabric, vergleichen Sie zunächst Flatkey-verwaltete Modell/API-Ansätze, bevor Sie den Cluster mieten oder kaufen. Das günstigste Netzwerk ist das, das Sie nicht betreiben müssen.


