
flatkey.ai Blog
Einblicke, Produktnotizen und Implementierungsleitfäden für Teams, die mit KI-APIs entwickeln.
Architektur von KI-Gateways
Neueste Artikel in Architektur von KI-Gateways.
WeiterlesenMigration von Basis-URL und SDK
Neueste Artikel in Migration von Basis-URL und SDK.
WeiterlesenKosten, Abrechnung und Betrieb
Neueste Artikel in Kosten, Abrechnung und Betrieb.
WeiterlesenUnternehmenskontrollen und Vertrauen
Neueste Artikel in Unternehmenskontrollen und Vertrauen.
WeiterlesenGateway-Vergleiche
Neueste Artikel in Gateway-Vergleiche.
WeiterlesenLeitfäden für Modelle und Modalitäten
Neueste Artikel in Leitfäden für Modelle und Modalitäten.
WeiterlesenZuverlässigkeit und Routing
Neueste Artikel in Zuverlässigkeit und Routing.
WeiterlesenWerkzeugintegrationen
Neueste Artikel in Werkzeugintegrationen.
Weiterlesen
Grok API Preise (2026): alle Modelle, Tool-Gebühren und Multiplikatoren
Aktuelle Preise der xAI Grok API: Text-, Bild-, Video- und Sprachtarife, die fünf Multiplikatoren (langer Kontext, Priorität, US-Region, Batch und Tools), ein Kostenrechner und der Preisvergleich mit GPT, Claude, Gemini und Qwen.
Was ist ein LLM-Gateway? Funktionsweise, wichtige Features und 7 Optionen im Vergleich (2026)
Was ein LLM-Gateway ist, wie es Schritt für Schritt funktioniert, die 9 wichtigsten Features, Unterschiede zu API-Gateway, Modell-Router und MCP-Gateway, wann Sie eines brauchen und 7 Gateways im Vergleich.
Mistral API Preise (2026): alle Modelle, Batch-Rabatt und Kostenbeispiele
Vollständige Mistral-API-Preisliste (offizielle Daten, Oktober 2026), Gratis-Modus, Batch- und Cache-Rabatte, Kostenrechner, Preisvergleich mit GPT, Claude, Gemini und Qwen sowie Code.
OpenAI-kompatible API von Amazon Bedrock: Base URL, Authentifizierung, Modelle und Code (2026)
So rufen Sie Amazon Bedrock mit dem OpenAI SDK auf: Endpoint-Wahl, kurz- und langfristige API-Keys, Modell-IDs, Code für curl/Python/Node, Guardrails, Preise und Lösungen für typische Fehler.
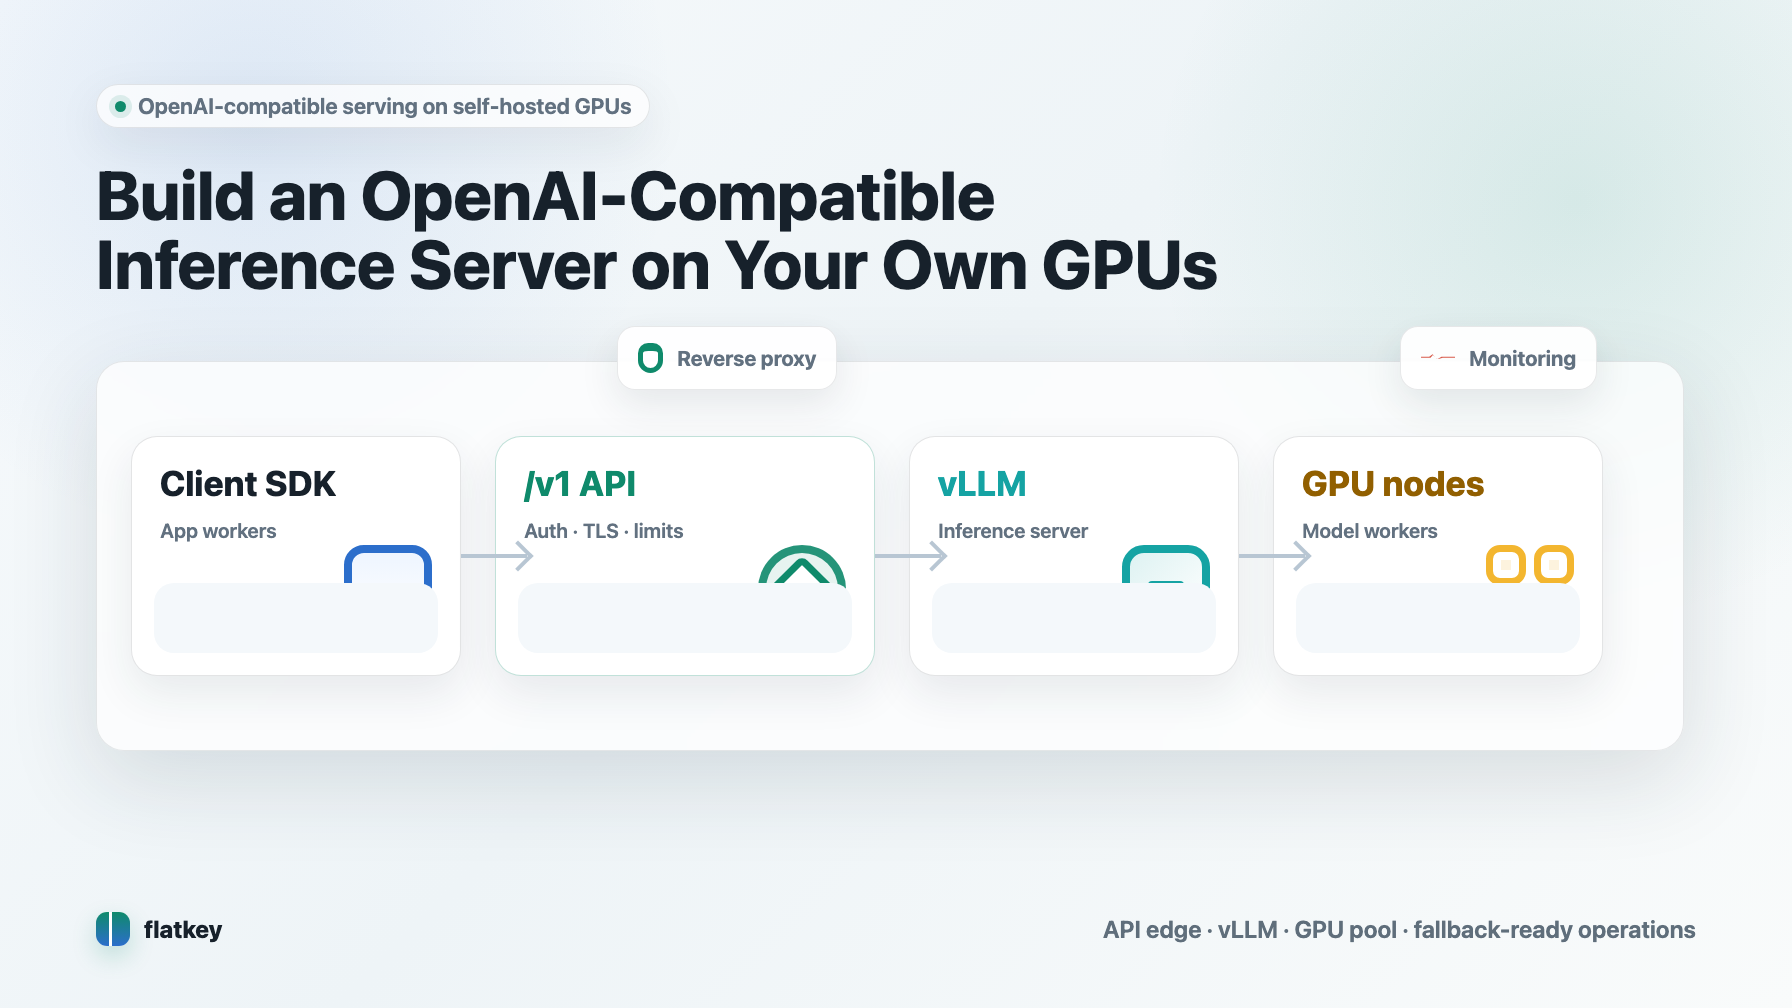
LLM selbst hosten (2026): Wann es sich lohnt, welche Hardware Sie brauchen und wie Sie es bereitstellen
Ein selbst gehostetes LLM führt Modelle mit offenen Gewichten auf GPUs aus, die Sie kontrollieren. Erfahren Sie, wann es günstiger ist als eine Abrechnung pro Token (mit GPU-Preisen vom Oktober 2026), wie Sie den GPU-Speicher dimensionieren, welches Serving-Tool passt und wie Sie einen OpenAI-kompatiblen vLLM-Server mit Ausweichlösung bereitstellen.
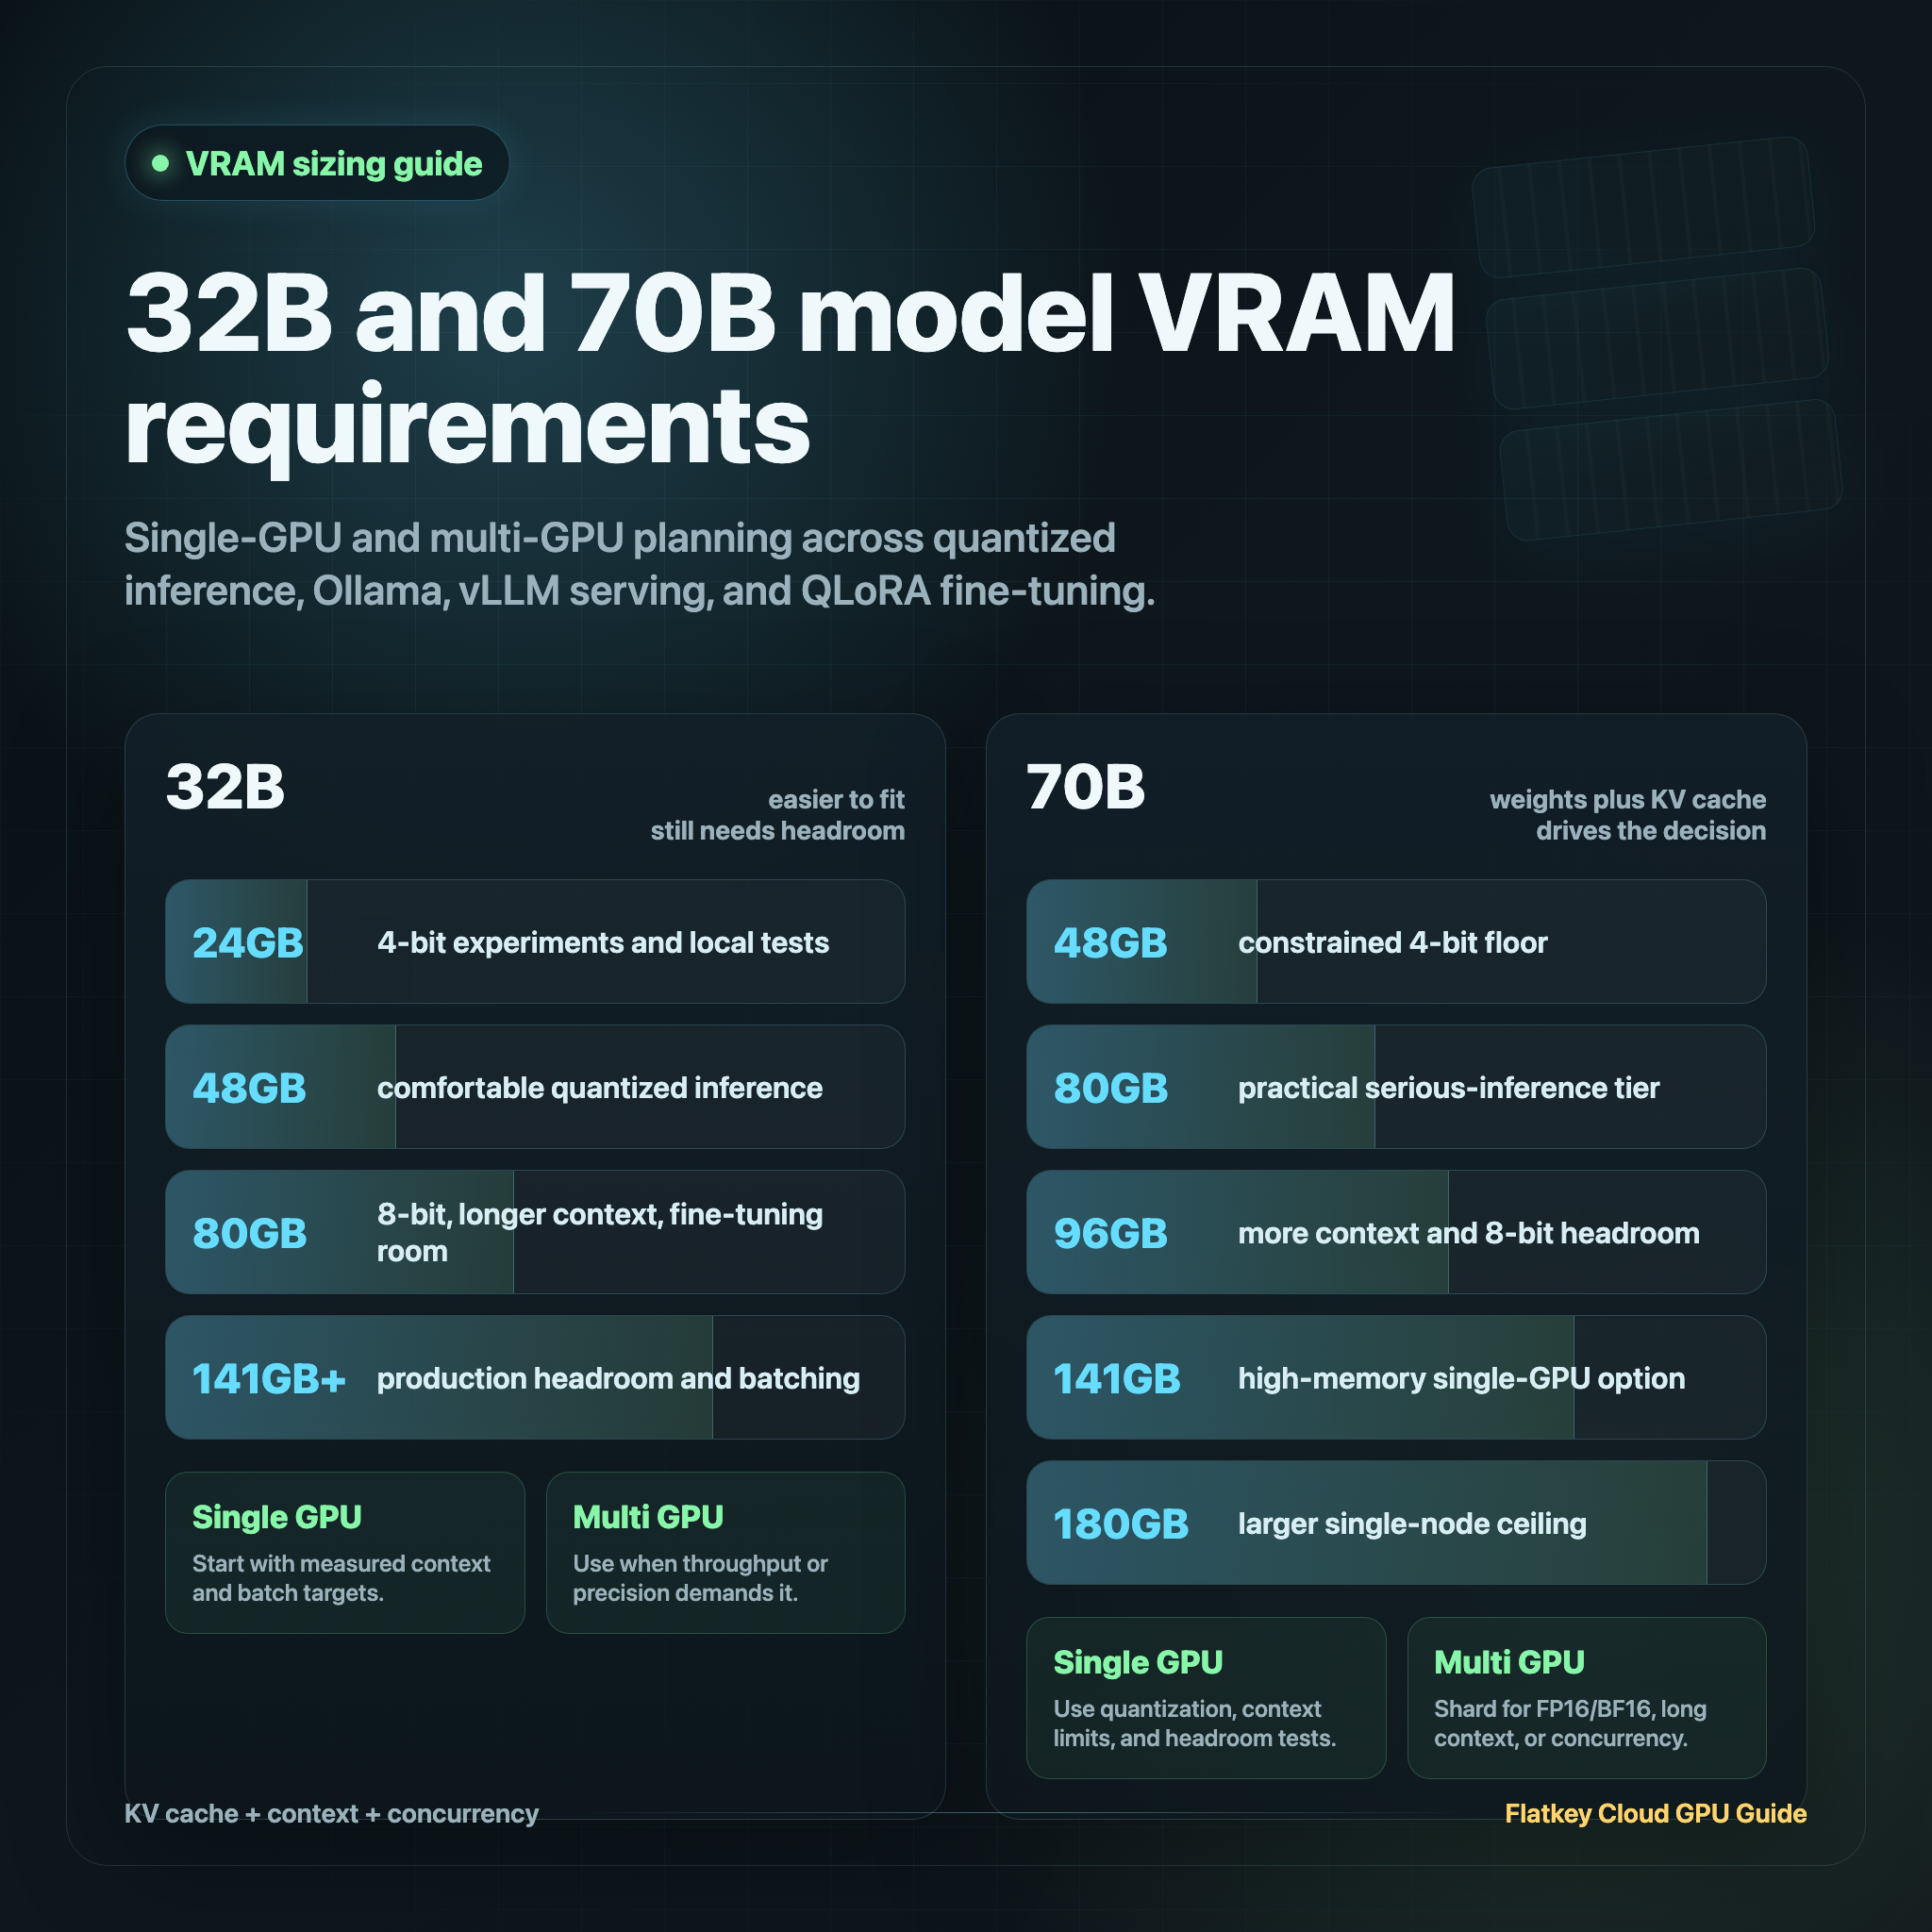
VRAM-Leitfaden für 32B- und 70B-Modelle: Single-GPU- und Multi-GPU-Optionen
Erfahren Sie praxisnahe VRAM-Anforderungen für 32B- und 70B-Modelle bei 4-Bit-, 8-Bit- und FP16/BF16-Inferenz, Ollama, QLoRA-Fine-Tuning und Multi-GPU-Optionen.
Fehler „API Key Not Found in Cookies“: 6 Wege zur Behebung
Beheben Sie „API Key Not Found in Cookies“ und häufige Fehler, bei denen der API-Schlüssel nicht funktioniert – mit Cookie-Prüfungen, Bearer-Token-Setup, Proxy-Debugging und Key-Rotation.
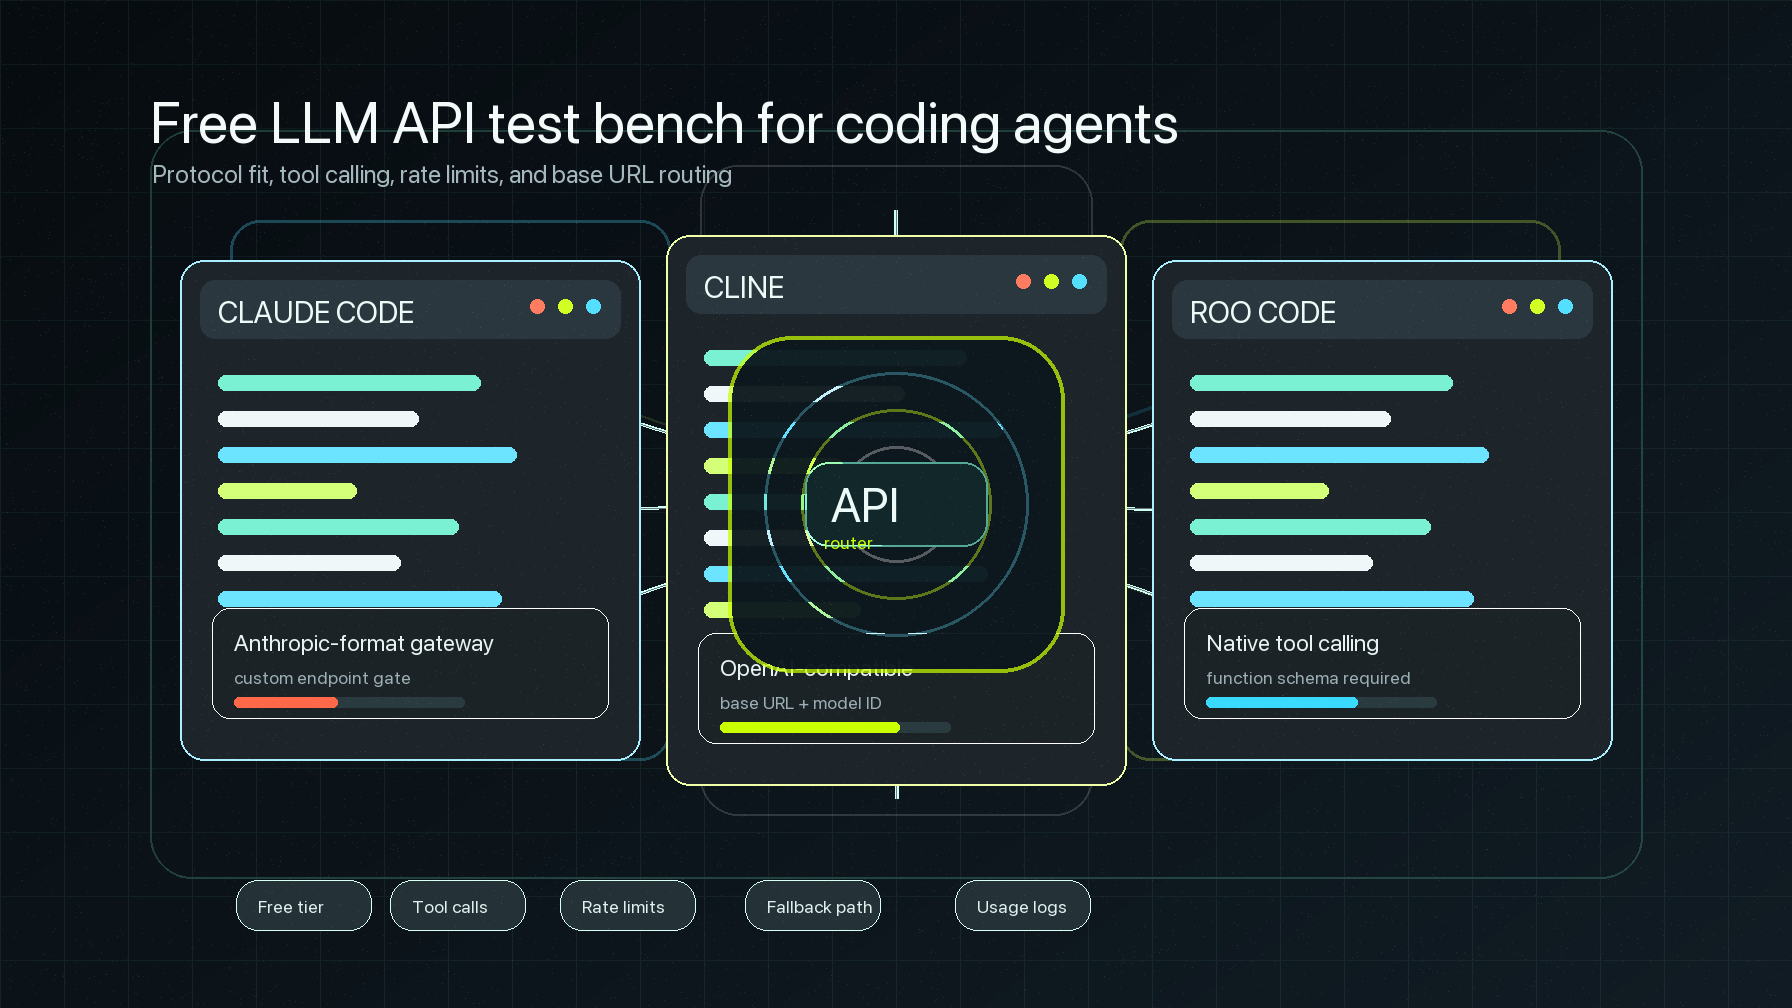
Welches kostenlose LLM ist am besten zum Programmieren? Getestet mit Claude Code, Cline und Roo Code
Ein praktischer Kompatibilitätsleitfaden für kostenlose LLM-APIs für Coding-Agents – mit Blick auf Claude Code, Cline, Roo Code, Tool-Calling, Base URLs und Quota-Fallen.
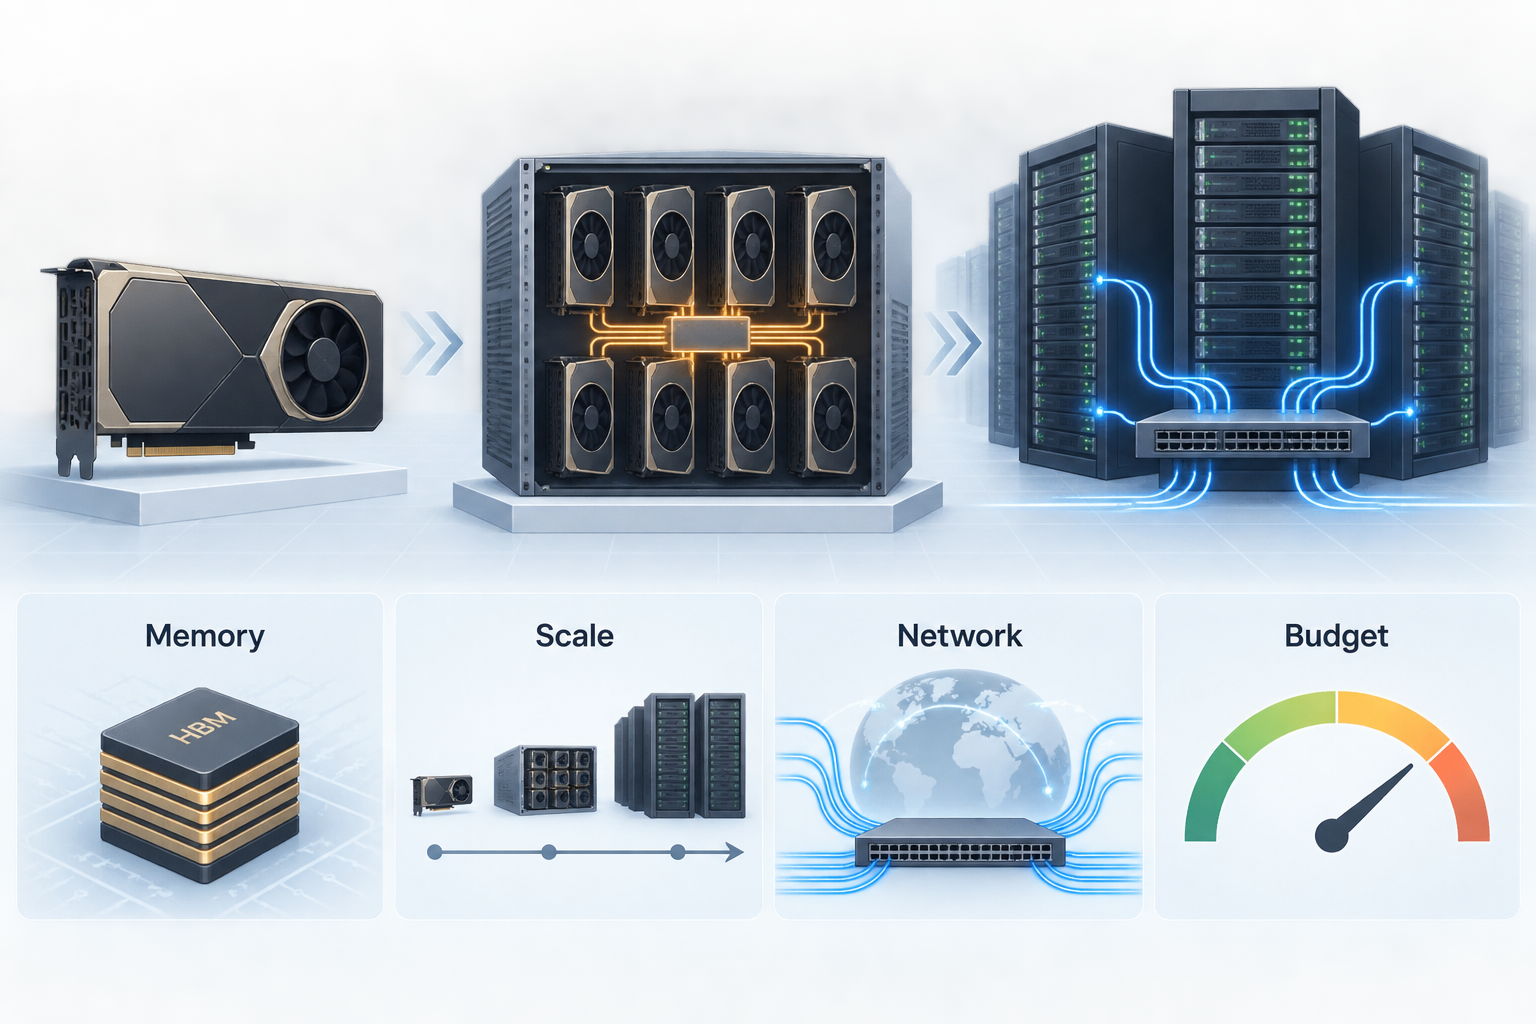
Beste GPU für LLM-Training: Skalierung, Speicher, Netzwerk und Budget
Ein praktischer Leitfaden für 2026 zur Auswahl der besten GPU für das LLM-Training nach Skalierung, Speicher, Netzwerk, Provider-Passung und Kosten pro fertiggestelltem Checkpoint.
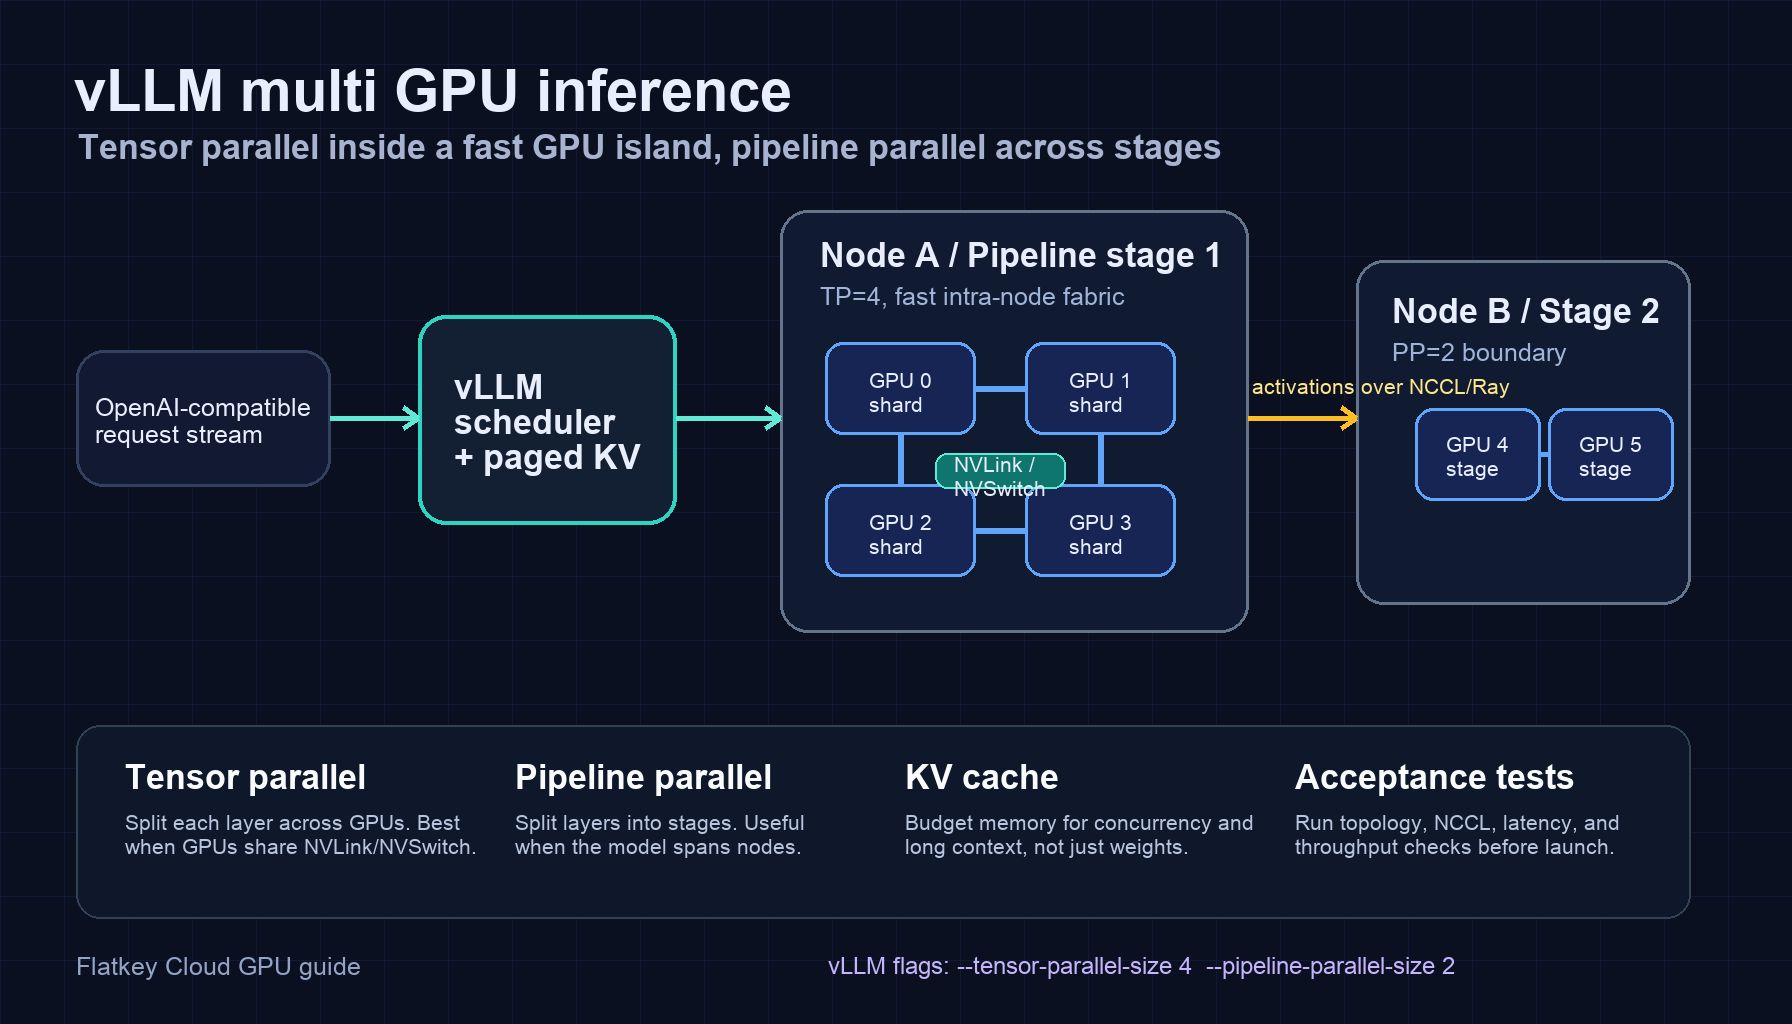
vLLM Multi-GPU-Inferenz: Tensor- und Pipeline-Parallel-Setup
Richten Sie vLLM Multi-GPU-Inferenz mit Tensor Parallelism, Pipeline Parallelism, Ray, Topologieprüfungen, Beispielen und Produktionstests ein.
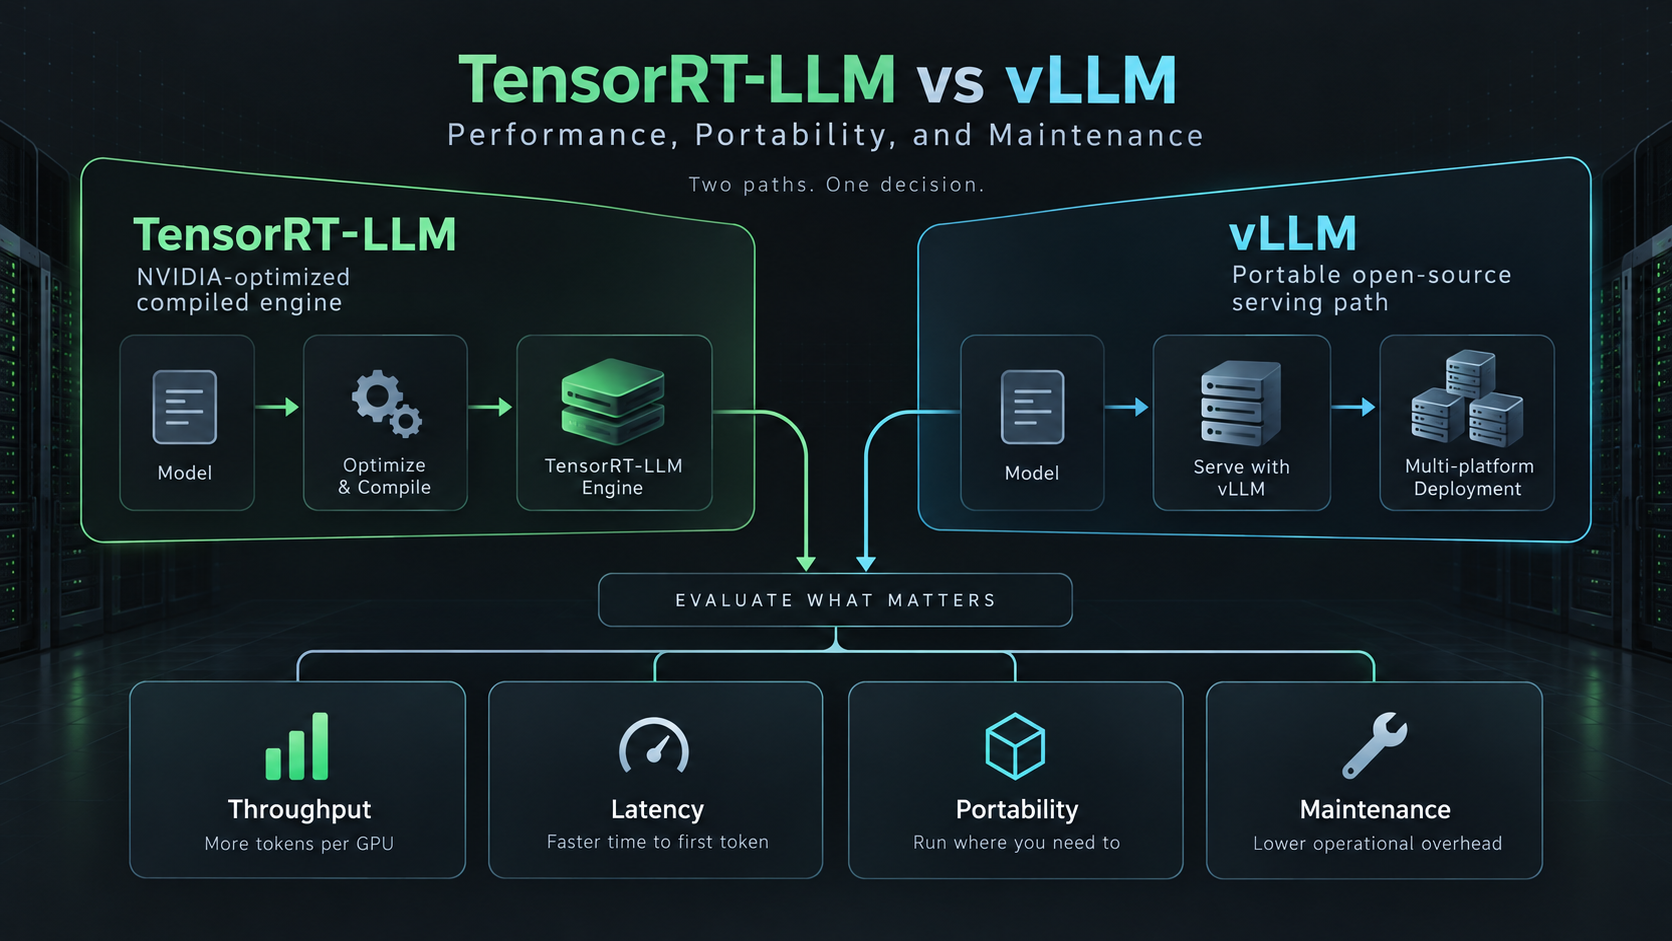
TensorRT-LLM vs. vLLM: Leistung, Portabilität und Wartung
Ein praktischer Vergleich von TensorRT-LLM und vLLM für KI-Infrastrukturteams, die eine LLM-Serving-Engine nach Leistung, Portabilität, Wartung und Benchmark-Design auswählen.
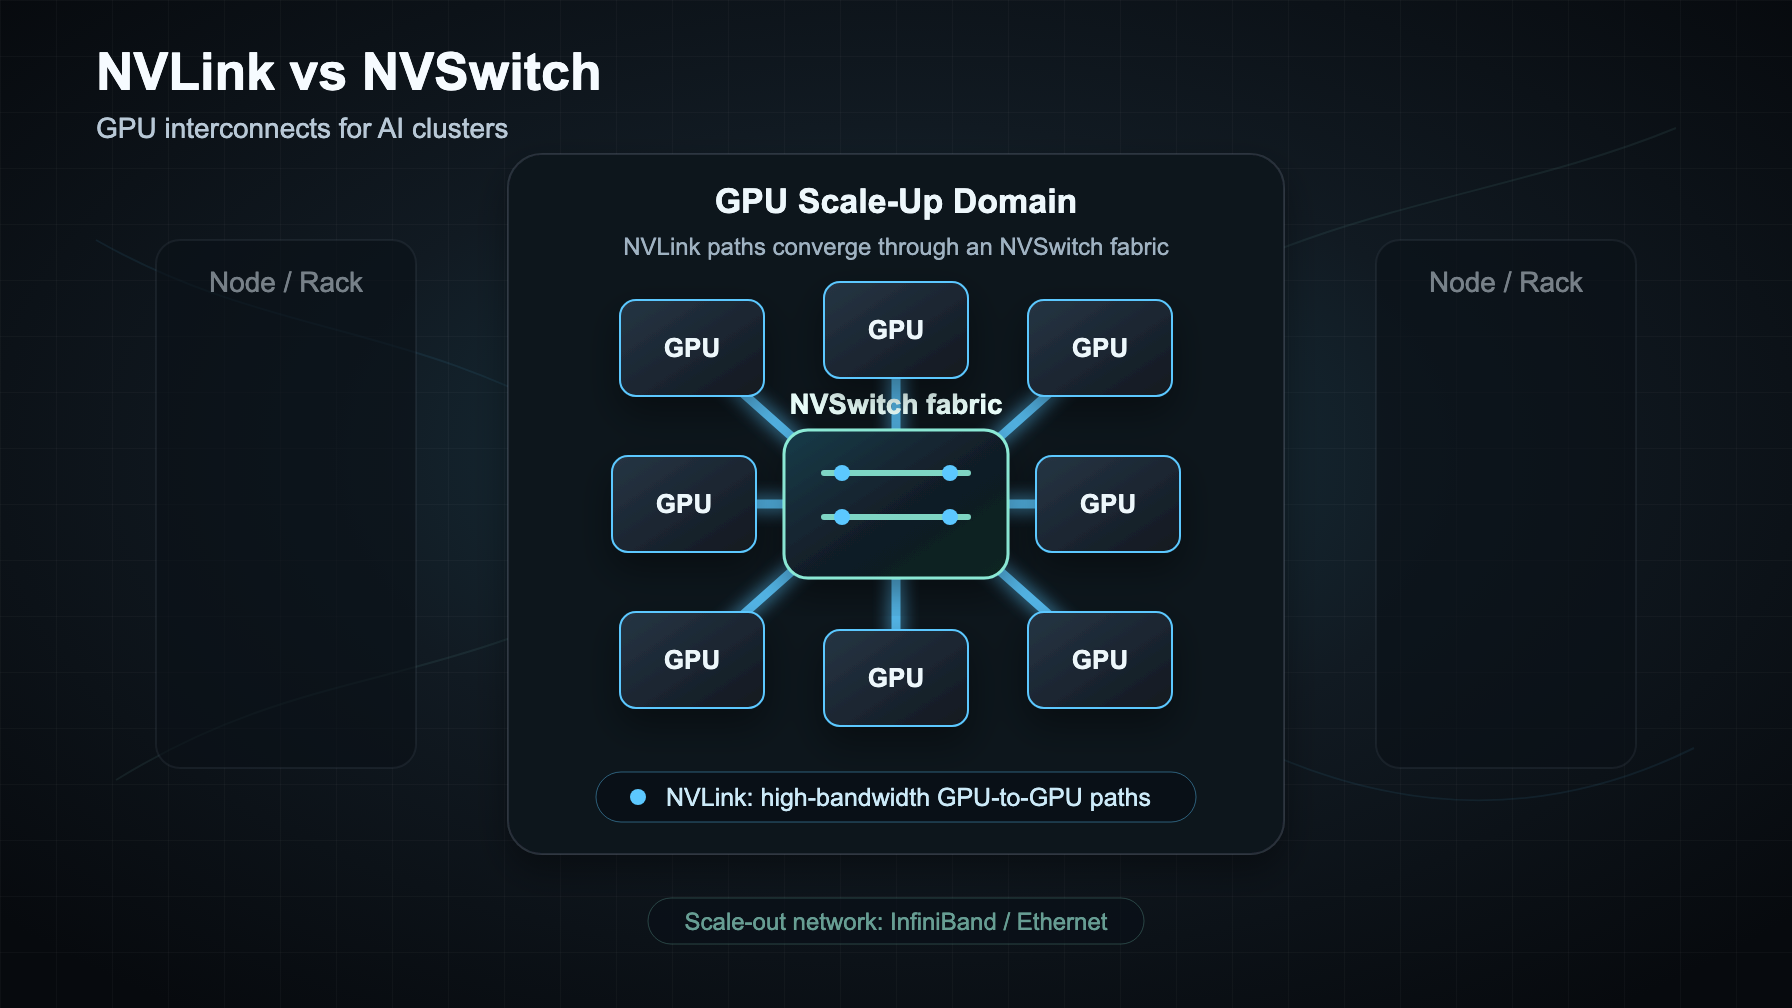
NVLink vs. NVSwitch: GPU-Interconnects für KI-Cluster erklärt
NVLink ist die GPU-zu-GPU-Verbindung, NVSwitch das Fabric, und InfiniBand oder Ethernet ist das Scale-out-Netzwerk. Hier erfahren Sie, wie Sie für KI-Cluster die richtige Wahl treffen.
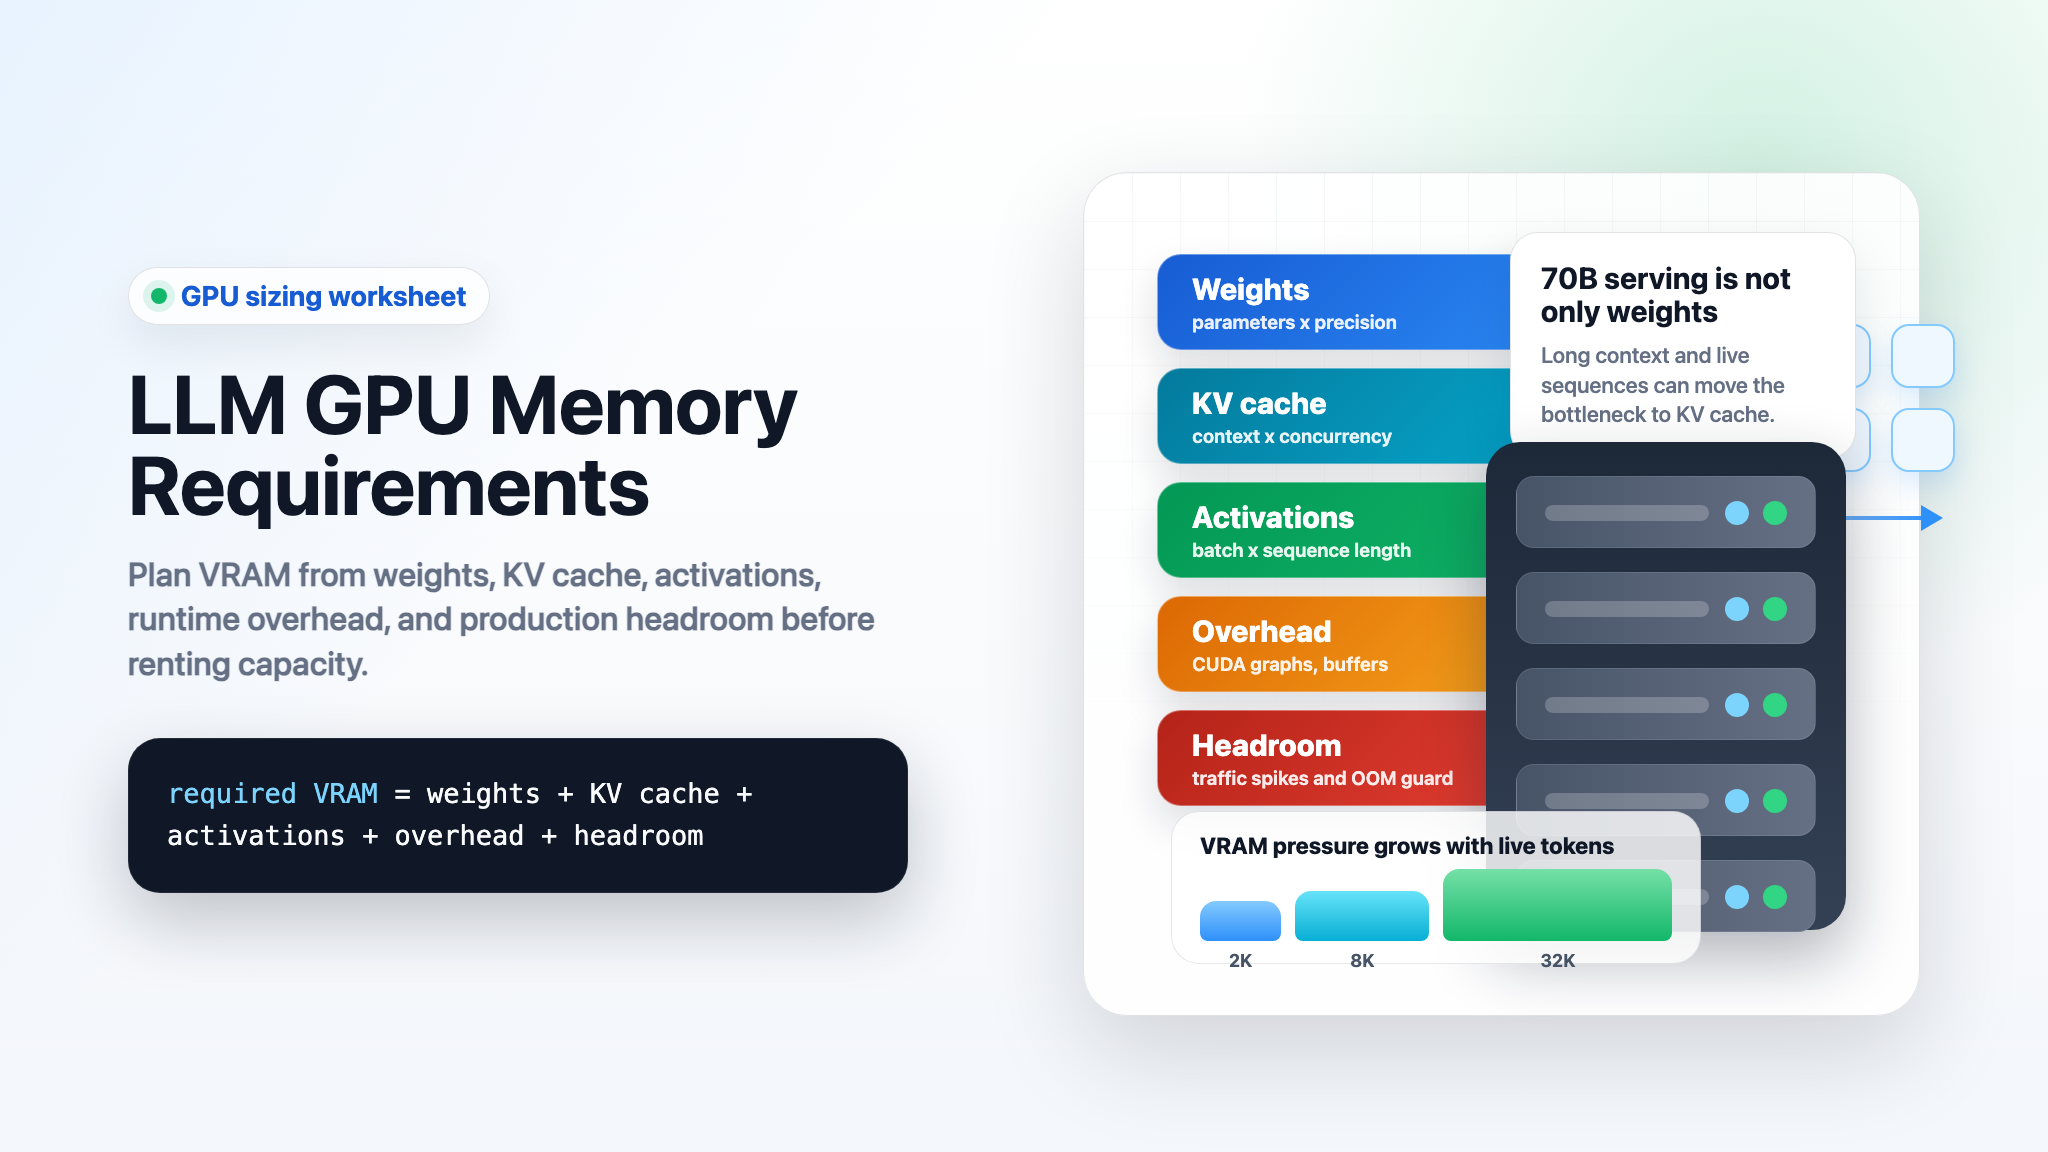
LLM-GPU-Speicheranforderungen: Gewichte, KV-Cache, Aktivierungen und Overhead
Ein praktisches Arbeitsblatt zur Schätzung des GPU-Speicherbedarfs von LLMs für Gewichte, KV-Cache, Aktivierungen, Serving-Overhead, vLLM-Planung für 70B-Modelle, Fine-Tuning und Training.
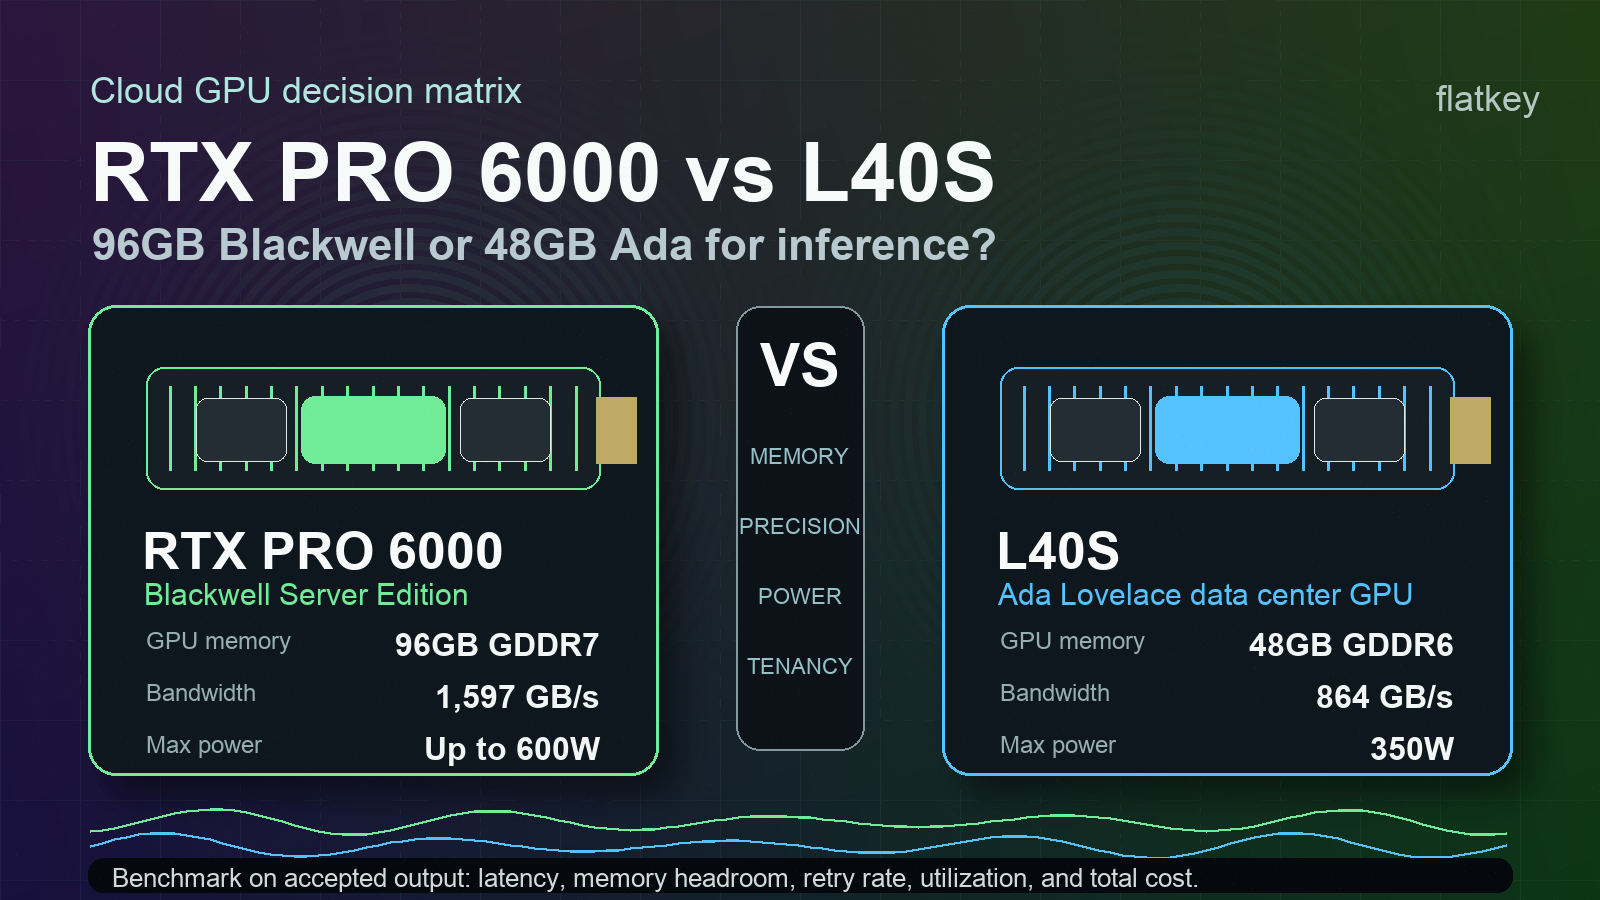
RTX PRO 6000 vs. L40S: 96 GB Blackwell oder Ada-Inference-GPU?
Vergleichen Sie NVIDIA L40S und RTX PRO 6000 Blackwell Server Edition für LLM-Inferenz, multimodale Workloads, Speicherbedarf, Leistung und Kosten pro verarbeitetem Output.
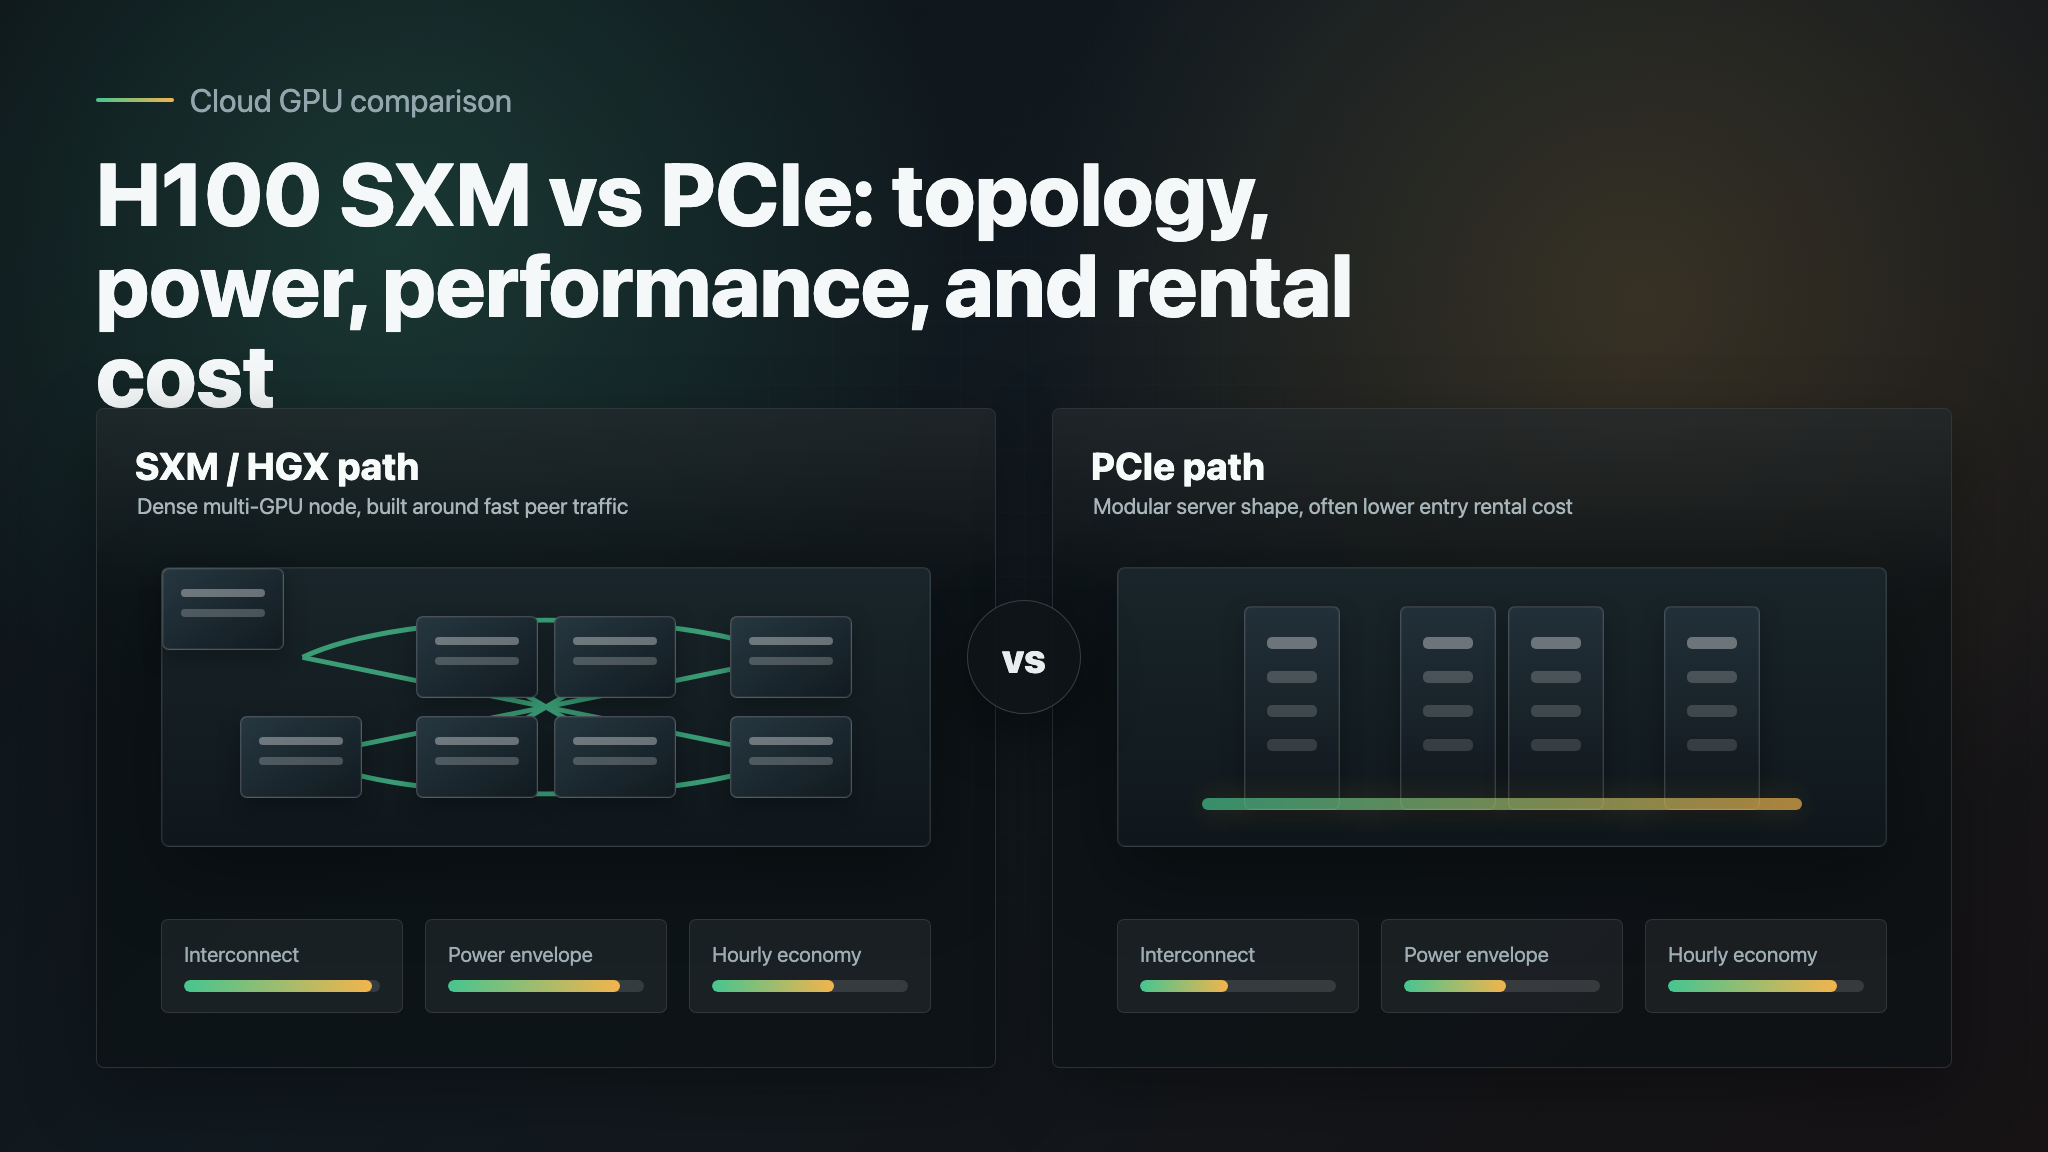
H100 SXM vs. PCIe: NVLink, Leistung, Performance und Mietkosten
Vergleichen Sie H100 PCIe und SXM hinsichtlich NVLink, Stromverbrauch, Workload-Performance und Mietkosten, bevor Sie Cloud-GPUs mieten.
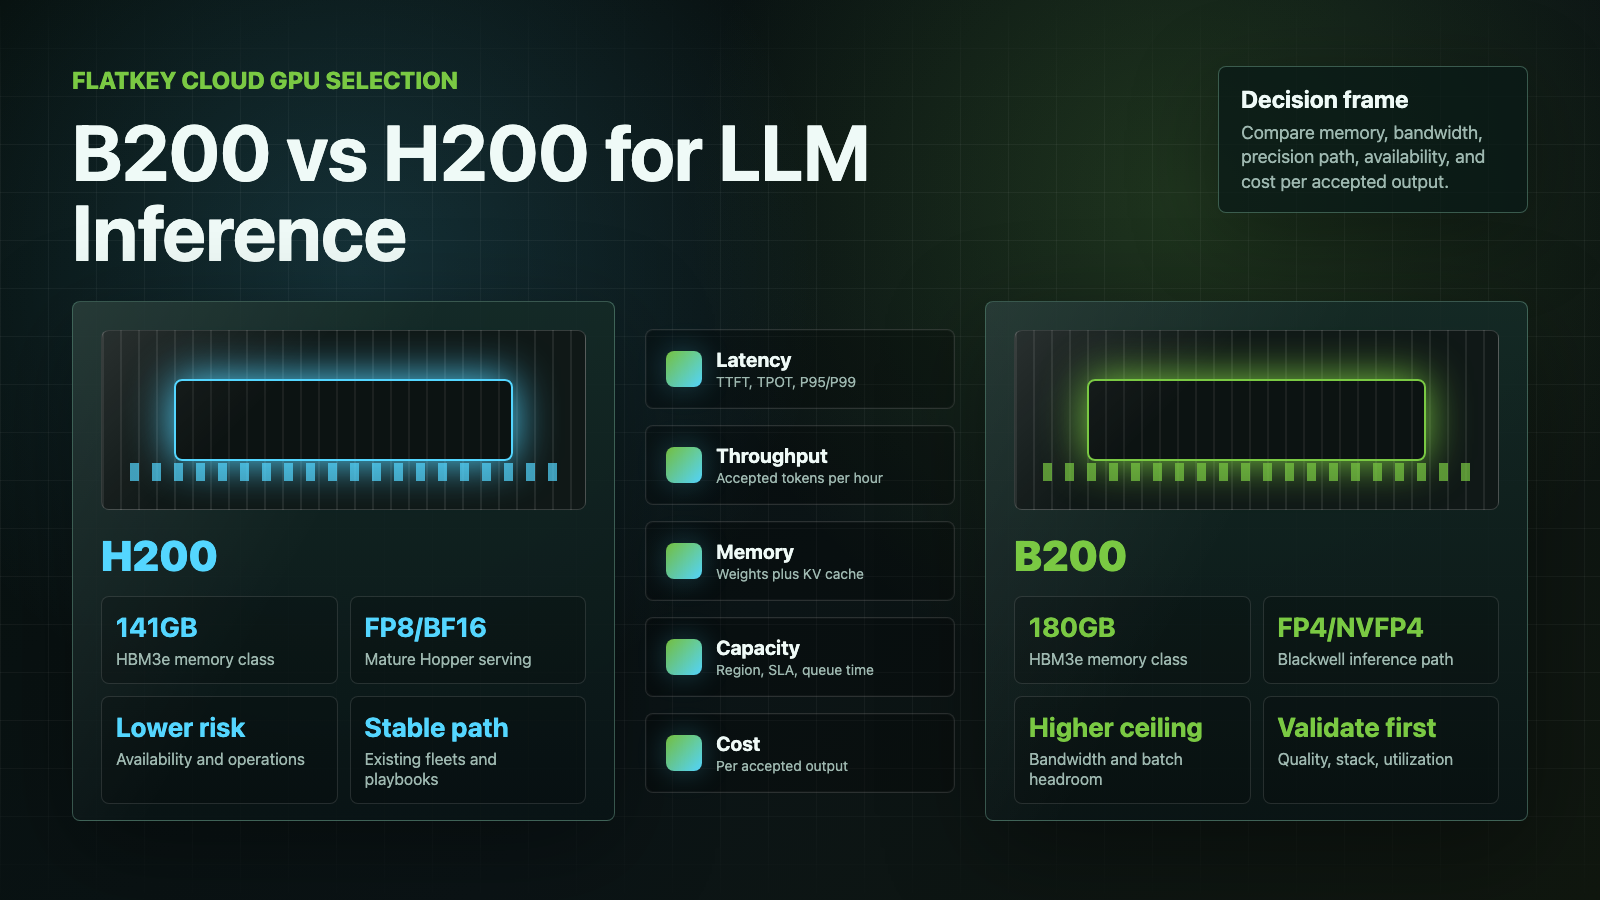
NVIDIA B200 vs. H200: Welche GPU ist besser für LLM-Inference?
Vergleiche NVIDIA B200 vs. H200 für LLM-Inference nach Speicher, Bandbreite, Präzisionsunterstützung, DGX-Systemen, Verfügbarkeit in Cloud-GPUs und Kosten pro akzeptierter Ausgabe.
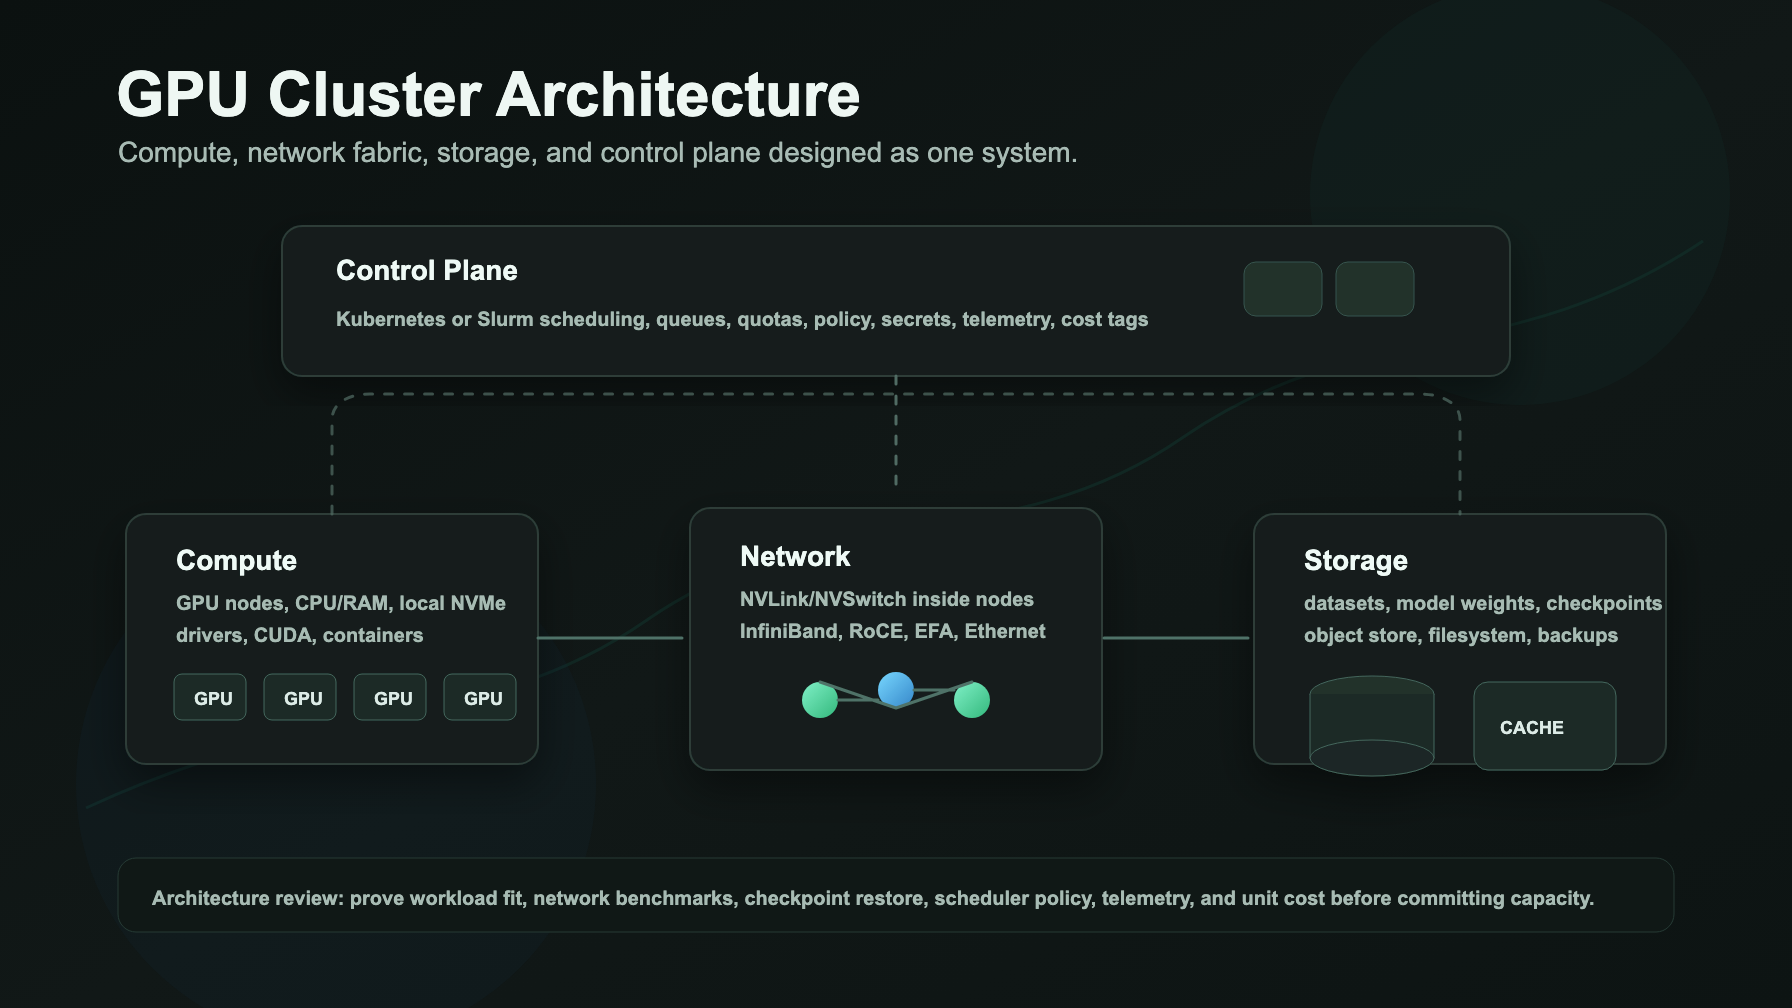
GPU-Cluster-Architektur: Compute, Netzwerk, Storage und Control Plane
Ein praxisnaher Leitfaden zur GPU-Cluster-Architektur für Compute-Knoten, Netzwerk-Fabric, Storage, Kubernetes- oder Slurm-Control-Plane, Observability und Abnahmetests.
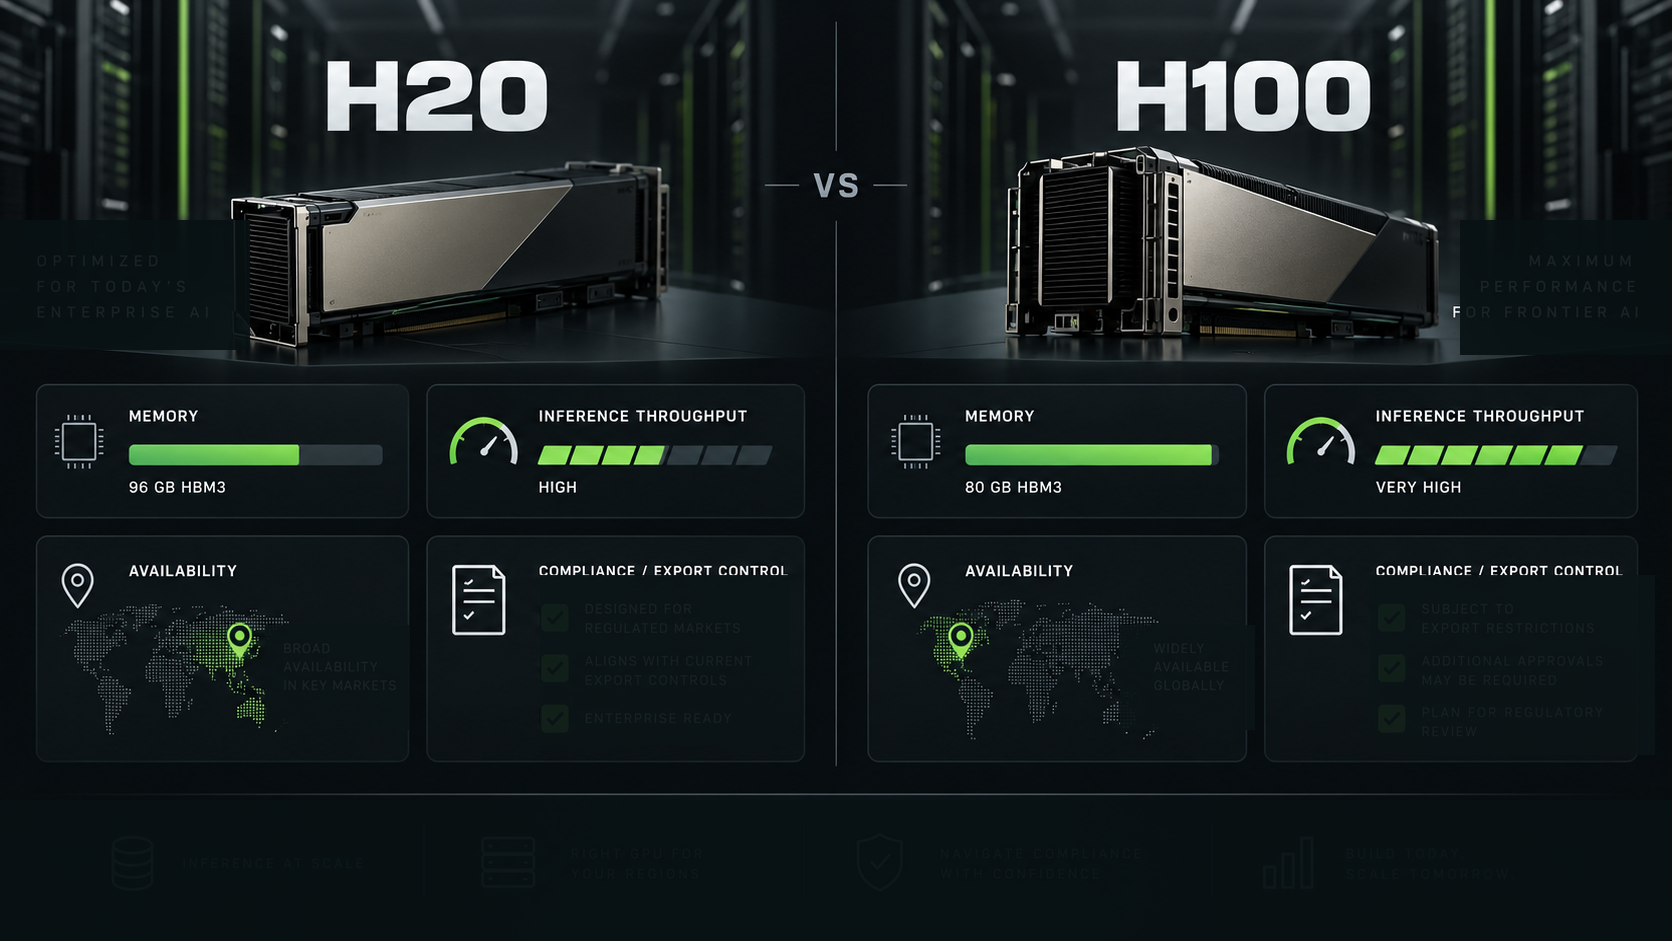
NVIDIA H20 vs H100: Inferenz, Speicher, Verfügbarkeit und Compliance
Ein praxisnaher H20-vs-H100-Vergleich für Enterprise-Teams im Bereich KI, mit Fokus auf Inferenz, Speicher, Verfügbarkeit, Exportkontrollrisiko und darauf, wann H200 oder Modell-APIs die besseren Ausgangspunkte sind.
Schneller entwickeln mit einem KI-Gateway.
Nutze flatkey.ai, um Modelle, Schlüssel, Abrechnung und Observability über eine API-Plattform zu verwalten.
Loslegen