
Blog de flatkey.ai
Ideas, notas de producto y guías de implementación para equipos que crean sobre APIs de IA.
Arquitectura de pasarelas de IA
Últimos artículos en Arquitectura de pasarelas de IA.
Leer másMigración de URL base y SDK
Últimos artículos en Migración de URL base y SDK.
Leer másCostes, facturación y operaciones
Últimos artículos en Costes, facturación y operaciones.
Leer másControles empresariales y confianza
Últimos artículos en Controles empresariales y confianza.
Leer másComparativas de pasarelas
Últimos artículos en Comparativas de pasarelas.
Leer másGuías de modelos y modalidades
Últimos artículos en Guías de modelos y modalidades.
Leer másFiabilidad y enrutamiento
Últimos artículos en Fiabilidad y enrutamiento.
Leer másIntegraciones de herramientas
Últimos artículos en Integraciones de herramientas.
Leer más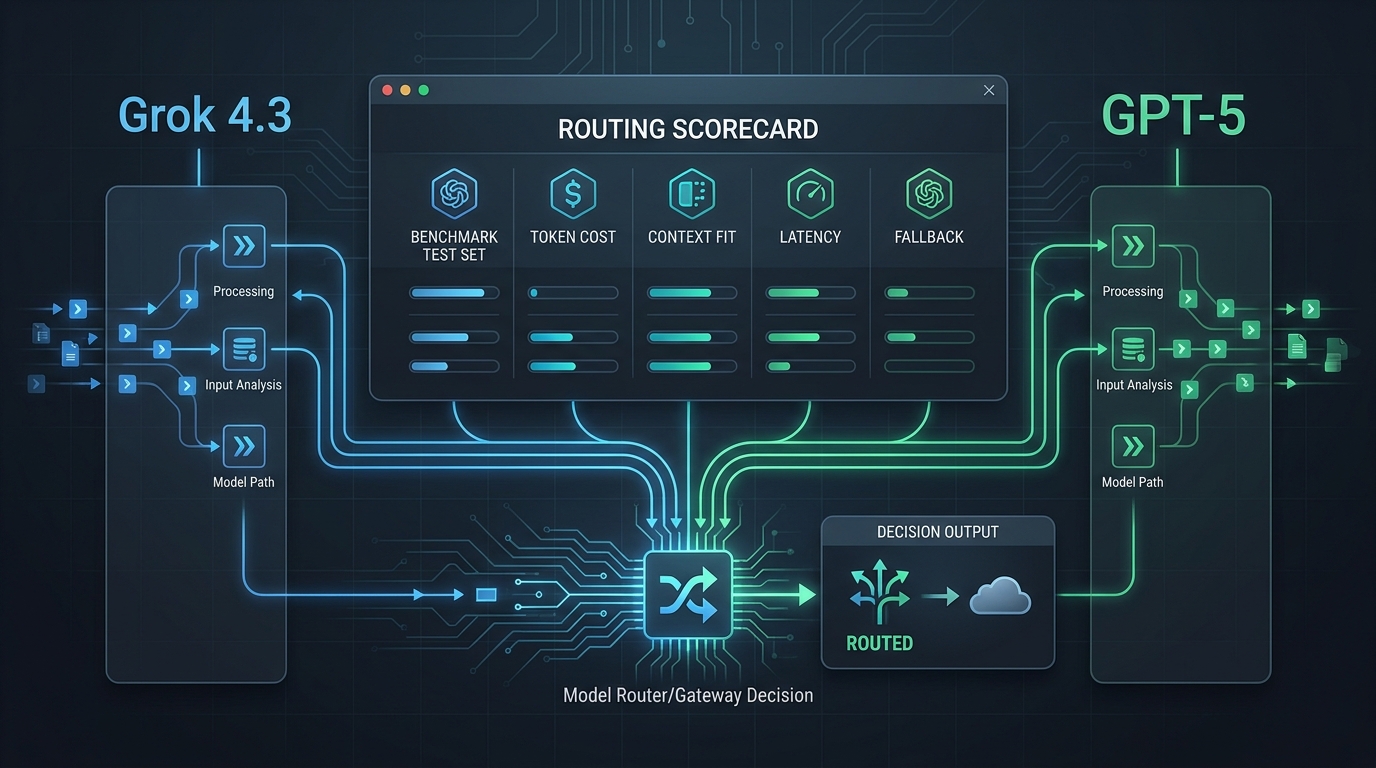
Grok 4.3 vs GPT-5: benchmarks, precios y cuándo enrutar cada uno
Una guía de enrutamiento respaldada por fuentes para equipos que comparan Grok 4.3 y GPT-5 en precios, contexto, diseño de benchmarks, plazos de migración y cuándo usar una pasarela.

Alquilar un servidor GPU: guía de arquitectura, rendimiento y despliegue en la nube
Aprende a alquilar un servidor GPU con la asignación adecuada, comprobaciones de topología, fases de despliegue y pruebas de aceptación antes de comprometer capacidad.

Rack de servidores GPU: guía de arquitectura, rendimiento y despliegue en la nube
Guía práctica para dimensionar, validar y desplegar capacidad de GPU a escala de rack para cargas de trabajo de IA.

Guía de API de supresión de PII (2026): comparativa de AWS, Google Cloud, Azure y Presidio para aplicaciones con LLM
Una API de supresión de PII detecta y enmascara datos personales en texto. Comparamos Amazon Comprehend, Google Sensitive Data Protection, Azure Language PII y Presidio, con código, unidades de facturación, resultados reales de detección y un flujo de supresión de PII para LLM.
Decodificación especulativa para la inferencia de LLM: mejoras de rendimiento y compensaciones
Guía práctica sobre la decodificación especulativa para la inferencia de LLM: cómo funciona, cuándo ayuda, en qué se diferencian EAGLE y Medusa, y qué evaluar antes del despliegue.

Inferencia vs. entrenamiento de IA: rendimiento, costes y decisiones de despliegue
Inferencia vs. entrenamiento de IA: compara métricas de rendimiento, factores de coste, requisitos de despliegue y cuándo ajustar o servir un modelo.

¿Qué es el enrutamiento de LLM? Reglas, ponderaciones y políticas basadas en costes
¿Qué es el enrutamiento de LLM? Descubre cómo las reglas, las puntuaciones ponderadas, los filtros de capacidades, las alternativas y la evaluación hacen que las API multimodelo sean más fiables.

Despliegue de vLLM Expert Parallel para DeepSeek y otros modelos MoE
Despliega vLLM expert parallel para DeepSeek y otros modelos MoE con los flags, la topología, las comprobaciones de backend y las pruebas de lanzamiento adecuados.

vLLM Docker: arquitectura, rendimiento y guía de despliegue en la nube
Guía de despliegue de vLLM Docker para GPU en la nube: arquitectura, configuración compatible con OpenAI, optimización del rendimiento, escalado multi-GPU y comprobaciones de producción.

API unificada para modelos de IA: una clave, un endpoint y una facturación
Guía práctica sobre una API unificada para consolidar el acceso a modelos, claves, endpoints, uso, facturación, enrutamiento y respaldo sin perder las opciones nativas de cada proveedor.
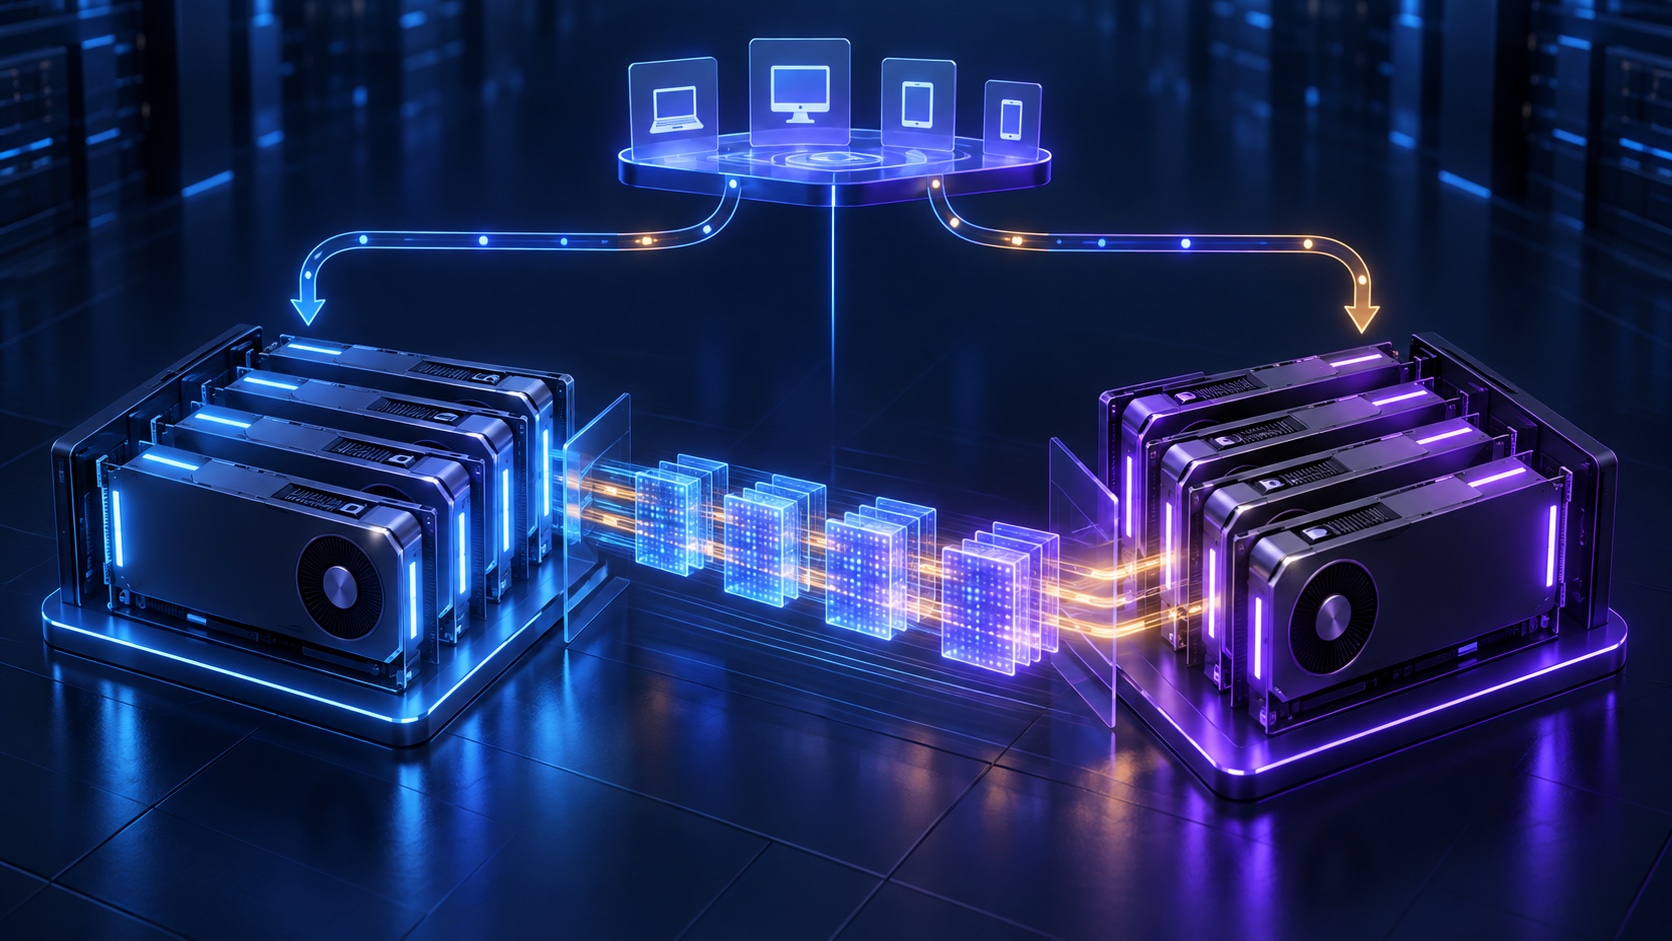
Desagregación de prefill y decode de SGLang: arquitectura y guía de implementación
Implemente la desagregación de prefill y decode de SGLang con grupos de GPU separados, transferencia de caché KV, métricas de validación, opciones de topología y comprobaciones de despliegue.

Notas de arquitectura

Coste por millón de tokens de LLM autoalojados: un modelo reproducible de costes de GPU
Un modelo reproducible para calcular el coste de servir LLM autoalojados a partir de la capacidad total de GPU, el rendimiento aceptado, la utilización y la calidad.

API de Perplexity AI: acceso, precios, integración y guía de producción
Una guía respaldada por fuentes para elegir la interfaz de API de Perplexity adecuada, integrarla correctamente, estimar costes y operarla de forma segura en producción.

URL base de la API de OpenAI (2026): endpoints directos y compatibles
La URL base oficial de la API de OpenAI, rutas de endpoint habituales, configuración compatible con Flatkey, ejemplos de código y soluciones para errores por /v1 duplicado o 404.

Costo de la API de OpenAI en 2026: tabla de precios y calculadora
Una guía actual sobre el costo de la API de OpenAI con tablas de precios de GPT-6, una calculadora copiable, ejemplos prácticos, costos ocultos y comprobaciones de optimización.

Cómo obtener una clave de API de OpenAI y solucionar un error 401 «Clave de API no válida»
Diagnostica de forma segura los errores 401 de clave de API no válida de OpenAI, incluidos endpoints incorrectos, secretos obsoletos, claves revocadas, controles de proyecto y listas de permitidos de IP.
¿La clave de la API de OpenAI es gratis? Límites, costos y consideraciones para producción
Una clave de la API de OpenAI es una credencial, no un presupuesto gratuito garantizado para producción. Conoce qué verificar sobre elegibilidad, créditos, límites, costos y controles de gasto antes del lanzamiento.
Crea más rápido con una sola pasarela de IA.
Usa flatkey.ai para gestionar modelos, claves, facturación y observabilidad desde una plataforma API.
Empezar