Explicación de los límites de tasa de LLM: RPM, TPM y reintentos es un tema de fiabilidad en producción antes de ser una configuración de SDK. Los límites de tasa deciden cuántas solicitudes, tokens, trabajos o generaciones concurrentes puede impulsar tu aplicación a través de un proveedor o gateway en una ventana de tiempo. Los reintentos deciden qué ocurre cuando se alcanza un límite. La política de reintentos incorrecta puede convertir una pequeña ráfaga en una interrupción sostenida.
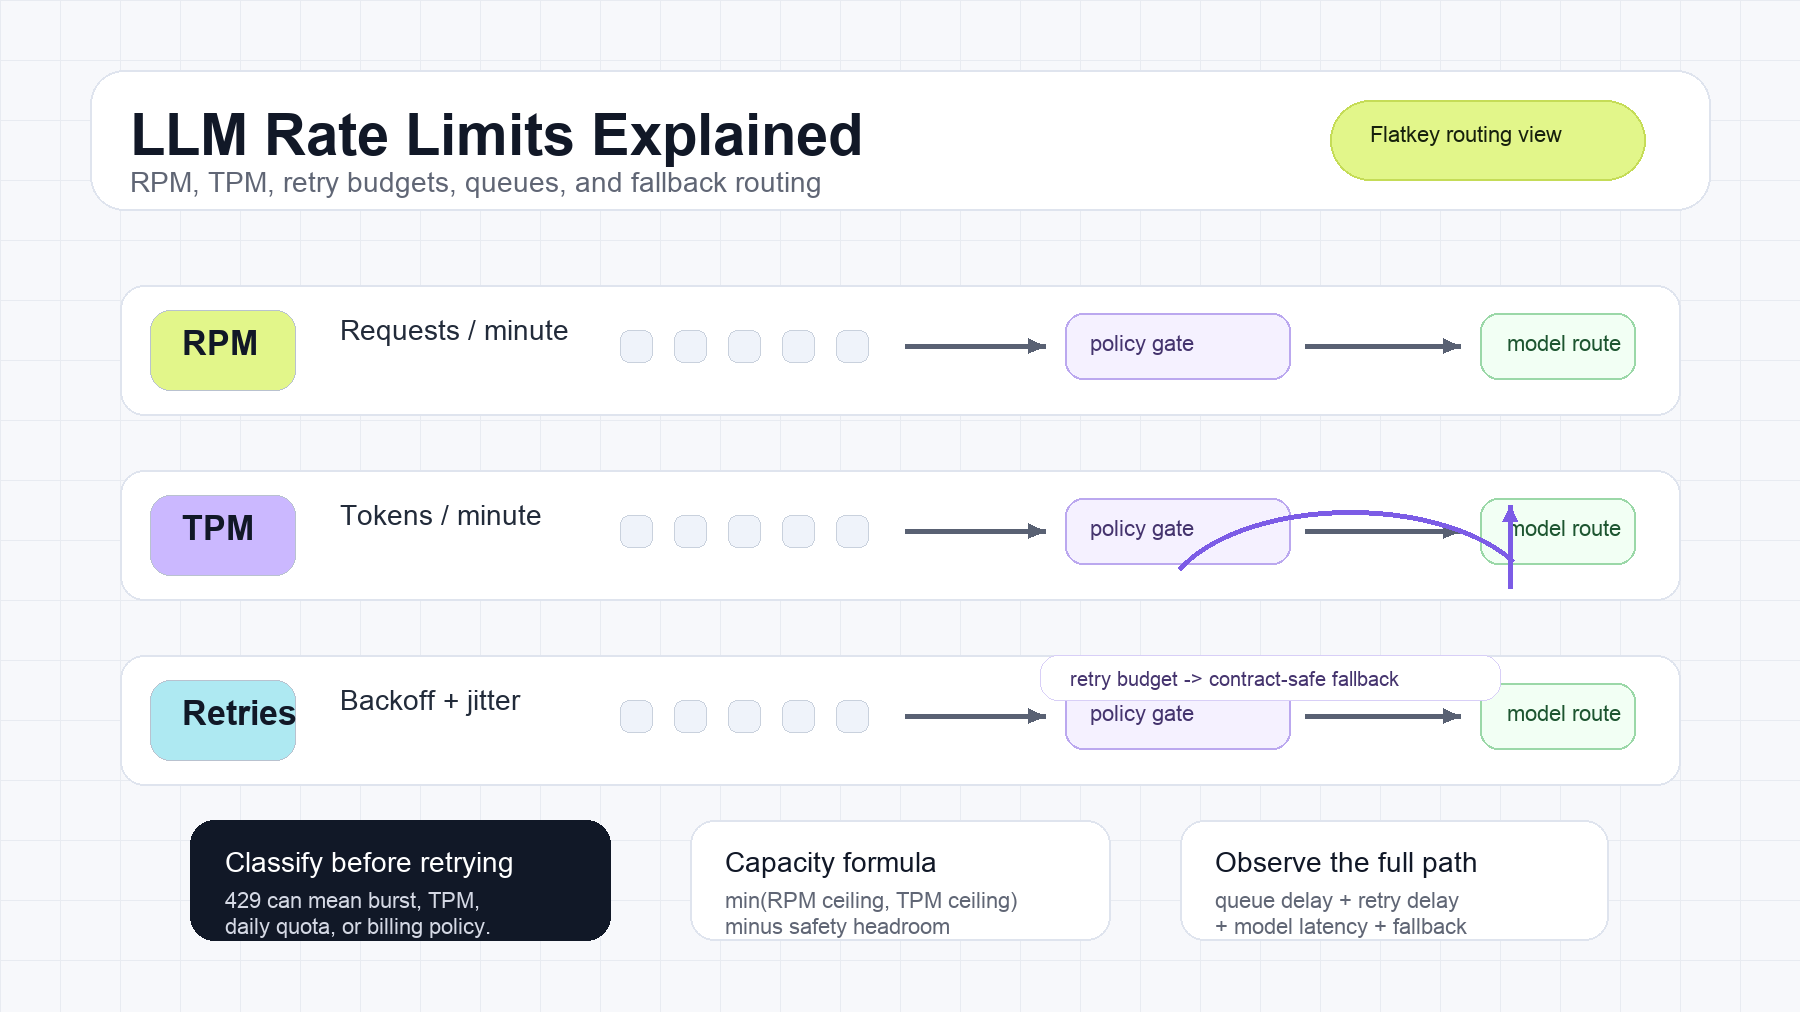
La regla práctica es simple: RPM controla la frecuencia de solicitudes, TPM controla el rendimiento de tokens, la concurrencia controla el trabajo en curso y los reintentos consumen la misma capacidad escasa a menos que estén limitados. Un sistema de producción debe clasificar primero el recurso restringido y luego elegir entre espaciar, encolar, reducir tokens, reintentar brevemente o enrutar a otro modelo compatible con el contrato.
Esta guía trata Explicación de los límites de tasa de LLM: RPM, TPM y reintentos como un manual operativo para equipos de producto y plataforma de IA. Cubre los términos, la matemática de capacidad, la política de reintentos, los campos de observabilidad y los controles de gateway al estilo Flatkey que evitan que los límites de tasa de la API de LLM se conviertan en un incidente para el cliente.
Respuesta rápida sobre la explicación de los límites de tasa de LLM: RPM, TPM y reintentos
Usa esta tabla cuando estés diagnosticando un incidente de límite de tasa de LLM.
| Señal | Qué mide | Síntoma típico | Primer control |
|---|---|---|---|
| RPM | Solicitudes admitidas por minuto o ventana definida por el proveedor | Muchas llamadas pequeñas fallan con 429 |
Espaciar solicitudes, poner en cola ráfagas, agrupar tareas pequeñas |
| TPM | Tokens de entrada y/o salida admitidos por minuto o ventana | Los prompts largos, las salidas largas o las ejecuciones de evaluación se limitan | Reservar tokens, acortar el contexto, limitar la salida |
| RPD / TPD | Solicitudes o tokens admitidos por día | El trabajo se detiene hasta que se restablece la cuota | Detener reintentos, reprogramar, solicitar un nivel superior |
| Concurrencia | Solicitudes o trabajos en curso al mismo tiempo | Las generaciones lentas se acumulan incluso con un RPM moderado | Limitar trabajadores, añadir backpressure |
| Presupuesto de reintentos | Cuánto trabajo extra puede gastar un llamador después de un fallo | Tormenta de reintentos, latencia inflada, efectos secundarios duplicados | Limitar intentos, tiempo transcurrido y estados reintentables |
| Ruta de fallback | Modelo o proveedor alternativo elegible | La ruta principal está limitada pero el producto aún necesita salida | Rutar solo cuando encajen la capacidad, la política y el coste |
Explicación de los límites de tasa de LLM: RPM, TPM y reintentos se reduce a una decisión operativa: no reintentar a ciegas. Un 429 no es una orden para enviar la misma solicitud otra vez inmediatamente. Es una señal de que algún bucket de capacidad, política de cuota, estado de facturación o mecanismo de protección del proveedor rechazó la solicitud.
Por qué existen los límites de tasa
Los proveedores aplican límites de tasa de la API de LLM para proteger la capacidad compartida, evitar cuentas descontroladas y mantener coherente la política de facturación o nivel de servicio. OpenAI, Anthropic y Gemini documentan conceptos de límites de tasa, pero exponen distintos nombres de buckets, alcances, encabezados y paneles. OpenAI documenta los límites de tasa y aconseja a los clientes manejar los errores de límite con backoff. Anthropic documenta límites de gasto a nivel de organización y espacio de trabajo, además de límites de tasa a nivel de modelo que pueden incluir solicitudes y tokens. Gemini documenta niveles con conceptos de límites de solicitudes, tokens y diarios.
Esos controles del proveedor son necesarios, pero no son una política de producto completa. Normalmente responden a la pregunta del lado del proveedor: “¿Puede este proyecto enviar más tráfico ahora mismo?” Tu aplicación todavía necesita responder preguntas del lado del producto:
- ¿Qué cliente, espacio de trabajo, equipo o función causó la ráfaga?
- ¿El recurso restringido eran solicitudes, tokens de entrada, tokens de salida, concurrencia, cuota diaria o gasto?
- ¿Debería esta carga esperar, degradarse, reducirse o fallar rápidamente?
- ¿Está permitida una ruta de fallback por capacidad, política de datos, precio y contrato del cliente?
- ¿Los reintentos están empeorando el límite?
Para controles de cuota adyacentes, combina este artículo con gestión de cuota de la API de IA y gestión del gasto de la API de IA.
RPM, TPM y concurrencia son límites diferentes
Los equipos a menudo tratan los límites de tasa como un solo número. Eso oculta el verdadero cuello de botella.
RPM: solicitudes por minuto
RPM limita el número de solicitudes admitidas durante una ventana de tiempo definida por el proveedor. Los prompts pequeños, las comprobaciones de salud, los bucles de herramientas de agentes y los trabajos de evaluación de alta dispersión suelen presionar primero el RPM. Una carga de trabajo puede estar muy por debajo del TPM y aun así alcanzar el RPM si envía demasiadas llamadas pequeñas.
TPM: tokens por minuto
TPM limita el rendimiento de tokens. Según el proveedor y el modelo, el límite puede considerar tokens de entrada, tokens de salida, tokens almacenados en caché o buckets separados de entrada y salida. La recuperación de contexto largo, el historial de conversación, las salidas extensas, la generación de múltiples candidatos y las evaluaciones en paralelo suelen presionar el TPM antes que el RPM.
Concurrencia: trabajo en curso
La concurrencia no es RPM. Un sistema puede enviar solo 60 solicitudes por minuto y aun así tener alta concurrencia si cada generación tarda 20 segundos. El streaming y las llamadas a herramientas de larga duración hacen esto visible. Limitar los grupos de trabajadores y la profundidad de cola suele ser un mejor control que más reintentos.
Límites diarios y límites de gasto
Algunos límites no se recuperan después de una breve pausa. Los límites diarios de solicitudes, los límites diarios de tokens, los límites mensuales de gasto y las restricciones de facturación normalmente deberían detener los reintentos. La acción correcta es reprogramar, subir de nivel, ajustar el presupuesto o indicar al usuario que la capacidad se ha agotado.
Por qué puede recibir un 429 por debajo del límite anunciado
Un límite publicado como “1,000 RPM” rara vez significa que un cliente pueda enviar 1,000 solicitudes en el primer segundo de un minuto. Los proveedores pueden aplicar ventanas deslizantes, cubos de tokens, grupos de modelos, reglas de ráfaga específicas por nivel, límites de aceleración o cuotas compartidas del proyecto.
Una solicitud puede recibir 429 Too Many Requests incluso cuando un contador local parece seguro porque:
- Varios workers, usuarios, servicios o entornos comparten el mismo límite de cuenta.
- Los tokens de entrada y salida se cuentan en cubos diferentes.
- Un modelo tiene un grupo más reducido que otro modelo.
- Los reintentos de fallos anteriores todavía están consumiendo capacidad de solicitudes.
- La aceleración del tráfico es demasiado brusca para los controles de aceleración.
- Hay activa una regla diaria, de gasto, de espacio de trabajo o de nivel de servicio.
- El proveedor devuelve un
429genérico para varias políticas de capacidad.
Por eso Explicación de los límites de tasa de LLM: RPM, TPM y reintentos debe empezar por la clasificación, no por el código. Registre el código de estado, el tipo de error del proveedor, los encabezados de respuesta, el modelo, la cuenta o el proyecto, la estimación de tokens, los tokens reales, el número de intento, el retraso en cola y el ID de solicitud del proveedor cuando esté disponible.
Fórmula de planificación de capacidad
Comience con topes independientes para solicitudes y tokens, y luego opere por debajo del máximo.
request_ceiling = RPM * safety_factor

token_ceiling = (TPM * safety_factor) / average_total_tokens_per_request

safe_requests_per_minute = min(request_ceiling, token_ceiling)
Use un factor de seguridad como 0.70 a 0.90 según la variación de tokens, los consumidores compartidos, el comportamiento de reintentos y lo costoso que sea no cumplir los objetivos de latencia.
Ejemplo:
RPM = 1,000
TPM = 2,000,000
average_total_tokens_per_request = 4,000
safety_factor = 0.80

request_ceiling = 1,000 * 0.80 = 800 requests/minute

token_ceiling = (2,000,000 * 0.80) / 4,000 = 400 requests/minute

safe_requests_per_minute = min(800, 400) = 400 requests/minute
En este ejemplo, TPM es la restricción vinculante. Añadir más workers no incrementará el rendimiento sostenible. Generará más cola, más reintentos o más errores 429.
Para sistemas en línea, traduzca la tasa segura de solicitudes a un punto de partida de concurrencia:
target_concurrency ~= requests_per_second * average_request_seconds
Si la tasa segura es de 400 solicitudes por minuto, eso equivale a unas 6.67 solicitudes por segundo. Si la latencia media del modelo es de 3 segundos, una concurrencia inicial es de unas 20. Ajuste contra la latencia p95 y p99, no solo contra los promedios.
Reserva de tokens para la seguridad de TPM
Los incidentes de TPM a menudo provienen de una planificación optimista. La aplicación admite trabajo basándose en tokens esperados, pero el modelo produce una salida más larga de lo previsto.
Un programador más seguro reserva tokens antes de enviar la solicitud:
reservation:
  workload: support_answer
  model_route: primary_chat_route
  request_id: req_8f3a
  estimated_input_tokens: 3200
  max_output_tokens: 900
  reserved_total_tokens: 4100
  reservation_expires_at: 2026-10-10T11:03:00Z
Después de la respuesta, concilie los tokens reservados con los tokens reales:
actual_usage:
  input_tokens: 3014
  output_tokens: 622
  total_tokens: 3636
  retry_attempts: 0
  accepted_result: true
Reserve con estimaciones p95 o específicas de la carga de trabajo para producción. Use el consumo real para la atribución de costes y la previsión. Esa separación facilita la operación de los límites de tasa de la API de LLM: el control de admisión usa una estimación segura, mientras que finanzas y producto revisan el coste real por resultado aceptado.
Un árbol de decisión de límites de tasa
Cuando una solicitud se rechaza o una cola crece, decida el control según la causa.
Did the provider return Retry-After or a reset header?
  yes -> wait for the hint if it fits the caller latency budget
  no  -> use bounded exponential backoff with jitter for transient classes

Is the cause daily quota, billing, permission, or hard spend limit?
  yes -> do not retry; fail, reschedule, or request capacity
  no  -> continue

Is RPM the binding constraint?
  yes -> pace requests, batch small work, or queue low priority traffic
  no  -> continue

Is TPM the binding constraint?
  yes -> shorten context, cap output, reserve tokens, or delay long jobs
  no  -> continue

Is concurrency the binding constraint?
  yes -> reduce workers, set queue deadlines, and apply backpressure
  no  -> continue

Is an eligible fallback route healthy and policy-approved?
  yes -> route after the retry budget is spent
  no  -> return a controlled failure
Este árbol de decisión es el activo de valor para Explicación de los límites de tasa de LLM: RPM, TPM y reintentos. Evita que el manejo de 429 se convierta en un bucle ilimitado, y convierte Explicación de los límites de tasa de LLM: RPM, TPM y reintentos de un tema de definiciones en un flujo de trabajo de respuesta a incidentes.
Cómo usar Retry-After
HTTP Retry-After indica al cliente cuánto tiempo esperar antes de hacer otra solicitud. La RFC lo define como un retraso en segundos o una fecha HTTP. La referencia de MDN para 429 Too Many Requests también describe el uso de Retry-After para indicar cuándo el cliente puede reintentar.
Reglas prácticas:
- Respete un
Retry-Afterválido cuando encaje con el presupuesto de latencia del llamador. - Limite los valores muy largos para llamadas interactivas; no mantenga abierta indefinidamente una solicitud de usuario.
- Trate los valores inválidos o ausentes como una razón para usar retroceso exponencial del lado del cliente.
- No reintente causas no reintentables solo porque
Retry-Afteresté ausente. - Registre la sugerencia del proveedor y el retraso real utilizado.
Para flujos interactivos de usuario, el presupuesto de reintento suele ser menor que la sugerencia del proveedor. En ese caso, falle rápido con mensajes útiles o enrute la solicitud a otro lugar. Para trabajos por lotes, la puesta en cola puede ser mejor que devolver un error.
Retroceso exponencial con jitter
El retroceso exponencial aumenta el retraso después de cada intento fallido. El jitter aleatoriza ese retraso para que los workers no se sincronicen y reintenten al mismo tiempo. La guía de AWS sobre backoff y jitter es útil porque explica por qué un retroceso exponencial simple con límite aún puede agrupar reintentos sin aleatoriedad.
Una fórmula común de jitter completo:
delay_ms = random(0, min(cap_ms, base_ms * 2^attempt))
Una política de reintento de producción necesita más que la fórmula del retraso:
| Campo de política | Control recomendado |
|---|---|
| Estados reintentables | 429, algunos 5xx y fallos transitorios de red |
| Estados no reintentables | errores de validación, de autenticación, de permisos, de facturación, agotamiento de cuota diaria |
| Máximo de intentos | Poco número para llamadas interactivas; mayor solo para trabajos sin conexión |
| Tiempo máximo transcurrido | Limitado por el presupuesto de latencia visible para el usuario o por el plazo del trabajo |
| Jitter | Requerido para sistemas con varios workers |
| Retry-After | Úselo cuando sea válido y asumible |
| Cancelación | Deténgase inmediatamente cuando el llamador cancele |
| Observabilidad | Conteo de intentos, tiempo de espera, estado final, ID de solicitud, demora en cola |
Las solicitudes fallidas aún pueden consumir capacidad del límite de tasa. Por eso los reintentos deben formar parte de la planificación del límite de tasa, no ser una idea tardía.
Ayudante de reintento en TypeScript para APIs compatibles con OpenAI
Este ayudante usa Retry-After cuando está presente; de lo contrario, usa jitter completo. Se detiene cuando se agotan los intentos o el tiempo transcurrido.
type ChatRequest = {
  model: string;
  messages: Array<{ role: "system" | "user" | "assistant"; content: string }>;
  max_tokens?: number;
};

const sleep = (milliseconds: number) =>
  new Promise((resolve) => setTimeout(resolve, milliseconds));

function retryAfterMilliseconds(response: Response): number | null {
  const value = response.headers.get("retry-after");
  if (!value) return null;

  const seconds = Number(value);
  if (Number.isFinite(seconds)) return Math.max(0, seconds * 1_000);

  const date = Date.parse(value);
  return Number.isNaN(date) ? null : Math.max(0, date - Date.now());
}

export async function createChatCompletion(
  apiKey: string,
  request: ChatRequest,
  options: { maxAttempts?: number; maxElapsedMs?: number } = {},
) {
  const maxAttempts = options.maxAttempts ?? 4;
  const maxElapsedMs = options.maxElapsedMs ?? 30_000;
  const startedAt = Date.now();

  for (let attempt = 0; attempt < maxAttempts; attempt += 1) {
    const response = await fetch("https://router.flatkey.ai/v1/chat/completions", {
      method: "POST",
      headers: {
        Authorization: `Bearer ${apiKey}`,
        "Content-Type": "application/json",
      },
      body: JSON.stringify(request),
    });

    if (response.ok) return response.json();

    const retryable = response.status === 429 || response.status >= 500;
    const finalAttempt = attempt === maxAttempts - 1;
    if (!retryable || finalAttempt) {
      throw new Error(`La solicitud de LLM falló con ${response.status}: ${await response.text()}`);
    }

    const serverDelay = retryAfterMilliseconds(response);
    const exponentialCap = Math.min(8_000, 500 * 2 ** attempt);
    const jitteredDelay = Math.random() * exponentialCap;
    const delayMs = serverDelay ?? jitteredDelay;

    if (Date.now() + delayMs - startedAt >= maxElapsedMs) {
      throw new Error("Presupuesto de reintento de LLM agotado");
    }

    await sleep(delayMs);
  }

  throw new Error("Estado de reintento inalcanzable");
}
Añada tiempos de espera de solicitud, clases de error estructuradas, telemetría y cancelación antes de usarlo en producción. Si la llamada puede crear efectos secundarios externos, haga que la operación de negocio sea idempotente antes de reintentar.
¿Reintentar, poner en cola, reducir o enrutar?
Un sistema resiliente tiene más de una respuesta al estrangulamiento.
| Situación | Reintentar | Cola | Reducir tokens | Derivar a otro lugar |
|---|---|---|---|---|
Un único 429 transitorio corto |
Sí, con límite | Opcional | No | Normalmente no |
| Agotamiento sostenido de RPM | Muy limitado | Sí | Normalmente no | A veces |
| Agotamiento sostenido de TPM | Muy limitado | Sí | Sí | A veces |
| Cuota diaria agotada | No | Solo si es aceptable un restablecimiento posterior | No | Quizá |
| Error de facturación o permisos | No | No | No | No, primero corrige el acceso |
| Sobrecarga del proveedor con fallback saludable | Brevemente | Opcional | No | Sí, tras la comprobación de políticas |
| Stream parcial ya entregado | Normalmente no se vuelve a reproducir | Quizá continuar o reiniciar explícitamente | Quizá | Solo con semántica clara |
La puesta en cola protege al proveedor y la experiencia del usuario cuando el trabajo puede esperar. La reducción de tokens protege el TPM. El enrutamiento protege la disponibilidad solo cuando la ruta alternativa cumple el mismo contrato de producto.
Para patrones específicos de sobrecarga, usa el manual de API Error 529 overloaded. Para las implicaciones de coste, conecta el comportamiento de reintentos y fallback con AI gateway pricing y how to compare AI model prices.
Límites de tasa en evaluaciones de modelos
Los límites de tasa pueden invalidar una comparación de modelos.
Si el modelo A se prueba con 10 workers y el modelo B con 100 workers, el modelo B puede parecer más lento porque el harness provocó puesta en cola y reintentos. Esa medición dice más sobre la configuración de la prueba que sobre la latencia del modelo.
Para evaluaciones defendibles:
- Separa la latencia del modelo, el retraso de la cola y el retraso del reintento.
- Usa el mismo proceso de llegada o el mismo nivel de utilización normalizado para cada ruta.
- Calienta el tráfico gradualmente cuando los proveedores usan controles de aceleración.
- Registra tokens e intentos por tarea completada.
- Informa por separado la tasa de éxito en el primer intento y la tasa de éxito eventual.
- Compara el coste por tarea aceptada, no solo el precio por token.
- Ejecuta las pruebas de sobrecarga por separado de las pruebas de calidad.
Esto es especialmente importante para cuentas gratuitas o de nivel bajo. El artículo sobre free LLM APIs es un contexto útil porque los límites gratuitos suelen estar diseñados para exploración, no para carga de producción.
Métricas sobre las que alertar
Haz seguimiento de esto por proveedor, modelo, ruta, tenant, carga de trabajo y entorno:
- Solicitudes por minuto.
- Tokens de entrada por minuto y tokens de salida por minuto.
- Tokens estimados reservados frente a tokens reales usados.
- Profundidad de la cola y antigüedad del elemento más antiguo en cola.
- Tiempo de espera para capacidad de tasa.
- Tasa de éxito en el primer intento.
- Intentos de reintento por solicitud exitosa.
- Tasa de
429por causa clasificada. - Amplificación de reintentos: intentos totales divididos por resultados exitosos.
- Tasa de fallback y resultado del fallback.
- Latencia de extremo a extremo p50, p95 y p99.
- Coste por tarea exitosa o aceptada.
Las convenciones semánticas de IA generativa de OpenTelemetry pueden ayudar a estandarizar la telemetría de modelo, operación, tokens, respuestas y errores. Mantén también las dimensiones específicas del producto: cliente, workspace, clase de tráfico, entorno, función y responsable.
Una alerta solo sobre el recuento total de 429 es ruidosa. Una mejor señal combina la tasa de limitación, la antigüedad de la cola, la amplificación de reintentos y la tasa final de fallos.
Una arquitectura de límites de tasa para producción
Un recorrido de solicitud robusto suele tener siete capas de control:
client
  -> admission control
  -> priority queue
  -> token reservation
  -> RPM + TPM limiter
  -> provider/model route
  -> bounded retry controller
  -> contract-safe fallback
  -> usage, cost, and latency ledger
Usa el control de admisión cuando la cola no pueda cumplir la fecha límite del llamador. Usa colas de prioridad para que las evaluaciones no críticas no desplacen el tráfico de producción. Usa la reserva de tokens para mantener honesto el TPM. Usa un controlador de reintentos centralizado para que las capas de SDK, cola, gateway y worker no reintenten todas de forma independiente.
El libro mayor de uso debe registrar:
rate_limit_event:
  request_id: req_8f3a
  workspace_id: ws_42
  environment: production
  workflow: support_answer
  route_requested: primary_chat_route
  route_final: fallback_chat_route
  estimated_input_tokens: 3200
  max_output_tokens: 900
  actual_input_tokens: 3014
  actual_output_tokens: 622
  attempt_count: 2
  retry_delay_ms: 740
  queue_delay_ms: 1180
  final_status: success
  classified_limit: transient_rpm_burst
  accepted_result: true
Esto hace que los límites de tasa de la API de LLM puedan revisarse después del incidente. También da a los equipos de finanzas y producto la evidencia que necesitan cuando los reintentos o fallbacks cambian el coste por resultado aceptado.
Cómo encaja Flatkey
Flatkey proporciona a los equipos una clave API y una URL base compatible con OpenAI para las rutas de modelo admitidas. Eso no elimina los límites de tasa de LLM upstream. Proporciona a los equipos una única superficie de integración donde el enrutamiento, la revisión de uso y la política pueden hacerse consistentes entre proveedores.
Para el flujo Explicación de los límites de tasa de LLM: RPM, TPM y reintentos, una capa de gateway ayuda cuando:
- Tu aplicación necesita una única política de reintentos, cola y respaldo en lugar de lógica por proveedor dispersa entre servicios.
- Los equipos de producto necesitan comparar la salud de las rutas, la latencia, los tokens y el coste del resultado aceptado en un solo libro mayor.
- Los equipos de plataforma necesitan listas de अनुमति de modelos, presupuestos por subclave y controles de uso por entorno o flujo de trabajo.
- Finanzas necesita un único saldo, una factura y evidencia a nivel de solicitud en lugar de paneles de proveedor desconectados.
- Los operadores necesitan mover el tráfico elegible cuando una ruta está restringida, sin reescribir el SDK de la aplicación.
El gateway aún debe preservar los contratos específicos del modelo. No enrutes de un modelo a otro a menos que la ventana de contexto, el comportamiento de las herramientas, la salida estructurada, la política de seguridad, los controles de datos, la latencia y el coste sean aceptables para esa carga de trabajo. Consulta la disponibilidad actual de las rutas y los precios en el directorio de modelos de Flatkey y en precios de Flatkey antes del lanzamiento en producción.
Errores comunes
Tratar RPM como concurrencia
RPM mide las admisiones a lo largo del tiempo. La concurrencia mide el trabajo en curso. Las generaciones lentas pueden crear una alta concurrencia con un RPM moderado.
Reintentar inmediatamente cada 429
Los reintentos inmediatos sincronizan a los trabajadores y consumen más capacidad. Respeta Retry-After cuando sea válido, añade jitter y limita el presupuesto de reintentos.
Usar un solo limitador para todos los modelos
Los proveedores pueden usar pools de modelos separados o pools compartidos por cuenta. El limitador debe seguir el ámbito de cuota documentado y los encabezados de respuesta observados.
Ignorar consumidores compartidos
Un panel, un ejecutor de evaluaciones, un agente de codificación y una API de producción pueden compartir un proyecto. Reserva capacidad por carga de trabajo y aísla el tráfico crítico cuando sea posible.
Reintentar flujos parciales
Una vez que los tokens han llegado al usuario o se ha ejecutado una acción de herramienta, una repetición silenciosa puede duplicar la salida o los efectos secundarios. Define explícitamente la semántica de continuación, reinicio o idempotencia.
Medir solo la latencia del proveedor
La latencia para el usuario final incluye el retraso de cola, el retraso del reintento, el retraso del respaldo y la latencia del modelo. Alerta sobre toda la ruta y mantén separados los componentes.
Preguntas frecuentes
¿Cuál es la diferencia entre RPM y TPM?
RPM limita cuántas solicitudes se admiten a lo largo del tiempo. TPM limita cuántos tokens de entrada y/o salida se admiten. Los prompts pequeños suelen agotar primero el RPM; las cargas de trabajo con mucho contexto o mucha salida suelen agotar primero el TPM.
¿Por qué recibo errores 429 por debajo de mi límite de RPM?
El proveedor puede aplicar ventanas deslizantes, buckets de tokens, cuotas compartidas por cuenta, límites de tokens separados, pools específicos por modelo, límites diarios o controles de aceleración. Tu contador local de solicitudes puede no representar todo el ámbito de la cuota.
¿Debo reintentar cada 429?
No. Reintenta con un presupuesto pequeño y jitter el estrangulamiento de corta duración. No reintentes repetidamente el agotamiento de cuota diaria, las restricciones de facturación, los errores de permisos, los errores de validación o la sobrecarga sostenida que no tenga una ventana realista de recuperación.
¿El backoff exponencial garantiza el éxito?
No. El backoff reduce las colisiones y da tiempo a que se recupere la capacidad transitoria. No puede crear cuota. El agotamiento persistente requiere menor demanda, más capacidad, trabajo diferido o otra ruta elegible.
¿Los reintentos cuentan contra los límites de tasa?
Pueden contar. Los proveedores pueden contabilizar las solicitudes o intentos fallidos dentro de los límites activos, por lo que la amplificación de reintentos debe supervisarse y limitarse.
¿Cuántos reintentos debería usar una solicitud de LLM?
No existe un número universal. Define los intentos a partir del presupuesto de latencia visible para el usuario y del modo de fallo. Las aplicaciones interactivas normalmente solo necesitan unos pocos intentos breves antes de fallar o enrutar; los trabajos offline pueden tolerar colas más largas.
Lista de verificación final
Usa esta lista de verificación al implementar Explicación de los límites de tasa de LLM: RPM, TPM y reintentos en producción:
- Modela por separado RPM, TPM, límites diarios, límites de gasto y concurrencia.
- Calcula la capacidad a partir del mínimo entre los techos de solicitudes y de tokens.
- Opera por debajo del máximo publicado con un factor de seguridad.
- Reserva tokens antes de enviar solicitudes de alta variabilidad.
- Usa colas y ritmo para la carga sostenida.
- Respeta
Retry-Aftercuando sea válido y asumible. - Usa backoff exponencial con jitter cuando no exista una pista válida del servidor.
- Limita los intentos y el tiempo total de reintento.
- Detén los reintentos por errores de cuota, facturación, permisos y validación.
- Evita repetir flujos parciales o efectos secundarios no idempotentes.
- Enruta solo a modelos que preserven el contrato de producto requerido.
- Separa el retraso de cola y el retraso de reintento de la latencia del modelo en las evaluaciones.
- Activa alertas por amplificación de reintentos y antigüedad de la cola, no solo por el recuento bruto de
429. - Registra IDs de solicitud, estimaciones de tokens, tokens reales, intentos, ruta de respaldo y resultado final en el libro mayor de uso.
Los límites de tasa son controles de planificación de capacidad antes que mensajes de error. La conclusión perdurable de Explicación de los límites de tasa de LLM: RPM, TPM y reintentos es medir de forma independiente la frecuencia de solicitudes, el rendimiento de tokens, la concurrencia, los reintentos y los resultados de respaldo para que 429 se convierta en una señal accionable en lugar de ruido en producción.
Fuentes
- Documentación sobre límites de tasa de OpenAI: https://platform.openai.com/docs/guides/rate-limits
- OpenAI Cookbook, manejo de límites de tasa: https://cookbook.openai.com/examples/how_to_handle_rate_limits
- Límites de tasa de Anthropic: https://docs.anthropic.com/en/api/rate-limits
- Límites de tasa de la API de Gemini: https://ai.google.dev/gemini-api/docs/rate-limits
- RFC 9110 Retry-After: https://www.rfc-editor.org/rfc/rfc9110.html#name-retry-after
- MDN 429 Too Many Requests: https://developer.mozilla.org/en-US/docs/Web/HTTP/Reference/Status/429
- Blog de arquitectura de AWS, backoff exponencial y jitter: https://aws.amazon.com/blogs/architecture/exponential-backoff-and-jitter/
- Convenciones semánticas de IA generativa de OpenTelemetry: https://opentelemetry.io/docs/specs/semconv/gen-ai/
- Precios de Flatkey: https://flatkey.ai/pricing
- Directorio de modelos de Flatkey: https://flatkey.ai/models