¿Qué es un LLM gateway? Cómo funciona, funciones clave y 7 opciones comparadas (2026)
Un LLM gateway es una capa de API única entre tu aplicación y uno o varios proveedores de modelos. Se encarga de la autenticación, el enrutamiento, el fallback, los límites de uso, el seguimiento de costes y los logs, de modo que tu código llama a un solo endpoint en lugar de integrarse con cada proveedor por separado. La mayoría de los gateways exponen una API compatible con OpenAI. Pasar de GPT a Claude, Gemini o Qwen consiste entonces en cambiar un string model, no en desplegar una nueva integración de SDK.
Esta guía explica paso a paso cómo funciona un LLM gateway, las nueve funciones que importan, en qué se diferencia de un API gateway, un router de modelos y un MCP gateway, cuándo lo necesitas y cuándo no, y cómo se comparan siete gateways populares. Los datos de producto se contrastaron con la documentación oficial de cada proveedor el 20 de octubre de 2026.
Definición de LLM gateway
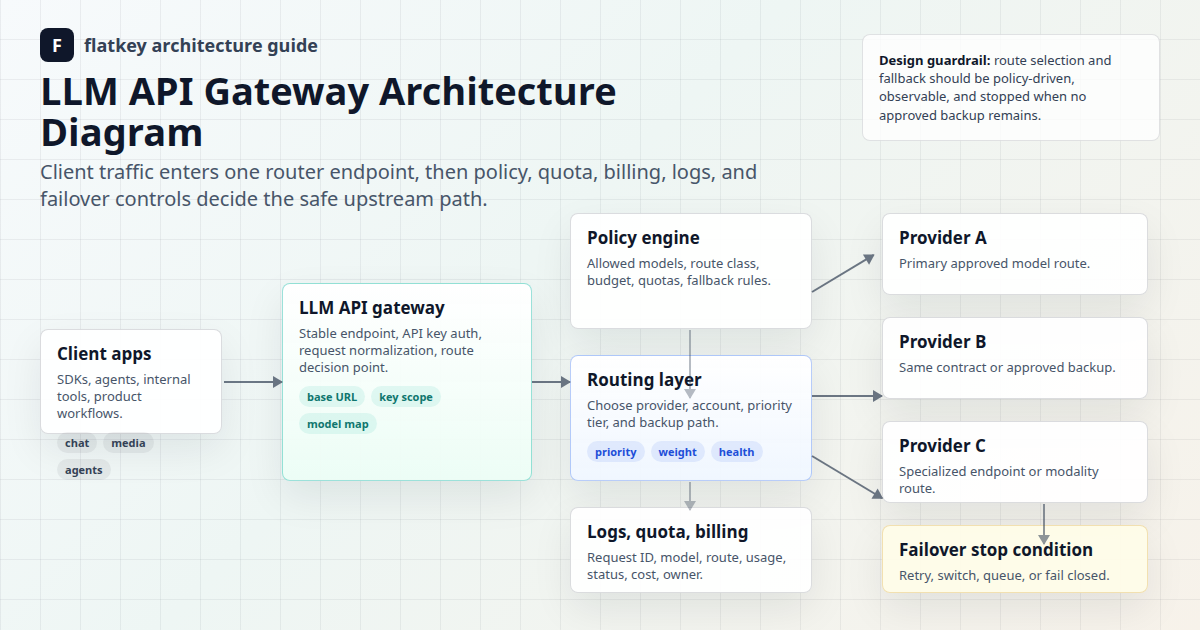
Un LLM gateway (también llamado AI gateway o LLM API gateway) recibe solicitudes de modelos desde las aplicaciones, aplica controles comunes, reenvía cada solicitud al endpoint de modelo adecuado y devuelve la respuesta en un formato homogéneo.
Your apps ──► LLM gateway ──┬──► OpenAI
                            ├──► Anthropic
  one key                   ├──► Google
  one API shape             ├──► Alibaba (Qwen)
  one usage ledger          └──► fallback provider
El gateway no aloja los modelos. Controla el acceso a ellos.
Por qué los equipos adoptan un LLM gateway
Sin gateway, cada servicio guarda sus propias keys de proveedor, implementa sus propios reintentos y registra el uso en su propio formato. Los problemas crecen con cada proveedor nuevo:
| Sin gateway | Con gateway |
|---|---|
| Una key por proveedor y por servicio | Una key de gateway por servicio, rotada de forma centralizada (guía de rotación de keys) |
| SDKs y formatos de error distintos | Un único formato de API, normalmente compatible con OpenAI |
| Una caída obliga a cambiar código | El fallback es configuración |
| Gasto repartido entre facturas | Un único registro por equipo, key y modelo |
| Sin límites compartidos | Cuotas y presupuestos por key |
Además, los precios de los proveedores varían lo suficiente como para que el enrutamiento aporte valor. El 20 de octubre de 2026, los precios de lista de salida en las páginas de modelos de Flatkey iban de 0,47 $ por millón de tokens (qwen3.8-flash) a 10,00 $ (gpt-6-sol, claude-sonnet-5-5) y 15,00 $ (kimi-k3). Un gateway te permite aprovechar esa diferencia sin reescribir código.
Cómo funciona un LLM gateway, paso a paso
- La app envía una solicitud a la base URL del gateway con una key de gateway.
- Autenticación: el gateway valida la key y carga su política (modelos permitidos, presupuesto, límite de uso).
- Política previa: comprueba cuotas y puede censurar o bloquear contenido y añadir metadatos como equipo, entorno o funcionalidad.
- Enrutamiento: elige el endpoint del proveedor para el modelo solicitado, o la siguiente ruta sana de una cadena de fallback.
- Llamada al proveedor: traduce la solicitud al formato del proveedor si hace falta y devuelve la respuesta en streaming.
- Registro: guarda modelo, latencia, tokens, coste, estado e ID de solicitud para observabilidad y facturación.
Las 9 funciones de un LLM gateway que importan
| Función | Qué comprobar |
|---|---|
| API unificada | /v1/chat/completions compatible con OpenAI, además de Responses o Messages si los usas |
| Catálogo de modelos | Qué modelos están activos y con qué rapidez llegan los nuevos |
| Fallback y failover | Cadenas ordenadas y qué las activa (429, 5xx, timeout) |
| Balanceo de carga | Entre keys, regiones o proveedores |
| Límites y presupuestos | Por key, equipo y modelo, con topes estrictos |
| Observabilidad | Logs de solicitudes, uso de tokens, latencia y errores, idealmente exportables con las convenciones GenAI de OpenTelemetry |
| Seguimiento de costes | Por key, equipo y entorno (guía de atribución de costes) |
| Caché | Caché de respuestas exacta o semántica, y paso del prompt caching del proveedor |
| Seguridad y políticas | Alcance de keys, censura de datos personales, condiciones de retención, evidencia SOC 2 o DPA |
LLM gateway vs API gateway vs router de modelos vs MCP gateway
| Capa | Controla | ¿Entiende tokens y modelos? | Ejemplo |
|---|---|---|---|
| API gateway | APIs HTTP genéricas | No | Kong, AWS API Gateway |
| LLM gateway | Tráfico de modelos entre proveedores | Sí | LiteLLM, Portkey, Flatkey |
| Router de modelos | Qué modelo responde a cada prompt | Sí | RouteLLM, un motor de reglas |
| MCP gateway | Llamadas a herramientas de agentes vía Model Context Protocol | A nivel de herramienta | Proxies y registros MCP |
¿Cuál es la diferencia entre un MCP gateway y un LLM gateway? Un LLM gateway gobierna las llamadas a los modelos. Un MCP gateway gobierna las llamadas de los agentes a herramientas y fuentes de datos mediante el Model Context Protocol. Las plataformas de agentes suelen necesitar ambos: un LLM gateway para el gasto en modelos y un MCP gateway para los permisos de herramientas. Consulta controles de gateway para agentes de IA y AI API gateway vs gestión de APIs.
7 LLM gateways comparados (2026)
| Gateway | Despliegue | Código abierto | Punto fuerte | A tener en cuenta |
|---|---|---|---|---|
| LiteLLM | Proxy autoalojado o SDK | Sí | Más de 100 proveedores, enrutamiento, presupuestos | Tú lo operas, escalas y parcheas |
| Portkey | Alojado o autoalojado | El núcleo del gateway es abierto | Guardrails, observabilidad | Funciones avanzadas en planes de pago |
| Cloudflare AI Gateway | Alojado en el edge | No | Caché, analítica, límites de uso | Sigues gestionando las keys de proveedor |
| Kong AI Gateway | Autoalojado o Konnect | El núcleo es abierto | Encaja con la gestión de APIs de Kong existente | Configuración de plugins laboriosa |
| Vercel AI Gateway | Alojado | No | Integración estrecha con Vercel y AI SDK | Ideal dentro del ecosistema Vercel |
| OpenRouter | Alojado | No | Catálogo de modelos muy amplio, créditos | Enrutamiento compartido tipo marketplace |
| Flatkey | Alojado | No | Una key y un saldo para GPT, Claude, Gemini, Qwen, DeepSeek, Kimi, GLM, además de imagen y vídeo | Revisa el catálogo para modelos de nicho |
Comparativas más detalladas: guía para elegir el mejor LLM gateway, alternativas a OpenRouter, alternativas a Portkey, alternativas a Vercel AI Gateway y gateway gestionado vs proxy autoalojado.
Cómo se ve un LLM gateway en código
Con un gateway compatible con OpenAI, tu app mantiene el SDK de OpenAI y cambia dos valores: la base URL y la key. Cambiar de proveedor pasa a ser un cambio de string.
curl
curl https://router.flatkey.ai/v1/chat/completions \
  -H "Authorization: Bearer $FLATKEY_API_KEY" -H "Content-Type: application/json" \
  -d '{"model": "claude-sonnet-5-5", "messages": [{"role": "user", "content": "What is an LLM gateway?"}]}'
Python: un cliente, varios proveedores, fallback automático
import os
from openai import OpenAI, APIError

gw = OpenAI(api_key=os.environ["FLATKEY_API_KEY"], base_url="https://router.flatkey.ai/v1")

def complete(prompt, chain=("gpt-6-sol", "claude-sonnet-5-5", "gemini-3.5-flash")):
    for model in chain:
        try:
            r = gw.chat.completions.create(model=model, messages=[{"role": "user", "content": prompt}])
            return model, r.choices[0].message.content, r.usage.total_tokens
        except APIError as err:
            print(f"{model} -> {err.__class__.__name__}, trying next")
    raise RuntimeError("no route available")

print(complete("Give me one sentence on why gateways log token usage."))
Node.js
import OpenAI from "openai";
const gw = new OpenAI({ apiKey: process.env.FLATKEY_API_KEY, baseURL: "https://router.flatkey.ai/v1" });

const models = ["qwen3.8-max", "gpt-6-luna"];
const results = await Promise.all(models.map((model) =>
  gw.chat.completions.create({ model, messages: [{ role: "user", content: "Define 'fallback' in 8 words." }] })
));
results.forEach((r, i) => console.log(models[i], r.usage.total_tokens, r.choices[0].message.content));
Sin gateway, esto exigiría tres SDKs, tres keys y tres formatos de error. Para tu primera llamada, sigue la guía rápida de Flatkey.
Compatibilidad con OpenAI: qué garantiza y qué no
"Compatible con OpenAI" significa que el formato de solicitud y respuesta coincide con la Chat Completions API de OpenAI. No garantiza que todos los modelos admitan todas las funciones. Antes de migrar, prueba esto en cada modelo:
- Chunks de streaming y valores de
finish_reason - Llamadas a herramientas o funciones, y llamadas en paralelo
- Salida estructurada o modo JSON
- Entradas de imagen y archivos
- Campos de
usage, incluidos los tokens en caché - Códigos de error por límite de uso y desbordamiento de contexto (taxonomía de errores)
Cuándo necesitas un LLM gateway (y cuándo no)
Probablemente lo necesitas si: - Llamas a dos o más proveedores de modelos, o piensas hacerlo. - Varios equipos o servicios comparten el gasto en IA y necesitan presupuestos por equipo. - Necesitas failover durante caídas de proveedores. - Finanzas necesita un único registro en lugar de cinco facturas.
Puede que aún no lo necesites si: - Tienes un solo prototipo con un solo modelo y poco tráfico. - Tu contrato con el proveedor exige acceso directo, sin intermediarios.
Cómo evaluar un LLM gateway en una tarde
- Prueba de contrato: pasa por él tus 20 solicitudes más habituales (streaming, herramientas, JSON).
- Prueba de fallos: fuerza un ID de modelo erróneo y un timeout. ¿Se activa el fallback y el error es claro?
- Prueba de sobrecarga: compara la latencia P50 y P95 con la llamada directa al proveedor.
- Prueba del registro: ¿los tokens registrados coinciden con el
usagedel proveedor? ¿Se ve el coste por key? - Revisión de seguridad: comprueba el alcance de las keys, la retención de logs y las condiciones de tratamiento de datos (checklist de DPA).
- Prueba de salida: ¿puedes dejarlo volviendo a cambiar la base URL?
Preguntas frecuentes
¿Qué es un LLM gateway?
Un LLM gateway es una API intermedia situada entre las aplicaciones y los proveedores de modelos. Centraliza autenticación, enrutamiento, fallback, límites de uso, logs y seguimiento de costes tras un único endpoint, normalmente compatible con OpenAI.
¿Cuáles son los LLM gateways más populares?
Entre las opciones más usadas en 2026 están LiteLLM (código abierto, autoalojado), Portkey, Cloudflare AI Gateway, Kong AI Gateway, Vercel AI Gateway, OpenRouter y routers alojados como Flatkey.
¿Un LLM gateway es gratis?
Los gateways de código abierto como LiteLLM son gratuitos de ejecutar, pero pagas el alojamiento y la operación. Los gateways alojados cobran una tarifa de plataforma o facturan el uso de modelos con sus propios precios. En cualquier caso, los tokens de los modelos siguen costando dinero.
¿Cuál es la diferencia entre un MCP gateway y un LLM gateway?
Un LLM gateway gestiona las solicitudes a modelos de lenguaje. Un MCP gateway gestiona las solicitudes de los agentes a herramientas y fuentes de datos mediante el Model Context Protocol. Resuelven problemas distintos y a menudo se despliegan juntos.
¿Un LLM gateway es lo mismo que un AI gateway?
Normalmente sí. "AI gateway" es el término de marketing más amplio y suele cubrir también modelos de imagen, vídeo y audio. "LLM gateway" pone el foco en los modelos de texto.
¿Un LLM gateway añade latencia?
Un poco: un salto de red adicional más las comprobaciones de políticas. Mide la sobrecarga P95 en tu propia región. Durante una caída, el failover suele ahorrar mucho más tiempo del que cuesta ese salto.
¿Un LLM gateway puede reducir costes?
Sí, de forma indirecta. Facilita aplicar de forma coherente el enrutamiento a modelos más baratos, la caché y los topes de presupuesto. No puede abaratar los tokens de un modelo concreto, salvo que el propio gateway ofrezca tarifas con descuento.
Conclusión
Un LLM gateway convierte muchas integraciones de proveedores en un único endpoint controlado: una key, un formato de API, un registro y el fallback como configuración. Elige una opción autoalojada (LiteLLM, Kong) si quieres control total y puedes operarla. Elige una alojada (Portkey, Cloudflare, Vercel, OpenRouter, Flatkey) si prefieres no gestionar infraestructura. Para probar la vía alojada, consulta el directorio de modelos de Flatkey y la página de precios.
Última actualización: 20 de octubre de 2026 · Flatkey Team. Los datos de producto resumen la documentación oficial enlazada en el texto.