
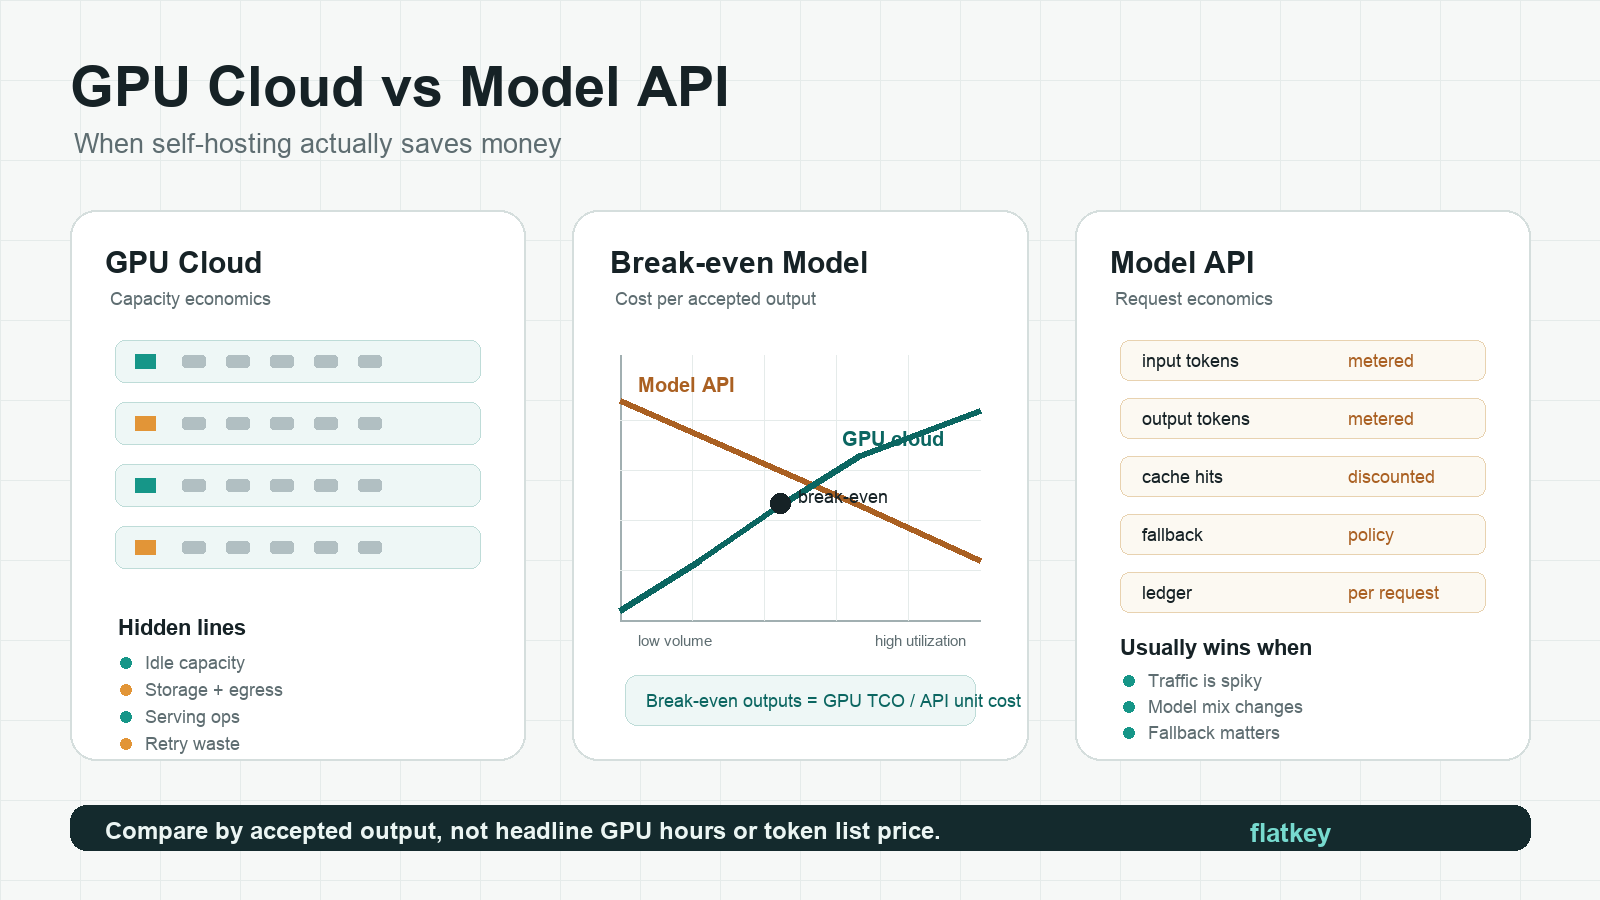
La mayoría de los equipos plantean la cuestión de GPU cloud frente a API de modelo demasiado tarde. Alquilan GPUs, despliegan una pila de serving, ajustan el batching, contratan soporte de plataforma y solo entonces comparan la factura con una API de modelo gestionada. Para entonces, la comparación ya está sesgada hacia la ruta en la que han invertido esfuerzo.
La mejor pregunta es más simple: ¿necesitas control de la capa GPU, o necesitas salidas de modelo fiables al menor coste aceptado?
Para los equipos de IA empresarial, GPU cloud empieza a ahorrar dinero cuando tienes demanda sostenida, una elección de modelo estable, alta utilización útil y el equipo de ingeniería para ejecutar inferencia. Una API de modelo suele ser más barata cuando el tráfico es irregular, la elección del modelo cambia con frecuencia, los reintentos y el failover importan más que el control del hardware, o necesitas modelos frontier que no pueden alojarse por tu cuenta.
La regla práctica de Flatkey: compara GPU cloud frente a API de modelo por coste por salida aceptada, no solo por la tarifa por hora de la GPU o el precio de lista por token.
Respuesta rápida: GPU cloud vs API de modelo
Usa esta tabla antes de construir una hoja de cálculo.
| Situación | Normalmente empezar con | Por qué |
|---|---|---|
| Producto en fase inicial, prompts cambiantes, demanda incierta | API de modelo | Evitas GPUs inactivas mientras aprendes sobre tráfico, calidad y ajuste del modelo. |
| Inferencia por lotes de alto volumen sobre un único modelo abierto estable | GPU cloud | La utilización sostenida puede amortizar la pila de serving. |
| Chat orientado al cliente con picos impredecibles | API de modelo o híbrido | El autoscaling, el fallback y no tener capacidad ociosa suelen importar más que el precio unitario bruto. |
| Ponderaciones propietarias, kernels personalizados, localización estricta de datos | GPU cloud | El requisito de negocio es el control, no solo el coste. |
| Enrutamiento de modelos multi-proveedor, modelos frontier o cambios frecuentes de modelo | API de modelo | Evitas reconstruir la infraestructura de serving por cada cambio de modelo. |
| Carga de trabajo estable a largo plazo con utilización probada | GPU cloud reservada, clúster GPU dedicado o GPUs en colocation | El compromiso puede reducir el coste efectivo de capacidad una vez que la demanda está probada. |
El resto de esta guía ofrece un modelo copiable para comparar GPU cloud frente a API de modelo sin ocultar el tiempo ocioso, los reintentos, las operaciones o los filtros de calidad.
La unidad de coste que realmente importa
No compares:
- Tarifa horaria de la GPU frente a precio por token.
- Cotización de cloud frente a un benchmark en el mejor de los casos.
- Precio de lista de la API de modelo frente a un clúster propio totalmente utilizado.
En su lugar, compara uno de estos denominadores:
| Carga de trabajo | Mejor denominador |
|---|---|
| Chat de LLM o agentes | Coste por respuesta aceptada, tarea aceptada o token de salida aceptado |
| Clasificación o extracción por lotes | Coste por registro aceptado |
| Generación de código | Coste por parche aceptado o tarea de programación completada |
| Generación de imágenes | Coste por imagen aceptada tras filtros de calidad |
| Generación de vídeo | Coste por segundo aceptado o clip aceptado |
| Fine-tuning o entrenamiento | Coste por ejecución completada |
Para la mayoría de los equipos de inferencia:
effective_unit_cost =
  all_in_monthly_cost
  / accepted_outputs_after_retries_quality_filters_and_failures
Aquí es donde muchas comparaciones entre GPU cloud y API de modelo cambian de signo. Un endpoint autoalojado puede mostrar un gran throughput en benchmarks y aun así perder si la utilización es baja, el modelo no pasa los controles de calidad o los ingenieros dedican demasiado tiempo a mantener la pila saludable.
Modelo de costes de la API de modelo
Una API de modelo parece simple porque la factura normalmente se mide por solicitud, token, segundo de imagen o vídeo, o llamada a herramienta. Pero un modelo justo de API de modelo necesita algo más que el precio unitario publicado.
Usa este modelo:
monthly_model_api_cost =
  input_token_cost
  + cached_input_or_context_cost
  + output_token_cost
  + tool_or_media_cost
  + retry_and_fallback_cost
  + gateway_or_router_cost
  + observability_and_finops_cost
Luego normaliza:
model_api_cost_per_accepted_output =
  monthly_model_api_cost
  / accepted_outputs
Qué capturar:
| Línea de coste | Qué comprobar |
|---|---|
| Tokens de entrada y salida | La página oficial de precios del proveedor, el ID del modelo, la ventana de contexto, el límite de salida y la fecha de verificación. |
| Entrada en caché | Si el proveedor admite caching de prompts o descuentos por acierto de caché, y si tu carga de trabajo reutiliza realmente el contexto. |
| Precios por lotes | Si el procesamiento por lotes o asíncrono se ajusta a tu requisito de latencia. |
| Reintentos | Reintentos por limitación de tasa, errores transitorios, controles de calidad fallidos y solicitudes de fallback. |
| Capa de router/gateway | Cualquier tarifa de gateway, registro de uso, allowlist de modelos, presupuesto por subclave o flujo de facturación. |
| Operaciones | Integración, monitorización, gestión del estado del proveedor y conciliación financiera. |
Usa las páginas oficiales de origen para los números actuales, no tablas de tarifas copiadas. Empieza con precios de la API de OpenAI, precios de Anthropic, precios de la API de Google Gemini y la página de precios actual de tu gateway o router.
Para Flatkey, el lado de la API de modelo consiste en una sola clave, un solo saldo y un único registro de uso entre modelos y herramientas oficiales. Eso importa cuando el verdadero problema de coste no es una sola llamada al modelo, sino claves dispersas, múltiples facturas, controles de presupuesto por equipo y conmutación por error entre proveedores.
Modelo de coste de cloud GPU
La cloud GPU no es solo el precio por hora de la GPU. Una API de modelo autoalojada en producción tiene coste de capacidad, software de serving, almacenamiento, red, monitorización, trabajo de disponibilidad y capacidad ociosa.
Usa este modelo:
monthly_gpu_cloud_cost =
  gpu_compute_hours
  + storage_and_snapshot_cost
  + bandwidth_and_egress_cost
  + load_balancing_and_network_cost
  + serving_stack_cost
  + observability_and_logging_cost
  + platform_engineering_cost
  + support_plan_or_managed_service_cost
  + idle_capacity_cost
  + retry_failure_and_redeployment_waste
Luego normaliza:
self_hosted_cost_per_accepted_output =
  monthly_gpu_cloud_cost
  / accepted_outputs
Qué capturar:
| Elemento de coste | Por qué cambia la respuesta |
|---|---|
| Modelo de GPU y memoria | H100, H200, B200, A100, L40S y las GPUs de clase RTX tienen curvas diferentes de memoria, rendimiento, suministro y precio. |
| Modo de producto | Bajo demanda, spot, reservado, marketplace, GPU serverless, clúster dedicado y bare metal tienen perfiles de fiabilidad distintos. |
| Utilización | Un endpoint autoalojado más barato pierde rápidamente si la GPU permanece inactiva. |
| Stack de serving | vLLM, SGLang, TensorRT-LLM, NIM o servidores personalizados necesitan soporte operativo real. |
| Almacenamiento y carga del modelo | Los pesos grandes, snapshots, volúmenes y pulls repetidos pueden volverse relevantes. |
| Red | El egreso, los enlaces privados, las IP públicas y el balanceo de carga pueden cambiar la economía por unidad. |
| Fallos | Los errores de falta de memoria, las preempciones, los contenedores defectuosos y los arranques en frío aumentan el coste aceptado. |
Usa las páginas actuales de los proveedores como puntos de referencia: precios de AWS EC2, instancias AWS P5, precios de GPU de Google Cloud, precios de RunPod, Lambda GPU Cloud y precios de Vast.ai.
Trata cada precio de GPU como si tuviera marca temporal. La oferta del marketplace, la disponibilidad regional y las cotizaciones comprometidas pueden cambiar más rápido que el artículo que estás leyendo.
La fórmula de punto de equilibrio
Aquí es donde una decisión entre cloud GPU y API de modelo deja de ser una opinión y pasa a ser una decisión de nivel financiero.
El modelo de punto de equilibrio más simple es:
break_even_outputs =
  monthly_gpu_cloud_cost
  / model_api_cost_per_accepted_output
Si tu carga de trabajo produce más outputs aceptados que break_even_outputs, el autoalojamiento puede ahorrar dinero. Si produce menos, una API de modelo probablemente sea más barata.
También puedes expresar la misma idea en utilización:
required_utilization =
  monthly_gpu_cloud_cost
  / equivalent_model_api_cost_at_expected_volume
Esa fórmula solo es útil si la carga de trabajo es estable. Si el volumen, el modelo, la longitud de contexto o el objetivo de calidad cambian cada mes, el lado de la API de modelo tiene valor de opción que una fórmula de utilización no capta.
Ejemplo práctico: por qué el precio horario de la GPU puede llevar a error
Supongamos que un equipo está decidiendo si autoalojar un modelo abierto estable.
| Entrada | Valor de ejemplo |
|---|---|
| Coste total de cloud GPU | 24.000 $ al mes |
| Volumen de outputs aceptados | 30 millones de outputs aceptados al mes |
| Coste autoalojado por output aceptado | 0,0008 $ |
| Coste de la API de modelo por output aceptado | 0,0012 $ |
| Coste mensual de la API de modelo al mismo volumen | 36.000 $ |
| Ahorro aparente del autoalojamiento | 12.000 $ al mes |
En ese caso base, la cloud GPU parece ahorrar dinero.
Ahora estresa los supuestos.
| Cambio | Efecto |
|---|---|
| La utilización útil cae un 35% | El coste unitario autoalojado sube porque el pool fijo de GPUs hace menos trabajo aceptado. |
| La tasa de reintentos o fallos de calidad se duplica | Ambas rutas se encarecen, pero el autoalojamiento también absorbe desperdicio de capacidad. |
| El producto cambia a un modelo más grande | Las GPUs existentes pueden necesitar sharding, más memoria o un nuevo stack de serving. |
| La demanda se vuelve irregular | La API de modelo puede escalar con la demanda; el pool de GPUs debe dimensionarse para los picos o aceptar colas. |
Si el escenario negativo elimina el ahorro, el autoalojamiento en realidad no es más barato. Es una apuesta de capacidad.
Cuándo la cloud GPU realmente ahorra dinero
La cloud GPU puede ahorrar dinero cuando la mayoría de estas afirmaciones son ciertas:
- Tienes una demanda sostenida, no ráfagas ocasionales.
- La familia de modelos es estable durante meses, no días.
- El modelo tiene pesos abiertos o, de otro modo, está disponible para autoalojamiento.
- La carga de trabajo tiene una alta utilización útil después de las brechas en la cola y los fallos.
- Los objetivos de latencia pueden cumplirse con tu stack de serving.
- Puedes ejecutar vLLM, SGLang, TensorRT-LLM, NIM u otro stack de forma fiable.
- El equipo puede supervisar la utilización de GPU, la presión de memoria, la latencia p95/p99, la tasa de errores y la amplificación de reintentos.
- Tienes un plan para la carga del modelo, el calentamiento de caché, la automatización del apagado y la seguridad de los despliegues.
- La cotización incluye suposiciones de almacenamiento, egreso, soporte y disponibilidad.
- Finanzas se siente cómoda financiando capacidad antes de que llegue cada solicitud.
Esto es común en la inferencia por lotes de gran volumen, los pipelines internos de extracción, los bots de soporte estables, los modelos abiertos específicos de un dominio y las cargas de trabajo donde los pesos personalizados o la localización de datos importan.
Para una planificación más profunda del lado de la GPU, usa las guías de Flatkey sobre precios de alquiler de GPU, la mejor GPU para la inferencia de LLM, alquiler de clústeres de GPU y TCO de clústeres de GPU.
Cuándo las APIs de modelo siguen siendo más baratas
Las APIs de modelo suelen seguir siendo más baratas cuando esto es cierto:
- El tráfico es irregular, estacional o aún desconocido.
- La aplicación necesita múltiples modelos de vanguardia.
- El modelo cambia más rápido que tu plan de infraestructura.
- El equipo necesita más respaldo, gestión de límites de velocidad, facturas, registros de uso y controles de presupuesto que control sobre el hardware.
- No puedes mantener las GPU lo suficientemente ocupadas como para compensar el tiempo de inactividad.
- No tienes un equipo de plataforma listo para operar la capa de serving.
- La carga de trabajo incluye modelos cerrados, generación multimodal, capacidades propietarias del proveedor o lanzamientos de modelos que avanzan rápido.
- Compras quiere atribución por solicitud en lugar de una factura de infraestructura compartida.
Aquí es donde la comparación entre GPU cloud y API de modelo no trata solo del precio. Una API de modelo puede reducir el tiempo de integración, la complejidad de compras y la superficie de incidentes.
Flatkey encaja en este lado de la decisión cuando los equipos quieren una única ruta compatible con OpenAI para muchos modelos oficiales, un único saldo prepago, una sola factura, presupuestos por subclave, listas de अनुमति de modelos, registros de uso a nivel de solicitud y conmutación por error entre canales upstream. Consulta las guías relacionadas sobre comparación de precios de modelos de IA, comparación de precios de APIs de IA, precios de gateways de IA y gestión del gasto en APIs de IA.
Lo híbrido suele ser la respuesta real
Muchos equipos empresariales de IA no deberían forzar una única respuesta universal. Un modelo híbrido suele ser más defendible:
| Segmento de carga de trabajo | Opción predeterminada mejor |
|---|---|
| Inferencia estable y de gran volumen con pesos abiertos | GPU cloud |
| Razonamiento o código con modelo de vanguardia | API de modelo |
| Trabajos por lotes que pueden esperar en cola | GPU cloud, spot o capacidad reservada |
| Picos orientados al cliente | API de modelo o desbordamiento híbrido |
| Pesos propietarios | GPU cloud |
| Exploración de modelos | API de modelo |
| Despliegue regulado con control de infraestructura | GPU cloud dedicada, GPU cloud privada, colocation o instalaciones propias |
El patrón híbrido es:
- Enruta las cargas de trabajo desconocidas y variables a través de APIs de modelo.
- Haz pruebas comparativas de las cargas de trabajo estables en GPU cloud.
- Mueve solo las cargas de trabajo con volumen comprobado y estabilidad del modelo al autoalojamiento.
- Mantén un respaldo de API de modelo para desbordamiento, actualizaciones de modelo y diversidad de proveedores.
Ese camino evita el error más costoso: comprar capacidad de GPU para una carga de trabajo que después cambia de forma.
Plan de benchmark antes de cambiar
Ejecuta el mismo tráfico por ambas rutas durante al menos una ventana representativa.
| Métrica | Ruta GPU cloud | Ruta API de modelo |
|---|---|---|
| Salidas aceptadas | ||
| Tokens o registros de entrada | ||
| Tokens o resultados de salida | ||
| Latencia p50 / p95 / p99 | ||
| Tiempo hasta el primer token | ||
| Tasa de errores | ||
| Tasa de reintentos | ||
| Tasa de rechazo por calidad | ||
| Capacidad inactiva | N/A | |
| Horas de personal | ||
| Almacenamiento y egreso | ||
| Costo total | ||
| Costo por salida aceptada |
Luego pregunta:
- ¿Sigue ganando GPU cloud después del tiempo inactivo?
- ¿Sigue ganando después del tiempo del personal?
- ¿Sigue ganando después de los reintentos y los filtros de calidad?
- ¿Sigue ganando si el modelo cambia?
- ¿Sigue ganando si el tráfico cae un 30%?
- ¿Sigue ganando si la latencia p95 debe mejorar?
Si la respuesta es sí incluso en el caso desfavorable, el autoalojamiento merece un proceso serio de compras.
Lista de verificación de compras
Para GPU cloud:
- ¿Qué GPU exacta, tamaño de memoria, CPU, RAM, disco, interconexión y ancho de banda de red están incluidos?
- ¿La capacidad es bajo demanda, spot, marketplace, cloud segura, reservada, dedicada o bare metal?
- ¿Qué costos de almacenamiento, snapshot, egress, IP pública, balanceador de carga, soporte y observabilidad quedan excluidos?
- ¿Qué sucede durante una falla del host, preemption, mantenimiento o escasez de capacidad?
- ¿Puede el proveedor ejecutar tu benchmark real antes del compromiso?
- ¿Cuál es el plazo mínimo, la ruta de escalado y el costo de salida?
Para las APIs de modelo:
- ¿Qué IDs exactos de modelo, ventanas de contexto, límites de salida y unidades de precios se usan?
- ¿Los aciertos de caché, trabajos batch, unidades de imagen/video y llamadas a herramientas se cobran por separado?
- ¿Cuáles son los límites de tasa y las opciones de fallback?
- ¿Cómo se contabilizan los reintentos, las llamadas fallidas al proveedor y los rechazos de calidad?
- ¿Finanzas puede exportar el uso por equipo, clave, modelo, entorno y cliente?
- ¿Qué términos de retención de datos, cumplimiento y SLA aplican?
Lista de verificación de fuentes
Usa estas páginas oficiales como punto de partida para los insumos actuales:
| Tipo de fuente | Páginas para consultar |
|---|---|
| Precios de API de modelo | Precios de la API de OpenAI, Precios de Anthropic, Precios de la API de Google Gemini |
| Precios de cloud de GPU | Precios de AWS EC2, Instancias AWS P5, Precios de GPU de Google Cloud, Precios de RunPod, Lambda GPU Cloud, Precios de Vast.ai |
| Frameworks de serving | Servidor compatible con OpenAI de vLLM, Documentación de SGLang |
| Especificaciones de GPU | NVIDIA H100, NVIDIA H200, NVIDIA DGX B200 |
| Estructura de FinOps | FinOps FOCUS |
| Contexto de costos de Flatkey | Precios de Flatkey, Flatkey Compute, Índice de precios de Flatkey Compute |
Preguntas frecuentes
¿La cloud de GPU siempre es más barata que una API de modelo?
No. La cloud de GPU solo es más barata cuando la utilización útil es lo suficientemente alta como para compensar la capacidad inactiva, el almacenamiento, el egress, las operaciones de serving, el desperdicio por reintentos y el tiempo del personal. Una API de modelo puede ser más barata para cargas de trabajo intermitentes o cambiantes incluso cuando el precio por token parece más alto.
¿Cuándo el autoalojamiento de un LLM ahorra dinero?
El autoalojamiento ahorra dinero cuando el modelo es estable, el volumen es alto, la utilización es predecible, el equipo puede operar la pila de serving y el costo total de la cloud de GPU por salida aceptada es inferior al costo de la API de modelo bajo supuestos conservadores.
¿Cómo debo comparar los precios de cloud de GPU frente a los de una API de modelo?
Compara el costo por salida aceptada. Incluye tokens, horas de GPU, almacenamiento, ancho de banda, tiempo inactivo, reintentos, tasa de fallos, filtros de calidad, tiempo de ingeniería, soporte y operaciones financieras. No compares solo el precio horario de la GPU con el precio de lista por token.
¿Cuál es el mayor costo oculto del inferencia en cloud de GPU?
Los mayores costos ocultos suelen ser la capacidad inactiva, las operaciones de ingeniería, el almacenamiento y el egress, los despliegues fallidos, los reintentos por falta de memoria y los cambios de serving poco probados. Estos costos no aparecen en la tarifa horaria destacada de la GPU.
¿Cuál es el mayor costo oculto de las APIs de modelo?
Los mayores costos ocultos suelen ser los reintentos, las llamadas de fallback, los prompts largos, el contexto no cacheado, las respuestas con mucho output, las llamadas a herramientas o medios, las cuentas de proveedores dispersas y una atribución de uso débil. Un libro mayor a nivel de solicitud ayuda a exponer estos costos.
¿Los equipos de IA empresarial deberían usar una arquitectura híbrida?
A menudo, sí. Usa APIs de modelo para exploración, modelos frontier, picos de demanda y fallback. Mueve solo las cargas de trabajo estables y de alto volumen a la cloud de GPU después de que un benchmark demuestre un costo aceptado menor. Mantén la ruta de API disponible para overflow y cambios de modelo.
Conclusión
Cloud de GPU frente a API de modelo no es una decisión filosófica. Cloud de GPU frente a API de modelo es una decisión de economía de cargas de trabajo.
Elige cloud de GPU cuando puedas mantener ocupada la capacidad, el modelo sea estable y el control del hardware cree una ventaja real. Elige una API de modelo cuando la flexibilidad, el acceso multi-proveedor, los cambios de modelo más rápidos y la gobernanza por solicitud valgan más que el ahorro teórico en hardware.
La ruta más segura es gradual: empieza con la API de modelo, prueba la carga de trabajo, mueve a cloud de GPU solo los segmentos estables cuando la matemática del punto de equilibrio resista escenarios conservadores, y mantén una ruta de API para fallback y futuros cambios de modelo.
Si está comparando la nube de GPU frente a una API de modelo para una carga de trabajo de IA en producción, Flatkey puede ayudar del lado de la API con una sola clave, un solo saldo, rutas oficiales de modelos, registros de uso, presupuestos y facturas mientras su equipo demuestra qué cargas de trabajo realmente merecen capacidad de GPU dedicada.


