¿Qué es una fábrica de IA? Clústeres de GPU, datos, modelos y operaciones
¿Qué es una fábrica de IA? Una fábrica de IA es el sistema operativo que rodea la IA empresarial: capacidad de GPU, canalizaciones de datos, entrenamiento o ajuste fino de modelos, servicio de inferencia, evaluación, gobernanza y operaciones de costos trabajando como un único bucle de producción repetible.
La metáfora importa porque la IA no se produce solo con GPUs. Un clúster de GPU es la sala de máquinas, pero una fábrica de IA también necesita datos curados, planificadores, almacenamiento, redes, registros de modelos, flujos de implementación, observabilidad, controles de seguridad y un modelo financiero para decidir cuándo alquilar GPUs, reservar clústeres, usar API gestionadas o combinar las tres cosas.
NVIDIA popularizó el término en torno a la infraestructura que convierte datos en inteligencia, y proveedores como Dell Technologies y HPE ahora usan "fábrica de IA" para describir plataformas empresariales de IA de pila completa. Para quienes construyen, la pregunta útil es menos "¿quién es el dueño de la frase?" y más práctica: ¿qué piezas deben existir antes de que tu carga de trabajo de IA se convierta en una fábrica en lugar de un experimento aislado?
Esta guía define qué es una fábrica de IA, explica cómo funciona una fábrica de IA, mapea las capas principales de la plataforma y muestra dónde encaja Flatkey cuando un equipo quiere acceso a modelos/API sin operar por sí mismo cada capa de la infraestructura de GPU.
La definición rápida: ¿qué es una fábrica de IA?
Una fábrica de IA es un entorno de producción que convierte datos sin procesar, prompts, modelos, cómputo y retroalimentación operativa en resultados de IA utilizables. En términos empresariales, es un sistema repetible para crear, desplegar, medir y mejorar capacidades de IA.
Una forma sencilla de pensarlo:
| Capa de la fábrica | Qué hace | Propietario habitual |
|---|---|---|
| Capacidad de GPU y aceleradores | Ejecuta entrenamiento, ajuste fino, inferencia por lotes o cargas de trabajo de inferencia en tiempo real | Infraestructura, plataforma, sistemas de ML |
| Red y almacenamiento | Mueve conjuntos de datos, checkpoints, embeddings, registros y artefactos de modelos sin cuellos de botella | Infraestructura, SRE, plataforma de datos |
| Canalizaciones de datos | Ingiere, limpia, etiqueta, filtra y actualiza los datos usados por modelos y aplicaciones | Ingeniería de datos, plataforma de ML |
| Ciclo de vida del modelo | Selecciona modelos base, ajusta finamente, evalúa, versiona y despliega | Ingeniería de ML, producto de IA |
| Servicio y enrutamiento | Entrega resultados de modelos a través de APIs, trabajos por lotes, agentes o aplicaciones | Backend, plataforma, ingeniería de IA |
| Operaciones | Supervisa latencia, errores, utilización, costo, seguridad, acceso y deriva de calidad | SRE, FinOps, seguridad, gobernanza |
Así que cuando alguien pregunta "¿qué es una fábrica de IA?", la mejor respuesta es: es la pila de producción completa para IA, no solo una sala llena de GPUs.
¿Cómo funciona una fábrica de IA?
Una fábrica de IA funciona convirtiendo cuatro entradas en un bucle de salida gestionado:
- Datos entran a través de eventos de clientes, documentos, código, registros, medios, datos sintéticos, conjuntos de datos públicos o llamadas a herramientas.
- Cómputo procesa los datos mediante trabajos de entrenamiento, ejecuciones de ajuste fino, canalizaciones de recuperación, trabajos de embeddings, inferencia por lotes o inferencia en tiempo real.
- Modelos producen resultados a través de checkpoints, API alojadas, enrutadores de modelos o agentes específicos de dominio.
- Operaciones miden si los resultados son fiables, asequibles, gobernados y suficientemente útiles como para mantenerse en producción.
Ese bucle se repite. Una fábrica de IA madura recopila retroalimentación de usuarios y sistemas, convierte esa retroalimentación en datos de evaluación, mejora prompts o modelos, y lanza la siguiente versión mediante un despliegue controlado.
Por eso la conversación sobre fábricas de IA incluye tanto el diseño del centro de datos como las operaciones del producto. Un clúster puede entrenar o servir un modelo, pero la fábrica solo existe cuando el equipo puede responder repetidamente:
- ¿Qué cargas de trabajo requieren control directo de GPU?
- ¿Qué cargas de trabajo pueden usar una API de modelo gestionada?
- ¿Qué datos tienen permitido llegar a qué modelo?
- ¿Qué resultados superan la evaluación?
- ¿Qué fallos deben reintentarse, conmutarse por error o detenerse?
- ¿Qué equipo, cliente, producto o entorno generó el costo?
Fábrica de IA vs clúster de GPU
Un clúster de GPU es un recurso de cómputo. Una fábrica de IA es un sistema de producción que utiliza recursos de cómputo.
La distinción importa porque muchos programas de IA costosos fallan en la capa superior al clúster. El equipo compra capacidad y luego descubre que el movimiento de datos, el almacenamiento de checkpoints, el servicio de modelos, la observabilidad, el control de acceso y la atribución de costos son los verdaderos bloqueos.
Usa una guía de alquiler de clústeres de GPU cuando necesites comparar capacidad de GPU multinodo, topología, redes y pruebas de aceptación. Usa un modelo de fábrica de IA cuando necesites decidir cómo el cómputo, los datos, el despliegue del modelo y las operaciones se convierten en una capacidad de IA duradera.
| Pregunta | Respuesta de clúster de GPU | Respuesta de fábrica de IA |
|---|---|---|
| ¿Qué estamos comprando? | Nodos, GPUs, red, almacenamiento, soporte | Un sistema de producción de IA repetible |
| ¿Qué se optimiza? | Rendimiento, utilización, disponibilidad, finalización de trabajos | Resultado de negocio, calidad, coste, gobernanza, velocidad de iteración |
| ¿Quién lo opera? | Infra, plataforma, SRE, sistemas de ML | Infra más datos, ML, producto, seguridad, finanzas |
| ¿Qué puede salir mal? | Red saturada, trabajos fallidos, GPUs inactivas, contención de colas | Modelo incorrecto, datos débiles, salida insegura, coste descontrolado, gobernanza ausente |
| ¿Cuál es la pregunta de economía unitaria? | Coste por hora de GPU o por trabajo | Coste por salida aceptada, función, cliente o flujo de trabajo |
Para el modelado de costes, combina este artículo con la hoja de cálculo del TCO de clústeres de GPU. El presupuesto de una fábrica de IA debe incluir el clúster, pero también el almacenamiento, la salida de datos, el tiempo de ingeniería, los fallos, la evaluación, la observabilidad y la gobernanza.
Capas de la plataforma de fábrica de IA
¿Qué es una plataforma de fábrica de IA? Es la capa de software e infraestructura que permite a los equipos ejecutar la fábrica como un producto en lugar de como una colección de scripts.
En la práctica, una plataforma de fábrica de IA suele incluir siete capas.
1. Capacidad y hardware
Esta capa incluye GPUs o aceleradores, hosts CPU, memoria, almacenamiento local, diseño de racks, energía, refrigeración y el centro de datos o región de nube donde se ejecuta la carga de trabajo.
Para entrenamiento e inferencia por lotes de gran tamaño, los equipos se preocupan por el rendimiento multinodo, la red, la velocidad de los checkpoints y el comportamiento del programador. Para inferencia en tiempo real, los equipos se preocupan por la cola, los arranques en frío, las colas de latencia, el autoescalado y el tiempo de actividad. El modelo de capacidad adecuado puede ser alquiler de GPU bajo demanda, capacidad reservada de GPU, una nube privada de GPU, GPU sin servidor, colocation o un clúster interno.
2. Red y almacenamiento
Las cargas de trabajo de IA a menudo están limitadas por el movimiento, no por las matemáticas brutas. Los trabajos de entrenamiento mueven conjuntos de datos y checkpoints. Los sistemas de recuperación mueven embeddings y documentos fuente. La generación de medios mueve archivos grandes. Los flujos de trabajo de agentes pueden llamar a herramientas, bases de datos y navegadores.
Eso significa que una plataforma de fábrica de IA necesita una localidad de almacenamiento predecible, reglas de retención de datos, planes de copia de seguridad y rutas de red que se ajusten a la carga de trabajo. Un clúster con GPUs rápidas y almacenamiento débil aún puede tener un rendimiento inferior.
3. Canalizaciones de datos
Las canalizaciones de datos deciden de qué puede aprender la fábrica y con qué puede responder. Cubren la ingesta, el filtrado, el etiquetado, la deduplicación, el manejo de la privacidad, los límites de permisos, las comprobaciones de calidad y los calendarios de actualización.
Para la generación aumentada por recuperación, la canalización de datos puede ser más importante que la elección del modelo. Para el ajuste fino, pequeños problemas de calidad pueden convertirse en fallos repetidos aguas abajo. Para los agentes, las herramientas de datos y las herramientas web pasan a formar parte de la superficie de entrada de la fábrica.
4. Ciclo de vida del modelo
El ciclo de vida del modelo abarca la selección del modelo, el diseño de prompts, el ajuste fino, la evaluación, el versionado, las pruebas de regresión, las reversions y las notas de lanzamiento. Aquí es donde un equipo decide si usar una API de modelo de frontera, un modelo de pesos abiertos en GPUs alquiladas, un modelo especializado de imagen/vídeo o una ruta híbrida.
Flatkey es relevante aquí cuando un equipo quiere comparar y enrutar entre APIs oficiales de modelos sin gestionar muchas claves de proveedores y saldos separados. Flatkey ofrece a los desarrolladores una clave, un saldo y una factura únicos en cientos de modelos oficiales y herramientas de pago por llamada, lo que puede ser más sencillo que convertir cada carga de trabajo en infraestructura propia.
5. Serving, enrutamiento e integración con aplicaciones
Serving convierte un modelo entrenado o seleccionado en un endpoint fiable. El enrutamiento decide qué modelo, proveedor, región o ruta de respaldo debe gestionar cada solicitud.
Aquí es donde la fábrica de IA se encuentra con las aplicaciones. Un agente de programación, un copiloto de atención al cliente, una canalización de imágenes, un flujo de trabajo de vídeo o una herramienta interna de investigación no deberían necesitar conocer cada detalle de la infraestructura. Necesitan una API estable, latencia predecible, coste trazable y modos de fallo recuperables.
Si tu equipo está decidiendo si poseer la capa de serving, lee nube de GPU vs API de modelo. La versión corta: posee el serving en GPU cuando el control del hardware, los modelos personalizados, el aislamiento de datos o la economía unitaria justifican la carga operativa; usa APIs de modelos cuando la velocidad, la amplitud, la conmutación por error y una menor carga de plataforma importan más.
6. Observabilidad, evaluación y gobernanza
Una fábrica de IA debe medir más que el tiempo de actividad. Debe rastrear el volumen de solicitudes, la latencia, los errores, los reintentos, el coste, la elección del modelo, las versiones de prompts, las fuentes de datos, los filtros de seguridad, las puntuaciones de evaluación y las salidas aceptadas.
La gobernanza va junto a la observabilidad. Los equipos necesitan controles de acceso, registros de auditoría, reglas de retención, aprobación de proveedores, límites sobre datos de clientes y rutas de escalado para resultados inseguros o de baja calidad. Sin esos controles, la fábrica puede escalar el riesgo más rápido que el valor.
7. FinOps y cadencia operativa
Las fábricas de IA convierten cómputo en resultados, pero los equipos financieros siguen necesitando saber cuánto cuestan esos resultados. El modelo operativo debe atribuir el gasto por producto, entorno, cliente, equipo o flujo de trabajo.
Las métricas de unidad útiles incluyen:
- Coste por salida aceptada
- Coste por acción de usuario completada
- Coste por llamada a herramienta exitosa
- Utilización de GPU por clase de carga de trabajo
- Desperdicio por reintentos y fallos
- Tasa de aciertos de caché
- Tiempo de espera en cola
- Tasa de fallback del modelo
El valor de Flatkey es mayor cuando los equipos quieren el uso de modelos y herramientas en un libro mayor compartido en lugar de cuentas de proveedor fragmentadas. Eso no reemplaza un clúster de GPU para infraestructura personalizada, pero puede reducir la complejidad de las cargas de trabajo de modelos/API que no requieren control directo del hardware.
¿Qué es una fábrica de IA en términos de NVIDIA?
¿De qué suele tratar la discusión sobre qué es una fábrica de IA según NVIDIA? NVIDIA usa el término para describir una infraestructura que convierte los datos empresariales en inteligencia, con GPUs, redes aceleradas, software y patrones de despliegue trabajando juntos. Los materiales de fábrica de IA de NVIDIA y la arquitectura de referencia empresarial se centran en un diseño de pila completa, no solo en aceleradores individuales.
Ese enfoque es útil, pero también puede sesgar a los lectores hacia la visión del hardware. El comprador práctico debería traducir el concepto de NVIDIA en una lista de verificación operativa:
- ¿Qué cargas de trabajo necesitan GPUs de NVIDIA directamente?
- ¿Qué modelos se entrenan, ajustan o sirven en esas GPUs?
- ¿Qué fuentes de datos alimentan los modelos?
- ¿Qué pila de software programa y supervisa los trabajos?
- ¿Qué aplicaciones consumen los resultados?
- ¿Qué equipo se encarga de la confiabilidad, la seguridad y el costo?
Jensen Huang suele presentar las fábricas de IA como la próxima generación de centros de datos porque fabrican tokens o inteligencia a partir de datos y energía. Tómalo como la narrativa macro. Tu implementación aún necesita dimensionamiento de cargas de trabajo, gobernanza, diseño de niveles de servicio y un modelo de costos.
¿Qué es una fábrica de IA en contexto empresarial?
En un contexto empresarial, una fábrica de IA es una capacidad organizativa. Ofrece a los equipos una forma repetible de lanzar funciones de IA, flujos de trabajo de agentes, copilotos internos, productos de datos y operaciones automatizadas.
La fábrica debería responder a las preguntas de negocio en términos operativos:
| Business question | AI factory translation |
|---|---|
| ¿Podemos lanzar esta función de IA de forma segura? | Permisos de datos, evaluación del modelo, alternativa de respaldo, registros de auditoría |
| ¿Podemos escalar sin un costo inesperado? | Presupuestos, límites de tasa, libro mayor de uso, enrutamiento de modelos, utilización de GPU |
| ¿Podemos mejorar la calidad con el tiempo? | Bucles de retroalimentación, conjuntos de evaluación, pruebas de regresión, versionado de prompts/modelos |
| ¿Pueden los equipos reutilizar la plataforma? | API compartidas, plantillas, observabilidad, controles de acceso |
| ¿Podemos cambiar de modelo o proveedor? | Capa de abstracción, rutas compatibles con OpenAI, benchmarks de modelos |
Esta es también la razón por la que una fábrica de IA no es automáticamente la inversión adecuada para todos los equipos. Si el producto solo necesita texto estándar, imagen, video, búsqueda, navegador, enriquecimiento o llamadas a herramientas de agente, una pasarela administrada de modelos y herramientas puede llegar a producción más rápido. Si el producto necesita pesos de modelos personalizados, control del plano de datos privado, inferencia de alto volumen o canalizaciones de medios especializadas, una fábrica respaldada por GPU puede estar justificada.
¿Construir, alquilar o usar APIs de modelos?
La estrategia correcta de fábrica de IA suele ser híbrida.
Construye o reserva capacidad de GPU cuando:
- Ejecutas inferencia constante y de alto volumen, y puedes mantener las GPUs utilizadas.
- Necesitas pesos de modelo personalizados, servicio de modelos privado o kernels especializados.
- Puedes operar almacenamiento, redes, programación, seguridad y respuesta a incidentes.
- El costo de la carga de trabajo por resultado aceptado es menor después de incluir todos los costos ocultos.
Alquila clústeres de GPU cuando:
- Necesitas ráfagas de entrenamiento, ajuste fino, evaluación o inferencia por lotes.
- Quieres validar la forma de la carga de trabajo antes de comprar o reservar capacidad.
- Necesitas aceleradores, regiones o topologías específicos para un proyecto definido.
- Puedes tolerar el trabajo de configuración y pruebas de aceptación.
Usa API de modelos o una pasarela cuando:
- Necesitas acceso rápido a muchos modelos y modalidades.
- La carga de trabajo cambia con frecuencia.
- La conmutación por error del proveedor importa más que el control bruto del hardware.
- Tu equipo quiere una clave API, una factura y controles de uso en lugar de cuentas de proveedor dispersas.
- Necesitas herramientas como búsqueda, automatización del navegador, enriquecimiento de datos o API de medios en el mismo flujo de trabajo.
Para muchos equipos, la fábrica de IA no es un único lugar. Es un modelo operativo que abarca GPUs alquiladas, API administradas, servicios internos y herramientas de agentes.
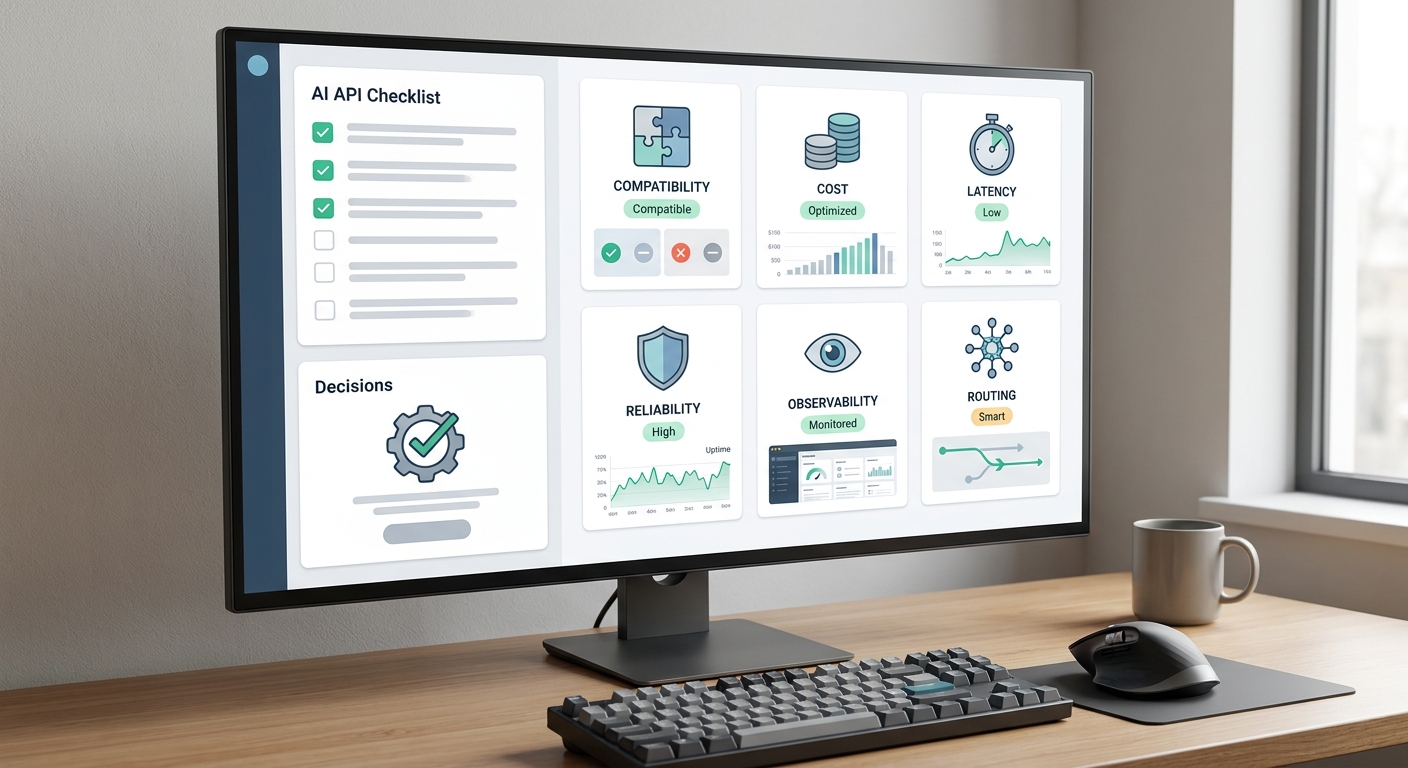
Lista de evaluación de una fábrica de IA
Antes de invertir en una plataforma de fábrica de IA, haz estas preguntas:
- Workload: ¿Estamos entrenando, ajustando, generando embeddings, sirviendo, generando medios, ejecutando agentes o haciendo todo eso?
- Latency: ¿Qué cargas de trabajo son en tiempo real, por lotes, asíncronas o con intervención humana?
- Data: ¿Qué conjuntos de datos, documentos, registros y resultados de herramientas alimentan el sistema, y quién puede acceder a ellos?
- Model strategy: ¿Qué modelos son propios, alquilados, de pesos abiertos, API de frontera, multimodales o especializados?
- Serving: ¿Las aplicaciones necesitan un endpoint interno estable, una API compatible con OpenAI o acceso directo al clúster?
- Reliability: ¿Qué sucede cuando falla un modelo, proveedor, nodo GPU, ruta de almacenamiento o cola?
- Cost: ¿Cuál es el costo por resultado aceptado después de reintentos, tiempo de inactividad, almacenamiento, egreso, ingeniería y soporte?
- Governance: ¿Cómo se auditan prompts, resultados, fuentes de datos, usuarios y versiones de modelos?
- Portability: ¿Puede la carga de trabajo moverse entre proveedores, regiones, familias de modelos o tipos de GPU?
- Ownership: ¿Qué equipo es dueño de la fábrica después del lanzamiento?
Si tu equipo no puede responder esas preguntas, empieza con algo más pequeño. Usa API administradas para la primera ruta de producción, mide el uso real y luego mueve las cargas de trabajo que claramente justifican el control directo de GPU a una plataforma de fábrica de IA más formal.
Errores comunes
El primer error es tratar una fábrica de IA como un proyecto de aprovisionamiento. Comprar GPU no es lo mismo que construir un sistema de producción de IA.
El segundo error es ignorar las operaciones de datos. Una mala calidad de datos, permisos poco claros, pipelines de recuperación débiles y conjuntos de evaluación faltantes generan más riesgo aguas abajo que la mera elección del modelo.
El tercer error es medir solo el precio horario de la GPU. Para la IA en producción, mida el trabajo útil completado. Los precios de alquiler de GPU son solo un insumo; el tiempo en cola, los reintentos, los trabajos fallidos, el almacenamiento, el movimiento de datos y el tiempo del personal también importan.
El cuarto error es construir una fábrica personalizada para cargas de trabajo que deberían usar API. Si una ruta gestionada con un modelo oficial es suficiente, el coste de oportunidad de operar infraestructura puede superar el ahorro.
El quinto error es omitir el diseño para fallos. Los sistemas de IA fallan por sobrecarga, deriva del modelo, incidentes del proveedor, rechazos de políticas, malas recuperaciones, errores de herramientas y reintentos descontrolados. La fábrica necesita controles antes de que llegue el tráfico.
Preguntas frecuentes
¿Qué es una fábrica de IA y cómo funciona?
Una fábrica de IA es un sistema de producción que convierte datos, modelos, capacidad de cómputo y retroalimentación operativa en resultados de IA. Funciona combinando capacidad de GPU o API, pipelines de datos, gestión del ciclo de vida del modelo, serving, observabilidad, gobernanza y operaciones de costes en un bucle repetible.
¿Qué es una plataforma de fábrica de IA?
Una plataforma de fábrica de IA es la infraestructura y la pila de software que se usa para ejecutar ese bucle. Puede incluir clústeres de GPU, almacenamiento, red, programadores, pipelines de datos, registros de modelos, endpoints de serving, monitorización, gobernanza, controles de costes y pasarelas de modelos/API.
¿Qué es una fábrica de IA de NVIDIA?
En el marco de NVIDIA, una fábrica de IA es una infraestructura acelerada que convierte datos empresariales en inteligencia usando GPU, redes, software y arquitecturas de referencia. La conclusión útil es que una fábrica de IA necesita una pila completa alrededor de las GPU: datos, modelos, despliegue, observabilidad y operaciones.
¿Qué es una fábrica de IA de NVIDIA Jensen Huang?
Cuando Jensen Huang habla de fábricas de IA, normalmente describe el cambio de los centros de datos tradicionales que almacenan y sirven información a centros de datos acelerados que producen tokens, predicciones o inteligencia. Para los operadores, esa visión aún debe traducirse en dimensionamiento de cargas de trabajo, gobernanza de datos, serving de modelos y controles de costes.
¿Qué es una fábrica de IA en el contexto empresarial?
En el contexto empresarial, una fábrica de IA es una capacidad repetible para lanzar y mejorar funciones de IA. Proporciona a los equipos una forma controlada de transformar los datos de la empresa y la capacidad de modelos externos en flujos de trabajo útiles, mientras se hace seguimiento de la calidad, el coste, el riesgo y la responsabilidad.
Conclusión
¿Qué es una fábrica de IA? Es el sistema de producción que convierte la IA de experimentos aislados en una capacidad operativa. Los clústeres de GPU son importantes, pero solo son una capa. La fábrica también necesita pipelines de datos, gestión del ciclo de vida del modelo, serving, enrutamiento, evaluación, gobernanza y controles financieros.
Para cargas de trabajo que requieren modelos personalizados o control directo del hardware, planifique toda la pila de la fábrica de IA antes de comprar capacidad. Para cargas de trabajo que pueden usar API y herramientas de modelos oficiales, Flatkey puede ofrecer una ruta más sencilla: una clave, un saldo, una factura y enrutamiento entre modelos y herramientas de pago por llamada, mientras su equipo aprende qué cargas de trabajo necesitan realmente su propia fábrica.
Fuentes y lecturas adicionales
- NVIDIA: AI Factory
- NVIDIA Docs: AI Factory Design Overview
- Dell Technologies: Dell AI Factory with NVIDIA
- HPE: What is an AI factory?
- Flatkey: TCO de clústeres de GPU
- Flatkey: Nube de GPU vs API de modelo