La tarification des API de génération d’images semble simple jusqu’à ce qu’une équipe tente de comparer de vraies factures. OpenAI facture le travail d’image avec des lignes distinctes pour les jetons d’image et de texte, des règles d’entrée mise en cache et des tarifs de sortie spécifiques au modèle. Google sépare les routes Gemini image, les routes Imagen et les surfaces tarifaires Vertex AI. fal propose un catalogue au style place de marché avec paiement à l’usage, où l’unité peut être des générations, des mégapixels, des crédits, des secondes ou du temps GPU.
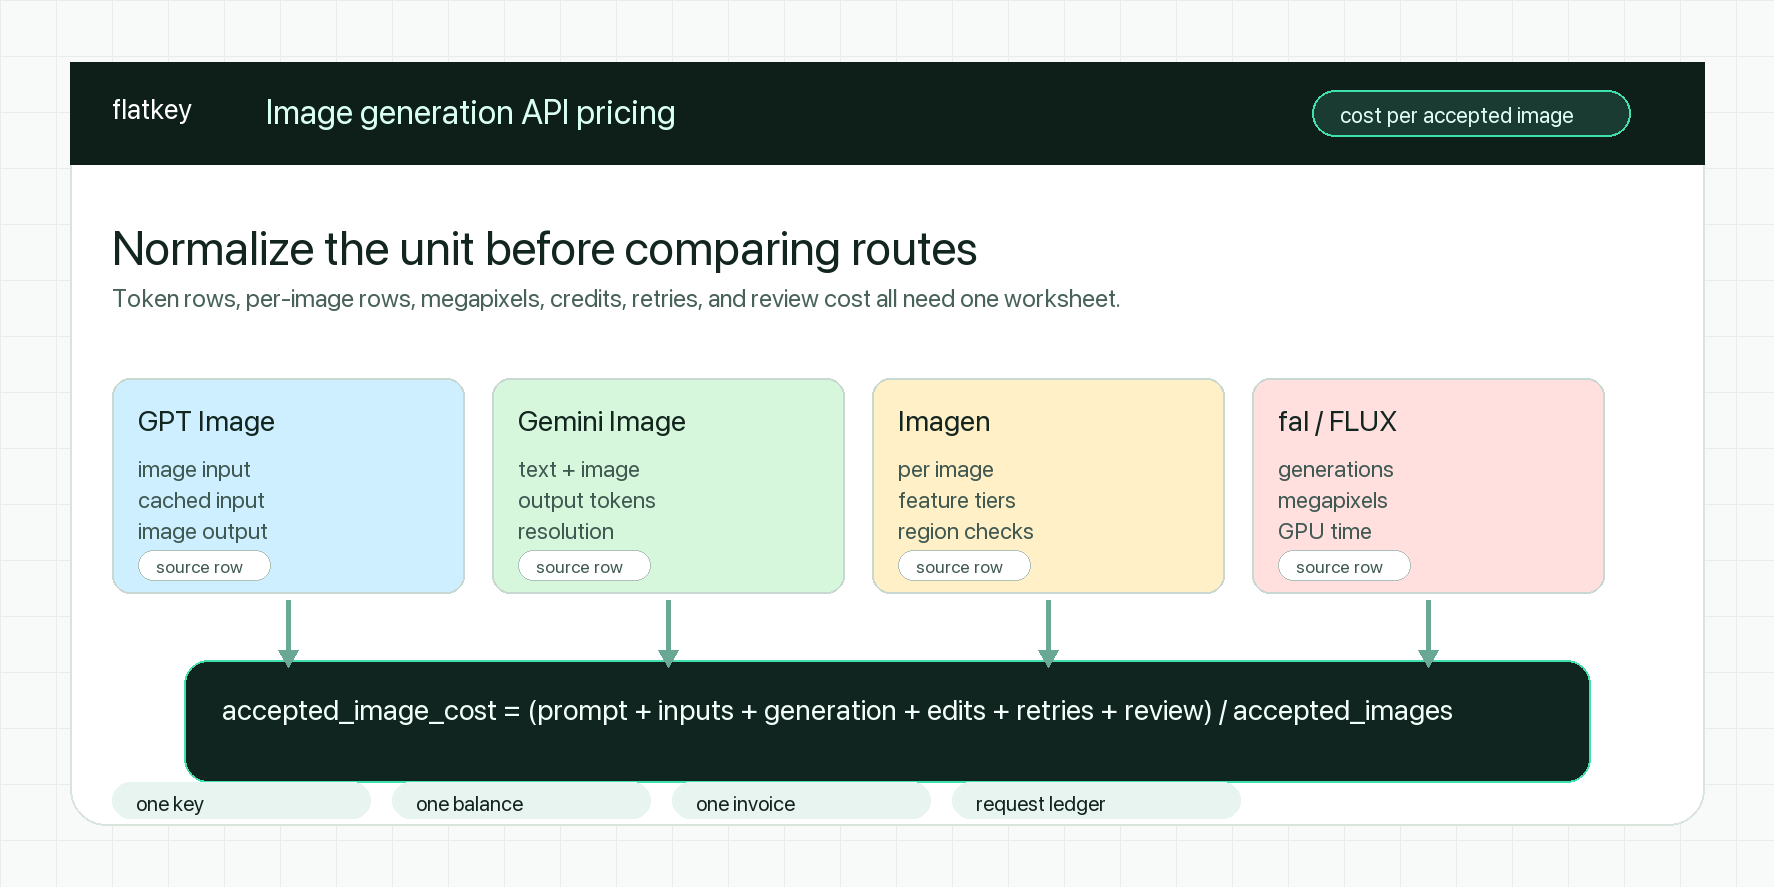
C’est pourquoi une comparaison de image generation api pricing ne devrait pas commencer par l’affirmation universelle du « modèle le moins cher ». La comparaison utile est le coût par image acceptée : le coût total du texte du prompt, des images de référence, de la génération de sortie, des retouches, des nouvelles tentatives, des rejets de sécurité, des upscales et de la relecture manuelle, divisé par le nombre d’images que votre flux de travail peut réellement livrer.
Ce guide s’adresse aux développeurs, aux équipes produit et aux équipes achats qui comparent la tarification des API de génération d’images entre OpenAI GPT Image, Google Gemini Image, Google Imagen, des routes de type fal/FLUX et une couche API multi-fournisseurs comme Flatkey. Les sources ont été vérifiées le 13 octobre 2026. Considérez chaque ligne de prix comme une donnée de planification à un instant donné et revérifiez la page officielle du fournisseur avant un déploiement en production.
Réponse rapide : normalisez d’abord les unités tarifaires
Utilisez ce tableau avant de comparer les lignes de tarification des API de génération d’images.
| Route du fournisseur | Forme de tarification publique à normaliser | Ce qui modifie généralement la facture |
|---|---|---|
| OpenAI GPT Image | Lignes pour l’entrée d’image, l’entrée d’image mise en cache, la sortie d’image et les jetons de texte, selon le modèle | Version du modèle, niveau de qualité, taille de sortie, API Images directe vs API Responses, modifications, masques, images de référence et images partielles diffusées en streaming |
| Google Gemini Image | Tarification en jetons du modèle Gemini plus des lignes de sortie image ou équivalent image | Modèle actuel vs aperçu, sortie 1K/2K/4K, images d’entrée, grounding, mode batch/flex et cycle de vie du modèle |
| Google Imagen | Par image générée ou lignes d’image spécifiques aux fonctionnalités via les surfaces Google AI / Vertex AI | Offres rapide, standard et premium ; retouche, upscaling, recontextualisation de produit, région et disponibilité de l’endpoint |
| fal / marketplace de modèles | Par génération, par mégapixel, crédits, secondes ou temps GPU selon la page du modèle | Choix du modèle, résolution, options LoRA ou fine-tune, mode file d’attente, tâches échouées et déploiement de votre propre modèle |
| Route Flatkey | Ligne modèle au niveau de la route, registre des requêtes, un seul solde et une seule facture | L’unité de facturation du fournisseur reste importante, mais les preuves d’utilisation et la réconciliation restent centralisées |
La métrique de la feuille de calcul est :
accepted_image_cost =
  (prompt_text_cost
  + input_image_cost
  + generation_cost
  + edit_or_upscale_cost
  + retry_cost
  + human_review_or_retouch_cost)
  / accepted_images
Pour les workflows créatifs, le mot « acceptée » est important. Si une génération à 0,04 $ a un taux d’acceptation de 35 % et qu’une génération à 0,08 $ a un taux d’acceptation de 75 %, la deuxième route peut être moins chère pour l’asset final même si le prix affiché est plus élevé.
Comparaison de la tarification des API de génération d’images
La comparaison ci-dessous est volontairement compacte. Elle montre comment lire chaque surface tarifaire, et non un tableau maître obsolète qui serait faux dès qu’une famille de modèles change.
| Famille de routes | Preuve tarifaire actuelle vérifiée | Meilleur cas d’usage de départ | Avertissement achats |
|---|---|---|---|
| GPT Image | Le tableau tarifaire d’OpenAI liste les lignes actuelles du modèle GPT Image, y compris les prix de l’entrée d’image, de l’entrée d’image mise en cache et de la sortie d’image par 1M de jetons. Le guide image renvoie aussi les lecteurs vers un calculateur de coût pour la génération d’images. | Images héro de produit, retouches, travail sur fond transparent et workflows où le contrôle de la sortie mérite d’être mesuré avec soin | Ne comparez pas un échantillon de faible qualité à la sortie premium d’un autre fournisseur. Les règles d’entrée mise en cache de l’API Responses ne s’appliquent pas à tous les chemins d’endpoint image. |
| Gemini Image | La page de tarification de Google AI liste la tarification actuelle des modèles Gemini et les pages de modèle pour les routes image Gemini. D’anciens IDs de modèles en aperçu ou obsolètes peuvent encore apparaître dans de vieux exemples. | Applications multimodales où la génération d’images se situe près de la compréhension d’images, du raisonnement sur les prompts ou d’une logique de workflow Gemini plus large | Incluez les images d’entrée, la résolution de sortie, le grounding et l’éligibilité batch/flex avant de le déclarer moins cher. |
| Imagen | La tarification Google Cloud Vertex AI est la source officielle de planification pour les lignes Imagen hébergées sur Vertex et les familles de fonctionnalités. | Génération de campagnes prévisibles, images de produits et équipes qui préfèrent un budget par image | La tarification par image est plus simple à expliquer, mais la région, l’endpoint, la prise en charge des fonctionnalités et le cycle de vie du modèle doivent toujours être vérifiés. |
| fal / routes de type FLUX | La page de tarification de fal décrit des API de modèles pay-per-use et la tarification GPU serverless, tandis que les pages de modèle individuelles exposent l’unité de facturation exacte de chaque route. | Équipes qui ont besoin d’un large accès à une place de marché de modèles, de modèles média ouverts, d’expérimentations rapides ou d’une inférence personnalisée serverless | Les unités varient selon le modèle. Une ligne par génération, une ligne par mégapixel et une ligne par heure GPU ne doivent pas être comparées sans spécification de tâche. |
| Flatkey | La source produit de Flatkey positionne une seule clé, un seul solde, une seule facture et des preuves d’utilisation au niveau des requêtes pour les modèles et outils pris en charge. | Équipes testant plusieurs familles de modèles sans gérer des clés et factures séparées chez chaque fournisseur | Flatkey simplifie le routage et les preuves de facturation ; il ne supprime pas la nécessité de vérifier l’unité du modèle source et le prix spécifique à la route. |
Tarification de GPT Image : les lignes de jetons ont besoin d’un cahier des charges
La tarification des images d’OpenAI ne se limite plus à un simple nombre « par image ». La page de tarification actuelle liste les lignes du modèle GPT Image par modalité. Par exemple, les lignes actuelles de GPT Image 2 exposent les prix de l’entrée d’image, de l’entrée d’image mise en cache et de la sortie d’image, tandis que l’entrée texte a sa propre ligne. Le point pratique n’est pas seulement le prix exact ; c’est qu’une image générée peut inclure plus d’un composant tarifé.
Avant de comparer GPT Image avec Gemini ou Imagen, créez un cahier des charges :
route_family: openai_gpt_image
model: gpt-image-2_or_other_current_model
endpoint_surface: images_api_or_responses_api
task: product_hero | marketplace_image | ad_variant | edit | transparent_background
output_size: 1024x1024 | 1536x1024 | 4k_if_supported
quality: low | medium | high | provider_specific_setting
reference_images: count_and_resolution
edits_or_masks: yes_or_no
streamed_partial_images: yes_or_no
accepted_images_required: number
max_attempts_per_image: number
Comparez ensuite les enregistrements réels de requêtes, et pas seulement les lignes du tableau. Un flux de retouche fortement basé sur des images de référence peut avoir une économie différente de celle d’un lot propre texte-vers-image. Une interface créative en streaming peut aussi produire des sorties partielles qui doivent entrer dans le budget.
GPT Image vaut souvent la peine d’être testé en premier lorsque le contrôle qualité est coûteux : fidélité des formes de produit, fonds transparents, continuité des retouches, images de campagne conformes à la marque, ou cas où une retouche manuelle annulerait les économies d’un parcours de génération moins cher.
Tarification des images Gemini : inclure les images d’entrée, la résolution et le cycle de vie
La tarification des images Gemini peut être mal interprétée lorsque les équipes ne regardent que l’exemple de sortie. Un flux de travail Gemini peut inclure du texte de prompt, des images d’entrée, la sortie d’image, une sortie en plus haute résolution, le grounding et des choix batch/flex. Google modifie aussi le statut des modèles au fil du temps, donc une page de modèle actuelle compte autant qu’un tableau tarifaire.
Utilisez cette liste de contrôle pour les routes d’images Gemini :
| Vérification | Pourquoi c’est important |
|---|---|
| ID exact du modèle | Les IDs des modèles en aperçu, obsolètes et actuels peuvent avoir des disponibilités et des tarifs différents. |
| Résolution de sortie | Un aperçu créatif en 1K/2K et un asset final en 4K doivent être prévus séparément. |
| Images d’entrée | Les images de référence et les images produit peuvent modifier le coût effectif. |
| Grounding ou recherche | Le grounding peut ajouter un coût distinct lorsqu’il est utilisé. |
| Mode batch ou flex | Les modes moins coûteux peuvent ne pas correspondre à la latence d’une revue créative interactive. |
| Taux d’acceptation | Une forte adéquation multimodale peut réduire les sorties rejetées même si l’unité affichée n’est pas la moins chère. |
Gemini est un bon candidat lorsque la génération d’images fait partie d’un produit multimodal plus large : compréhension d’images, raisonnement sur les prompts, références téléchargées par le client et variantes créatives générées dans un seul flux. La comparaison est moins pertinente si vous n’avez besoin que d’un simple lot d’images et que vous n’utilisez jamais la capacité multimodale environnante.
Pour la tarification de l’API de génération d’images, la leçon Gemini est simple : ne séparez pas le coût de sortie d’image du contexte multimodal qui crée l’image.
Tarification d’Imagen : prévisions plus simples, mais pas automatiques
La tarification à la manière d’Imagen est plus simple pour les équipes financières, car de nombreuses lignes de planification peuvent s’exprimer par image générée ou par famille de fonctionnalités. Cela rend les prévisions de campagne plus claires :
monthly_imagen_budget =
  accepted_images_required
  * attempts_per_accepted_image
  * price_per_generated_image
  + feature_specific_costs
La simplicité aide, mais elle n’élimine pas les vérifications de production. Confirmez :
- Le modèle Imagen exact ou la famille de fonctionnalités.
- Si la route est accessible via l’API Gemini, Vertex AI ou une autre surface fournisseur.
- La disponibilité par région et par compte.
- Si votre flux de travail nécessite la génération, l’édition, l’upscaling, l’essayage virtuel ou la recontextualisation de produits.
- Le statut actuel du cycle de vie et les notes de migration.
- Si la route Flatkey sélectionnée expose l’endpoint que votre application appelle réellement.
Imagen est souvent un bon premier test pour des variantes de campagnes en volume, des images de produits e-commerce et des équipes qui veulent une prévision par image plus facile à gérer financièrement. Mais une ligne moins chère par image peut perdre si le taux d’acceptation est plus faible ou si l’ensemble de fonctionnalités impose davantage de retouches.
fal et les routes de marketplace : comparez l’unité, pas seulement le nom du modèle
Les plateformes d’API d’images de type marketplace sont utiles parce qu’elles exposent rapidement de nombreux modèles de médias. Le compromis est que chaque route peut avoir sa propre grammaire de facturation. Une page peut facturer par génération. Une autre peut facturer par mégapixel. Une autre peut facturer des crédits, des secondes ou du temps GPU serverless.
Pour les routes de type fal/FLUX, construisez une ligne comme celle-ci :
| Champ | Valeur d’exemple |
|---|---|
| URL de la page du modèle | La route exacte que vous allez appeler |
| Unité de facturation | Génération, mégapixel, crédit, seconde ou heure GPU |
| Résolution | Pixels de sortie finaux, pas seulement le paramètre du prompt |
| Mode de file d’attente | Interactif ou batch |
| Facturation en cas d’échec | Si les tâches échouées, les annulations ou les blocages de sécurité sont facturés |
| Nombre de variantes | Nombre de sorties par prompt |
| Taux d’acceptation | Actifs finaux acceptés divisés par actifs générés |
Cela compte parce qu’un modèle de marketplace peut sembler bon marché à une résolution donnée et devenir moins intéressant après les upscales, les variantes, les tentatives répétées et la revue humaine. L’accès via marketplace est précieux pour les tests ; les achats doivent néanmoins s’appuyer sur des unités normalisées.
La feuille de calcul du coût par image acceptée
Utilisez cette feuille de calcul avant de mettre en production le trafic.
| Champ de la feuille de calcul | GPT Image | Gemini Image | Imagen | fal / marketplace |
|---|---|---|---|---|
| Texte du prompt | Inclure une ligne pour les jetons de texte | Inclure une ligne pour les jetons de texte | Vérifier la surface du fournisseur | Généralement inclus dans l’unité de route, mais à vérifier |
| Images de référence | Inclure une ligne pour l’entrée image | Inclure une ligne pour l’entrée image | Vérifier l’unité d’entrée propre à la fonctionnalité | Vérifier si c’est facturé séparément |
| Unité de génération | Jetons de sortie image par modèle | Sortie image ou ligne de jetons du modèle | Image générée / ligne de fonctionnalité | Génération, mégapixel, crédit, seconde ou temps GPU |
| Modifications / suréchantillonnages | Inclure si séparé | Inclure si séparé | Spécifique à la fonctionnalité | Spécifique au modèle |
| Essais par image acceptée | Mesurer en pilote | Mesurer en pilote | Mesurer en pilote | Mesurer en pilote |
| Relecture humaine / retouche | Inclure la main-d’œuvre si cela a du sens | Inclure la main-d’œuvre si cela a du sens | Inclure la main-d’œuvre si cela a du sens | Inclure la main-d’œuvre si cela a du sens |
| Métrique de comparaison finale | Coût par image acceptée | Coût par image acceptée | Coût par image acceptée | Coût par image acceptée |
Définissez ce que signifie « acceptée » avant le lancement du pilote. Pour un workflow e-commerce ou média, acceptée peut signifier :
- L’image passe la revue créative.
- La forme, la couleur et l’emballage du produit sont corrects.
- Aucun texte, main, anatomie, visage, logo ou défaut de sécurité ne nécessite de retouche.
- Le résultat respecte les règles de la place de marché ou de la plateforme publicitaire.
- L’asset est approuvé dans le budget de tentatives autorisé.
Cela transforme le pricing des API de génération d’images d’un simple exercice de lecture de tableau en une métrique opérationnelle.
Exemple de prévision
Supposons qu’une campagne ait besoin de 500 images acceptées.
| Route | Coût de génération affiché | Essais par image acceptée | Logique globale du coût par image acceptée |
|---|---|---|---|
| Route A | Unité affichée plus basse | 3,0 essais | Peut revenir plus cher après les sorties rejetées et la retouche |
| Route B | Unité affichée moyenne | 1,8 essai | Peut l’emporter si le respect du prompt et la continuité des modifications sont meilleurs |
| Route C | Unité affichée plus élevée | 1,3 essai | Peut encore l’emporter pour des assets vedettes à forte valeur si le temps de revue baisse |
La prévision est :
campaign_cost =
  accepted_images_required
  * attempts_per_accepted_image
  * all_in_cost_per_attempt
  + human_review_or_retouch_cost
Réalisez un pilote de 30 à 50 images avant qu’achats ne considère une route comme moins chère. Le pilote doit utiliser le même jeu de prompts, les mêmes images de référence, les mêmes exigences de taille et les mêmes règles de relecteur pour chaque route.
Comment Flatkey aide au contrôle des tarifs
Le rôle de Flatkey n’est pas d’affirmer qu’un fournisseur est universellement moins cher. Sa valeur est opérationnelle : une clé, un solde prépayé, une facture et des preuves d’utilisation au niveau des routes sur les modèles et outils pris en charge. Cela aide les développeurs et les équipes finance à comparer le pricing des API de génération d’images sans disperser les clés des fournisseurs entre les agents, services et environnements.
Avant de faire passer le trafic par une couche d’API multi-fournisseurs, vérifiez :
- Le modèle apparaît dans l’annuaire des modèles ou la page de tarification de Flatkey.
- La famille d’endpoint correspond à votre chemin d’application.
- La ligne de tarification et l’unité du fournisseur sont à jour.
- Le registre des requêtes enregistre l’ID du modèle, la route, le nombre d’unités, le coût, le statut et l’ID de requête.
- Les échecs côté Flatkey, les échecs côté fournisseur, les sorties créatives rejetées et les rejets de relecture humaine sont tagués séparément.
- Le responsable financier peut rapprocher l’utilisation avec une seule facture.
Pour les décisions de route adjacentes, lisez le guide GPT Image vs Gemini Image API, la check-list de tarification et de routage de l’API Imagen, ainsi que la comparaison plus large des tarifs des modèles IA.
Quand chaque modèle de tarification l’emporte
| Scénario | Meilleur point de départ | Pourquoi |
|---|---|---|
| Images produit strictes vedettes | GPT Image ou route image de type Gemini Pro | La qualité de sortie, la continuité des modifications et un plus faible nombre d’images rejetées peuvent compenser un coût affiché plus élevé. |
| Application créative multimodale | Gemini Image | La génération peut se situer près de la compréhension d’images et du raisonnement texte/image. |
| Variantes de campagne en volume | Imagen fast/standard ou routes marketplace | Les unités par image ou spécifiques à la route peuvent être plus faciles à prévoir à grande échelle. |
| Expérimentation de modèles | Routes fal / marketplace | Un large catalogue d’accès aide les équipes à comparer le style, la vitesse et le taux d’acceptation. |
| La finance a besoin d’un seul registre | Comparaison des routes Flatkey | Un seul solde et une seule facture réduisent le travail de rapprochement entre les expérimentations de fournisseurs. |
Erreurs courantes de tarification
Évitez ces erreurs lorsque vous comparez le pricing des API de génération d’images :
- Comparer le chemin bas coût d’un fournisseur avec le chemin haute qualité d’un autre fournisseur.
- Ignorer le coût d’entrée des images de référence.
- Considérer des ID de modèle de préversion ou obsolètes comme des routes de production.
- Oublier les tentatives, les rejets liés à la sécurité et les retouches manuelles.
- Mesurer le coût par image générée au lieu du coût par image acceptée.
- Mélanger les prix directs du fournisseur avec les prix via routage sans indiquer la source.
- Supposer que le point de terminaison prend en charge les modifications, les masques, les arrière-plans transparents ou la sortie 4K sans test de validation rapide.
- Laisser chaque équipe produit acheter des crédits fournisseur séparés sans registre partagé.
Références officielles de tarification
Consultez ces pages avant le déploiement en production :
- Tarification de l’API OpenAI
- Guide de génération d’images OpenAI
- Tarification de l’API Google AI Gemini
- Tarification de l’IA générative Google Cloud Vertex AI
- Tarification de fal
- Tarification de Flatkey
- Répertoire des modèles Flatkey
FAQ
Quelle est la meilleure façon de comparer la tarification des API de génération d’images ?
Comparez le coût par image acceptée. Normalisez le texte du prompt, les images d’entrée, l’unité de génération, la résolution, la qualité, les tentatives, les sorties rejetées et le coût de revue avant de décider quelle route est la moins chère.
GPT Image est-il facturé par image ou par jeton ?
L’interface tarifaire actuelle d’OpenAI inclut des lignes pour les images et les jetons de texte pour les modèles GPT Image. Considérez les estimations d’images d’exemple comme des aides à la planification et vérifiez l’utilisation réelle pour votre point de terminaison et votre charge de travail.
Gemini Image est-il moins cher que GPT Image ?
Pas automatiquement. Gemini Image peut être intéressant pour les workflows multimodaux, mais les images d’entrée, la résolution de sortie, l’ancrage, le mode batch et le taux d’acceptation peuvent modifier le coût final.
Imagen est-il plus facile à budgéter ?
Souvent, oui. Les routes de type Imagen peuvent être plus faciles à prévoir, car de nombreuses lignes de planification sont par image générée ou par famille de fonctionnalités. Vous devez quand même vérifier le statut du modèle, le point de terminaison, la région, la prise en charge des fonctionnalités et le taux d’acceptation.
Comment les achats doivent-ils comparer fal ou les routes de marketplace ?
Utilisez la page exacte du modèle et l’unité de facturation. Une route de marketplace facturée par génération ne doit pas être comparée directement à une autre route facturée par mégapixel, crédit, seconde ou heure GPU tant que les deux n’ont pas été normalisées en coût par image acceptée.
Comment Flatkey aide-t-il à contrôler la tarification des API de génération d’images ?
Flatkey donne aux équipes une seule clé, un seul solde, une seule facture et des preuves d’utilisation au niveau des requêtes sur les routes prises en charge. Cela facilite les tests comparatifs entre fournisseurs et la réconciliation tout en conservant la nécessité de vérifier l’unité de chaque fournisseur source.
En bref
La comparaison pratique de la tarification des api de génération d’images n’est pas un tableau statique du modèle le moins cher. GPT Image, Gemini Image, Imagen et les routes de marketplace exposent tous des unités différentes. Normalisez-les en coût par image acceptée, lancez un petit pilote avec les mêmes prompts et les mêmes règles d’évaluation, puis utilisez le répertoire de modèles, la page de tarification et le registre d’utilisation de Flatkey pour contrôler le routage et les dépenses avant que le trafic de production ne monte en charge.