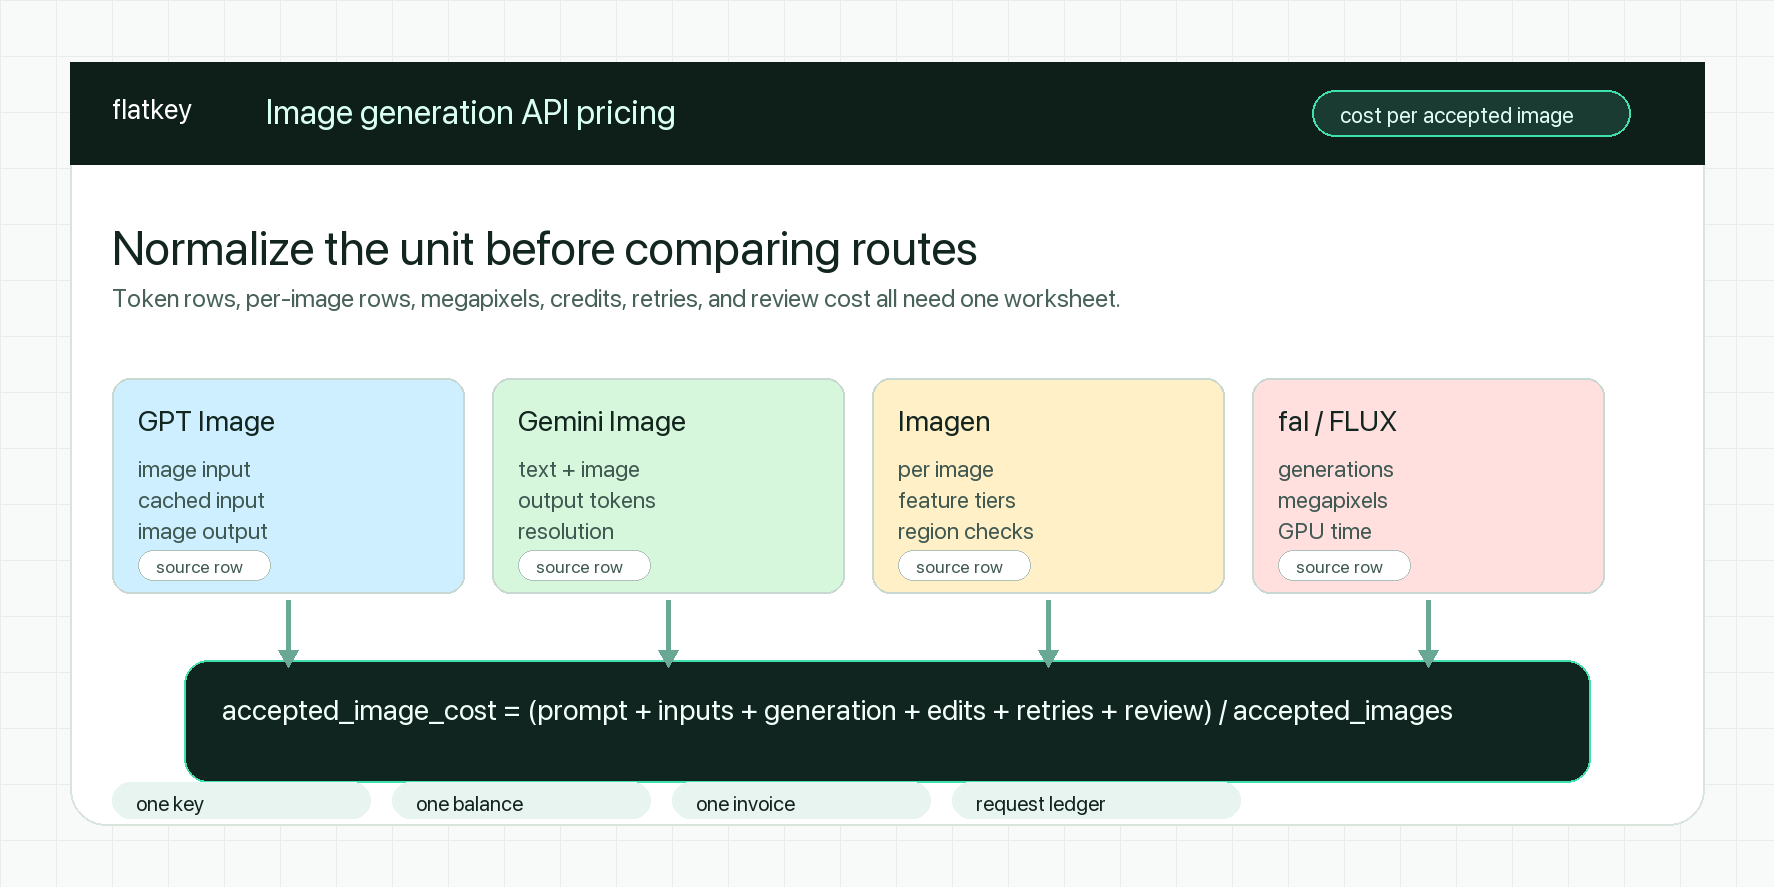
Los precios de las API de generación de imágenes parecen sencillos hasta que un equipo intenta comparar facturas reales. OpenAI fija el precio del trabajo con imágenes mediante filas de tokens de imagen y texto, reglas de entrada en caché y tarifas de salida específicas por modelo. Google separa las rutas de imágenes de Gemini, las rutas de Imagen y las superficies de precios de Vertex AI. fal expone un catálogo de pago por uso con estilo de marketplace, donde la unidad puede ser generaciones, megapíxeles, créditos, segundos o tiempo de GPU.
Por eso una comparación de image generation api pricing no debería empezar con una afirmación universal de "el modelo más barato". La comparación útil es el coste por imagen aceptada: el coste total del texto del prompt, las imágenes de referencia, la generación de salida, las ediciones, los reintentos, los rechazos de seguridad, los aumentos de escala y la revisión manual dividido entre las imágenes que tu flujo de trabajo realmente puede enviar.
Esta guía está dirigida a desarrolladores, equipos de producto y equipos de compras que comparan precios de API de generación de imágenes entre OpenAI GPT Image, Google Gemini Image, Google Imagen, rutas estilo fal/FLUX y una capa de API multisitio como Flatkey. Las fuentes se comprobaron el 13 de octubre de 2026. Trata cada fila de precios como datos de planificación en un momento concreto y vuelve a revisar la página oficial del proveedor antes de un despliegue en producción.
Respuesta rápida: normaliza primero las unidades de precios
Usa esta tabla antes de comparar filas de precios de API de generación de imágenes.
| Ruta del proveedor | Forma pública de precios que hay que normalizar | Qué suele cambiar la factura |
|---|---|---|
| OpenAI GPT Image | Filas de entrada de imagen, entrada de imagen en caché, salida de imagen y tokens de texto por modelo | Versión del modelo, nivel de calidad, tamaño de salida, API de Images directa frente a API de Responses, ediciones, máscaras, imágenes de referencia e imágenes parciales en streaming |
| Google Gemini Image | Precios por tokens del modelo Gemini más filas de salida de imagen o equivalentes a imagen | Modelo actual frente a vista previa, salida 1K/2K/4K, imágenes de entrada, grounding, modo batch/flex y ciclo de vida del modelo |
| Google Imagen | Por imagen generada o filas de imagen específicas de funciones a través de las superficies de Google AI / Vertex AI | Niveles fast, standard y premium; edición, upscaling, recontextualización de productos, región y disponibilidad del endpoint |
| fal / marketplace de modelos | Por generación, por megapíxel, créditos, segundos o tiempo de GPU según la página del modelo | Elección del modelo, resolución, opciones de LoRA o fine-tune, modo cola, trabajos fallidos y si despliegas tu propio modelo |
| Ruta de Flatkey | Fila de modelo a nivel de ruta, libro mayor de solicitudes, un saldo y una factura | La unidad de facturación del proveedor sigue importando, pero las pruebas de uso y la conciliación se mantienen en un solo lugar |
La métrica de la hoja de cálculo es:
accepted_image_cost =
  (prompt_text_cost
  + input_image_cost
  + generation_cost
  + edit_or_upscale_cost
  + retry_cost
  + human_review_or_retouch_cost)
  / accepted_images
Para flujos creativos, "aceptada" es la palabra importante. Si una generación de 0,04 $ tiene una tasa de aceptación del 35 % y una generación de 0,08 $ tiene una tasa de aceptación del 75 %, la segunda ruta puede ser más barata para el activo final aunque el precio visible sea más alto.
Comparación de precios de API de generación de imágenes
La comparación siguiente es deliberadamente compacta. Muestra cómo leer cada superficie de precios, no una tabla maestra obsoleta que estará mal la próxima vez que cambie una familia de modelos.
| Familia de rutas | Evidencia de precios actual revisada | Mejor caso de uso inicial | Advertencia para compras |
|---|---|---|---|
| GPT Image | La tabla de precios de OpenAI enumera las filas actuales del modelo GPT Image, incluidos los precios de entrada de imagen, entrada de imagen en caché y salida de imagen por 1M tokens. La guía de imágenes también dirige a los lectores a una calculadora de costes para la generación de imágenes. | Imágenes principales de producto, ediciones, trabajo con fondo transparente y flujos donde merece la pena medir con cuidado el control de la salida | No compares una muestra de baja calidad con la salida premium de otro proveedor. Las reglas de entrada en caché de la API de Responses no se aplican a todas las rutas de endpoint de imagen. |
| Gemini Image | La página de precios de Google AI enumera los precios actuales de los modelos Gemini y las páginas de modelo para las rutas de imagen de Gemini. Los antiguos IDs de modelos de vista previa o en desuso todavía pueden aparecer en ejemplos antiguos. | Aplicaciones multimodales en las que la generación de imágenes está cerca de la comprensión de imágenes, el razonamiento del prompt o una lógica de flujo de trabajo más amplia de Gemini | Incluye las imágenes de entrada, la resolución de salida, grounding y la elegibilidad de batch/flex antes de llamar al servicio más barato. |
| Imagen | Los precios de Google Cloud Vertex AI son la fuente autoritativa de planificación para las filas de Imagen alojadas en Vertex y las familias de funciones. | Generación de campañas predecible, imágenes de producto y equipos que prefieren presupuestos por imagen | El precio por imagen es más fácil de explicar, pero la región, el endpoint, la compatibilidad de funciones y el ciclo de vida del modelo siguen necesitando verificación. |
| fal / rutas estilo FLUX | La página de precios de fal describe APIs de modelos de pago por uso y precios de GPU sin servidor, mientras que las páginas de modelos individuales exponen la unidad de facturación exacta para cada ruta. | Equipos que necesitan acceso amplio al marketplace de modelos, modelos de medios abiertos, experimentos rápidos o inferencia personalizada sin servidor | Las unidades varían según el modelo. Una fila por generación, una fila por megapíxel y una fila por hora de GPU no deben compararse sin una especificación del trabajo. |
| Flatkey | La fuente del producto de Flatkey posiciona una clave, un saldo, una factura y pruebas de uso a nivel de solicitud en los modelos y herramientas compatibles. | Equipos que prueban varias familias de modelos sin gestionar claves e facturas separadas de cada proveedor | Flatkey simplifica el enrutamiento y las pruebas de facturación; no elimina la necesidad de verificar la unidad del modelo de origen y el precio específico de la ruta. |
Precios de GPT Image: las filas de tokens necesitan una especificación de trabajo
Los precios de imágenes de OpenAI han dejado de ser una simple cifra de "por imagen". La página actual de precios enumera las filas del modelo GPT Image por modalidad. Por ejemplo, las filas actuales de GPT Image 2 muestran precios para entrada de imagen, entrada de imagen en caché y salida de imagen, mientras que la entrada de texto tiene su propia fila. El punto práctico no es solo el precio exacto; es que una imagen generada puede incluir más de un componente facturable.
Antes de comparar GPT Image con Gemini o Imagen, crea una especificación de trabajo:
route_family: openai_gpt_image
model: gpt-image-2_or_other_current_model
endpoint_surface: images_api_or_responses_api
task: product_hero | marketplace_image | ad_variant | edit | transparent_background
output_size: 1024x1024 | 1536x1024 | 4k_if_supported
quality: low | medium | high | provider_specific_setting
reference_images: count_and_resolution
edits_or_masks: yes_or_no
streamed_partial_images: yes_or_no
accepted_images_required: number
max_attempts_per_image: number
Luego compara los registros reales de solicitudes, no solo las filas de la tabla. Un flujo de edición con muchas imágenes de referencia puede tener una economía distinta a un lote limpio de texto a imagen. Una interfaz creativa en streaming también puede producir salidas parciales que entran en el presupuesto.
A menudo vale la pena probar GPT Image primero cuando el control de calidad es costoso: fidelidad de la forma del producto, fondos transparentes, continuidad en las ediciones, imágenes de campañas seguras para la marca o casos en los que el retoque manual borraría el ahorro de una ruta de generación más barata.
Precios de imágenes de Gemini: incluye imágenes de entrada, resolución y ciclo de vida
Los precios de Gemini Image pueden interpretarse mal cuando los equipos solo miran el ejemplo de salida. Un flujo de trabajo de Gemini puede incluir texto del prompt, imágenes de entrada, salida de imagen, salida de mayor resolución, grounding y opciones de batch o flex. Google también cambia el estado del modelo con el tiempo, por lo que una página actual del modelo importa tanto como una tabla de precios.
Usa esta lista de verificación para las rutas de imagen de Gemini:
| Comprobación | Por qué importa |
|---|---|
| ID exacto del modelo | Las versiones preview, obsoletas y actuales pueden tener distinta disponibilidad y precios. |
| Resolución de salida | Una vista creativa preliminar en 1K/2K y un recurso final en 4K deben proyectarse por separado. |
| Imágenes de entrada | Las imágenes de referencia y de producto pueden cambiar el coste efectivo. |
| Grounding o búsqueda | El grounding puede añadir un coste separado cuando se usa. |
| Modo batch o flex | Los modos de menor coste pueden no coincidir con la latencia de revisión creativa interactiva. |
| Tasa de aceptación | Un fuerte ajuste multimodal puede reducir las salidas rechazadas incluso si la unidad indicada no es la más baja. |
Gemini es un buen candidato cuando la generación de imágenes forma parte de un producto multimodal más amplio: comprensión de imágenes, razonamiento sobre prompts, referencias subidas por clientes y variantes creativas generadas en un solo flujo. Es menos limpio como comparación si solo necesitas un lote sencillo de imágenes y nunca usas la capacidad multimodal circundante.
Para precios de API de generación de imágenes, la lección de Gemini es sencilla: no separes el coste de salida de imagen del contexto multimodal que crea la imagen.
Precios de Imagen: previsión más fácil, pero no automática
Los precios al estilo Imagen son más fáciles para los equipos financieros porque muchas filas de planificación pueden expresarse por imagen generada o por familia de funciones. Eso hace que la previsión de campañas sea más clara:
monthly_imagen_budget =
  accepted_images_required
  * attempts_per_accepted_image
  * price_per_generated_image
  + feature_specific_costs
La simplicidad ayuda, pero no elimina las comprobaciones de producción. Confirma:
- El modelo exacto de Imagen o la familia de funciones.
- Si la ruta se accede a través de Gemini API, Vertex AI u otra superficie del proveedor.
- Disponibilidad por región y cuenta.
- Si tu flujo de trabajo necesita generación, edición, escalado, prueba virtual o recontextualización de producto.
- El estado actual del ciclo de vida y las notas de migración.
- Si la ruta Flatkey seleccionada expone el endpoint que realmente llama tu aplicación.
Imagen suele ser una buena primera prueba para variantes de campañas masivas, imágenes de productos de ecommerce y equipos que quieren una previsión por imagen más amigable para finanzas. Pero una fila de menor coste por imagen puede perder si la tasa de aceptación es menor o si el conjunto de funciones obliga a un retoque adicional.
fal y rutas de marketplace: compara la unidad, no solo el nombre del modelo
Las plataformas de API de imágenes tipo marketplace son útiles porque exponen muchos modelos de medios rápidamente. La contrapartida es que cada ruta puede tener su propia gramática de facturación. Una página puede cobrar por generación. Otra puede cobrar por megapíxel. Otra puede cobrar créditos, segundos o tiempo de GPU serverless.
Para rutas estilo fal/FLUX, construye una fila como esta:
| Campo | Valor de ejemplo |
|---|---|
| URL de la página del modelo | La ruta exacta que llamarás |
| Unidad de facturación | Generación, megapíxel, crédito, segundo o hora de GPU |
| Resolución | Píxeles de salida finales, no solo la configuración del prompt |
| Modo de cola | Interactivo o por lotes |
| Facturación por fallo | Si los trabajos fallidos, cancelaciones o bloqueos de seguridad se cobran |
| Cantidad de variantes | Número de salidas por prompt |
| Tasa de aceptación | Activos finales aceptados dividido por activos generados |
Esto importa porque un modelo de marketplace puede parecer barato a una resolución y volverse menos atractivo después de escalados, variantes, reintentos y revisión humana. El acceso al marketplace es valioso para probar; las compras aún necesitan unidades normalizadas.
La hoja de cálculo del coste por imagen aceptada
Use esta hoja de cálculo antes de comprometer tráfico de producción.
| Campo de la hoja de cálculo | GPT Image | Gemini Image | Imagen | fal / marketplace |
|---|---|---|---|---|
| Texto del prompt | Incluya la fila de tokens de texto | Incluya la fila de tokens de texto | Verifique la superficie del proveedor | Normalmente incluido en la unidad de ruta, pero verifique |
| Imágenes de referencia | Incluya la fila de entrada de imagen | Incluya la fila de entrada de imagen | Verifique la unidad de entrada específica de la función | Verifique si se cobra por separado |
| Unidad de generación | Tokens de salida de imagen según el modelo | Salida de imagen o fila de tokens del modelo | Imagen generada / fila de función | Generación, megapíxel, crédito, segundo o tiempo de GPU |
| Ediciones/escalado | Incluya si es aparte | Incluya si es aparte | Específico de la función | Específico del modelo |
| Intentos por imagen aceptada | Mida en el piloto | Mida en el piloto | Mida en el piloto | Mida en el piloto |
| Revisión humana / retoque | Incluya la mano de obra si es significativa | Incluya la mano de obra si es significativa | Incluya la mano de obra si es significativa | Incluya la mano de obra si es significativa |
| Métrica final de comparación | Costo por imagen aceptada | Costo por imagen aceptada | Costo por imagen aceptada | Costo por imagen aceptada |
Defina "aceptada" antes de que comience el piloto. Para un flujo de trabajo de ecommerce o medios, aceptada podría significar:
- La imagen pasa la revisión creativa.
- La forma, el color y el empaque del producto son correctos.
- No hay texto, mano, anatomía, rostro, logotipo o defecto de seguridad que requiera retoque.
- El resultado cumple con las reglas del marketplace o de la plataforma publicitaria.
- El recurso se aprueba dentro del presupuesto de reintentos permitido.
Esto convierte la comparación de precios de API de generación de imágenes de un ejercicio de lectura de tablas en una métrica operativa.
Ejemplo de previsión
Supongamos que una campaña necesita 500 imágenes aceptadas.
| Ruta | Costo de generación publicado | Intentos por imagen aceptada | Lógica integral de imagen aceptada |
|---|---|---|---|
| Ruta A | Unidad de precio de etiqueta más baja | 3.0 intentos | Puede resultar más cara después de las salidas rechazadas y el retoque |
| Ruta B | Unidad de precio de etiqueta media | 1.8 intentos | Puede ganar si el cumplimiento del prompt y la continuidad de edición son mejores |
| Ruta C | Unidad de precio de etiqueta más alta | 1.3 intentos | Aún puede ganar para activos estrella de alto valor si el tiempo de revisión disminuye |
La previsión es:
campaign_cost =
  accepted_images_required
  * attempts_per_accepted_image
  * all_in_cost_per_attempt
  + human_review_or_retouch_cost
Ejecute un piloto de 30 a 50 imágenes antes de que compras considere una ruta como más barata. El piloto debe usar el mismo conjunto de prompts, imágenes de referencia, requisitos de tamaño y reglas de revisión para cada ruta.
Cómo Flatkey ayuda con el control de precios
El papel de Flatkey no es afirmar que un proveedor sea universalmente más barato. Su valor es operativo: una clave, un saldo prepagado, una factura y evidencia de uso por ruta en los modelos y herramientas compatibles. Eso ayuda a los equipos de desarrollo y finanzas a comparar precios de API de generación de imágenes sin dispersar claves de proveedor entre agentes, servicios y entornos.
Antes de mover tráfico a través de una capa de API multi-proveedor, verifique:
- Que el modelo aparezca en el directorio de modelos o en la página de precios de Flatkey.
- Que la familia de endpoint coincida con la ruta de su aplicación.
- Que la fila de precios y la unidad del proveedor estén actualizadas.
- Que el registro de solicitudes capture el ID del modelo, la ruta, el conteo de unidades, el costo, el estado y el ID de solicitud.
- Que los fallos del lado de Flatkey, los fallos del lado del proveedor, las salidas creativas rechazadas y los rechazos de revisión humana estén etiquetados por separado.
- Que el responsable financiero pueda conciliar el uso con una sola factura.
Para decisiones de rutas adyacentes, lea la guía GPT Image vs Gemini Image API, la lista de verificación de precios y enrutamiento de Imagen API y la comparación de precios de modelos de IA más amplia.
Cuándo gana cada modelo de precios
| Escenario | Mejor punto de partida | Por qué |
|---|---|---|
| Imágenes estrictas de producto principal | GPT Image o ruta de imagen estilo Gemini Pro | La calidad de salida, la continuidad de edición y menos imágenes rechazadas pueden superar un costo de etiqueta más bajo. |
| Aplicación creativa multimodal | Gemini Image | La generación puede situarse cerca de la comprensión de imágenes y del razonamiento texto/imagen. |
| Variantes de campaña masiva | Imagen fast/standard o rutas de marketplace | Las unidades por imagen o específicas de la ruta pueden ser más fáciles de prever a escala. |
| Experimentación de modelos | Rutas fal / marketplace | El amplio acceso al catálogo ayuda a los equipos a comparar estilo, velocidad y tasa de aceptación. |
| Finanzas necesita un solo libro mayor | Comparación de rutas de Flatkey | Un saldo y una factura reducen el trabajo de conciliación entre experimentos de proveedores. |
Errores comunes de precios
Evite estos errores al comparar precios de API de generación de imágenes:
- Comparar la ruta de baja calidad de un proveedor con la ruta de alta calidad de otro proveedor.
- Ignorar el coste de entrada de imágenes de referencia.
- Tratar los IDs de modelo de vista previa o depreciados como rutas de producción.
- Olvidar los reintentos, los rechazos de seguridad y el retoque manual.
- Medir el coste por imagen generada en lugar de por imagen aceptada.
- Mezclar precios directos del proveedor con precios enrutados sin etiquetar la fuente.
- Asumir que el endpoint admite ediciones, máscaras, fondos transparentes o salida 4K sin una prueba de humo.
- Permitir que cada equipo de producto compre créditos separados de proveedores sin un libro mayor compartido.
Referencias oficiales de precios
Consulta estas páginas antes del despliegue en producción:
- Precios de la API de OpenAI
- Guía de generación de imágenes de OpenAI
- Precios de la API Gemini de Google AI
- Precios de IA generativa de Google Cloud Vertex AI
- Precios de fal
- Precios de Flatkey
- Directorio de modelos de Flatkey
Preguntas frecuentes
¿Cuál es la mejor manera de comparar los precios de las API de generación de imágenes?
Compara el coste por imagen aceptada. Normaliza el texto del prompt, las imágenes de entrada, la unidad de generación, la resolución, la calidad, los reintentos, las salidas rechazadas y el coste de revisión antes de decidir qué ruta es más barata.
¿GPT Image tiene un precio por imagen o por token?
La superficie de precios actual de OpenAI incluye filas de tokens de imagen y texto para los modelos GPT Image. Trata las estimaciones de imágenes de ejemplo como ayuda para la planificación y verifica el uso real de tu endpoint y carga de trabajo.
¿Gemini Image es más barato que GPT Image?
No automáticamente. Gemini Image puede resultar atractivo para flujos de trabajo multimodales, pero las imágenes de entrada, la resolución de salida, el grounding, el modo por lotes y la tasa de aceptación pueden cambiar el coste final.
¿Es más fácil presupuestar Imagen?
A menudo, sí. Las rutas estilo Imagen pueden ser más fáciles de prever porque muchas filas de planificación son por imagen generada o por familia de funciones. Aun así, debes verificar el estado del modelo, el endpoint, la región, la compatibilidad con funciones y la tasa de aceptación.
¿Cómo debería compras comparar las rutas de fal o de marketplace?
Usa la página exacta del modelo y la unidad de facturación. Una ruta de marketplace con precio por generación no debe compararse directamente con otra ruta con precio por megapíxel, crédito, segundo o hora de GPU hasta que ambas se normalicen en coste por imagen aceptada.
¿Cómo ayuda Flatkey a controlar los precios de la API de generación de imágenes?
Flatkey ofrece a los equipos una sola clave, un solo saldo, una sola factura y evidencia de uso a nivel de solicitud en las rutas compatibles. Eso facilita las pruebas comparativas entre proveedores y la conciliación, al tiempo que se mantiene la necesidad de verificar la unidad de cada proveedor fuente.
Conclusión
La comparación práctica de precios de la api de generación de imágenes no es una tabla estática del modelo más barato. GPT Image, Gemini Image, Imagen y las rutas de marketplace exponen unidades diferentes. Normalízalas en coste por imagen aceptada, ejecuta un pequeño piloto con los mismos prompts y reglas de revisión, y luego usa el directorio de modelos, la página de precios y el libro de uso de Flatkey para controlar el enrutamiento y el gasto antes de que el tráfico de producción escale.