
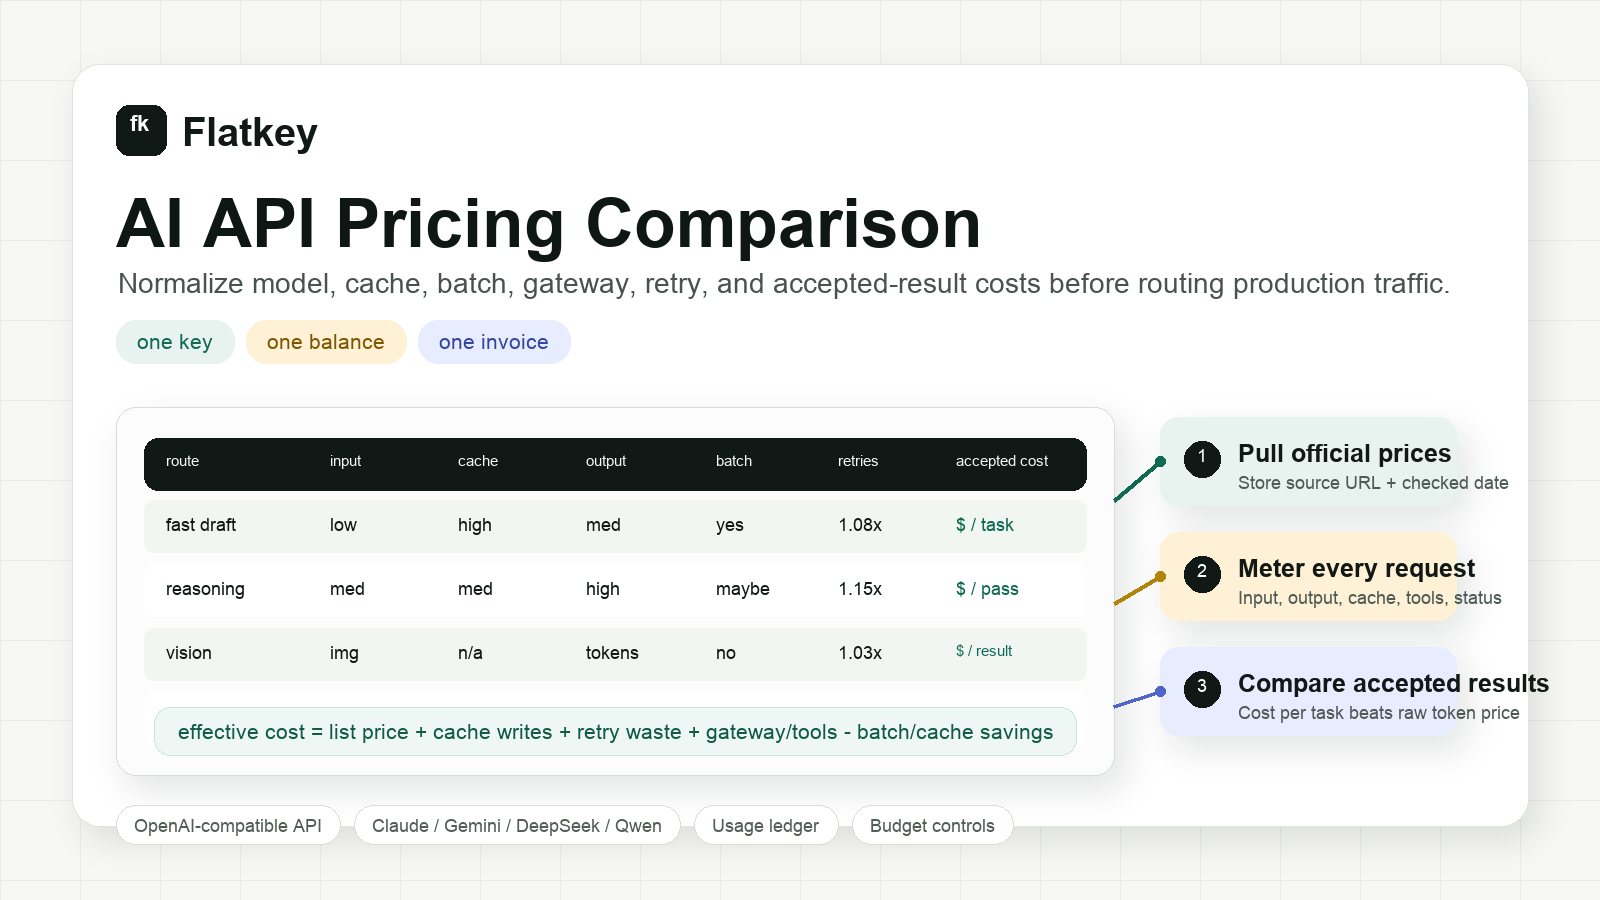
Comparaison des tarifs des API IA : coûts des modèles, du cache, des lots et de la passerelle
Une comparaison des tarifs des API IA n’est utile que si elle correspond à la façon dont votre produit envoie réellement les requêtes. Un tableau des prix des jetons d’entrée et de sortie est un point de départ, pas un budget. Les dépenses réelles varient selon l’entrée mise en cache, les jetons de raisonnement, les nouvelles tentatives, les remises sur lots, les appels d’outils, la génération de médias, les frais de passerelle et le pourcentage de sorties que vos utilisateurs acceptent.
Ce guide fournit aux développeurs, aux équipes produit et aux équipes achats une feuille de calcul pratique pour comparer les tarifs des API IA entre OpenAI, Anthropic Claude, Google Gemini, DeepSeek, Alibaba Model Studio/Qwen, et une API multi-fournisseurs telle que Flatkey.
En bref : comparez le coût par résultat accepté, et pas seulement le prix affiché par million de jetons.
Le cadre rapide de comparaison des tarifs des API IA
Utilisez cette comparaison normalisée avant de changer de fournisseur, d’approuver un budget plus élevé ou de mettre un workflow d’agent en production.
| Couche | Ce qu’il faut comparer | Pourquoi cela change votre facture |
|---|---|---|
| Prix affiché du modèle | Tarifs des entrées, des entrées mises en cache, des sorties, des images, de l’audio, de la vidéo et des appels d’outils | La grille tarifaire visible peut avantager un fournisseur pour les prompts et un autre pour les complétions. |
| Forme de la charge de travail | Jetons d’entrée moyens, jetons de sortie, préfixe pouvant être mis en cache, taille des médias et appels d’outils | Un modèle de sortie bon marché peut devenir coûteux s’il nécessite de longs prompts ou des nouvelles tentatives répétées. |
| Remises et modes | API Batch, niveaux flex/priority, hits du cache, fenêtres hors pointe, engagement d’utilisation ou conditions de volume | Le même modèle peut avoir une économie différente selon la planification et la tolérance à la latence. |
| Coût de fiabilité | Taux de nouvelles tentatives, taux de repli, taux de timeout et politique en cas d’appel échoué | Le gaspillage lié aux nouvelles tentatives peut annuler l’avantage d’un prix affiché plus bas. |
| Coût d’exploitation | Clés API, factures, exports d’utilisation, contrôles budgétaires, conservation des données et charge de travail d’approvisionnement | Les équipes finance et plateforme ont besoin de gouvernance, pas seulement de jetons moins chers. |
| Résultat accepté | Taux d’acceptation, taux d’édition humaine, taux de réussite de l’évaluateur ou taux de succès des tâches | La requête la moins chère n’est pas le résultat le moins cher si la qualité baisse. |
Pour toute comparaison des tarifs des API IA, commencez par cette formule :
coût effectif par résultat accepté =
  (coût d’entrée + coût d’entrée mise en cache + coût de sortie + coût des médias/outils + coût de passerelle + gaspillage lié aux nouvelles tentatives)
  / nombre de résultats acceptés
Si vous ne comparez que les prix affichés des jetons d’entrée et de sortie, vous passerez à côté des coûts qui apparaissent généralement après le lancement : comportement du cache, nouvelles tentatives, appels d’outils et rapprochement financier.
Tableau des sources de prix actuelles
Les tarifs des fournisseurs changent fréquemment. Au lieu de recopier dans votre document de planification une grande grille tarifaire déjà obsolète, conservez un tableau source à jour avec l’URL officielle, la date de vérification et les dimensions tarifaires que vous devez normaliser.
| Fournisseur ou route | Source tarifaire officielle à vérifier | Dimensions tarifaires à capturer | Notes pour la comparaison |
|---|---|---|---|
| API OpenAI | Tarification de l’API OpenAI | Entrée, entrée mise en cache, sortie, mode batch, fine-tuning, médias, traitement régional | Utile pour les produits déjà construits autour de schémas de requêtes compatibles avec OpenAI. Confirmez les identifiants de modèle et si vous utilisez la tarification standard ou batch. |
| API Anthropic Claude | Tarification de Claude | Entrée, sortie, mise en cache des prompts, tarification batch, famille de modèles, fenêtre de contexte | Très pertinent pour le code, le raisonnement et les tâches d’agent ; le comportement d’écriture et de lecture du cache compte pour les prompts répétés. |
| API Google Gemini | Tarification de l’API Gemini | Offre gratuite/payant, entrée, sortie, mise en cache, mode batch, options priority/flex, grounding via recherche | La tarification de Gemini peut varier selon la famille de modèles et le mode de service. Indiquez si des frais de recherche ou de grounding s’appliquent. |
| API DeepSeek | Tarification de l’API DeepSeek | Échec du cache d’entrée, hit du cache d’entrée, sortie, timing de pointe/hors pointe, alias de modèle | La tarification de type DeepSeek basée sur les hits du cache et les plages horaires exige des journaux de requêtes avec horodatage et statut du cache. |
| Alibaba Model Studio / Qwen | Modèles Alibaba Model Studio | Famille de modèles, modalité, région, jeton ou unité média, identifiant du modèle dans la console | Utile pour Qwen et l’accès aux modèles de la région Chine. Vérifiez la page de détail exacte du modèle pour l’unité facturable. |
| API multi-fournisseurs Flatkey | Tarification de Flatkey et Modèles Flatkey | Routes de modèles unifiées, un seul solde, grand livre par requête, appels d’outils, factures, budgets de sous-clés | Utile lorsque vous avez besoin d’une seule clé, d’un seul solde et d’un seul registre d’utilisation sur de nombreux modèles et outils officiels. |
Ajoutez trois champs obligatoires à chaque ligne : date de vérification, identifiant du modèle et unité. « $ par 1 M de jetons » n’est pas comparable à « $ par image », « $ par seconde de vidéo », « $ par appel d’outil » ou « niveau priority ».
Construisez la feuille de calcul avant de négocier
Une feuille de comparaison durable des tarifs des API IA doit comporter des colonnes qui reflètent le trafic de production.
| Colonne | Valeur d'exemple | Pourquoi c'est important |
|---|---|---|
| Fournisseur | Anthropic, OpenAI, Google, DeepSeek, Alibaba, route Flatkey | Garde séparées les routes directes chez les fournisseurs et les routes via passerelle. |
| ID du modèle ou de la route | claude-*, gpt-*, gemini-*, deepseek-*, qwen-* |
Évite les comparaisons silencieuses entre différents niveaux de modèles. |
| URL de la source tarifaire | Page officielle du fournisseur ou page du modèle Flatkey | Rend l'examen des achats traçable. |
| Date de vérification | 2026-10-12 |
Les tarifs peuvent évoluer plus vite que les revues de contrat. |
| Jetons d'entrée par tâche | 8,000 |
Les prompts longs modifient rapidement l'économie. |
| Part d'entrée mise en cache | 65% |
Les prompts système stables et les préfixes de récupération peuvent coûter moins cher. |
| Jetons de sortie par tâche | 1,200 |
Le raisonnement et les réponses verbeuses augmentent le coût de sortie. |
| Éligible au lot | yes/no | Les tâches hors ligne peuvent bénéficier de tarifs de lot plus bas. |
| Appels d'outils/médias | search, browser, image, video, enrichment | Les workflows d'agent ne sont pas uniquement textuels. |
| Multiplicateur de retry | 1.08x |
Les délais d'attente et les tentatives de secours ajoutent des dépenses cachées. |
| Taux d'acceptation | 82% |
Une sortie de faible qualité augmente le coût par résultat accepté. |
| Coût de gouvernance | facture, plafond budgétaire, export, besoin d'audit | Le coût des achats est bien réel même lorsque les tarifs par jeton sont faibles. |
N'agrégez pas tous les modèles dans une seule ligne. Séparez par charge de travail : chat, RAG, agent de codage, extraction de données, classification par lot, génération d'images, génération de vidéos et exécutions d'agents gourmandes en outils.
Comparer les tarifs directs des fournisseurs avec une API multi-fournisseurs
Les comptes directs chez les fournisseurs sont les plus simples lorsqu'une seule famille de modèles gère la majeure partie de votre travail et que votre équipe finance est à l'aise avec plusieurs fournisseurs distincts. Une API multi-fournisseurs devient plus utile lorsque vous devez comparer les modèles en continu, router selon la charge de travail ou gérer de nombreuses clés et factures.
| Point de décision | Des comptes directs chez les fournisseurs peuvent suffire lorsque... | Une API multi-fournisseurs aide lorsque... |
|---|---|---|
| Choix du modèle | Un fournisseur remporte la plupart des tâches. | Différentes charges de travail nécessitent des routes OpenAI, Claude, Gemini, DeepSeek, Qwen, image, vidéo et outils. |
| Effort d'ingénierie | Votre code appelle déjà un seul fournisseur et change rarement. | Vous voulez un routage compatible OpenAI et moins de réécritures d'intégration. |
| Contrôle des coûts | Une facture et un tableau de bord suffisent. | Vous avez besoin de budgets par sous-clé, de listes d'autorisation de modèles et d'exports d'utilisation par requête. |
| Achats | Des contrats séparés sont gérables. | Les contrats en double, les sièges inactifs et les clés fournisseurs dispersées ralentissent l'équipe. |
| Fiabilité | Des pannes occasionnelles chez le fournisseur sont acceptables. | Vous avez besoin de politiques de secours et d'un registre partagé pour le coût des retries/secours. |
| Workflows d'agents | L'application n'appelle que des modèles textuels. | Les agents appellent des modèles, la recherche web, des actions de navigateur, des outils d'enrichissement, des images et de la vidéo. |
Flatkey est conçu pour la deuxième colonne : une clé API, un solde, une facture, et un registre des requêtes sur plus de 300 modèles officiels et plus de 1 000 outils payés à l'appel. Cela ne supprime pas la nécessité de vérifier les prix officiels des modèles. Cela donne à votre équipe un endroit unique pour router, mesurer et rapprocher ces coûts. Pour une répartition connexe des frais de passerelle, voir tarification des passerelles IA.
Cinq exemples de charges de travail
1. Chat de support
Le chat de support a généralement des entrées modérées, des sorties courtes et un volume élevé. Comparez :
- Taux de réussite du cache des prompts pour le prompt système et le texte de politique.
- Budget de jetons de sortie selon le type de réponse.
- Taux d'escalade vers un modèle plus puissant.
- Coût par conversation résolue, et pas seulement coût par message.
Pour cette charge de travail, un modèle rapide moins cher peut l'emporter s'il maintient une qualité de résolution élevée. Si le modèle moins cher augmente le taux de transfert ou d'édition, les économies apparentes de jetons disparaissent.
2. Agent de codage
Les agents de codage ont souvent un contexte important, des appels d'outils, une sortie longue et de multiples retries. Comparez :
- Taille du contexte après une recherche dans le dépôt ou la lecture de fichiers.
- Instructions de projet mises en cache.
- Nombre d'appels d'outils par tâche acceptée.
- Gaspillage lié aux retries provenant de routes surchargées.
- Coût par changement fusionné ou correctif accepté.
C'est là qu'une comparaison des tarifs des API IA a besoin d'un registre. Une seule exécution d'agent peut inclure des appels de modèle, des appels d'outils, des appels de secours et des tentatives échouées.
3. Génération de réponses RAG
Les charges de travail RAG sont dominées par le contexte récupéré et la longueur de la réponse. Comparez :
- Nombre moyen de jetons récupérés.
- Part du préfixe de prompt stable.
- Comportement du cache pour les documents répétés.
- Coûts de citation et d'ancrage.
- Taux de réussite de l'évaluateur pour la factualité.
Ne choisissez pas un modèle uniquement parce que ses jetons d’entrée sont bon marché. S’il a besoin de deux fois plus de contexte ou produit des réponses qui échouent à l’évaluation, le coût par réponse acceptée peut être plus élevé. Si c’est la principale question de migration, utilisez la feuille de calcul plus détaillée dans comment comparer les prix des modèles d’IA.
4. Classification par lots
La classification par lots peut souvent tolérer des résultats différés. Comparez :
- Si le fournisseur propose un niveau batch ou flex.
- La taille maximale du lot et la fenêtre de traitement.
- Le coût de réexécution des erreurs.
- Le taux de réussite de la validation du schéma de sortie.
- Le coût total par ligne acceptée.
Si un fournisseur propose une tarification batch plus basse, les économies ne s’appliquent que lorsque votre flux de travail peut attendre et que votre processus de पुनessaie est propre.
5. Génération d’images et de vidéos
Les API d’images et de vidéos s’intègrent rarement dans un tableur basé uniquement sur les jetons. Comparez :
- Unité de sortie : image, seconde, clip, résolution ou crédit.
- Règles de facturation en cas d’échec de génération.
- Taux de modification/régénération.
- Taux d’approbation humaine.
- Coût par actif créatif accepté.
Pour les pipelines média, placez les modèles à jetons et les modèles de génération dans des onglets de feuille de calcul séparés. L’économie unitaire est trop différente pour une seule ligne combinée.
Un flux de travail de comparaison des tarifs des API IA en sept étapes
- Figez la charge de travail. Choisissez une famille de tâches réelle, comme les réponses du support, les correctifs d’un agent de codage, les réponses RAG, la classification par lots, la génération d’images ou la génération de vidéos.
- Collectez les prix officiels actuels. Utilisez les pages de tarification des fournisseurs, les pages de modèles Flatkey et une date vérifiée. Évitez les grilles tarifaires copiées sans URL source.
- Rejouez le trafic représentatif. Utilisez les mêmes prompts, entrées, plafonds de sortie, politique d’outils et validateurs sur tous les itinéraires.
- Journalisez chaque unité facturable. Capturez les jetons d’entrée, les jetons mis en cache, les jetons de sortie, les unités média, les appels d’outils, les tentatives de réessai, les erreurs et le statut.
- Notez les résultats acceptés. Utilisez une revue humaine, des validateurs automatisés ou des contrôles réussite/échec spécifiques à la tâche.
- Calculez le coût effectif. Divisez le coût total de l’itinéraire par les résultats acceptés, et non par le nombre total de requêtes.
- Ajoutez des contrôles opérationnels. Décidez si l’itinéraire gagnant respecte aussi les plafonds budgétaires, les besoins de facturation, la gouvernance des clés, la rétention des données et le plan de repli en cas d’incident.
Le résultat est une décision tarifaire que vous pouvez défendre auprès de l’ingénierie et des finances.
Où Flatkey s’intègre
Flatkey n’est pas un tableau de prix statique. C’est la couche de routage et de facturation pour les équipes qui doivent exécuter une véritable comparaison des tarifs des API IA en production. Pour une vue plus large au niveau des modèles, couvrant les coûts des jetons, des images et des vidéos, commencez par la comparaison des tarifs des modèles d’IA.
Utilisez Flatkey lorsque vous souhaitez :
- Appeler de nombreux modèles officiels via une seule clé API.
- Garder l’utilisation des modèles et des outils sur un seul solde.
- Comparer des itinéraires sans disperser les clés fournisseur entre les agents et les dépôts.
- Suivre les jetons d’entrée, de sortie et mis en cache, les appels d’outils, le statut et le coût dans un seul registre.
- Donner aux équipes des budgets par sous-clé et des listes d’autorisation de modèles.
- Rapprocher une seule facture au lieu de nombreux tableaux de bord fournisseurs.
Commencez avec Flatkey lorsque la comparaison elle-même est devenue un problème opérationnel. Si votre équipe sait déjà exactement quel fournisseur gagne et n’a pas besoin de routage multi-fournisseurs, un compte direct peut suffire. Lorsque les finances ont besoin d’une responsabilité par propriétaire, clé et budget, associez cette feuille de calcul avec la gestion des dépenses des API IA et les contrôles de quota des API IA.
Erreurs courantes dans la comparaison des tarifs des API IA
| Erreur | Que faire à la place |
|---|---|
| Comparer uniquement les tarifs des jetons d’entrée | Comparez l’entrée, l’entrée mise en cache, la sortie, les réessais et les résultats acceptés. |
| Mélanger le texte, l’image, la vidéo et les outils en une seule unité | Normalisez chaque modalité séparément, puis consolidez le coût du flux de travail accepté. |
| Ignorer la mise en cache des prompts | Mesurez les préfixes de prompt stables et les taux de cache hit. |
| Ignorer l’éligibilité au batch | Séparez les tâches sensibles à la latence et les tâches hors ligne. |
| Faire confiance à des tableaux de prix copiés et obsolètes | Stockez les URL des sources officielles et les dates de vérification. |
| Considérer les passerelles comme une simple majoration | Incluez la gouvernance, le basculement, les exports d’utilisation, les factures et le temps d’ingénierie. |
| Choisir la requête la moins chère | Choisissez le résultat accepté le moins cher qui répond aux exigences de qualité et de fiabilité. |
Questions fréquentes
Quelle est la meilleure façon de comparer les tarifs des API IA ?
La meilleure façon de comparer les tarifs des API IA est de normaliser chaque itinéraire en coût par résultat accepté. Incluez les jetons d’entrée, les jetons d’entrée mis en cache, les jetons de sortie, les unités média, les appels d’outils, les réessais, les frais de passerelle et le taux d’acceptation pour la charge de travail.
Pourquoi les prix des API IA diffèrent-ils autant ?
Les prix des API IA diffèrent parce que les fournisseurs utilisent différentes architectures de modèles, différents niveaux de service, fenêtres de contexte, règles de cache, remises batch, unités média et options régionales ou prioritaires. Un faible prix d’entrée ne signifie pas automatiquement que l’itinéraire est moins cher pour votre charge de travail.
Dois-je utiliser un seul fournisseur ou une API multi-fournisseurs ?
Utilisez un seul fournisseur lorsqu’une seule famille de modèles couvre la charge de travail et que la facturation séparée est facile à gérer. Utilisez une API multi-fournisseurs lorsque vous devez comparer en continu les routes, gérer de nombreuses clés, router entre des modèles de texte et de média, ou rapprocher l’utilisation dans un seul grand livre.
À quelle fréquence les tarifs doivent-ils être revérifiés ?
Revérifiez les tarifs avant chaque changement majeur de routage, revue de contrat ou prévision budgétaire. Pour les charges de travail de production qui évoluent rapidement, enregistrez la source de tarification et la date de vérification dans votre feuille de calcul des coûts afin que la finance et l’ingénierie puissent voir quand les chiffres risquent d’être obsolètes.
Un prix par jeton plus bas réduit-il toujours la dépense totale en IA ?
Non. Un prix par jeton plus bas peut être désavantageux une fois que vous incluez des prompts plus longs, des sorties plus longues, un taux d’acceptation plus faible, des retries, des appels de repli, l’utilisation d’outils et des frais supplémentaires de gouvernance. La métrique durable est le coût effectif par résultat accepté.
Liste de vérification finale
Avant de choisir une route, confirmez :
- L’ID du modèle, la source de tarification et la date de vérification sont enregistrés.
- Les unités d’entrée, d’entrée mise en cache, de sortie, de média et d’outil sont séparées.
- Le mode lot ou priorité est explicitement indiqué.
- Le coût des retries et des mécanismes de repli est inclus.
- Le taux d’acceptation est mesuré sur des tâches réelles.
- Les achats peuvent rapprocher la facture et exporter le grand livre d’utilisation.
- La décision finale est basée sur le coût du résultat accepté, et pas seulement sur le prix catalogue.
Voilà la comparaison pratique des tarifs des API IA : des prix sources à jour, un trafic représentatif de la production et un grand livre auquel la finance et l’ingénierie peuvent tous deux se fier.


