Plateformes d'observabilité IA : rôle et critères de choix (2026)
Une plateforme d'observabilité IA enregistre chaque appel de modèle, chaque étape d'agent et chaque appel d'outil de votre application (prompt, réponse, tokens, coût, latence et erreurs) afin que vous puissiez déboguer, évaluer et maîtriser les dépenses en production. Les principales options en octobre 2026 sont Langfuse, LangSmith, Arize (Phoenix et AX), Datadog LLM Observability, Helicone, Braintrust et Pydantic Logfire, et la plupart acceptent les traces OpenTelemetry. Choisissez selon l'endroit où vos données doivent résider, votre façon d'évaluer la qualité et le prix que vous paierez par trace.
Ce guide explique ce qu'est l'observabilité IA, quels signaux capturer, comment les principales plateformes se comparent en fonctionnalités et en tarifs publiés, et comment instrumenter une application en moins de 30 lignes de code. Les prix proviennent de la page tarifaire officielle de chaque fournisseur, consultée le 24 octobre 2026.
Qu'est-ce que l'observabilité IA ?
L'observabilité IA consiste à collecter des traces, des métriques, des logs et des scores de qualité à partir des systèmes d'IA pour pouvoir répondre à tout moment à trois questions : Qu'a fait le modèle ? La réponse était-elle bonne ? Combien cela a-t-il coûté ? Elle complète la supervision applicative classique, qui suit la disponibilité et la latence, avec des signaux propres aux modèles de langage :
- Entrées et sorties : le prompt, le contexte récupéré et la réponse générée.
- Consommation de tokens et coût : tokens d'entrée, de sortie et en cache par requête, utilisateur et fonctionnalité.
- Traces d'agents : chaque étape de raisonnement, appel d'outil et nouvelle tentative dans une exécution en plusieurs étapes.
- Qualité : scores d'évaluateurs, retours utilisateurs et signalements d'hallucination ou de non-conformité.
- Métadonnées du modèle et du fournisseur : quel modèle a répondu, par quelle route et avec quels paramètres.
La supervision traditionnelle vous dit qu'une requête a pris 9 secondes. L'observabilité IA vous dit qu'elle a pris 9 secondes parce que l'agent a appelé trois fois un outil de recherche, que le deuxième appel au modèle a reçu une erreur 429 et que le modèle de secours a produit une réponse qui a échoué à votre contrôle d'ancrage factuel (groundedness).
Supervision vs observabilité vs évaluation
| Pratique | Question à laquelle elle répond | Résultat typique |
|---|---|---|
| Supervision | Le système est-il disponible et dans les seuils ? | Tableaux de bord, alertes sur la latence et le taux d'erreur |
| Observabilité | Pourquoi cette requête précise s'est-elle comportée ainsi ? | Traces avec prompts, appels d'outils, tokens et métadonnées |
| Évaluation | La sortie est-elle correcte, sûre et utile ? | Scores issus de tests, de juges LLM ou de revues humaines |
Une plateforme d'observabilité IA moderne combine les trois. Le cadre de gestion des risques IA du NIST insiste aussi sur la mesure et la surveillance continues des systèmes d'IA déployés, ce qui explique pourquoi de nombreuses équipes de gouvernance exigent désormais ces enregistrements.
Le standard ouvert : les conventions GenAI d'OpenTelemetry
Vous n'avez plus besoin d'un SDK propriétaire pour capturer la télémétrie IA. OpenTelemetry définit des conventions sémantiques pour l'IA générative qui nomment les attributs standard des appels de modèles. En octobre 2026, ces conventions sont maintenues dans un dépôt semantic-conventions-genai dédié et restent au statut « Development » : certains noms peuvent donc encore changer.
| Attribut | Signification |
|---|---|
gen_ai.operation.name |
L'opération, par exemple chat ou embeddings (obligatoire) |
gen_ai.provider.name |
Le fournisseur, par exemple openai ou anthropic (obligatoire) |
gen_ai.request.model |
Modèle demandé par votre code |
gen_ai.response.model |
Modèle qui a réellement répondu |
gen_ai.usage.input_tokens / gen_ai.usage.output_tokens |
Nombre de tokens |
gen_ai.response.finish_reasons |
Raison de l'arrêt de la génération |
gen_ai.conversation.id |
Regroupe les tours d'une même conversation |
Instrumentez une seule fois avec ces attributs et vous pourrez envoyer les mêmes traces vers Langfuse, Arize Phoenix, Datadog, Logfire, Grafana Tempo ou tout autre backend compatible OTLP. La propagation du contexte entre services suit le standard W3C Trace Context.
Comparatif des plateformes d'observabilité IA
| Plateforme | Déploiement | Points forts | Tarif d'entrée publié (oct. 2026) |
|---|---|---|---|
| Langfuse | Open source (auto-hébergé) ou cloud | Traçage, gestion des prompts, évaluations ; cœur sous licence MIT | Hobby gratuit (50k unités/mois) ; Core 29 $/mois ; Pro 199 $/mois |
| LangSmith | Cloud, hybride ou auto-hébergé en Enterprise | Intégration poussée avec LangChain et LangGraph, évaluations | Developer 0 $/siège (5k traces de base) ; Plus 39 $/siège |
| Arize Phoenix et AX | Phoenix open source ; AX cloud | Traçage natif OTel, évaluations, analyse de dérive | Phoenix gratuit en auto-hébergement ; AX Pro 50 $/mois (50k spans) |
| Datadog LLM Observability | Cloud (intégré à Datadog) | Relie les traces LLM à l'APM, aux logs et à l'infrastructure | À l'usage ; devis via Datadog |
| Helicone | Cloud ou auto-hébergé | Journalisation par proxy en une ligne de configuration, cache | Hobby gratuit (10k requêtes) ; Pro 79 $/mois ; Team 799 $/mois |
| Braintrust | Cloud | Workflow centré sur l'évaluation, expériences, scoring | Starter 0 $ (1 Go traité, 10k scores) ; Pro 249 $/mois |
| Pydantic Logfire | Cloud | Observabilité OTel généraliste, très bon support Python et agents | Personal gratuit (10M enregistrements/mois) ; Team 49 $/mois |
Comment lire ce tableau :
- Vous devez garder les données dans votre propre environnement ? Commencez par Langfuse ou Arize Phoenix, tous deux auto-hébergeables.
- Vous payez déjà Datadog ? Son produit LLM Observability place les traces IA à côté de votre APM et de vos logs existants.
- Vous utilisez LangChain ou LangGraph ? LangSmith demande le moins de configuration.
- L'évaluation est la priorité ? Braintrust et LangSmith sont en tête sur les expériences et les workflows de scoring.
- Aucune modification de code ? Les outils de type proxy comme Helicone, ou les logs de votre passerelle IA, capturent le trafic au niveau réseau.
Ce qu'il faut regarder dans une plateforme d'observabilité IA
Utilisez cette checklist pendant l'essai :
- Support d'OpenTelemetry. Peut-elle ingérer des traces OTLP avec des attributs
gen_ai.*, et pouvez-vous réexporter vos données ? - Traçage des agents et des outils. Affiche-t-elle des spans imbriqués pour chaque étape, appel d'outil et nouvelle tentative, et pas seulement l'appel final au modèle ?
- Suivi des coûts. Calcule-t-elle le coût par requête à partir des tokens et de vos prix réels, y compris les tokens en cache et les remises batch ?
- Évaluations. Pouvez-vous lancer des contrôles automatiques (LLM-juge, regex, réponses de référence) sur les traces de production et être alerté en cas de baisse des scores ?
- Contrôles de confidentialité. Pouvez-vous masquer ou hacher les prompts, définir des durées de rétention et restreindre l'accès au contenu brut ?
- Unité de facturation. Les fournisseurs facturent à la trace, au span, à l'« unité », au Go ou au siège. Estimez votre volume mensuel dans chaque unité avant de comparer.
- Auto-hébergement. Si des données réglementées sont en jeu, vérifiez qu'une option auto-hébergée existe et ce qu'elle coûte à exploiter.
Instrumenter un appel LLM en Python avec OpenTelemetry
Cet exemple enregistre une chat completion avec les attributs GenAI standard et l'exporte vers n'importe quel endpoint OTLP (Langfuse, Phoenix, Logfire ou un collector local). Il appelle les modèles via un endpoint compatible OpenAI, donc le même code fonctionne pour GPT, Claude, Gemini ou DeepSeek.
pip install openai opentelemetry-sdk opentelemetry-exporter-otlp
export OTEL_EXPORTER_OTLP_ENDPOINT="http://localhost:4318"   # your collector or vendor endpoint
export FLATKEY_API_KEY="sk-..."
import os, time
from openai import OpenAI
from opentelemetry import trace
from opentelemetry.sdk.trace import TracerProvider
from opentelemetry.sdk.trace.export import BatchSpanProcessor
from opentelemetry.exporter.otlp.proto.http.trace_exporter import OTLPSpanExporter

provider = TracerProvider()
provider.add_span_processor(BatchSpanProcessor(OTLPSpanExporter()))
trace.set_tracer_provider(provider)
tracer = trace.get_tracer("support-bot")

client = OpenAI(api_key=os.environ["FLATKEY_API_KEY"],
                base_url="https://router.flatkey.ai/v1")

def answer(question: str, model: str = "claude-sonnet-5-5") -> str:
    with tracer.start_as_current_span(f"chat {model}") as span:
        span.set_attribute("gen_ai.operation.name", "chat")
        span.set_attribute("gen_ai.provider.name", "flatkey")
        span.set_attribute("gen_ai.request.model", model)
        t0 = time.time()
        r = client.chat.completions.create(
            model=model, max_tokens=300,
            messages=[{"role": "user", "content": question}])
        span.set_attribute("gen_ai.response.model", r.model)
        span.set_attribute("gen_ai.usage.input_tokens", r.usage.prompt_tokens)
        span.set_attribute("gen_ai.usage.output_tokens", r.usage.completion_tokens)
        span.set_attribute("gen_ai.response.finish_reasons", [r.choices[0].finish_reason])
        span.set_attribute("app.latency_ms", int((time.time() - t0) * 1000))
        return r.choices[0].message.content

print(answer("How do I reset my password?"))
provider.shutdown()  # flush spans before exit
En Node.js, le principe est le même avec @opentelemetry/sdk-node :
import OpenAI from "openai";
import { trace } from "@opentelemetry/api";

const tracer = trace.getTracer("support-bot");
const client = new OpenAI({ apiKey: process.env.FLATKEY_API_KEY, baseURL: "https://router.flatkey.ai/v1" });

export async function answer(question, model = "gpt-6.1-sol") {
  return tracer.startActiveSpan(`chat ${model}`, async (span) => {
    span.setAttributes({ "gen_ai.operation.name": "chat", "gen_ai.request.model": model });
    const r = await client.chat.completions.create({ model, messages: [{ role: "user", content: question }] });
    span.setAttributes({
      "gen_ai.response.model": r.model,
      "gen_ai.usage.input_tokens": r.usage.prompt_tokens,
      "gen_ai.usage.output_tokens": r.usage.completion_tokens,
    });
    span.end();
    return r.choices[0].message.content;
  });
}
Ne placez pas le contenu des prompts et des réponses dans les attributs des spans, sauf si votre politique de confidentialité l'autorise ; beaucoup d'équipes enregistrent plutôt un hachage ou une copie expurgée. Notre guide de journalisation des payloads présente des modèles d'anonymisation.
Votre passerelle IA est aussi une source d'observabilité
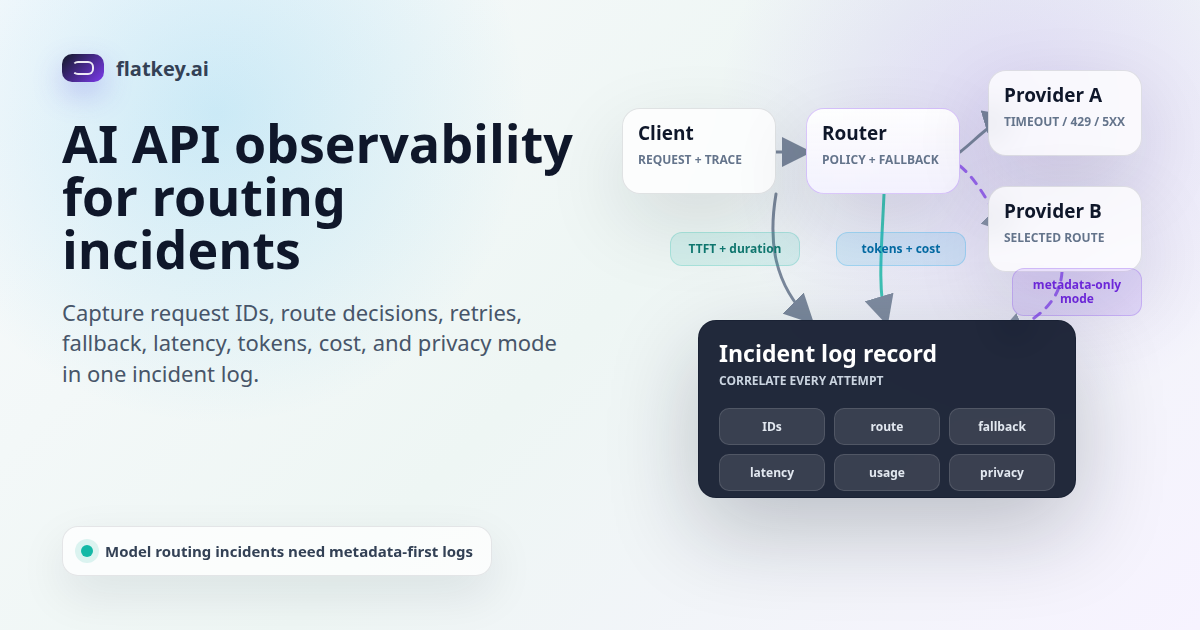
Si votre application appelle les modèles via une passerelle ou un routeur IA, la passerelle voit déjà chaque requête : c'est donc le point de départ le moins coûteux. Elle capture des données même pour les services qui ne sont pas encore instrumentés. Les logs d'utilisation de Flatkey, par exemple, enregistrent pour chaque appel l'horodatage, le modèle, les tokens d'entrée et de sortie, le coût, la clé API masquée et le statut ; ils s'exportent en CSV ou JSON et prennent en charge des plafonds de dépenses mensuels et des quotas par groupe (documentation d'utilisation Flatkey, octobre 2026).
Une configuration pratique combine les deux niveaux :
| Niveau | Ce qu'il voit le mieux | Exemple d'usage |
|---|---|---|
| Logs de la passerelle | Chaque appel de modèle, coût, statut, erreurs fournisseur, fallbacks | Dépenses par clé ou équipe, taux de 429 et 5xx, pannes fournisseur |
| Traces applicatives | Contexte métier, étapes d'agent, récupération, appels d'outils | Pourquoi la requête d'un utilisateur a échoué ou mal répondu |
| Évaluations | Qualité des réponses dans le temps | Détecter les régressions après un changement de prompt ou de modèle |
Reliez les deux avec un identifiant de requête commun : envoyez votre trace ID dans un en-tête ou un champ de métadonnées à chaque appel de modèle, afin de passer d'une ligne de log de la passerelle à la trace applicative complète. Consultez observabilité des API LLM : métriques, traces et coûts pour l'ensemble de métriques que nous recommandons, et le tableau de bord KPI de la passerelle IA pour la disposition des graphiques.
Les métriques qui comptent en production
| Métrique | Pourquoi elle compte | Idée d'alerte |
|---|---|---|
| Latence p50 / p95 par modèle | Les utilisateurs ressentent la latence de queue | p95 au-dessus de votre SLO pendant 10 minutes |
| Délai avant le premier token | Expérience de streaming | TTFT en hausse chez un seul fournisseur |
| Taux d'erreur par statut (429, 5xx, timeout) | Problèmes de fournisseur ou de quota | Taux de 429 supérieur à 2 % |
| Taux de fallback | Problèmes de fiabilité cachés | Fallbacks qui doublent d'un jour à l'autre |
| Coût par requête et par utilisateur | Maîtrise du budget | Dépense quotidienne au-dessus des prévisions |
| Tokens par requête | Prompts gonflés et agents incontrôlés | Exécutions d'agents au-delà d'un plafond de tokens |
| Score d'évaluation | Régressions de qualité | Baisse du score après un déploiement |
Attribuez les coûts par équipe et par environnement pour que la finance ait des réponses ; le guide d'attribution des coûts et le suivi des coûts par environnement présentent des schémas d'étiquetage. Pour le plan de déploiement, suivez la checklist de mise en œuvre de l'observabilité IA.
FAQ
Qu'est-ce que l'observabilité IA ?
L'observabilité IA consiste à collecter des traces, des métriques, des logs et des scores de qualité à partir d'applications d'IA pour voir ce qu'un modèle ou un agent a fait, si le résultat était bon et ce qu'il a coûté. Elle ajoute prompts, tokens, appels d'outils et évaluations à la supervision traditionnelle.
Quelle est la meilleure plateforme d'observabilité IA ?
Il n'existe pas de meilleure plateforme unique. Langfuse et Arize Phoenix conviennent aux équipes qui veulent de l'open source et de l'auto-hébergement, LangSmith aux utilisateurs de LangChain, Datadog aux équipes déjà sur Datadog et Braintrust aux workflows axés sur l'évaluation. Testez deux options avec vos propres traces.
Existe-t-il une plateforme d'observabilité IA gratuite ?
Oui. En octobre 2026, Langfuse Hobby (50k unités par mois), LangSmith Developer (5k traces de base), Helicone Hobby (10k requêtes), Braintrust Starter et Logfire Personal (10M enregistrements) sont gratuits, et Langfuse et Arize Phoenix peuvent être auto-hébergés sans frais de licence.
Quelle différence entre la supervision des LLM et l'observabilité IA ?
La supervision surveille des seuils prédéfinis comme la latence et le taux d'erreur. L'observabilité permet d'examiner en détail n'importe quelle requête individuelle, y compris les prompts, les appels d'outils, la consommation de tokens et les scores de qualité.
L'observabilité IA fonctionne-t-elle avec OpenTelemetry ?
Oui. Les conventions sémantiques GenAI d'OpenTelemetry définissent des attributs standard comme gen_ai.request.model et gen_ai.usage.input_tokens, et la plupart des plateformes acceptent les traces OTLP. En octobre 2026, ces conventions sont toujours au statut Development.
Qu'est-ce que l'observabilité de l'IA générative ?
C'est la même pratique appliquée aux modèles génératifs : capturer prompts, sorties, coûts en tokens, étapes d'agents et résultats d'évaluation pour que les équipes puissent déboguer et améliorer les fonctionnalités d'IA générative en production.
Sources
- Conventions sémantiques GenAI d'OpenTelemetry (octobre 2026)
- Tarifs Langfuse, tarifs LangSmith, tarifs Arize, tarifs Helicone, tarifs Braintrust, tarifs Logfire (tous consultés le 24 octobre 2026)
- Documentation Datadog LLM Observability (octobre 2026)
- Arize Phoenix sur GitHub et Langfuse sur GitHub
- Cadre de gestion des risques IA du NIST