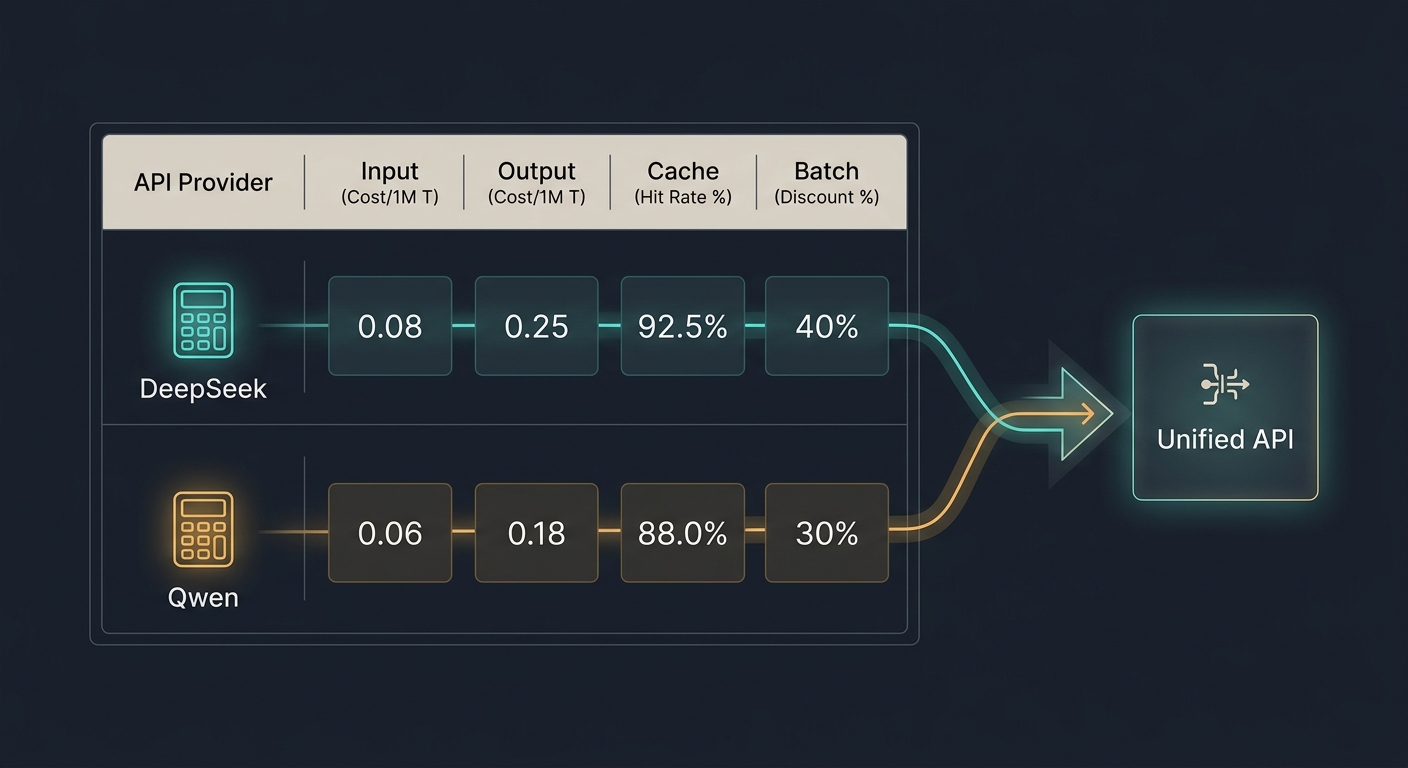
Si vous choisissez entre l’API DeepSeek et l’API Qwen pour un produit sensible au budget, ne commencez pas par un prix unitaire par jeton en gros titre. Commencez par la forme de votre charge de travail.
Un Guide des coûts 2026 pour l’API DeepSeek vs l’API Qwen pour les flux de travail sensibles aux coûts utile doit comparer au moins six éléments : les jetons d’entrée, les jetons de sortie, les hits de cache, les misses de cache, l’éligibilité au batch et le coût opérationnel d’un changement d’acheminement ultérieur.
Ce guide a été vérifié à partir de la documentation officielle des fournisseurs le 23 septembre 2026. Il est rédigé pour les indie hackers et les petites équipes produit IA qui ont besoin du coût fiable le plus bas par tâche acceptée, et non d’un benchmark de vitrine.
La version courte :
- Choisissez d’abord Qwen pour les chats simples à fort volume, les tâches de lot asynchrones et les flux de travail pouvant utiliser l’inférence par lot de Qwen ou ses règles de cache implicites/explicites.
- Choisissez d’abord DeepSeek lorsque vous souhaitez un point de terminaison global au format OpenAI plus simple, des lignes de jetons explicites de pointe/hors pointe, une comptabilisation automatique des hits et misses de cache, ou lorsque la qualité de DeepSeek Flash est déjà suffisamment bonne pour votre produit.
- Utilisez un routeur et un registre d’utilisation lorsque les économies de jetons attendues sont suffisamment faibles pour que la mise en place du fournisseur, le comportement des nouvelles tentatives, les soldes fragmentés ou le travail de migration puissent annuler la remise.
DeepSeek API vs Qwen API pour les flux de travail sensibles aux coûts : tableau de décision
| Schéma de flux de travail | Signal de coût actuel | Première famille de modèles à tester | Ce qui peut modifier la réponse |
|---|---|---|---|
| Chat court sans cache | Les lignes de la famille Qwen Flash peuvent être plus basses selon le calcul du prix public | Qwen | Longueur de sortie, région, instantané Qwen exact, taux de passage qualité |
| Évaluation asynchrone ou étiquetage | L’inférence par lot de Qwen facture les requêtes réussies à 50 % du coût de l’inférence en temps réel | Qwen | Éligibilité au batch, tolérance au délai de traitement, remises de cache non prises en charge dans le batch |
| Contexte long répété | Les deux fournisseurs disposent de mécanismes de cache ; DeepSeek expose directement les lignes hit/miss, Qwen propose des modes de cache explicites et implicites | Tester les deux | Taux réel de hit de cache, surcharge de création du cache, champs de cache spécifiques au fournisseur |
| Sortie à forte composante de raisonnement | Le gagnant dépend de savoir si Qwen Plus, Qwen Max, DeepSeek Flash ou DeepSeek Pro franchit le seuil de qualité | Aucun gagnant par défaut | Jetons de réflexion, nouvelles tentatives, longueur de réponse, taux d’acceptation |
| Configuration directe simple | DeepSeek publie une seule URL de base au format OpenAI ; la configuration de Qwen dépend de la région et de l’espace de travail | DeepSeek | Besoins en région de données, achats, présence existante sur Alibaba Cloud |
| Changements fréquents de modèle | Les économies de jetons peuvent être absorbées par les frais d’intégration et de facturation | Couche de routage partagée | Disponibilité des modèles, plan de retour arrière, journaux unifiés |
Ce tableau n’est pas un classement de qualité. C’est un outil de triage des coûts. La bonne comparaison est le coût par tâche acceptée, et non le coût par million de jetons d’entrée.
Ce qui a changé depuis la surveillance des prix de juillet 2026
La précédente surveillance des prix Flatkey pour cette URL utilisait DeepSeek V4 Flash et V4 Pro comme base et considérait Qwen Flash comme la ligne Qwen durable à bas coût. Les pages actuelles des fournisseurs rendent la comparaison plus nuancée.
DeepSeek indique désormais aux utilisateurs de l’API d’utiliser deepseek-flash comme nom de modèle. Sa documentation précise que les anciens noms tels que deepseek-v4-flash sont toujours acceptés, mais que les requêtes sont servies par DeepSeek-V4.1-Flash et facturées au prix Flash. DeepSeek publie également des prix de pointe et hors pointe, de sorte qu’un flux de travail exécuté le week-end ou en dehors des fenêtres UTC de pointe peut avoir un profil de coût différent d’un flux de travail exécuté pendant les heures de pointe.
Alibaba Cloud Model Studio expose désormais plusieurs lignes de la famille Qwen Flash selon les versions de modèle et les régions de déploiement, notamment qwen3.8-flash, qwen3.7-flash et qwen-flash. La même page sépare également la tarification régionale et le périmètre de déploiement, si bien qu’un seul prix Qwen ne suffit pas pour validation. L’ID exact du modèle et la région comptent.
Pour un guide des coûts 2026, cela signifie que la première consigne est simple : normaliser selon l’ID exact du modèle, la région, la règle de cache et le mode d’exécution avant de comparer les fournisseurs.
Snapshot actuel de la tarification première main
Tous les prix ci-dessous sont les prix publics de liste par million de tokens, tels qu’ils apparaissent dans la documentation première main au 23 septembre 2026. Ne les considérez pas comme contractuels. Vérifiez la page du fournisseur et votre compte avant de déplacer du trafic.
Lignes de tarification de l’API DeepSeek
La page de tarification de DeepSeek répertorie deepseek-flash et deepseek-v4-pro, tous deux avec une longueur de contexte de 1M et une sortie maximale de 384K.
| Modèle | Entrée cache-hit, hors pointe | Entrée cache-miss, hors pointe | Sortie, hors pointe | Entrée cache-hit, pointe | Entrée cache-miss, pointe | Sortie, pointe |
|---|---|---|---|---|---|---|
deepseek-flash | $0.003 | $0.15 | $0.60 | $0.006 | $0.30 | $1.20 |
deepseek-v4-pro | $0.022 | $0.66 | $1.98 | $0.044 | $1.32 | $3.96 |
DeepSeek publie également :
- URL de base au format OpenAI :
https://api.deepseek.com - URL de base au format Anthropic :
https://api.deepseek.com/anthropic - mise en cache automatique du contexte
prompt_cache_hit_tokensetprompt_cache_miss_tokensdans l’usage- heures de pointe de 01:00 à 04:00 et de 06:00 à 10:00 UTC, du lundi au vendredi, hors jours fériés publics chinois
L’avantage pratique est la clarté. Vous pouvez calculer séparément l’entrée cache-hit, l’entrée cache-miss et la sortie sans deviner quels tokens d’entrée ont bénéficié d’une remise.
Lignes de tarification de l’API Qwen
La page de tarification d’Alibaba Cloud Model Studio répertorie de nombreuses lignes Qwen. Les lignes de la famille Flash les plus pertinentes pour les flux de travail textuels sensibles aux coûts incluent :
| Ligne de modèle | Signal d’exemple de prix catalogue | Pourquoi c’est important |
|---|---|---|
qwen3.8-flash | Les lignes incluent $0.15 en entrée et $0.47 en sortie dans une ligne internationale visible ; d’autres régions affichent des chiffres différents | Famille Flash plus récente ; vérifiez la région et la route exacte |
qwen3.7-flash | Les lignes incluent $0.030 en entrée et $0.130 en sortie dans une ligne internationale visible ; d’autres régions affichent des chiffres différents | Souvent un très bon candidat à faible prix catalogue si la qualité suffit |
qwen-flash | Les lignes incluent $0.05 en entrée et $0.40 en sortie dans une ligne internationale visible ; d’autres régions peuvent différer | Ligne de base durable pour des tâches simples à faible coût |
qwen-plus | Les lignes incluent $0.40 en entrée et $1.20 en sortie dans une ligne visible | Utile lorsque la qualité de Flash ne suffit pas |
qwen3.7-plus | Les lignes incluent $0.40 en entrée et $1.60 en sortie dans une ligne visible | Utile pour des tâches de raisonnement ou de génération plus difficiles |
qwen3.8-max / qwen3.7-max | Les lignes incluent des prix d’entrée et de sortie nettement plus élevés | À tester uniquement lorsque Plus/Flash échouent aux critères de qualité |
Qwen publie aussi :
- des interfaces de chat compatibles avec OpenAI
- des URL de base spécifiques à la région ou à l’espace de travail
- des clés API qui doivent correspondre à la région du point de terminaison
- l’inférence par lot pour les modèles pris en charge à 50 % du prix de l’inférence en temps réel pour les requêtes réussies
- des modes de cache de contexte explicites et implicites, avec des champs de jetons de cache-hit dans l’utilisation
L’avantage pratique est une plus grande surface de remises. Si votre charge de travail peut s’exécuter de manière asynchrone ou peut atteindre de façon fiable le cache Qwen, le prix effectif de Qwen peut être bien inférieur à la ligne simple en temps réel.
Trois calculs de charge de travail
Ces exemples comparent uniquement la structure de facturation. Ils ne prétendent pas à une qualité, une latence, une fiabilité ou un comportement de sécurité équivalents.
Scénario 1 : chat court sans cache
Supposons :
- 10 000 requêtes
- 1 000 jetons d’entrée par requête
- 500 jetons de sortie par requête
- aucun cache hit
- aucun mode batch
| Route | Calcul | Coût estimé des jetons au prix catalogue |
|---|---|---|
ligne d’exemple qwen-flash | 10 M en entrée à $0.05 + 5 M en sortie à $0.40 | $2.50 |
ligne d’exemple qwen3.8-flash | 10 M en entrée à $0.15 + 5 M en sortie à $0.47 | $3.85 |
deepseek-flash, hors pointe | 10 M d’entrée en cache-miss à $0.15 + 5 M de sortie à $0.60 | $4.50 |
deepseek-flash, pointe | 10 M d’entrée en cache-miss à $0.30 + 5 M de sortie à $1.20 | $9.00 |
Pour un chat court sans cache, Qwen est le premier candidat en matière de coût. DeepSeek peut néanmoins l’emporter si son taux de réussite qualité est plus élevé, s’il nécessite moins de nouvelles tentatives, ou si la simplicité opérationnelle compte davantage que l’écart brut de jetons.
Scénario 2 : long contexte répété
Supposons :
- 10 000 requêtes
- 10 000 jetons d’entrée par requête
- 1 000 jetons de sortie par requête
- 90 % des jetons d’entrée atteignent le cache après le réchauffement
- pas de mode batch
| Route | Hypothèse de cache | Coût estimé en jetons au prix catalogue |
|---|---|---|
deepseek-flash, hors pointe | 90M de jetons d’entrée en hit à $0.003, 10M de jetons d’entrée en miss à $0.15, 10M de jetons de sortie à $0.60 | $7.77 |
deepseek-flash, pointe | 90M de jetons d’entrée en hit à $0.006, 10M de jetons d’entrée en miss à $0.30, 10M de jetons de sortie à $1.20 | $15.54 |
Exemple de ligne qwen-flash avec 20 % d’entrée en cache implicite | 90M de jetons d’entrée mis en cache à $0.01, 10M de jetons d’entrée normaux à $0.05, 10M de jetons de sortie à $0.40 | $5.40 |
C’est ici que l’ancienne règle empirique peut se briser. DeepSeek expose des lignes de hit de cache et de miss de cache très claires, mais la documentation actuelle de cache de Qwen indique que de nombreux modèles à cache implicite facturent les jetons mis en cache à un pourcentage du prix des jetons d’entrée normaux, tout en signalant aussi des exceptions propres à certains modèles. Si votre charge de travail dépend des économies de cache, n’approuvez aucun des deux fournisseurs sur la seule base d’un tableur. Consignez les jetons réels de hit de cache à partir de la réponse de l’API.
Scénario 3 : évaluation traitable par batch
Supposons la même forme de court échange que dans le scénario 1, mais que le travail puisse attendre un traitement batch asynchrone et utilise un modèle batch Qwen pris en charge.
| Route | Calcul | Coût estimé en jetons au prix catalogue |
|---|---|---|
Exemple de ligne qwen-flash en temps réel | Même que dans le scénario 1 | $2.50 |
qwen-flash éligible au batch | 50 % du coût en jetons de la requête en temps réel réussie | $1.25 |
deepseek-flash, en temps réel hors pointe | Même que dans le scénario 1 | $4.50 |
Pour les jeux d’évaluation, l’étiquetage de données nocturne, l’enrichissement hors ligne et les tests de régression, l’inférence batch Qwen est généralement le premier levier de coût à vérifier. Le compromis porte sur la latence et la mécanique : les jobs batch nécessitent une entrée JSONL, un seul modèle par fichier, du polling, la gestion du fichier de résultats et des vérifications d’acceptation.
Le calculateur que les indie hackers devraient utiliser
Utilisez-le avant de changer de modèle :
coût de la tâche acceptée =
  cache_miss_input_tokens * cache_miss_input_rate
  + cache_hit_input_tokens * cache_hit_input_rate
  + output_tokens * output_rate
  - verified_batch_discount
  + retry_tokens
  + fallback_tokens
  + migration_operating_cost
----------------------------------------------------
  accepted_tasks
Suivez ensuite ces champs pour chaque route candidate :
| Champ | Pourquoi c’est important |
|---|---|
| ID exact du modèle | Les alias flottants et les instantanés datés peuvent se comporter différemment |
| Région et point de terminaison | Les clés API Qwen sont liées à une région ; une incompatibilité de point de terminaison peut provoquer des échecs d’authentification |
| Mode d’exécution | Le temps réel, le batch, le cache et le repli du routeur utilisent des hypothèses de facturation différentes |
| Jetons d’entrée | Les longues invites rendent le cache et le raccourcissement des invites importants |
| Jetons de sortie | La sortie domine souvent les coûts de génération et de raisonnement |
| Jetons issus du cache | Les hypothèses de cache ne sont pas des économies tant que les journaux ne le prouvent pas |
| Nombre de tentatives | Un modèle moins cher qui effectue plus de tentatives peut coûter plus cher |
| Taux de tâches acceptées | Les échecs de qualité sont un coût caché |
| Moment d’exécution | Les tarifs de pointe / hors pointe de DeepSeek peuvent modifier le coût du même travail |
| Travail de migration | Le travail lié au SDK, au point de terminaison, à la région, à la journalisation et au retour arrière a un coût réel |
Différences de configuration de l’API qui affectent le coût
La configuration de DeepSeek est simple sur le plan opérationnel. Pour les appels compatibles OpenAI, l’URL de base est https://api.deepseek.com, avec des noms de modèles actuels tels que deepseek-flash et deepseek-v4-pro. Pour de nombreuses petites équipes, cette simplicité compte, car le temps de configuration est aussi un coût.
La configuration de Qwen offre davantage de choix. Model Studio prend en charge les appels compatibles OpenAI, mais l’URL de base varie selon la région et l’espace de travail. La documentation indique que les clés API sont liées à la région dans laquelle elles ont été créées, et qu’une clé d’une région peut échouer sur le point de terminaison d’une autre région. Ce n’est pas rédhibitoire, mais cela doit entrer dans la comparaison des coûts.
Si vous gérez un petit produit, le travail caché ressemble souvent à ceci :
- Ajouter une URL de base Qwen sensible à la région.
- Créer des clés API dans la bonne région.
- Tester l’ID exact du modèle Qwen dans cette région.
- Confirmer si l’inférence par lot est prise en charge pour ce modèle.
- Confirmer si le cache explicite ou implicite s’applique.
- Confirmer si les champs d’utilisation indiquent les jetons mis en cache.
- Ajouter un routage de repli si le routeur échoue aux seuils de qualité ou de latence.
C’est pourquoi un routeur à une seule clé peut être utile même pour une équipe axée sur le coût. Flatkey fournit aux équipes un seul point d’entrée compatible OpenAI, un seul solde, une seule facture, la découverte des modèles et la consultation de l’utilisation sur plusieurs fournisseurs. Vous devez toujours vérifier la disponibilité des modèles et les tarifs avant la mise en production, mais la comparaison opérationnelle devient plus claire, car la facturation et les preuves des requêtes se trouvent au même endroit.
Quand DeepSeek est le meilleur choix en matière de coût
DeepSeek est le meilleur premier test lorsque :
- vous voulez un seul point de terminaison direct du fournisseur, simple ;
- votre charge de travail peut s’exécuter pendant les périodes creuses ;
- l’invite comporte des préfixes répétés et que les jetons issus du cache DeepSeek apparaissent de manière fiable ;
- la qualité de
deepseek-flashsuffit pour la tâche ; - vous avez besoin de lignes de prix claires pour les jetons mis en cache, les ratés de cache et la sortie dans le même tableau tarifaire ;
- votre équipe préfère éviter la gestion des clés par région ou espace de travail.
L’avertissement important concerne le coût de sortie. DeepSeek Flash peut être très attractif lorsque les hits de cache d’entrée sont élevés, mais les réponses longues paient toujours les tarifs de sortie. Si le modèle produit des réponses verbeuses ou nécessite des tentatives supplémentaires, les économies sur le prix catalogue peuvent disparaître.
Quand Qwen est le meilleur choix en matière de coût
Qwen est le meilleur premier test lorsque :
- Vous pouvez utiliser une ligne de la famille Flash à faible coût dans la région dont vous avez besoin.
- Votre charge de travail peut s’exécuter via l’inférence batch.
- Vos prompts peuvent utiliser un cache implicite ou explicite.
- Vous utilisez déjà Alibaba Cloud ou avez besoin de familles de modèles Qwen spécifiques.
- Vous avez besoin d’un ensemble plus large de snapshots Qwen pour arbitrer entre qualité et coût.
- Vous pouvez gérer des opérations d’endpoint et de clé API liées à une région.
Le point d’attention est la complexité. Qwen comporte de nombreuses lignes, régions, versions de modèles et exceptions de cache. Il vous faut une revue de route enregistrée, pas seulement un prix copié depuis un tableau.
Modèle de revue de route en 30 minutes
Copy this before changing production traffic:
decision_date: 2026-09-23
workflow: ""
current_route:
  provider: ""
  model_id: ""
  region: ""
  endpoint: ""
candidate_routes:
  - provider: deepseek
    model_id: deepseek-flash
    execution_mode: realtime
    pricing_checked_url: https://api-docs.deepseek.com/quick_start/pricing
    cache_fields_to_log:
      - prompt_cache_hit_tokens
      - prompt_cache_miss_tokens
  - provider: qwen
    model_id: ""
    region: ""
    execution_mode: realtime_or_batch
    pricing_checked_url: https://docs.modelstudio.console.alibabacloud.com/en/model-studio/model-pricing
    cache_fields_to_log:
      - cached_tokens
acceptance_gate:
  sample_size: 100
  minimum_quality_pass_rate: ""
  maximum_retry_rate: ""
  maximum_p95_latency: ""
  maximum_cost_per_accepted_task: ""
rollback:
  owner: ""
  fallback_model_id: ""
  spend_limit: ""
  review_date: ""
Recommandation pratique
Pour la plupart des workflows indépendants sensibles aux coûts, commencez dans cet ordre :
- Testez la ligne Qwen Flash la moins chère disponible dans la région requise.
- Si la charge de travail est asynchrone, testez l’inférence batch Qwen.
- Si le prompt comporte du contexte répété, mesurez les champs de cache Qwen et les champs de cache DeepSeek côte à côte.
- Testez
deepseek-flashpendant les périodes creuses si une configuration simple ou la qualité DeepSeek est importante. - Utilisez Plus, Max ou DeepSeek Pro uniquement après l’échec du test d’acceptation avec la route la moins chère.
- Passez par une passerelle partagée lorsque le changement, le fallback ou la preuve de facturation devient une partie du coût d’exploitation.
N’approuvez pas la route la moins chère par jeton d’entrée. Approuvez la route la moins chère par tâche acceptée après l’enregistrement des preuves de qualité, de retry, de cache, de batch et de rollback.
Questions fréquentes
DeepSeek est-il moins cher que Qwen en 2026 ?
Pas universellement. Dans les exemples actuels, Qwen l’emporte souvent pour le chat simple sans cache et les tâches pouvant être exécutées en batch, tandis que DeepSeek reste attrayant pour une configuration directe simple, une comptabilisation explicite du cache, un trafic hors pointe et des charges de travail où deepseek-flash passe le critère de qualité avec moins de retries.
L’inférence batch Qwen est-elle toujours moins chère ?
Non. L’inférence batch Qwen peut facturer les requêtes réussies à 50 % du tarif de l’inférence en temps réel pour les modèles pris en charge, mais les jobs batch sont asynchrones et ne sont pas éligibles à certaines promotions ni à certaines remises de cache. Utilisez-la pour les jobs hors ligne, pas pour les appels produit sensibles à la latence.
Dois-je comparer DeepSeek Pro à Qwen Flash ?
Uniquement si les deux passent la même grille d’acceptation de qualité. Pour un guide des coûts, comparez le modèle le moins cher qui satisfait la tâche. Si Qwen Flash échoue mais que DeepSeek Flash réussit, la ligne Qwen la moins chère affichée n’a pas d’importance.
Le caching garantit-il des économies ?
Non. DeepSeek indique que les hits de cache dépendent de la correspondance des unités de préfixe mises en cache et ne sont pas garantis. La documentation de Qwen indique également que la probabilité de hit du cache implicite n’est pas garantie et doit être vérifiée via les champs d’utilisation. Considérez les économies de cache comme des économies mesurées, et non comme des économies promises.
Où se situe Flatkey ?
Flatkey est utile dès que le changement de modèle lui-même devient un coût. Avec un seul chemin compatible OpenAI, un seul solde, une seule facture et des journaux d’utilisation, vous pouvez comparer DeepSeek, Qwen et d’autres routes de modèles sans disperser les clés et les preuves de facturation entre plusieurs fournisseurs.
Réponse finale
La bonne conclusion du DeepSeek API vs Qwen API pour les flux de travail sensibles aux coûts : guide des coûts 2026 n’est pas « DeepSeek est moins cher » ni « Qwen est moins cher ». C’est :
Utilisez Qwen en premier pour les workflows simples, peu coûteux, cacheables et groupables par lots. Utilisez DeepSeek en premier lorsque la simplicité de configuration, la planification hors heures de pointe, la comptabilisation directe des hits de cache ou la qualité de DeepSeek Flash vous donnent le coût par tâche acceptée le plus bas. Utilisez Flatkey lorsque le coût du changement, de la journalisation et de la preuve de facturation commence à compter autant que le prix des jetons.